


本文是关于如何优化 RAG 技术的一系列文章之一。在之前的文章中,我们已经深入探讨了如何在 Chunking、Embedding 以及评估指标设计等环节优化 RAG 性能。这篇文章将重点关注如何准备评估 RAG 性能所需的数据集,为后续优化打下坚实基础。
1. 优化 RAG 不是“炼丹”,需要系统的方法
当涉及到如何优化 RAG(Retrieval-Augmented Generation)性能时,许多人往往采取“试错”的方法:“我尝试了一个新模块,问了几个问题,答案看起来还行…”。这样的定性评估方式虽然直观,但很难得出可靠的改进结论。
优化 RAG 性能需要采用科学实验的方式。这意味着我们必须设计量化的评估指标,并准备高质量的评估数据集。通过结构化的实验和评估方法,我们才能明确什么样的调整会真正提升性能。
随机提问题这种太上老君“炼丹”的方法不适用于 RAG 性能评估和优化
2. 结构化评估 RAG 的性能
RAG 系统的性能评估可以从以下两个主要方面进行:
-
检索评估(Retrieval Evaluation): 检索的段落是否相关?
-
生成评估(Generation Evaluation): 模型生成的答案是否恰当?
对于端到端的评估,我们通常关注以下四类指标:
-
Groundedness(可靠性): 检索评估中的关键指标,评估检索的段落是否为生成的答案提供了可靠支持,避免幻觉(hallucinations)或无关信息。这是生成评估的基础。
-
Completeness(完整性): 生成评估的核心指标,用于评估模型的回答是否全面覆盖了用户问题的所有方面,同时间接反映了检索阶段的信息充分性。
-
Utilization(利用率): 连接检索和生成的桥梁指标,用来评估检索到的信息是否被有效利用。如果利用率低,可能意味着检索到的段落与问题无关,或者模型未充分使用这些段落。
-
Relevance(相关性): 检索评估的直接反映,衡量检索到的段落与用户问题之间的相关性,同时也会影响生成评估的整体表现。
这些指标需要基于高质量的测试样本和严格的评估流程。
3. 使用 Agents 完成 RAG 性能基准测试
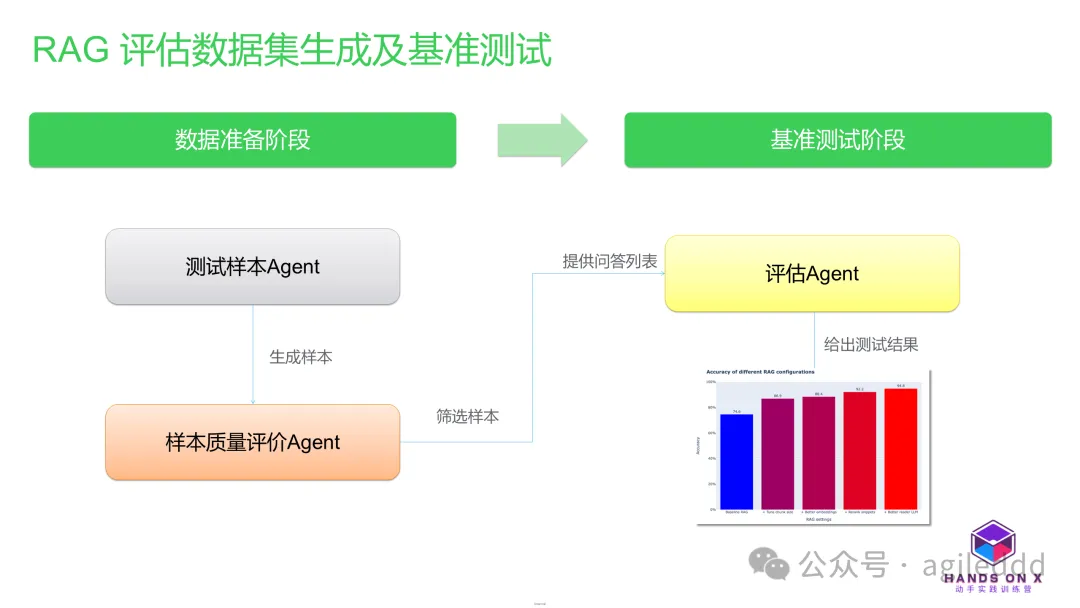
在开始具体流程前,我们需要了解三个代理(Agents)的协作关系:
-
测试样本代理(Test Sample Agent): 用于生成和准备测试数据,这些数据构成了评估系统的基础。
-
样本质量评价代理(Critique Agent): 对测试样本进行质量审核,确保最终用于评估的数据具备高准确性和清晰性。
-
评估代理(Evaluation Agent): 负责根据设计的指标对系统性能进行量化评估。这些评估指标覆盖了检索和生成的多个层面。
通过这三种代理的协作,可以建立一个系统化的性能基准测试流程,帮助开发者深入理解和优化 RAG 系统。
3.1 生成测试样本
为了评估 RAG 系统的性能,首先需要使用测试样本代理(Test Sample Agent) 生成测试样本。这些代理可以自动生成一组高质量的 QA 样本(问题与答案对)。例如,可以先生成 10 个样本用于快速测试,然后从公共资源库加载更多样本,或者生成更大规模的数据集以供全面评估。
但如果针对特定的知识库,建议生成至少 200 个样本,因为后续通过评价代理过滤掉低质量问题后,最终能保留的有效样本约为一半。
以下是生成QA样本的提示词:
QA_generation_prompt = """
Your task is to write a factoid question and an answer given a context.
Your factoid question should be answerable with a specific, concise piece of factual information from the context.
Your factoid question should be formulated in the same style as questions users could ask in a search engine.
This means that your factoid question MUST NOT mention something like "according to the passage" or "context".

Provide your answer as follows:

Output:::
Factoid question: (your factoid question)
Answer: (your answer to the factoid question)

Now here is the context.

Context: {context}\n
Output:::"""
3.2 检查样本质量
自动生成的样本可能存在质量问题,因此需要引入样本质量评价代理(Critique Agents) 来对问题进行质量审查。这些代理会根据多种标准对每个问题评分,比如:
-
问题是否清晰、无二义性?
-
问题是否适合特定知识领域?
我们通过这些代理对问题进行系统评分。当任意一个代理的评分过低时,直接剔除该问题。
💡提示: 当让代理生成分数时,先要求其输出理由,再给出最终评分。这种方式不仅能帮助我们验证评分结果,还能促使代理在回答过程中进行更深入的思考,从而提高评分的准确性。
以下是评估样本质量的提示词:
question_groundedness_critique_prompt = """
You will be given a context and a question.
Your task is to provide a 'total rating' scoring how well one can answer the given question unambiguously with the given context.
Give your answer on a scale of 1 to 5, where 1 means that the question is not answerable at all given the context, and 5 means that the question is clearly and unambiguously answerable with the context.

Provide your answer as follows:

Answer:::
Evaluation: (your rationale for the rating, as a text)
Total rating: (your rating, as a number between 1 and 5)

You MUST provide values for 'Evaluation:' and 'Total rating:' in your answer.

Now here are the question and context.

Question: {question}\n
Context: {context}\n
Answer::: """

question_relevance_critique_prompt = """
You will be given a question.
Your task is to provide a 'total rating' representing how useful this question can be to machine learning developers building NLP applications with the Hugging Face ecosystem.
Give your answer on a scale of 1 to 5, where 1 means that the question is not useful at all, and 5 means that the question is extremely useful.

Provide your answer as follows:

Answer:::
Evaluation: (your rationale for the rating, as a text)
Total rating: (your rating, as a number between 1 and 5)

You MUST provide values for 'Evaluation:' and 'Total rating:' in your answer.

Now here is the question.

Question: {question}\n
Answer::: """

question_standalone_critique_prompt = """
You will be given a question.
Your task is to provide a 'total rating' representing how context-independant this question is.
Give your answer on a scale of 1 to 5, where 1 means that the question depends on additional information to be understood, and 5 means that the question makes sense by itself.
For instance, if the question refers to a particular setting, like 'in the context' or 'in the document', the rating must be 1.
The questions can contain obscure technical nouns or acronyms like Gradio, Hub, Hugging Face or Space and still be a 5: it must simply be clear to an operator with access to documentation what the question is about.

For instance, "What is the name of the checkpoint from which the ViT model is imported?" should receive a 1, since there is an implicit mention of a context, thus the question is not independant from the context.

Provide your answer as follows:

Answer:::
Evaluation: (your rationale for the rating, as a text)
Total rating: (your rating, as a number between 1 and 5)

You MUST provide values for 'Evaluation:' and 'Total rating:' in your answer.

Now here is the question.

Question: {question}\n
Answer::: """
3.3 设置评估代理
最后,我们需要评估 RAG 系统在测试数据集上的表现。可以通过以下步骤完成:
- 选择评估指标:
- 我们重点关注faithfulness(可靠性) 作为主要指标,因为它能全面反映系统的端到端性能。
- 选择评估模型:
- 使用 GPT-4 作为评估代理,或者尝试其他性能良好的模型,如 kaist-ai/prometheus-13b-v1.0 或 BAAI/JudgeLM-33B-v1.0。
- 设计评估提示词:
- 提示词需要详细描述每个指标的评分标准(例如 1-5 分),并要求模型在评分前先输出评分依据。
💡提示: 提供详细的评分标准有助于评估代理保持一致性,避免因模糊标准导致评分结果的波动。
以下是 RAG 评估模型的提示词:
EVALUATION_PROMPT = """###Task Description:
An instruction (might include an Input inside it), a response to evaluate, a reference answer that gets a score of 5, and a score rubric representing a evaluation criteria are given.
1. Write a detailed feedback that assess the quality of the response strictly based on the given score rubric, not evaluating in general.
2. After writing a feedback, write a score that is an integer between 1 and 5. You should refer to the score rubric.
3. The output format should look as follows: \"Feedback: {{write a feedback for criteria}} [RESULT] {{an integer number between 1 and 5}}\"
4. Please do not generate any other opening, closing, and explanations. Be sure to include [RESULT] in your output.

###The instruction to evaluate:
{instruction}

###Response to evaluate:
{response}

###Reference Answer (Score 5):
{reference_answer}

###Score Rubrics:
[Is the response correct, accurate, and factual based on the reference answer?]
Score 1: The response is completely incorrect, inaccurate, and/or not factual.
Score 2: The response is mostly incorrect, inaccurate, and/or not factual.
Score 3: The response is somewhat correct, accurate, and/or factual.
Score 4: The response is mostly correct, accurate, and factual.
Score 5: The response is completely correct, accurate, and factual.

###Feedback:"""

from langchain.prompts.chat import (
    ChatPromptTemplate,
    HumanMessagePromptTemplate,
)
from langchain.schema import SystemMessage


evaluation_prompt_template = ChatPromptTemplate.from_messages(
    [
        SystemMessage(content="You are a fair evaluator language model."),
        HumanMessagePromptTemplate.from_template(EVALUATION_PROMPT),
    ]
)
3.4 生成报告与分析
通过评价代理完成评分后,可以生成一份包含所有指标数据的报告。报告不仅能帮助我们量化 RAG 系统的当前性能,还能为后续优化提供明确的方向。
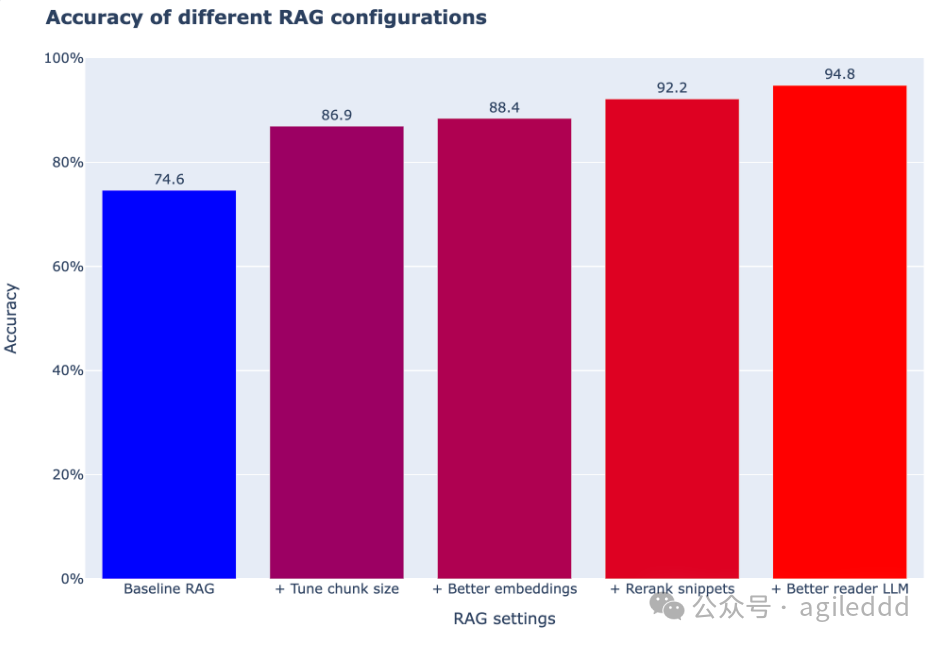
使用3个Agents的评估体系可以稳步优化 RAG性能
4. 结论
准备高质量的评估数据集是优化 RAG 性能的基础。通过引入生成代理和评价代理,我们可以建立一个系统化的评估流程,确保每个调整都有量化依据。这种基于数据驱动的方法不仅能帮助开发者快速迭代 RAG 系统,还能避免无效尝试导致的时间浪费。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

 191


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


