一个接口,整合所有大语言模型,吴恩达开发的,你就说行不行吧?

什么是大模型? 大模型是指具有数千万甚至数亿参数的深度学习模型。近年来,随着计算机技术和大数据的快速发展,深度学习在各个领域取得了显著的成果,如自然语言处理,图片生成,工业数字化等。为了提高模型的性能,研究者们不断尝试增加模型的参数数量,从而诞生了大模型这一概念。大模型通常由深度神经网络构建而成,拥有数十亿甚至数千亿个参数。大模型的设计目的是为了提高模型的表达能力和预测性能,能够处理更加复杂的任务和数据。大模型采用预训练+微调的训练模式,在大规模数据上进行训练后,能快速适应一系列下游任务的模型。 阅读详情

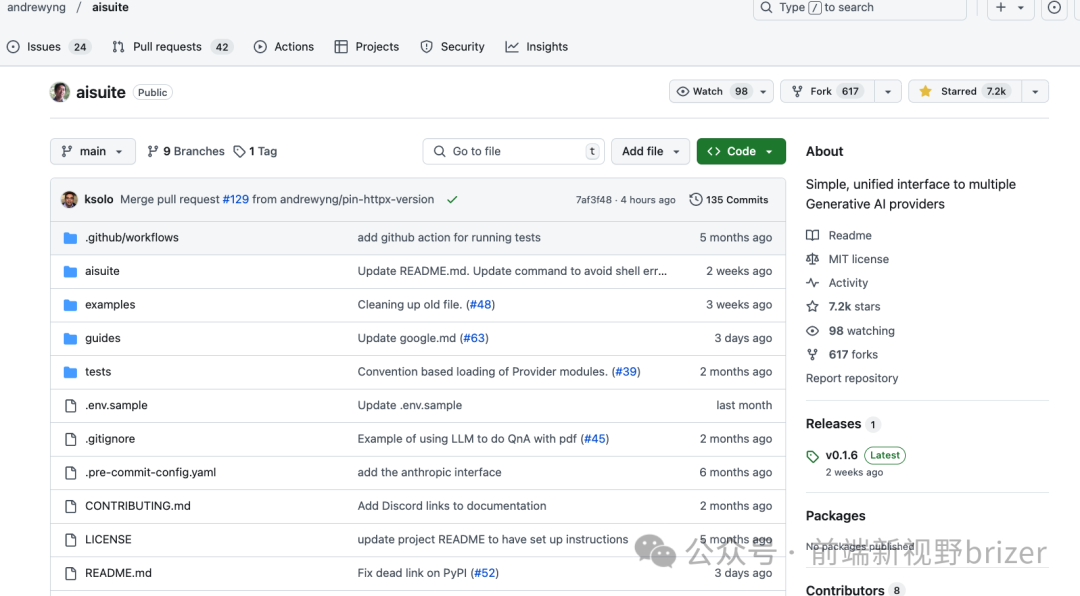
昨天逛GitHub,又遇到一个不得不分享的宝藏项目,名字叫 aisuite。
一看名字挺普通,但翻开它的简介,我差点惊掉下巴:
一个接口,整合所有大语言模型(LLM)提供商,还自带吴恩达的“出品认证”!

咱先聊吴恩达,AI界谁人不识君?这位大佬可不是随便给个项目站台的。
这次他带着aisuite,直接瞄准了开发者最头疼的问题:
用多个AI提供商的模型时,那些繁琐的SDK、不同的API格式、无穷无尽的调试,分分钟能让人怀疑人生。

而aisuite的出现,就是来治愈这种“开发者焦虑症”的!
它是什么?一个标准化的万能接口。不管你用的是OpenAI、Anthropic还是HuggingFace,代码写一次,随便切换。

目前支持的提供商阵容超级豪华:
OpenAI、Anthropic、Azure、Google、AWS、Groq、Mistral、HuggingFace、Ollama。
这名单看着就让人心潮澎湃。


再说个数据,你可能更有概念:aisuite在GitHub上的星星数,已经快8000了!
这可不是随便哪种“短命火”的项目,aisuite是社区真金白银“点赞投票”出来的热度。短短时间冲到这个星级,说明啥?
开发者们是真的爱了。


说了这些,你可能会问:它用起来真这么简单吗?
别急,我直接上个小例子给你感受下:

你今天突然想用OpenAI的GPT-4写段子,Anthropic的Claude润色,最后再让HuggingFace的模型给你学术补充。
以前你需要不同的文档、不同的密钥、不同的调用方式,搞到你想摔键盘。

现在有了aisuite,整个过程秒变丝滑:

import aisuite as ai      client = ai.Client()   models = ["openai:gpt-4o", "anthropic:claude-3-5-sonnet"]   messages = [       {"role": "system", "content": "用海盗英语回答。"},       {"role": "user", "content": "讲个笑话吧!"},   ]      for model in models:       response = client.chat.completions.create(           model=model,           messages=messages,           temperature=0.75       )       print(f"{model} 的回答:{response.choices[0].message.content}")

就是这么简单,一套代码,多模型切换无缝操作。
你甚至都不用知道每个模型的API细节,aisuite帮你全搞定了。


装起来更简单,pip一条龙服务:

  • 只装基础包:pip install aisuite

  • 加装Anthropic的支持:pip install 'aisuite[anthropic]'

  • 豪华全套版:pip install 'aisuite[all]'

配置呢?API密钥一键加到环境变量里,连配置文件都省了。
总之,开发体验就是一个字:爽。


更厉害的是,aisuite还给社区和新提供商留足了扩展空间:
只要你愿意,分分钟能给它加上新的模型支持。甚至不用担心接口不匹配,因为aisuite用了一套特别的命名规范,每个新模型的加入都超自然。

最后提醒一句,这东西现在火得一塌糊涂,等你发现它用起来有多香的时候,说不定星星已经破万了。

GitHub 地址:

https://github.com/andrewyng/aisuite

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

吴恩达Agentic AI教程:从知识图谱到Vibe Coding的智能体开发实战 Agentic AI(智能体人工智能)是当前AI领域的重要发展方向,它通过赋予大语言模型(LLM)规划、记忆和工具调用等能力,使其能够自主完成复杂任务。其核心原理在于将LLM作为“大脑”,结合外部工具(Tools)、知识库(如知识图谱)和特定技能(Skills),形成可感知、决策和执行的智能系统。这种架构的技术价值在于突破了传统AI模型仅能生成文本的局限,实现了与现实世界的交互和自动化。在应用场景上,Agentic AI广泛适用于智能客服、自动化流程助手、数据分析、代码生成(Vibe Coding)等领域。 阅读详情

相关推荐

吴恩达提示词工程教程:从核心模式到工程化实践

这次我们来看一个关于提示词工程(Prompt Engineering)的系统性学习资源。这个项目标题指向的是由吴恩达(Andrew Ng)主讲的一套提示词工程教程,号称是“2026首发,B站最全”,并附带课件代码。对于任何想要系统掌握如何与大语言模型(LLM)高效交互的开发者、产品经理或技术爱好者来说,这无疑是一个极具吸引力的起点。提示词工程不再是简单的“问问题”,而是构建可靠、高效AI应用的核心技能。 这套教程的核心价值在于它提供了一条从入门到进阶的清晰路径。它不仅仅是理论讲解,更侧重于实战,通过附带的课

weixin_34128237的博客 489

全网最全的python学习路线图,帮你整理好了!

Python所有方向的技术点做的整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。(全套教程文末领取哈)

m0_59163425的博客 1万+

什么是大模型

大模型(Big Model)是指在机器学习和人工智能领域中处理大规模数据和复杂模型的一种方法或技术。随着数据量的不断增加和模型的复杂度提高,传统的机器学习方法已经无法有效处理,因此大模型成为了解决这一挑战的重要工具之一。本文将介绍大模型的基本概念、应用场景以及一些常见的大模型技术。大模型是指在处理大规模数据和复杂模型时所采用的一种模型和算法。大模型通常需要处理海量的数据,这些数据可能来自于互联网、传感器、日志文件等各种来源。

私聊前往站内信:https://i.youkuaiyun.com/#/msg/chat/weixin_44976692 2万+

全网最全Python学习路线图+14张思维导图,让python初学者不走弯路

Python在近几年越来越受追捧,很多童鞋或者职场小伙伴想要提升技能-学习Python。

Python栈_基的博客 2892

GPT背后的法术——LLM全面解构

除了两个变化外,解码器端与编码器端的架构几乎相同。蒙面注意层。从编码器端导入键和值向量。让我们首先了解解码器的输入和输出。解码器的输入:目标序列(移位):在训练期间,目标序列(例如,机器翻译任务中的翻译句子)作为输入提供给解码器,但它被移位了一个位置。这意味着解码器接收到目标序列中除最后一个之外的所有标记。这样做是为了确保模型学会在给定先前标记的情况下预测序列中的下一个标记。编码器输出:编码器产生的隐藏状态,代表输入序列或换句话说,K 和 V 向量。

iCloudEnd的博客 1475

中国知网文献引用导入EndNote9.X,Web of science导入endnote以及谷歌学术导入endnote图文详解,全网最细版本适用EndNote9.x,Endnote20版本

在科研中用到EndNote管理文献,遇到插入文献时,中国知网如何将参考文献导进Endnote9.x或者web of sicence,谷歌学术如何将文章,文献导入进文献管理软件EndNote的详细图文2022版本解释,全网最细的笔记教程,值得大家参考收藏学习

sakura的博客 5178

吴恩达大佬刚发布的开源项目!对于AI初学者来说简直不要太友好

近日,GitHub 平台上涌现出一匹引人注目的黑马——一个开源项目在短短十几天内,其标星数便从零激增至超过 8000,堪称近期 star 增长速度最为迅猛的开源项目之一。

DEVELOPERAA的博客 1185

深入博通PEX89000内部:那颗ARM CPU和Synthetic Mode到底能玩出什么花样?

本文深入解析博通PEX89000系列PCIe交换芯片内置的ARM CPU与Synthetic Mode技术,揭示其在AI计算和数据中心的智能潜能。通过ARM Cortex CPU的实时控制和Synthetic Mode的自治网络功能,PEX89000实现了GPU集群的动态拓扑重组和资源池化,大幅提升AI训练效率。文章还探讨了该技术在软件定义数据平面和弹性AI架构中的创新应用。

weixin_30776273的博客 217

【2025】吴恩达LLM大模型学习笔记 (13)

LangChain 是一个用于构建大语言模型(LLM)应用的开源框架,其核心定位是。通过提供标准化组件和模块化设计,LangChain 解决了传统 LLM 应用开发中 “功能碎片化、集成复杂、逻辑难维护” 的问题,让开发者能快速构建具备上下文理解、多步推理、外部交互能力的高级应用。

一刀7段的博客 941

glibc手动升级高版本导致系统(RedHat/Centos)异常(无法开机等)的解决方法(回退低版本glibc)

我的系统是Redhat7.6, 理论上Redhat7/Centos7都可以使用该方法解决问题。 首先慎重提醒各位:glibc升级会产生无法预料的后果!由于Android NDK需要高版本的glibc才可以使用,所以作死手动去更新了glibc2.18,使得重启系统后图形界面消失。(Redhat/Centos升级此类安装包最好用yum升级,因为系统内的程序对他们的依赖很大,升级会导致大部分程序无法使用...

weixin_42881528的博客 9698

【机械视觉】Halcon—【二、Halcon算子全面介绍(超详细版)】

Halcon 的算子(operators)按照功能被系统性地划分为多个类别,官方文档中目前(Halcon 22.11 版本)共有 19 个主分类,每个主分类下还有若干子分类。 本人在此对这19个分类的常用核心算子进行了一系列的总结,且本人在文章最后还总结了一些案例经验。 注意: ​​​​​​​跨分类调用:某些算子可能在多个分类中,但官方文档中会明确其主分类。 例如: read_image(文件操作)常被其他分类(如图像处理)的示例调用,但其核心功能是文件读取。

qq_3517289697的博客 3920

吴恩达大佬刚发布的开源项目!对于AI初学者来说简直不要太友好(附教程)

近日,GitHub 平台上涌现出一匹引人注目的黑马——一个开源项目在短短十几天内,其标星数便从零激增至超过 8000,堪称近期 star 增长速度最为迅猛的开源项目之一。

2301_81888214的博客 794

Ubuntu运行vmware时报错Vmware Unable to install all modules!Use shipped Linux kernel AIO access library解决。

Ubuntu运行vmware时报错Vmware Unable to install all modules! vmware --version 提示下面内容: [AppLoader] Use shipped Linux kernel AIO access library. An up-to-date "libaio" or "libaio1" package from your system is preferred. VMware Workstation 16.1.2 build-17966106

wto882dim的博客 2851

AI Agent:人人都是开发者

Agent提供的快速迭代和实验本身就是一种新的用户体验发明路径。因此,Agent的价值在于降低新产品的开发成本,缩短开发周期,快速验证想法,通过组合式创新发现商业机会。

产品老A,8年互联网大厂AIPM,专注探索新型人机交互 1286

Carla自动驾驶仿真一:快速安装与运行Carla

网上有不少的Windows版本的Carla的安装教程,这里简单记录下自己安装过程,写的也比较详细,基本不用看其他文章。

zataji的博客 2万+

ESP-IDF 5.4下esp32-camera组件编译报错?手把手教你解决头文件缺失问题

本文详细解析了ESP-IDF 5.4环境下esp32-camera组件编译时出现的头文件缺失问题,提供了从目录结构优化、CMake配置到VSCode智能感知设置的完整解决方案。针对第三方组件集成难题,文章特别强调了PRIV_REQUIRES依赖声明和路径配置的关键作用,帮助开发者高效解决编译错误并建立稳定的开发环境。

weixin_28829629的博客 309

aisuite:统一的大模型SDK,简化LLM开发流程

AISuite是一个开源Python库,旨在解决开发者使用不同LLM提供商时面临的API碎片化、配置复杂性和模型切换困难等问题。它提供统一接口,支持OpenAI、Anthropic等11种模型,只需简单修改字符串即可切换模型。通过封装工具调用和自动执行功能,AISuite显著降低了开发门槛,提高了多模型集成效率,是跨LLM开发的理想选择。

Q2024107的博客 991

【示波器专题】示波器探头的原理深入——有源探头之单端有源探头

由于接地环路的苛刻要求,更高带宽的单端有源探头就算设计了也不实用。因此单端有源探头的带宽一般在6GHz以内,更高带宽的信号测量也只能使用差分有源探头(市面上有些型号的差分探头可同时兼顾单端测试)。......

一点硬件 2147

如何成为LLM开发工程师:从零开始的完整成长路径与核心技能图谱

Datawhale / llm-cookbook是面向开发者的LLM入门教程,基于吴恩达大模型系列课程中文版,帮助开发者系统掌握大语言模型应用开发技能。无论你是AI领域新人还是希望转型的软件工程师,这份成长指南都能为你清晰规划从入门到精通的学习路径。 ## 一、LLM开发工程师的核心能力模型 🚀 ### 1.1 必备基础知识体系 作为LLM开发工程师,你需要构建坚实的基础知识框架,包括: -

gitblog_00370的博客 708

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

基于Anthropic Claude的AI智能体开发实战:从工具调用到API部署

AI智能体(AI Agent)作为大语言模型(LLM)的高级应用形态,其核心原理在于通过规划、记忆和工具调用等机制,使模型从被动应答升级为能执行复杂任务的主动系统。这项技术的工程价值在于将大模型的认知能力与外部工具和数据源无缝连接,从而在自动化办公、智能客服、数据分析等场景中创造实际生产力。本文聚焦于Anthropic Claude模型,深入探讨如何利用其原生工具调用(Tool Use)和长上下文能力,结合Model Context Protocol (MCP)等新兴标准,构建可执行多步推理、处理长文档的实

weixin_30243533的博客 461

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

LLM智能体技能开发:模块化扩展与实战应用

大语言模型(LLM)的模块化能力扩展正通过Agent Skills机制实现技术突破。该机制将特定领域功能封装成标准化技能模块,通过统一接口与核心LLM交互,实现能力热插拔和专业分工。这种架构不仅避免了传统AI系统功能扩展时的全模型重训练,还显著提升了资源利用效率。在技术实现上,每个Skill包含能力描述文件、执行逻辑和验证用例三个核心组件,类似于乐高积木的标准化接口设计。实际应用中,从天气预报到股票分析的技能开发,再到智能投研助手等复杂场景的技能组合,展现了该技术的广泛适用性。开发工具链如LangChain

weixin_30786657的博客 422

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

Java工程师转型Agent开发:学习路径与实战指南

在现代AI应用开发中,大语言模型(LLM)与智能体(Agent)已经成为技术演进的核心方向。Agent并非简单的API调用,而是由推理循环、工具调用、记忆管理等机制构成的复杂系统。理解其底层原理,掌握工程化落地方法,是技术人员切入AI应用层的关键。随着LangChain4j、Spring AI等框架的成熟,Java开发者无需更换语言就能构建企业级Agent服务,将已有的Spring Boot生态、分布式系统经验迁移到智能体开发中。从补基础概念、精读框架文档,到动手实现一个带记忆和工具调用的Agent项目,完

weixin_29038155的博客 249
上一篇: 走进生信:PRAGA:用于空间多模态组学分析的原型感知图自适应聚合
下一篇: 医图顶会 MICCAI‘23 | H-DenseFormer:多模态融合分割的高效混合密集连接Transformer
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2841原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值