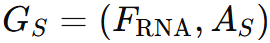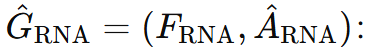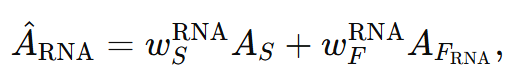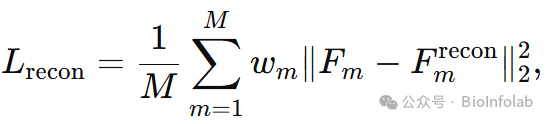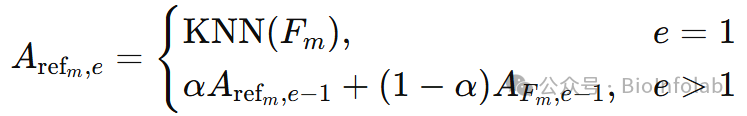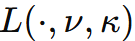
走进生信:PRAGA:用于空间多模态组学分析的原型感知图自适应聚合

AAAI 2025 | 基于自适应图结构和动态原型对比学习的空间多组学解析框架 ©PaperWeekly 原创 ·作者 |黄新磊单位 |大湾区大学信息科学与技术学院研究方向 |空间多组学,图学习本文提出了一个新的空间多组学解析框架,PRAGA,通过构建动态图结构和基于贝叶斯高斯混合模型的动态原型对比学习,实现在无人工标注和测序点类型数量先验的场景下对空间多模态组学数据的综合编码解析,并在五个空间多组学数据集上展现出最优的定性和定量结果。论文题目:PRAGA: Prot... 阅读详情

文章摘要

空间多模态组学技术被《Nature Methods》评为2023年的先进生物技术,在解析具有空间背景的生物调控过程中发挥着关键作用。近年来,基于K近邻(KNN)图的图神经网络在空间多模态组学方法中受到关注,因为它们能够建模测序点之间的语义关系。然而,固定的KNN图无法捕获由于生物测序过程中不可避免的数据扰动而隐藏的潜在语义关系,导致语义信息的丢失。此外,实际应用中常见的点注释缺失和类别数量先验的缺乏也阻碍了空间多模态组学模型的优化。

为此,我们提出了一种新的空间多模态组学解析框架,称为原型感知图自适应聚合用于空间多模态组学分析(PRAGA)。PRAGA构建了一个动态图,用于捕获潜在的语义关系,并全面整合空间信息和特征语义。该可学习的图结构通过学习跨模态知识,还可以去除扰动噪声。此外,我们基于贝叶斯高斯混合模型的动态适应性提出了一种动态原型对比学习方法,以优化多模态组学表示以应对未知的生物先验。在模拟和真实数据集上与7种竞争方法进行的定量和定性实验表明,PRAGA具有优越的性能。

模型方法
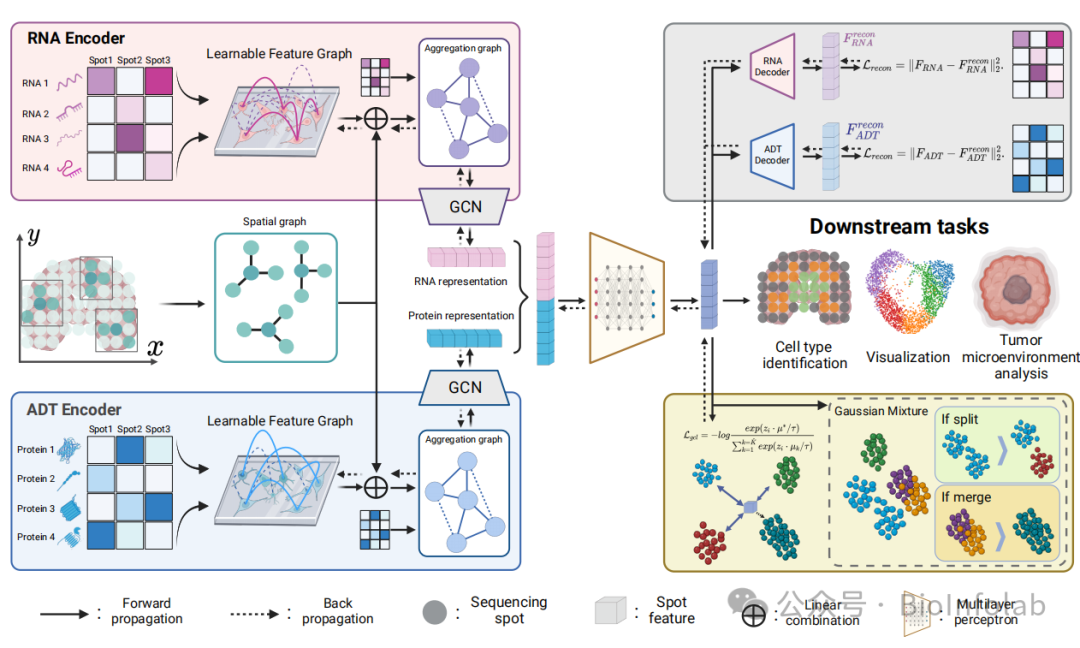
动态组学特定图 对于特定的组学模态,构建一个可学习的参数矩阵来建模测序点间的语义关系图。使用K近邻无向图来初始化以确保初始稀疏化。其中K设定为20.
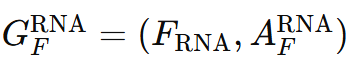
空间聚合编码 在首先通过KNN初始化可学习的特征图和空间邻接图。其中A是基于空间坐标计算的空间邻接矩阵。最终得到的空间聚合图为

其中两个W均为可学习参数。然后使用一层图卷积神经网络GCN作为编码器,通过空间聚合图可以对其中一个模态RNA测序特征进行编码。
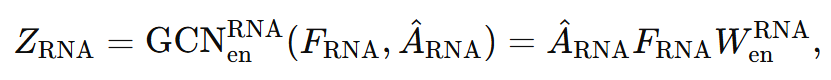
其中W是编码器中可以学习的参数矩阵。

类似的,其他组学数据进行编码,获得所有模态的特定编码后,使用MLP将不同模态的编码映射为统一的综合表示。
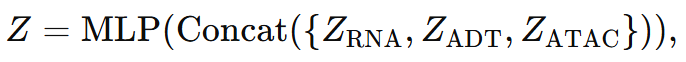
对于每种模态我们使用单层GCN实现解码,通过空间邻接图从综合编码Z中重构组学特征。利用重构损失计算与原始组学特征之间的均方差:

其中W为重构权重,能够帮助组学特定图从其他模态中获取知识,以减轻测序扰动的影响并促进潜在语义关系的发现。

邻接图的剧烈变化可能会导致训练不稳定,因此利用更新前后特征图的F范数来计算同质性损失,以限制特征图的变化。
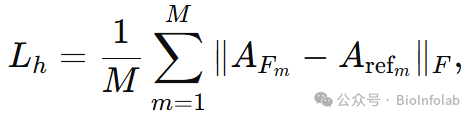
其中是模态m的参考图,初始化方式与相同,并在的学习过程中通过指数移动平均进行缓慢更新:

其中e是训练周期索引,是控制移动速度的超参数。同质性损失限制组学特定图每次仅学习少量的新关联边,在提供可解释性的同时保持训练稳定性。

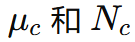
动态原型对比学习 使用综合表示Z,设置初始聚类数量为C,利用高斯混合模型将Z分配到C个聚类中。参数敏感性实验验证了初始化的C不敏感,所以只需要一个大致的C即可。每个聚类的均值和样本数量定义为,其中c代表聚类索引。为了动态调整聚类数量,每个聚类进一步分为两个子聚类,设置每个聚类分裂准则,以决定是否需要分裂:
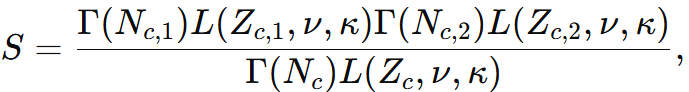
其中是伽马函数,是以正态逆Wishart分布为先验的边际似然,v和k是NIW的超参数。如果S>1,原聚类将被其中一个子聚类代替,另外一个子聚类作为新聚类添加。

同样也设置两个聚类是否需要合并:
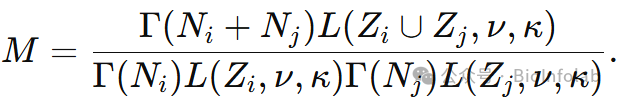
如果M>1,则新的聚类将代替原来的两个聚类。

在获得调整后的聚类后,我们将每个Spot分配聚类,并以聚类中心为原型进行对比学习,从而进一步优化可学习特征图。
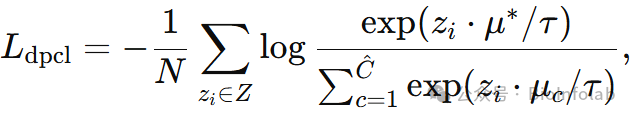
最后模型的总损失为:
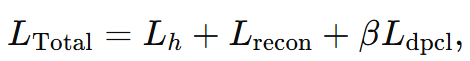
如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

AI 应用开发 × 算法面试题:业务场景实战 12 题【TopK、LRU、RRF 融合、相似度、限流算法,含手撕代码与底层答案】 本文聚焦AI应用岗算法面试新趋势,剖析12道融合业务场景的高频题:从海量日志中挖掘慢查询(分治+小顶堆)、亿级去重(布隆过滤器)、向量与关键词融合排序(RRF)、语义缓存设计(带租户隔离与TTL的LRU)到限流策略(令牌桶+滑动窗口),强调“场景复述→算法选型→手撕代码→生产落地”四步答题框架。突出考察点已从纯算法转向工程权衡、业务理解与系统设计能力,如误判容忍度、实时性与内存预算的平衡,助力开发者应对2026年真实技术挑战。 阅读详情

相关推荐

分享一下如何使用labelimg制作自己的YOLO数据集

首先准备一下自己的下准备一个空文件夹用于保存标签文件,如下图所示。

skywalkerxhx的博客 832

生物信息Agent构建全指南:7个核心模块打造你的专属序列分析引擎

掌握生物信息Agent的序列分析核心技术,构建高效自动化分析流程。本文详解7大核心模块设计,涵盖基因组、转录组等多场景应用,支持高通量数据智能解析,提升科研效率。方法系统实用,值得收藏。

LogicShoal的博客 812

同态加密与SEAL库实战:CKKS参数调优避坑指南

本文深入探讨了同态加密技术中CKKS方案的参数调优实践,重点解析了SEAL库中`poly_modulus_degree`、`coeff_modulus`和`scale`三大核心参数的配置技巧与避坑指南。通过实战案例展示了如何平衡计算深度、精度与性能,为开发者提供了一套完整的参数优化方法论,帮助避免常见的'scale out of bounds'等错误,显著提升同态加密应用的可靠性和效率。

weixin_29315569的博客 230

牛津大学团队AI生信分析神器「FlowAgent」

FlowAgent的自定义脚本系统支持用户将任意编程语言(R/Python/Bash等)编写的分析脚本集成到工作流中。系统通过脚本元数据自动发现并整合这些脚本,实现"即插即用"。FlowAgent通过整合自然语言交互、代理驱动的智能优化与多环境支持,显著提升了生物信息学工作流的自动化水平和可访问性,尤其为非计算背景的研究人员提供了高效工具。其动态错误处理、实时质量控制和模块化设计,使其在复杂生信分析中兼具鲁棒性与扩展性,有望加速多模态组学数据的科学发现。

zd200572的博客 1688

《炬丰科技-半导体工艺》用于半导体的RCA清洁技术

书籍:《炬丰科技-半导体工艺》 文章:用于半导体的RCA清洁技术 编号:JFKJ-21-1073 引言 RCA清洗技术是用于清洗硅晶圆等的技术,由于其高可靠性,30多年来一直被用于半导体和平板显示器(FPD)领域的清洗。其基础是以除去颗粒为目的的氨水-过氧化氢溶液组成的SC―1洗涤和以除去金属杂质为目的的盐酸-过氧化氢溶液组成的SC―2洗涤相结合的洗涤技术。SC-1洗涤的机理说明如下。首先,用过氧化氢氧化硅晶片的表面,用作为碱的氨蚀刻氧化硅,并通过剥离去除各种颗粒。此外,如图1所示,在pH 10.5附近的S

jfkj2021的博客 771

三相电路小白必看:正弦量向量表示法保姆级教程(附欧拉公式推导)

本文为电气工程初学者详细解析了三相电路中正弦量的向量表示法,即相量法。通过几何直观和欧拉公式推导,阐明如何将时变正弦量转化为静态复平面向量进行运算,并利用平行四边形法则简化同频正弦量的加减计算。文章结合Python代码进行可视化验证,帮助读者牢固掌握这一分析交流电路的核心工具。

linux6sysadmin的博客 1003

2025年多模态大模型API聚合平台的技术革新与实践

2025年,随着AI技术在多模态领域的突破,企业对高效、低成本的大模型接入需求激增。据行业观察,单一模型API已难以满足复杂业务场景,开发者常面临接口分散、计费繁琐、性能不稳定等痛点。在此背景下,聚合型API服务平台通过技术整合,正逐步成为企业智能化升级的基础设施。随着《生成式AI服务管理办法》在2025年的细化落地,合规性将成为技术选型的关键指标。(注:本文仅作技术探讨,相关数据来源于公开测试报告及厂商白皮书)2025年双十一期间,某头部直播平台采用。

m0_64363449的博客 586

别再只用线性回归了!用sklearn的核岭回归搞定非线性数据(附RBF核调参实战)

本文详细介绍了如何使用sklearn的核岭回归处理非线性数据,特别是RBF核的应用与调参实战。通过网格搜索找到最佳参数组合,核岭回归能有效捕捉数据中的复杂波动,显著提升模型性能。适合需要解决非线性问题的数据科学家和机器学习工程师。

weixin_34246529的博客 339

从原始数据到功能注释,生物信息Agent全流程解析,彻底搞懂序列分析链

掌握生物信息Agent的序列分析全流程,从原始数据质控到功能注释一网打尽。适用于基因组、转录组研究,集成自动化处理、序列比对与注释工具,提升分析效率与准确性。方法清晰实用,科研人员值得收藏。

FastProceed的博客 1091

Cadence OrCAD Capture 软件自带元件原理图符号库目录与介绍图文视频教程

硬件工程师在开始原理图设计时,应该首先拥有自己的元件原理图符号库。基于Capture进行原理图设计的一个很大的优点就是,软件自带的元件库比较全。本文简单介绍Capture软件自带元件库。

fydar的博客 5579

基于pytorch cnn ResNets卷积网络的模糊图像检测 完整代码数据直接运行

基于pytorch cnn ResNets卷积网络的模糊图像检测 完整代码数据直接运行

730

【算法拾光】队列|在每个树⾏中找最⼤值 + 最后⼀块⽯头的重量

本文总结两道经典算法题:一是通过层序遍历(BFS)逐层找最大值,利用队列分层处理,每层维护最大值;二是用大根堆(优先队列)模拟石头碰撞过程,每次取最大两块石头,差值重新入堆,直至剩余一块或无石。前者适用于树的层次遍历,后者适合动态获取最值场景。核心思想:队列用于分层遍历,堆用于高效取极值。

wuqingyigexiaoba的博客 200

【2026华为OD新规机考】最新套题持续更新【完全原创题解 | 详细考点分类 | 不断更新题目 | 六种主流语言Py+Java+Cpp+C+Js+Go】

可上练习华子OD、大厂真题绿色聊天软件戳od1441了解算法冲刺训练(备注【优快云】否则不通过)

weixin_48157259的博客 511

把 KV Cache 压到 FP4:BitDecoding-FP4 的算法-系统协同设计复盘

长上下文推理卡在KV Cache的显存与带宽上,而现有FP4方案要么精度崩、要么速度废。这篇文章复盘BitDecoding-FP4如何用三个算法补丁加一个系统重构,在B300上把服务吞吐提升2.4–3.0倍,精度几乎不掉。

helloagent的博客 318

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

【算法拾光】链表 哈希表|K个一组翻转链表 + 两数之和

K个一组翻转链表需分段反转,借助哑节点与前驱指针维护连接,避免断链;两数之和利用哈希表实现O(1)查找,空间换时间,高效定位目标组合。前者考察链表指针操作,后者聚焦映射关系构建,均为面试高频题。

wuqingyigexiaoba的博客 341

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

排序算法深度笔记(下):非比较类排序的线性突破与工程边界

排序算法时间复杂度额外空间复杂度稳定性是否基于比较选择排序O(N^2)(O(1))不稳定是冒泡排序O(N^2)(O(1))稳定是插入排序O(N^2)(O(1))稳定是归并排序O(N\log N)(O(N))稳定是快速排序O(N\log N)O(log N)不稳定是堆排序O(N\log N)O(1)不稳定是计数排序(O(N + M))O(M))稳定否基数排序O(N)稳定否桶排序平均O(N) / 最坏O(N^2)

2401_87069538的博客 617

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

优选算法:分治-归并排序

交易逆序对的总数

Wangshijie1015的博客 154

408 算法 06|堆与 Top-K:最小的 10 个数,到底该用数组还是堆

2022(42) 找 100 万个数里最小的 10 个,官方给了"10 元素有序数组"和"大根堆"两种答案。我把两种都实现并数了比较次数:k=10 时两者几乎打平,k=10000 时堆少 111 倍。另附 2021(42) 计数排序的比较次数与稳定性实测。

m0_56226131的博客 452

算法64,字母异位词分组

代码核心思路是:互为字母异位词的字符串,在对其字符进行排序后,一定会得到相同的字符串。因此,可以将排序后的字符串作为哈希表的键(Key)来进行分组。

sheshibenniaodan的博客 219

408 算法 04|主元素与三元组最小距离:两种“扫描时做决定“的思路

2013(41) 的主元素用摩尔投票一遍选出候选,但真正的考点是"选完必须验票";2020(41) 的三元组最小距离,三指针每次只挪最小的那个,靠的是 D=2×(max−min) 这个恒等式。两套完整 C 代码加真实输出,附官方评分档位表。

m0_56226131的博客 444

牛客周赛165C题(前后缀性质,递推,排序,枚举)

题目大意:给定长度为 `n` 的数组,选择 `k ∈ [1,n]`,将前 `k` 个元素整体翻转,后面的元素不变。要求操作后的整个数组非递减,统计满足条件的 `k` 的数量。题目链接:https://ac.nowcoder.com/acm/contest/141721/C。时间复杂度:O(nlogn)

2501_94316951的博客 175

【MPC 算法】Python 实战:模型预测控制(MPC)算法原理与代码实现

本文介绍模型预测控制(MPC)原理与Python实现。MPC通过滚动优化预测未来状态,结合系统模型、目标函数与约束条件,动态生成最优控制序列。以一阶温度系统为例,使用CVXPY构建凸优化问题,实现加热功率的智能调控。代码包含模型预测、目标函数设计(含温度跟踪与控制平滑惩罚)、输入约束及滚动更新机制。仿真结果表明,MPC能快速稳定温度至目标值60℃,且控制动作平滑合理,体现其在复杂系统中的优越性。

赖德发的博客 69

算法61,判定是否为字符重排

两字符串能互为重排 ⇔。

sheshibenniaodan的博客 227

【前缀和+复合离散化】题解:双色矩形(two)_数据结构_算法优化_预处理_二维前缀和_STL_C++算法竞赛

给定一个 $n \times n$ 的黑白棋盘,初始按 $i+j$ 奇偶染色,经 $k$ 个格子颜色翻转后,求子矩形中黑白格子数差的绝对值最大值。由于 $n$ 可达 $10^9$,但 $k \leq 50$,可离散化关键点。枚举所有由修改点构成的矩形及其四边向外扩展(共 $16$ 种扩展方式),利用二维前缀和快速计算变化量,结合奇偶性判断多出的格子颜色,最终取最大绝对差。时间复杂度为 $O(k^4)$,在 $k \leq 50$ 下可行。

YLCHUP的博客 214

算法62&&63,存在重复元素

判断整数数组中是否有任意元素出现至少两次。:判断数组中是否存在两个。,且索引差值的绝对值。

sheshibenniaodan的博客 105

商业综合体公摊电费分摊算法:512 商户双层权重与尾差实测

公摊电费分摊算法是指把公共回路电量按公示权重拆到每户的规则化计算过程,核心不是权重多精巧,而是每张账单都能被租户手算复现。某珠三角商业综合体 512 户商户实测:固定费与变动费按 4:6 加权,尾差用余数递补压到 0.01 千瓦时精度,24 个月 12288 张账单重算差异为零,月度争议从 31 起降到 2 起。适用边界:商铺与租户已独立装表、公共回路已分项计量的商业综合体适用;末端未装表、靠总表减合计倒推公摊的场景不适用,先把表补齐再谈分摊。

185
上一篇: AI必看!2024人工智能领域最具突破性的10篇创新论文(附论文)
下一篇: 一个接口,整合所有大语言模型,吴恩达开发的,你就说行不行吧?
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2841原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值