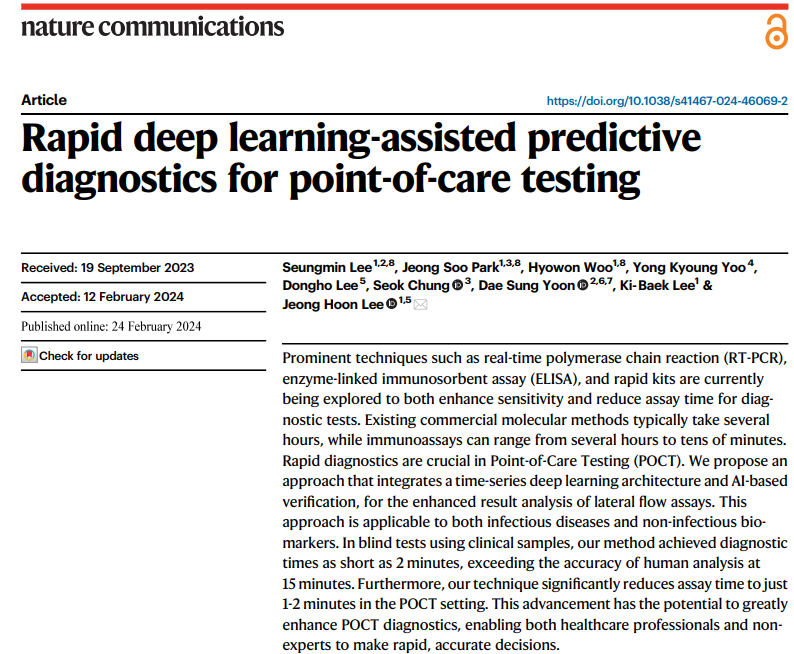
Nature Communications| 用于即时检测的快速深度学习辅助预测诊断

Nature收割机!多尺度特征融合简直“杀”疯了 例如,一种网络通过多尺度的注意力特征融合来处理复杂的任务。通过使用预训练的血管掩码作为先验知识,利用病变和血管之间的相关性,减少了复杂眼底结构引起的病变检测模糊性,提升了模型的准确性,实验结果在DDR和IDRiD数据集上表现出优于其他先进模型的性能。利用全局信息获取外观和运动特征的重要性权重,通过为更重要的模态特征分配更高权重,为较不重要的模态特征分配更低权重,自适应地融合不同模态的特征。通过动态选择不同尺度的特征进行融合,提高了多尺度特征融合的灵活性和融合特征的一致性,解决了不同尺度特征之间的冲突问题。 阅读详情

背景介绍

在即时检测(POCT)中,实现高灵敏度和快速诊断是一个关键挑战。目前,实时聚合酶链反应(RT-PCR)、酶联免疫吸附测定(ELISA)和快速检测试剂盒等技术正在被探索,以提高诊断测试的灵敏度并减少检测时间。现有的商业分子诊断方法通常需要几个小时,而免疫测定可以从几个小时到几十分钟不等。在急诊医疗护理中,迅速和精确的诊断对于患者结果具有深远的影响。例如,心肌梗死患者到达急诊室时,及时诊断和管理至关重要。在这种情况下,疾病和条件的快速识别对患者结果有重大影响。特别是在涉及传染病的情况下,及时诊断在识别病原体和感染中起着关键作用,从而有助于及时实施感染控制措施,避免潜在的爆发,并保护患者和医疗保健提供者的健康。此外,对于急诊室中的孕妇,了解她们的怀孕状态至关重要,尤其是在考虑涉及辐射的医学成像、麻醉或可能影响胎儿健康的治疗时。快速和精确的诊断是指导知情决策、有效管理健康状况的同时,最小化患者和胎儿风险的关键。

主要结果
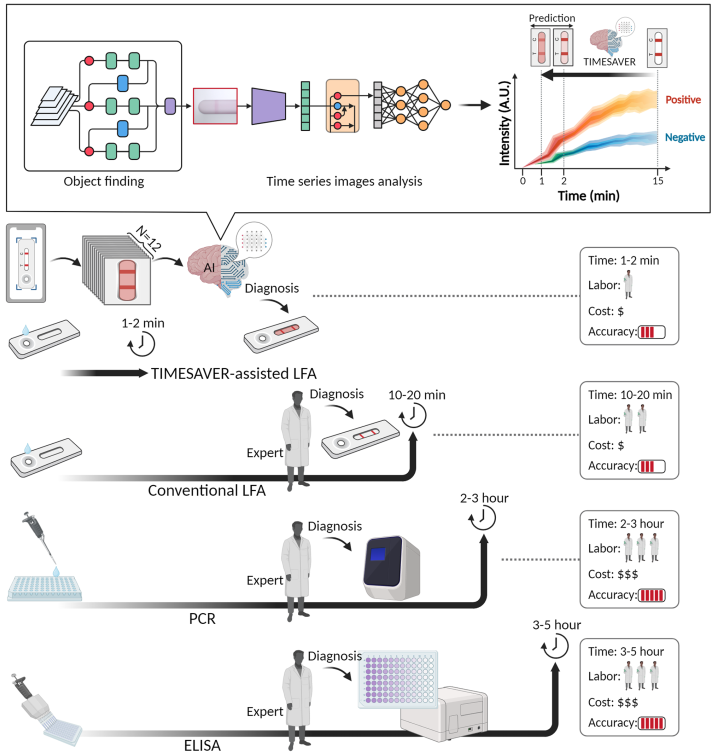
图1:AI驱动的TIMESAVER算法的性能指标。这个示意图展示了三种代表性的商业化诊断工具:商业LFA、PCR和ELISA,以及它们在时间、劳动、成本和准确性方面的性能指标。TIMESAVER算法,利用全面的时间序列深度学习架构,通过基于AI的验证,提供增强的结果分析,所有这些都在快速的1-2分钟检测时间内完成,超越了人类专家15分钟的检测。
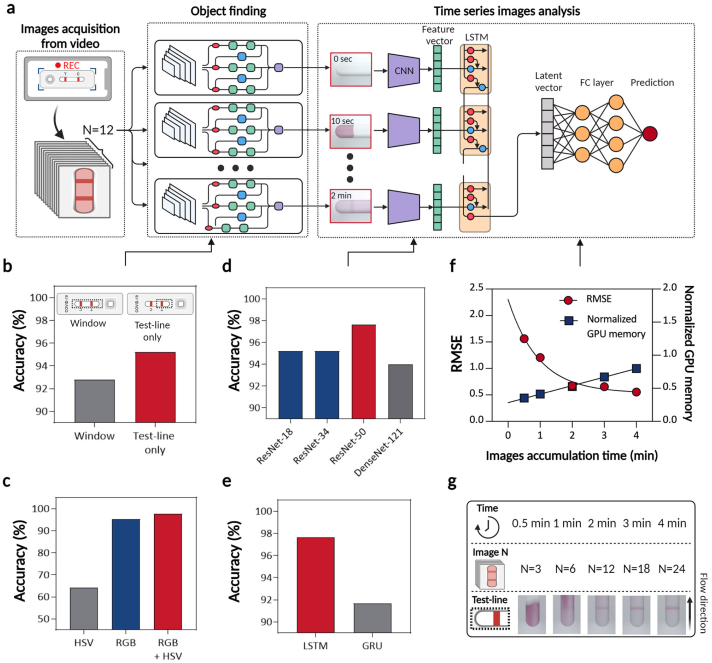
图2:TIMESAVER算法的模型优化。a TIMESAVER算法由使用YOLO的对象检测、通过CNN-LSTM的时间序列图像分析和FC层组成。b 对象查找:在LFA中的两种ROI选择方法比较。仅选择测试线的结果准确度更高(95.2%)与使用窗口(92.9%)相比。c 使用RGB和HSV的数据增强:结合两者达到了97.6%的准确度。d CNN模型优化:ResNet-50展现了最高的准确度97.6%,超过了其他模型。e LSTM优化:LSTM达到了97.6%的准确度,而GRU获得了91.7%。f 均方根误差(RMSE)与归一化GPU内存消耗之间的权衡,展示了基于AI优化的检测时间。g 时间序列图像:连续图像显示了检测随时间的进展。
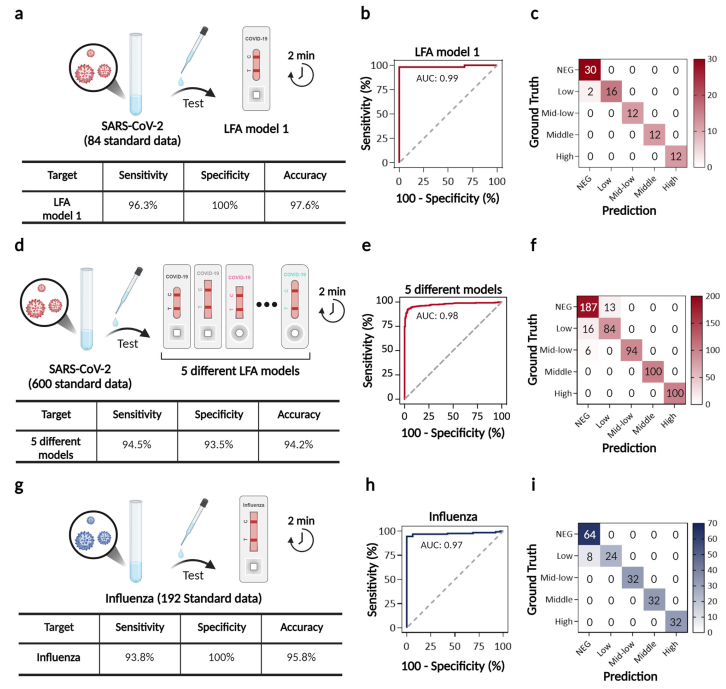
图3:使用TIMESAVER模型对商业LFA进行传染病(COVID-19、甲型/乙型流感)的2分钟检测评估。a TIMESAVER实现了96.3%的灵敏度、100%的特异性和97.6%的准确度。b ROC曲线显示AUC为0.99。c 混淆矩阵突出显示假阴性主要与低浓度样本相关。d-e 评估TIMESAVER算法在不同商业化LFA模型上的性能。f 混淆矩阵表明,区分低浓度和阴性对照对于实现更高准确性至关重要。g-i 流感检测:g 流感模型的灵敏度、特异性和准确度分别为93.8%、100%和95.8%。h ROC曲线的AUC值为0.97。i 混淆矩阵表明,假阴性主要与低浓度样本相关。
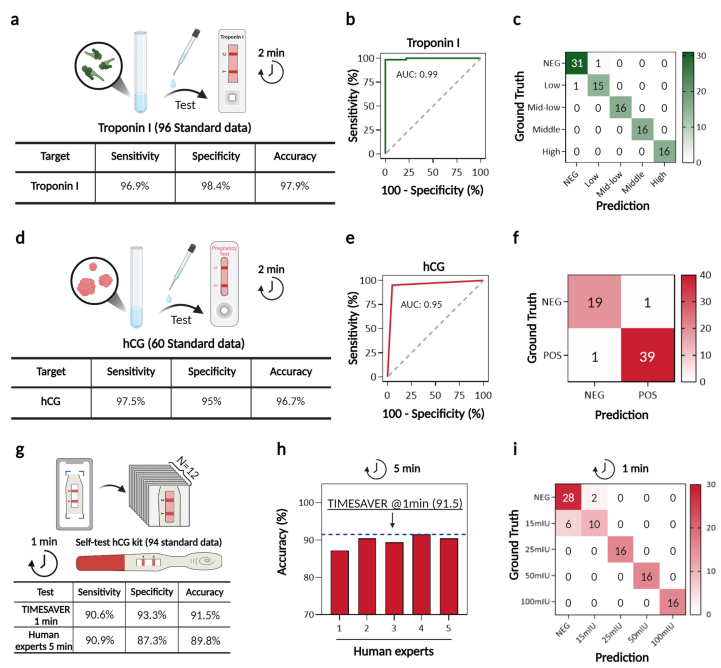
图4:使用TIMESAVER模型评估非传染病生物标志物(肌钙蛋白I和hCG)的检测。a-c 肌钙蛋白I检测:a 肌钙蛋白I检测的灵敏度、特异性和准确度分别为96.9%、98.4%和97.9%。b ROC曲线的AUC值为0.99。c 混淆矩阵。d-f hCG检测:d hCG检测的灵敏度、特异性和准确度分别为97.5%、95.0%和96.7%。e ROC曲线的AUC值为0.95。f 混淆矩阵。g-i 使用94个测试数据评估1分钟hCG自我测试的可行性:g 使用TIMESAVER在1分钟检测中实现了90.6%的灵敏度、93.3%的特异性和91.5%的整体准确度。h TIMESAVER在1分钟的准确度超过了五名专家在5分钟的准确度。i 混淆矩阵表明,假阳性和假阴性主要与低浓度相关。
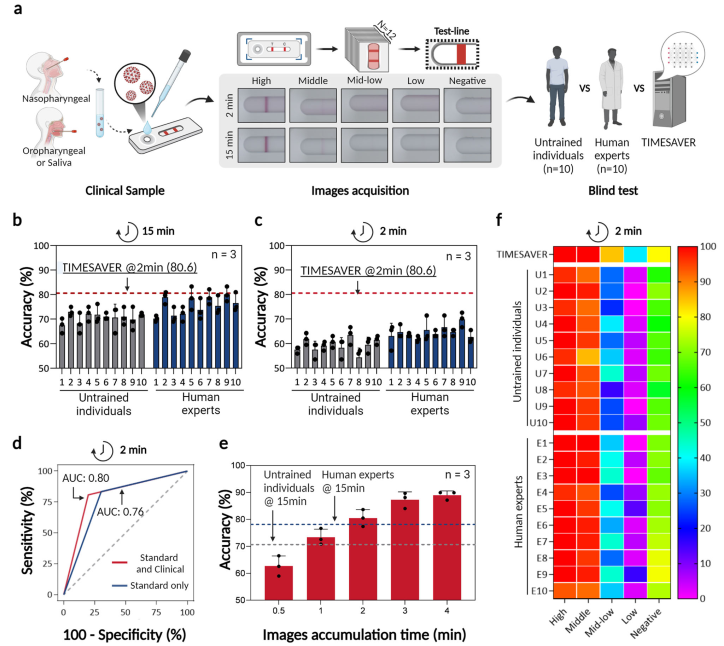
图5:通过盲测使用临床样本对COVID-19进行临床评估。a 十名未经训练的个体和十名人类专家评估了252个数据,包括COVID-19临床样本的各种浓度水平和阴性数据。b, c 盲测结果表明TIMESAVER在2分钟检测中显著快速。d 额外的临床数据提高了AUC(0.80),与仅有标准数据集(0.76)相比。e 在2分钟检测中,TIMESAVER超过了人类专家在15分钟检测中的准确度,达到了80.6%(n=3)。f 热图显示,在中低滴度范围内,TIMESAVER的准确度为84.6%,超过了未经训练的个体(29.2%)和人类专家(37.2%)。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

科研RAG系统实战:从PDF解析到认知图谱构建 RAG(检索增强生成)已超越简单AI搜索,成为科研工作者构建个人知识中枢的核心技术。其本质是将非结构化研究资料——如扫描PDF、学术视频字幕、手写批注与多模态图表——通过语义解析、领域适配的向量化及关系建模,转化为可演化的认知图谱。关键技术价值在于解决信息碎片化、专业术语嵌入失准、跨模态对齐断裂等真实瓶颈,支撑临床指南更新验证、材料实验参数溯源、古籍OCR辨识等高要求场景。本文聚焦生产级落地,详解PyMuPDF+Qdrant+text-embedding-3-large组合如何实现公式保真切片、时效感知检索 阅读详情

相关推荐

深度学习之Encoder-Only原理与实战

【代码】深度学习之Encoder-Only原理与实战。

yumiwangzi30的博客 265

AI架构错配:GPU硬件如何定义大模型的智能边界

人工智能的核心范式正面临一场深层的‘架构错配’——人类大脑是低功耗、实时响应、因果驱动的连续系统,而主流大模型却建立在冯·诺依曼架构与GPU矩阵计算范式之上,依赖批量输入、静态权重和高延迟推理。这种错配源于Transformer对GPU硬件特性的极致适配(如Self-Attention与Tensor Core的天然契合),而非对认知原理的模仿,导致其在边缘部署、流式交互、长时序建模等场景中存在根本性瓶颈。状态空间模型(SSM)、测试时训练(TTT)、神经形态芯片与预测编码等方向,正从计算范式、学习机制与硬件

weixin_30576827的博客 432

深度学习之Seq2Seq原理与实战

【代码】深度学习之Seq2Seq原理与实战。

yumiwangzi30的博客 132

Nature发文:深度学习系统为什么这么好骗?

选自Nature 作者:Douglas Heave 机器之心编译 机器之心编辑部 几张贴纸就能「改变」交通标志识别结果,转个方向就看不出图中的动物种类,今天的人工智能系统经常会出现莫名其妙的 bug。最新一期《自然》杂志上的这篇文章向我们介绍了深度学习为什么如此容易出错,以及解决这些问题的研究方向。 一辆自动驾驶汽车在接近停止标志时非但没有停车,反而加速驶入了繁忙的十字路口。一份事故...

喜欢打酱油的老鸟 1055

深度学习之TF-IDF原理与实战

【代码】深度学习之TF_IDF原理与实战。

yumiwangzi30的博客 187

深度学习之LoRA(低秩适配)原理与实战

【代码】深度学习之LoRA(低秩适配)原理与实战。

yumiwangzi30的博客 258

Nature发布颠覆传统的深度学习范式

文章提出了,一种,通过即可完成预测,,在上超越传统方法(如 XGBoost、CatBoost)。在于,适用于。然而,其在于。整体来看,该研究为,但。TabPFN 的算法流程可以分为以下TabPFN 在(synthetic datasets)上进行,目的是学习一个。采用生成大量,包括。这些合成数据模拟了,让 TabPFN 学习到如何在新数据上做出最优预测。采用进行学习,但与 NLP 任务不同,TabPFN 主要用于。关键创新在于每一行的数据可以关注(类似 NLP 中的 token attention)。

Python_cocola的博客 5046

[工具使用]黑暗引擎FOFA

黑暗引擎FOFAFOFA(点我进入)逻辑运算符搜索子域名domain搜索指定内容的host全部域名bodycert搜索选定应用的网站搜索指定开放端口的IP搜索指定协议的IP搜索IP或者网段的信息搜索指定CSS/JS网站常用的一些内容其他 FOFA(点我进入) 官网这样描述:FOFA是白帽汇推出的一款网络空间资产搜索引擎。它能够帮助用户迅速进行网络资产匹配、加快后续工作进程。例如进行漏洞影响范围分析、应用分布统计、应用流行度排名统计等。 简单理解就是,一个本土加强版shodan,知道某产品在互联网的部署情况、

网络安全知识分享 3万+

文献速递:深度学习乳腺癌诊断---基于深度学习的图像分析预测乳腺癌中H&E染色组织病理学图像的PD-L1状态

BCCA队列中的每位患者有3个H&E染色的TMA核心,一个用于PD-L1的IHC染色的TMA,和一个用于PD-1的。a 一位专家病理学家使用我们设计的计算机辅助注释软件,根据患者的H&E及相应的IHC染色TMA图像,为PD-L1状态进行注释。然而,考虑到数据极度不平衡的特性(仅3%为阳性),这对优化构成了难题,因为用于训练系统的阳性样本非常少,PD-1的AUC结果仍然很高。每位女性有三个H&E染色的TMA核心,一个用于PD-L1的免疫组织化学(IHC)染色的TMA和一个用于PD-1的。

weixin_38594676的博客 953

Unified Access Control:从NAS到RRC的5G接入控制全流程解析

本文深入解析了5G统一接入控制(Unified Access Control)的全流程,从NAS到RRC的协同工作机制。通过身份核验、业务分类和动态决策三个核心步骤,UAC实现了智能调度和弹性决策,确保海量设备接入时的网络稳定性。文章详细介绍了USIM卡的身份凭证体系、NAS层的业务分类引擎以及RRC层的动态决策机制,并提供了实战案例和常见问题排查方法。

weixin_30855099的博客 589

golang 线上事故

golang 线上事故 最近公司要做大促的一些活动。并且单量,qps持续上涨。之前使用的是django python 语言做的一个服务端。目前已经部署的国家里面最多的国家会有300+个实例。大促期间还可能会增加一个实例数。这么多的实例部署,回滚的时间都会特变长,除了问题也不好定位。并且如此多的一个机器,连接数* 实例数也会导致DB等其他服务扛不住这么大的并发。所以决定上go服务解决性能问题。 ...

lcf枫的博客 1537

Deep learning REVIEW--三位大牛的Nature

Yann LeCun 扬·勒丘恩 卷积神经网络之父 YoShua Bengio 蒙特利尔教授 吴恩达的师兄弟 Geoffrey Hinton 神经网络之父 三人合作的深度学习文字(好不容易计算机科学能在nature上发表) 深度学习主要通过反向传播来改变程序的内参,卷积神经网络在图像,视频,语音和音频处理上有应用,循环神经网络...

weixin_33709364的博客 582

YOLOv11的物理信息神经网络(PINN):引入物理规律约束目标运动预测

本文介绍了YOLOv11目标检测与PINN物理信息神经网络的融合技术。YOLOv11采用增强特征提取和参数优化架构,在保持实时性的同时提升检测精度。PINN通过将物理方程嵌入损失函数,实现数据高效学习。两者的结合可显著提升运动预测准确性和遮挡处理鲁棒性。文章详细阐述了环境配置、YOLOv11模型验证方法,并提供了基础PINN框架代码实现,展示了物理约束如何通过自动微分整合到神经网络中。该融合技术适用于自动驾驶、无人机导航等需要物理规律建模的视觉感知场景。

本博客聚焦 YOLOv11 全流程落地,涵盖架构优化、数据集处理、训练技巧与多场景部署,兼及国产数据库、Java 开发与 AI 模型应用,内容兼顾理论与工程实践,为开发者提供系统干货,助力高效提升技术能力。 423

Nature期刊以及子刊与膝关节相关的研究

膝关节作为人体最大且最复杂的承重关节,其结构完整性与功能稳定性对运动能力及生活质量具有决定性影响。近年来,随着影像学、分子生物学与计算模拟技术的发展,自然系列期刊(Nature, Nature Medicine, Nature Biomedical Engineering, Nature Communications 等)持续发表关于膝关节疾病机制、早期诊断、再生修复及个性化治疗策略的重要研究成果。以下为基于近五年内发表于Nature及其子刊的相关论文整理的技术文章大纲。

qq_46981910的博客 424

DBT关键切片重建算法

DBT通过有限角度(通常15°~50°)扫描,获取一系列低剂量投影图,重建出三维断层图像。传统FBP在稀疏角度下会产生严重的“伪影拖尾”和层间干扰。临床诊断中,放射科医生往往只关注几层关键切片(即病灶所在层),其余层仅作参考。

AI的内部世界的博客 89

9.20华为OD机试真题 新系统 - 字符串分组求和 (Java/Py/C/C++/Js/Go)

9.20华为OD机试真题 新系统 - 字符串分组求和 (Java/Py/C/C++/Js/Go)

算法大师! 587

博士研究者的学术能力补给系统:十门免费高价值课程精析

学术研究能力并非知识堆砌,而是工具应用、思维建模与专业表达三位一体的动态系统。在Ph.D.阶段,真正制约科研效能的常是文献管理失序、统计误用、代码不可复现、论文叙事乏力等结构性短板。本文聚焦‘学术操作系统补丁’理念,基于真实研究工作流提炼出覆盖R语言实战、批判性思维训练、学术英语动词精准化、数据伦理决策、跨学科表达转译等核心能力的十门高质量免费课程。所有课程均支持旁听模式,直击方法论断层与生产力瓶颈,助力研究者实现从‘会做’到‘做对’再到‘说清’的能力跃迁。

weixin_33836874的博客 281

【项目实战】TARA威胁分析和风险评估

TARA是信息安全领域中的一种风险评估方法,在汽车信息安全的上下文中,TARA分析特别重要,因为它可以帮助识别和管理与智能网联车辆相关的各种威胁,包括数据泄露、未经授权的访问、远程操控等。通过TARA分析,企业可以制定出针对性的安全目标、产品要求和产品安全声明,以确保汽车及其零部件符合相关的信息安全标准和法规。此外,TARA分析还可以与数字化建模系统结合,以更系统化和高效的方式进行风险评估和管理。

奶爸的编程之路,也就一周冷个三天 2710

Nature:Deep Learning 深度学习综述

翻译:https://artificial-intelligence.net.cn/2019/06/05/1559711811/?from=singlemessage&isappinstalled=0 作者:Yann LeCun, Yoshua Bengio ,Geoffrey Hinton 发表及时间:Nature,2015 概念:深度学习允许由多个处理层的计算模型来学习具有多个...

因为懂得的博客 1万+

SAP CPI 之使用国密算法实现SM系列算法加解密

System.out.println("SM2-私钥:" + privateKey);System.out.println("SM2-公钥:" + publicKey);System.out.println("SM2-密文:" + encrypts);System.out.println("SM2-明文:" + data2);新建groovy,通过import之后,调用jar包中的方法。在CP中导入jar包,选择Upload,选中导入的jar包。的密钥和向量值,不安全!的公钥和私钥,不安全!

u012830826的博客 1335

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

Nature:深度学习的现在和未来:DeepLearning、无监督学习、NLP

最新的《Nature》杂志专门为“人工智能 + 机器人”开辟了一个专题 ,发表多篇相关论文,其中包括了LeCun、Bengio和Hinton首次合作的这篇综述文章“Deep Learning”。本文为该综述文章中文译文的上半部分。 【编者按】三大牛Yann LeCun、Yoshua Bengio和Geoffrey Hinton在深度学习领域的地位无人不知。为纪念人工智能提出60周年,最新

zzou清月灵兮的博客 3万+

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

深度学习0:数学知识:正态分布1

步骤内容结果1引入e−x2e^{-x^2}e−x2钟形曲线2算它的面积I∫−∞∞e−x2dxI∫−∞∞​e−x2dx3平方变成二重积分I2I^2I24换极坐标简化计算5算出I2πI^2 = \piI2πIπIπ​6代入σ\sigmaσ和μ\muμ做变量替换得到σ2πσ2π​7除以它归一化得到正态分布公式2π2π​不是随便写的,它来自高斯积分∫−∞∞e−x2。

tellmewhoisi的博客 195

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

【原创深度学习项目】基于深度学习的建筑工地防护装备检测系统|安全帽与反光衣检测系统(RT-DETR-L 模型)

本文设计并实现了一套基于RT-DETR-L的建筑工地防护装备检测系统,采用Django+Vue前后端架构,实现对安全帽、反光背心等7类装备及“无PPE”“未戴安全帽”等缺失状态的精准识别。系统支持图片、视频、摄像头实时检测,具备参数可调、数据可视化与统计分析功能,有效解决小目标漏检、误检及管理难问题,助力智慧工地安全管理落地。文末可获取源码。

qq_1445749146的博客 215

图解循环神经网络(RNN)

RNN(循环神经网络)就是“带记忆的网络”:让网络拥有一块“记忆”,在处理当前数据时,能同时参考之前看过的内容;它不一次性看完全部输入,而是像人读书一样,一个字一个字地读,每读一个字就更新一次脑子里的记忆,然后用这份记忆去理解当前这个字。但便签一直在被改写,新信息不断挤占旧信息,传到第 40 步时,“巴黎”的痕迹已经淡得几乎没了。读到“贵”的时候,网络并没有重新去查“好看”这个词——但“好看”的影响已经融在了便签里(那个 1.5)。这三个困难的共同点:答案不在当前这一个字里,而在“前面那串东西”里。

技术管理两手抓,两手都要硬. 358

神经网络入门指南:从 CNN、RNN 到 Attention

神经网络的学习,本质是“预测—比较—纠错”的循环;CNN 通过局部连接与权重共享理解图像;RNN 通过隐藏状态传递上下文;LSTM 和 GRU 用门控机制管理记忆;Encoder–Decoder 把理解与生成拆成两个阶段;Attention 则让模型在每一步都能主动寻找最相关的信息。到这里,我们已经走完了从普通神经网络到 Attention 的完整路线。下一篇将正式进入 Transformer,看看它如何摆脱 RNN 的顺序计算,又如何让每个 Token 直接找到与自己相关的信息。

爱敲代码的小黄 353

基于深度学习的垃圾分类系统的设计与实现

本系统是一个基于 Flask Web 框架与 PyTorch 深度学习模型的垃圾分类智能识别平台。系统面向垃圾图像分类场景,能够对上传图片中的玻璃、纸张、纸板、塑料、金属、其他垃圾等六类垃圾进行自动识别与置信度评估,并提供识别历史、数据统计、模型在线训练与记录导出等完整功能。系统使用 TrashNet 公开垃圾分类数据集进行模型训练,管理员可手动发起模型训练,训练完成后自动加载新权重。启动服务不会自动训练。

aiyuanma_vip的博客 385
上一篇: 构建生产级 RAG 系统前,必须搞懂的 7 个核心问题
下一篇: 本地部署LLM工具大比拼:谁才是你的智能之选?
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值