OPENSCHOLAR-基于大模型RAG的科研专家

OpenScholar:华盛顿大学联合艾伦研究所开源的学术搜索工具 OpenScholar是由华盛顿大学和艾伦AI研究所联合开发的开源学术搜索工具,旨在通过检索和综合科学文献中的相关论文来回答用户问题。该工具利用大规模科学论文数据库、定制的检索器和重排器,以及一个优化的8B参数语言模型,生成基于实际文献的准确回答。OpenScholar在提供事实性回答和准确引用方面超越了现有的专有和开源模型,所有相关代码和数据均已开源,支持并加速科学研究。 阅读详情

摘要

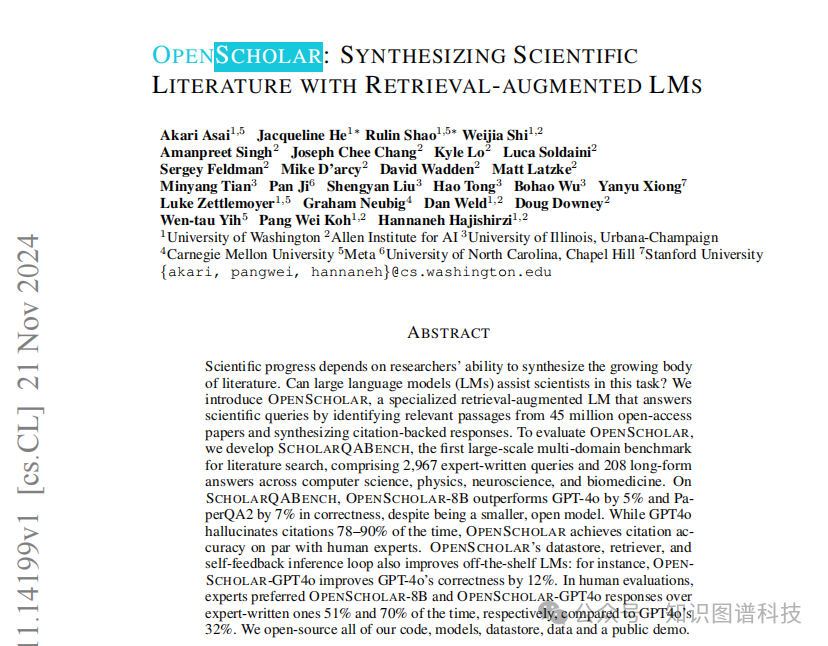
科学进步取决于研究人员综合不断增长的文献的能力。大型语言模型 (LM) 能否帮助科学家完成这项任务?

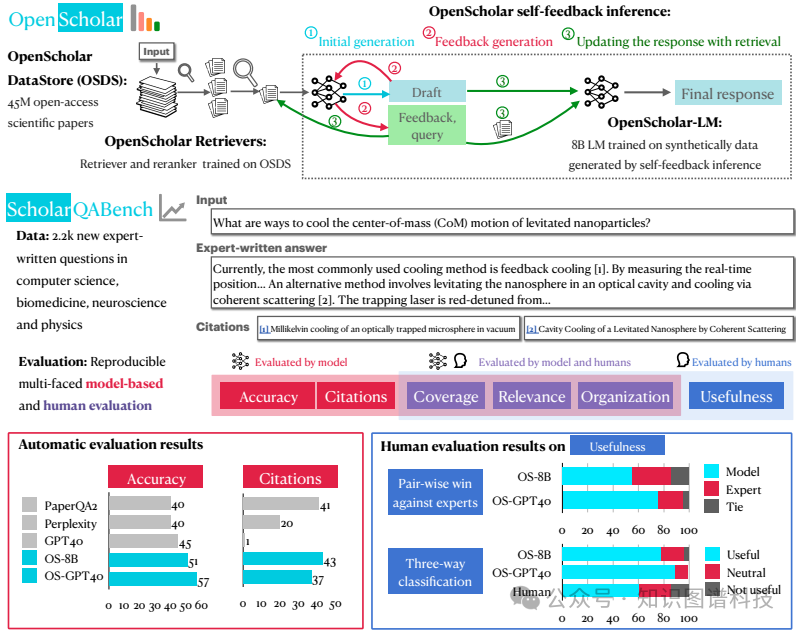
我们介绍了 OpenScholar ,这是一种专门的检索增强 LM,它通过从 4500 万篇开放获取论文中识别相关段落并综合引文支持的回复来回答科学问题。

为了评估 OpenScholar,我们开发了 ScholarQABench,这是第一个用于文献搜索的大规模多领域基准,包括 2,967 个专家撰写的查询和 208 个长篇答案,涵盖计算机科学、物理学、神经科学和生物医学。

在 ScholarQABench 上,OpenScholar -8B 的正确性比 GPT-4o 高出 5%,比 PaperQA2 高出 7%,尽管它是一个更小的开放模型。虽然 GPT4o 在 78-90% 的情况下会产生引文幻觉,但 OpenScholar 的引文准确性与人类专家相当。OpenScholar 的数据存储、检索器和自反馈推理循环也改进了现成的 LM:例如,OpenScholar -GPT4o 将 GPT-4o 的正确性提高了 12%。

在人工评估中,专家分别有 51% 和 70% 的时间更喜欢 OpenScholar -8B 和 OpenScholar -GPT4o 的回答,而不是专家编写的回答,而 GPT4o 的回答为 32%。我们开源了所有代码、模型、数据存储、数据和公开演示。

OpenScholar: Synthesizing Scientific Literature with Retrieval-augmented LMs

https://arxiv.org/html/2411.14199v1

相关链接
openscholar.allen.ai/Blogallenai.org/blog/openscholar__OpenScholar codegithub.com/AkariAsai/OpenScholar__ScholarBench codegithub.com/AkariAsai/ScholarBenchCheckpoints, Data, IndexOpenScholar/openscholar-v1Expert EvaluationAkariAsai/OpenScholar_ExpertEval

核心速览

研究背景

  1. 研究问题:这篇文章要解决的问题是如何利用大型语言模型(LLMs)来辅助科学家综合科学文献。具体来说,研究如何通过检索增强的语言模型(Retrieval-Augmented Language Models, RAG)来回答科学查询,识别相关段落并合成引用支持的响应。

  2. 研究难点:该问题的研究难点包括:LLMs的幻觉问题、依赖过时的预训练数据以及缺乏透明的引用归属。例如,在计算机科学和生物医学领域,GPT-4在引用最新文献时,有78-90%的时间会编造引用。
  3. 相关工作:该问题的研究相关工作包括检索增强的语言模型(如Lewis et al., 2020; Guu et al., 2020),但这些系统通常依赖于黑箱API或通用LLMs,没有针对科学领域进行优化,也没有使用开放的科学领域特定的检索数据存储。此外,科学文献综合的评估工作有限,通常使用单学科和小规模的人类评估(如Agarwal et al., 2024; Zheng et al., 2024)或简化的任务(如多项选择题问答)。

研究方法

这篇论文提出了OPENSCHOLAR,一种专门用于科学文献综合的检索增强语言模型。具体来说,

  1. 数据存储和检索器:OPENSCHOLAR使用了一个包含4500万篇开放获取论文的大型数据存储(OPENSCHOLAR-DATASTORE, OSDS),并为这些论文构建了相应的段落嵌入。检索器首先从ODS中检索段落,然后使用重排器对检索到的段落进行精炼和排序。
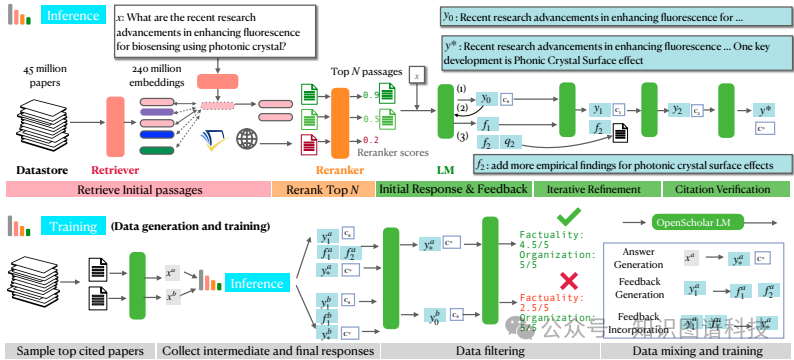
  2. 迭代自我反馈生成:在推理时,OPENSCHOLAR首先生成初始响应,并通过自然语言反馈迭代改进其输出。具体步骤包括:生成初始响应和反馈、使用反馈进行迭代细化、引用验证。

  3. 训练数据生成:为了训练一个更小但更具竞争力的8B模型,OPENSCHOLAR通过推理时管道生成高质量的训练数据。具体步骤包括:从数据存储中采样论文摘要、生成信息检索查询、使用OPENSCHOLAR推理时管道生成高质量响应。

实验设计

  1. 数据收集:OPENSCHOLAR使用peS2o v3.1作为数据源,包含截至2024年10月的4500万篇论文。每篇论文的主文被分割成250词的文本块,并与论文标题连接形成段落。

  2. 样本选择:在单篇论文任务中,使用了SciFact、PubMedQA和QASA等现有数据集,并从这些数据集中提取出需要多篇论文回答的问题。在多篇论文任务中,招募了博士研究人员生成复杂科学问题,并要求他们从整个开放获取的论文集合中检索相关信息。

  3. 参数配置:对于8B模型,使用Llama 3.1 8B进行训练,训练数据来自Ivison et al. (2023)和SciRIFF (Wadden et al., 2024)。训练过程中,设置了最大上下文长度为10k,批量大小为1,梯度累积步长为2,优化器为AdamW。

结果与分析

  1. 单篇论文任务:在单篇论文任务中,OPENSCHOLAR的OS-8B和OS-70B在最终正确率和引用准确率方面均优于其他模型。例如,OS-70B在PubMedQA和QASA任务上的表现与GPT-4o相当甚至更好。

  2. 多篇论文任务:在多篇论文任务中,OPENSCHOLAR-8B、70B和GPT4o(OS-8B、OS-70B和OS-GPT4o)表现出强大的性能。OS-GPT4o在SCHOLAR-CS任务上的正确率比GPT4o提高了12.7个百分点,比标准RAG提高了5.3个百分点。

  3. 自动评估:在自动评估中,OPENSCHOLAR在引用准确率、内容质量和组织等方面均优于其他模型。例如,OS-8B在SCHOLAR-CS任务上的引用准确率为47.9%,而GPT4o仅为31.1%。
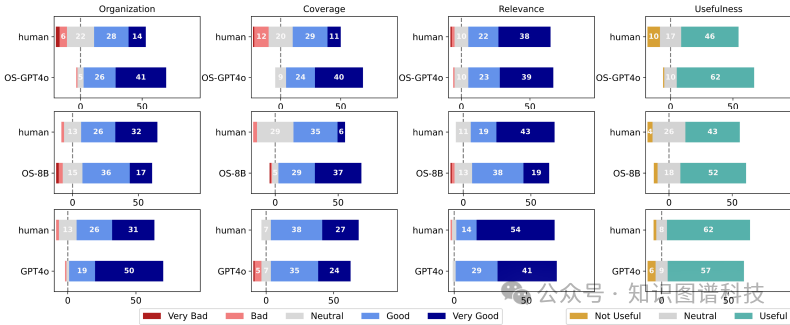
  4. 人类评估:在人类评估中,OPENSCHOLAR-GPT4o和OS-8B在有51%和70%的情况下优于人类编写的答案。专家评估显示,OPENSCHOLAR生成的答案在覆盖范围和组织方面优于人类编写的答案。
总体结论

这篇论文提出了OPENSCHOLAR和SCHOLARQABENCH,分别用于解决科学文献综合问题和评估文献回顾自动化。OPENSCHOLAR通过检索增强和迭代自我反馈生成,显著提高了科学文献综合的质量和准确性。SCHOLARQABENCH提供了一个标准化的大规模多领域评估基准,支持多种科学领域的文献回顾任务。实验结果表明,OPENSCHOLAR在多个任务和评估中均优于现有的系统和人类编写的答案。论文还开源了OPENSCHOLAR的所有代码、模型、数据存储和SCHOLARQABENCH基准,以支持和加速未来的研究工作。

论文评价

优点与创新

  1. 创新的检索增强模型:OPENSCHOLAR是一个创新的检索增强语言模型,专门用于科学文献的合成。它通过结合检索和自反馈生成来提高响应的质量和准确性。

  2. 大规模数据集:OPENSCHOLAR使用了包含4500万篇开放获取论文的OPENSCHOLAR-DATASTORE,这是目前最大的开源科学领域数据集。

  3. 多领域基准测试:SCHOLARQABENCH是一个大规模的多领域基准测试,涵盖了计算机科学、物理学、神经科学和生物医学四个领域,提供了现实且可复现的评估。

  4. 高质量训练数据:通过自反馈生成高质量的训练数据,使得较小的、更高效的模型也能生成高质量的输出。

  5. 专家评估:进行了详细的专家评估,涉及16位来自计算机科学、物理学和生物医学领域的科学家,结果显示OPENSCHOLAR生成的答案在覆盖率和组织性方面优于人类编写的答案。

  6. 开源生态系统:所有代码、模型、数据存储、数据和公共演示都开源,支持并加速未来的研究工作。

不足与反思

  1. 数据集规模限制:由于招募专家注释者的成本和时间的限制,带有人类编写答案的评估数据集相对较小,这可能引入统计方差和潜在的偏见。

  2. 自动评估管道的局限性:自动评估管道可能无法完美地捕捉生成内容的质量,特别是在评估引用精度和覆盖范围时。

  3. 注释者的专业知识:注释者的专业知识可能无法完全覆盖所有领域,特别是那些访问论文数据受限的领域。

  4. 模型能力的局限:尽管OPENSCHOLAR在多个方面表现出色,但它仍然依赖于预训练的模型,这些模型可能会随着时间的推移而演变,影响结果的复现性。

  5. 未来工作方向:未来的研究可以探索如何更好地整合版权受保护的论文内容,并进一步提高模型在科学文献综述任务中的表现。

关键问题及回答

问题1:OPENSCHOLAR在处理科学文献综述任务时,如何确保引用的准确性和透明度?

OPENSCHOLAR通过以下步骤确保引用的准确性和透明度:

  1. 数据存储和检索器:OPENSCHOLAR使用了一个包含4500万篇开放获取论文的大型数据存储(OPENSCHOLAR-DATASTORE, OSDS),并为这些论文构建了相应的段落嵌入。检索器首先从ODS中检索段落,然后使用重排器对检索到的段落进行精炼和排序。

  2. 迭代自我反馈生成:在推理时,OPENSCHOLAR首先生成初始响应,并通过自然语言反馈迭代改进其输出。具体步骤包括:生成初始响应和反馈、使用反馈进行迭代细化、引用验证。通过这种方式,模型能够在生成响应的过程中不断校正和验证引用的准确性。

  3. 引用验证:在生成最终响应后,OPENSCHOLAR会指示生成器LM验证响应中的引用。具体来说,模型确保所有需要引用的陈述都有适当的引用支持,并且在移除引用后不会影响响应的完整性。

问题2:SCHOLARQABENCH作为一个大规模多领域评估基准,具体包括哪些任务和评估指标?

SCHOLARQABENCH包括以下任务和评估指标:

  1. 单篇论文任务:这些任务包括SciFact、PubMedQA和QASA等现有数据集,主要评估模型在单篇论文中的表现,如事实准确性、引用准确性和答案质量。

  2. 多篇论文任务:这些任务包括SCHOLARQA-CS、SCHOLARQA-BIO、SCHOLARQA-NEURO和SCHOLARQA-MULTI,要求模型从多篇论文中检索和综合信息,生成长形式的答案。评估指标包括答案的正确性、引用准确率、内容覆盖范围、组织结构和整体有用性。

  3. 自动评估:使用Prometheus和osunlp/attrscore-flan-t5-xl等工具对生成的答案进行自动评估,涵盖引用准确率、内容质量和组织结构等方面。

  4. 人类评估:招募博士研究人员对模型生成的答案进行详细评估,评估指标包括答案的正确性、引用准确率、内容覆盖范围、组织结构和整体有用性。

问题3:OPENSCHOLAR在人类评估中的表现如何,与其他模型相比有哪些优势?

在人类评估中,OPENSCHOLAR的表现显著优于其他模型,具体优势包括:

  1. 正确答案率:OPENSCHOLAR-GPT4o和OS-8B在有51%和70%的情况下优于人类编写的答案,显示出其在生成高质量答案方面的能力。

  2. 覆盖范围和组织:专家评估显示,OPENSCHOLAR生成的答案在覆盖范围和组织方面优于人类编写的答案。具体来说,OPENSCHOLAR能够提供更广泛和深入的信息,组织更加清晰和有逻辑。

  3. 整体有用性:在人类评估中,OPENSCHOLAR-GPT4o和OS-8B的答案被认为是有用的比例分别为80%和72%,显著高于人类编写的答案。

  4. 引用准确性:OPENSCHOLAR在引用准确率方面也表现出色,生成的答案中引用的论文大多真实存在且相关,减少了虚假引用的问题。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

OpenScholar与Installatron集成解决方案指南 OpenScholar是一个为学术界设计的 Drupal 发行版,旨在帮助教育机构和学者搭建和管理他们的个人或团队网站。它提供了一系列的工具和功能,包括但不限于内容管理、事件日历、个人主页以及协作工具。本章将向读者介绍OpenScholar的核心功能,并探讨其如何简化学术网站的搭建和维护流程,从而使用户能够更加专注于研究和学术交流。 阅读详情

相关推荐

基于OpenCV的驾驶疲劳检测与预警系统设计

PERCLOS(Percentage of Eye Closure)是一种基于眼睑闭合程度的疲劳度量指标。在基于OpenCV的驾驶疲劳检测与预警系统设计中,PERCLOS可以用于检测驾驶员的眼睑闭合程度,以判断其是否疲劳。该函数用于检测视频流中人脸的疲劳程度。具体地,该函数通过检测人脸的眼睛和嘴巴的状态来评估人脸的疲劳程度。眼睛状态是通过计算眼睛的长宽比(eyear)来判断,如果长宽比小于某个阈值,则认为眼睛闭合,表示人处于疲劳状态。

2301_79810943的博客 2327

高效科研新范式:OpenScholar智能文献分析工具全攻略

OpenScholar是一款基于检索增强生成技术(RAG:检索增强生成技术)的开源学术工具,专为科研工作者与AI开发者设计。通过文献检索增强与科学文献分析的深度融合,该工具实现了科研文献的智能检索、精准分析与深度综合,为学术研究提供一站式解决方案。本文将从项目价值、环境部署、核心功能、场景拓展及生态矩阵五个维度,全面介绍OpenScholar的使用方法与技术细节。 ## 一、项目核心价值:智能文

gitblog_01036的博客 1647

【迁移学习综述】

迁移学习的目标是将某个领域或任务上学习到的知识应用到不同的但相关的领域或问题中。迁移学习的研究来源于一个观测:人类可以将以前的学到的知识应用于解决新的问题,更快的解决问题或取得更好的效果。迁移学习被赋予这样一个任务:从以前的任务当中去学习知识(knowledge)或经验,并应用于新的任务当中。换句话说,迁移学习目的是从一个或多个源任务(source tasks)中抽取知识、经验,然后应用于一个目标领域(target domain)当中去。

afadgas的博客 4319

【亲测免费】 OpenScholar 使用教程

OpenScholar 使用教程 1. 项目介绍 OpenScholar 是一个基于检索增强的语言模型(LM)的开源项目,旨在帮助科学家有效地浏览和综合科学文献。它通过首先在文献中搜索相关论文,然后基于这些来源生成响应,来回答用户的查询。 2. 项目快速启动 在开始之前,请确保您的环境中已安装以下依赖: conda create -n os_env python=3.10.0 conda acti...

gitblog_00484的博客 2038

玩转ubuntu18 --机器视觉方面(yolo算法识别及摄像头和cmake问题解决)

玩转ubuntu18 --机器视觉方面(yolo v3算法识别) 1.YOLO的简介 工作原理 先前的检测系统重新调整分类器或本地化器以执行检测。他们将模型应用于多个位置和比例尺的图像。图像的高分区域被视为检测。 我们使用完全不同的方法。我们将单个神经网络应用于整个图像。该网络将图像划分为区域,并预测每个区域的边界框和概率。这些边界框按预测概率加权。 我们的模型比基于分类器的系统具有几个优势。它在测试时间查看整个图像,因此其预测由图像中的全球上下文提供信息。它还通过单一网络评估进行预测,这与R-CNN等系统

qq_53951823的博客 1556

redhawk:Low Power Analysis

1.rush current与switch cell 在standby状态下为了控制leakage power我们选择power gating的设计方式,使用power switch cell关闭block/power domain的电源。 power switch的基本介绍可见: 低功耗设计-Power Switch power switch的table中有四种状态,对应block工作、待机和上电,下电。low power analysis主要分析上电的过程。 上电过程可以看做mos电容

m0_61544122的博客 3203

OpenScholar 科学文献检索增强工具使用指南

OpenScholar是一个基于检索增强生成技术(RAG管道→检索增强生成技术流程)的开源项目,专为科学家设计的文献综合工具。它通过先检索相关论文再生成回答的方式,帮助研究人员高效处理学术文献。项目核心包含四大模块: [![OpenScholar工作流程图](https://raw.gitcode.com/gh_mirrors/op/OpenScholar/raw/a23324bd2042d21

gitblog_00983的博客 615

6、Cocos2D游戏开发:精灵添加与角色实现

本文详细介绍了在Cocos2D游戏开发中如何添加背景精灵和玩家角色精灵。通过创建GameScene场景、组织项目资源、使用多分辨率图像适配不同设备,并深入讲解了将角色拆分为上下半身以实现更真实瞄准效果的原理。文章还解析了Cocos2D的图像搜索机制、锚点概念及其应用,以及如何通过父子节点关系管理复合角色。最终实现了猎人角色在场景中的正确显示与定位,为后续动画和交互功能打下基础。

e3f4g5的博客 90

OpenScholar:科研领域的革命性开源神器,4500万论文检索增强生成靠谱回答

该系统利用大规模的科学论文数据库,通过定制的检索器和重排器,以及一个优化的8B参数语言模型,生成基于实际文献的、准确的回答。: 在专家评审中,51%的情况下,专家更倾向于OpenScholar-8B的回答,而OpenScholar结合GPT-4o的版本更是达到了70%的偏好率,远超GPT-4o的32%。相比之下,GPT-4o在78%–90%的情况下会生成虚假的引用。OpenScholar的性能结果在多个方面展现出了显著的优势,这些结果不仅证明了其技术的实力,也显示了其在科学研究中的潜在应用价值。

qq_26303031的博客 1338

【Unity 实用工具篇】✨| 使用Fungus插件制作一个对话系统,简单好学易上手

今天带来的是Unity中一款简单易用的对话插件Fungus,它是一个免费的交互式的对话系统。 Fungus是Unity免费的一款开源的插件,它可以无代码的实现玩家与NPC之间的对话,并且支持本地化,对相机、Sprite及音乐音效的控制。 学会使用该插件就可以做一些对话剧情类的游戏了,还是非常好用的,下面就来学习一下Fungus具体怎么使用吧!

努力前行,总会成为自己心中的那道光 1万+

【数据集3】高分辨率统计降尺度日值数据集NEX-GDDP的介绍与下载方法

对NEX-GDDP数据集进行介绍和下载说明

WW、forever的博客 2392

OpenScholar 模型实战:如何用 AI 写零幻觉的学术论文(附完整代码)

当前通用大模型在学术论文创作中存在致命缺陷——幻觉,实验数据显示,GPT-4o在生物医学领域的虚假引用率高达94.8%,计算机科学领域亦达78.7%,Llama 3.1的幻觉率更是突破97%,严重影响学术创作的严谨性与可信度。这类幻觉主要表现为虚构实验数据、伪造文献引用、编造研究结论三大类,不仅会导致论文投稿被拒,更可能误导后续研究方向,违背科研诚信原则。

学海无涯,笃行致远 983

地统计插值学习心得(一)

(创建地统计图层工具用于根据现有的地统计图层或者地统计模型来创建包含新要素数据集的地统计图层,也就是使用构建好的地统计模型用到新的数据集中)这表明,远离极值的区域预测不受极值的影响,并且还表明,包括极值会导致钼元素浓度高的区域周围的预测明显变高。通常,我们使用同一个数据集进行建模和预测,但是在实际插值过程中,这两步的数据可以是不同的,这就是处理极值的诀窍。如果你的数据集有无法忽略的极值时(比如这些钼元素浓度),一种常见的方法是首先显式移除极值进行建模,然后在预测中使用整个数据集(包括极值)。

JData_Engineer的博客 286

错过等一年!Open-AutoGLM开源首周深度解读:本地部署最佳实践TOP5

解决本地部署难题,智谱开源Open-AutoGLM带来高效自动化方案。本文深度解读开源首周最佳实践TOP5,涵盖安装配置、模型加载、多场景适配与性能优化技巧,助力开发者快速构建本地AutoGLM应用,提升开发效率。方法实用,步骤清晰,值得收藏。

PixelGlow的博客 838

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

最新开源:开源科研神器 OpenScholar 来了!能检索4500万篇论文,科研效率提升10倍!

本质上,OpenScholar 是一个进行过检索增强(retrieval-augmented)的语言模型,外接一个包含4500万篇论文的数据库,性能可以优于专有系统,甚至媲美人类专家。为了方便自动化评估,研究团队还推出了全新的大规模基准 ScholarQABench,覆盖了CS、生物、物理等多个学科,用于评价模型在引用准确性、涵盖度和质量的等方面的表现。总体而言, OpenScholar 实现了SOTA性能,大大优于 GPT-4o 和相应的标准 RAG 版本,以及 PaperQA2 等专用的文献综述系统。

u012744245的博客 1万+

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

解锁学术研究新范式:OpenScholar文献分析的5个实用技巧

如何在10分钟内搭建起专业的文献分析工作站?OpenScholar提供了轻量化的环境配置方案,即使是实验室的老旧服务器也能流畅运行。 🔍 **操作步骤**: ```bash # 创建专用虚拟环境 conda create -n scholar_env python=3.10.0 -y conda activate scholar_env # 安装核心依赖 pip install -r req

gitblog_00497的博客 646

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

OpenScholar助高效检索和整合科学文献?

近日,华盛顿大学和艾伦人工智能研究所Ai2推出的语言模型(LM)工具OpenScholar,可帮助科学家高效检索和整合科学文献。OpenScholar通过首先搜索相关文献,再基于这些文献生成回答,为用户提供准确可靠的查询解答。从事科研的人都离不开读文献。然而,如今每年发表的论文数量已达数百万篇(例如,某位大佬在硕博期间就发表了178篇~)。在如此海量的文献中,如何高效利用宝贵的时间获取所需信息,显得尤为重要。OpenScholar基于4500万篇科学文献内容回答提问者的问题。

qq_21478261的博客 504

Secret Llama性能优化终极方案:加速模型加载和推理速度的完整指南

Secret Llama是一款完全在浏览器中运行的私密LLM聊天机器人,支持Llama 3和Mistral等开源模型。它最大的优势是完全私有化,对话数据永远不会离开你的计算机,且无需服务器即可运行。本文将为您揭秘如何通过优化配置和最佳实践,显著提升Secret Llama的模型加载速度和推理性能。 ## 🚀 为什么Secret Llama需要性能优化? Secret Llama基于webll

gitblog_00574的博客 1167

Nature 重磅!OpenScholar这个开源 AI 系统,文献综述能力超越人类专家

科学研究的本质是站在巨人的肩膀上。但当巨人的数量以指数级增长时,我们需要新的工具来帮助我们找到正确的肩膀。开放、透明、可信赖的 AI 辅助科研它不完美,仍有局限(如跨学科泛化能力需进一步验证、自反馈机制增加计算开销),但它证明了开源系统在专业领域可以达到甚至超越专有系统的水平。对于每一位科研工作者来说,这可能是一个信号:是时候认真考虑如何将这类工具纳入你的研究流程了。

Orange_Yang123的博客 386

提升科研效率:OpenScholar如何让文献检索从繁琐到高效

在科研工作中,文献检索常常是研究的起点,却也可能成为效率瓶颈。想象一下,当你需要探索"如何利用光子晶体增强生物传感的荧光效率"这样的专业问题时,面对4500万篇潜在文献,传统关键词搜索往往如同大海捞针。更令人沮丧的是,即使找到了相关文献,也常常需要手动筛选、交叉比对,耗费大量时间却可能遗漏关键研究。OpenScholar作为一款基于检索增强生成技术的工具,正是为解决这些痛点而生,让科研工作者从文献

gitblog_00162的博客 369

检索增强型语言模型(OpenScholar by Allen AI)

外接4500万篇论文的数据库,采用检索增强的方法,通过数据存储、bi-encoder检索器、cross-encoder重排序器等组件,从大量文献中筛选出与输入查询语义相关的段落,为LLM生成关键词提供丰富的学术文献依据。由艾伦人工智能研究所(AI2)和华盛顿大学共同开发。面对全球科研论文数量爆炸式增长,科研人员面临严重信息过载,而现有通用AI工具如ChatGPT等在处理科学问题时存在生成幻觉、成本高、参数规模大等缺陷。

weixin_43156294的博客 1316

eBPF监控革命:bpftop如何彻底改变性能分析工作流

🚀 在当今复杂的云原生环境中,系统性能监控变得前所未有的重要。传统的监控工具往往难以深入到内核层面,而eBPF技术正是解决这一痛点的完美方案。今天我们要介绍的bpftop工具,正是eBPF监控领域的革命性产品,它提供了运行eBPF程序的动态实时视图,彻底改变了性能分析的工作流程。 ## 🔥 什么是bpftop? **bpftop** 是一个强大的实时监控工具,专门用于跟踪和分析运行中的eB

gitblog_00240的博客 862

Nature发文!首个真正能写综述论文的开源 AI模型来啦,超越chatGPT和人类专家

比如,在我们的实验中,当要求GPT-4o引用计算机科学和生物医学等领域的最新文献时,,这是首个大规模、多领域的科学文献合成基准。未来,随着更多用户反馈的融入与系统的持续优化,OpenScholar 有望成为科学家日常研究中不可或缺的智能助手,推动科研效率与质量的全面提升,它并非简单存储论文,而是将论文正文分割成256词的文本块并与标题结合,构建为可检索的段落,让它查找时不再是机械地匹配关键词,例如,在“计算机科学”部分中,专家会列出答案必须包含的关键要点,AI 的回答需要满足这些“评分标准”才能得分。

郑老师统计 507

UnityRuntimeInspector搜索功能实现:深入理解HierarchyDataRootSearch设计原理

UnityRuntimeInspector是一款强大的Unity运行时调试与编辑工具,其核心功能之一就是高效的Hierarchy搜索系统。本文将深入剖析HierarchyDataRootSearch类的设计原理,带你了解如何在Unity项目中实现快速、精准的游戏对象搜索功能。 ## 搜索功能核心架构概览 HierarchyDataRootSearch作为搜索功能的核心实现类,继承自Hierar

gitblog_01149的博客 987

OpenScholar:使用检索增强语言模型合成科学文献(原始论文翻译简本)

摘要 OpenScholar是一个检索增强语言模型系统,专为科学文献综合任务设计。该系统包含4500万篇开放获取论文构建的数据存储(OSDS)和优化的检索流程,能够生成带有准确引用的科学回答。研究团队开发了ScholarQABench基准测试,包含2967个专家编写的跨学科科学问题和208个长篇幅参考答案。实验表明,OpenScholar-8B模型在正确率上比GPT-4o高5%,引用准确率达到人类专家水平。当与GPT-4o结合时,OpenScholar-GPT4o将正确率提升12%。

weixin_40378424的博客 412
上一篇: 多模态大模型能力评测基准全面综述:理解、推理、生成、应用、趋势
下一篇: 1000倍成本压缩!适用于所有场景的低成本解决方案,微软开源超强LazyGraphRAG及使用教程
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2829原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值