


视觉语言模型(VLMs)将对齐的图像-文本对嵌入到一个联合空间中,但通常依赖于确定性的嵌入,假设图像和文本之间存在一对一的对应关系。
这过于简化了实际世界中的关系,它们本质上具有多种到多种的关系,即多个描述词描述一张图像,反之亦然。作者引入了概率语言图像预训练(ProLIP),这是第一个仅使用概率目标进行亿级图像-文本数据预训练的具有强零样本能力的概率VLMs。
ProLIP通过使用"不确定性 Token "等效于没有额外参数来有效估计不确定性。
作者还引入了一种新的包含损失,它强制图像-文本对之间以及原始和 Mask 输入之间存在分布包含关系。
实验表明,通过利用不确定性估计,ProLIP可以提高下游任务的效果,并与直观的不确定性概念相吻合,例如,较短的文本来表示更高的不确定性,更通用的输入包括特定输入。
利用文本不确定性,作者进一步将ImageNet的准确性从74.6%提高到75.8%(在几样本设置下),这支持了作者的概率方法的实际优势。
代码可在https://github.com/naver-ai/prolip中找到。
1 Introduction
视觉语言模型(VLMs)旨在实现视觉和语言的联合嵌入空间,已成为近年来机器学习领域的重要基石。在训练过程中,VLMs通过对比学习将一对对齐的图像-文本(例如,一张图像及其对应的描述)映射到相同的空间。从大规模图像-文本对齐数据集中学习到的丰富的联合表示在各种下游任务上取得了显著的成功,例如零样本分类(将类标签视为模版文本,例如,一张照片)或图像-文本跨模态检索。
尽管它们取得了巨大的成功,但大多数视觉语言模型(VLMs)将表示编码到确定性的欧几里得空间中。这假设图像和文本之间存在一对一的对应关系,这简化了现实世界关系的复杂性。实际上,图像-文本匹配本质上是多对多的。多个描述可以准确地描述一张图像,每个描述突出不同视觉内容的不同方面。例如,一列火车图像可以由多个描述来描述,例如“一列火车”、“火车站”或“一辆火车停在车站旁边”。
相反,一个描述可能对应多个描述相似场景或目标的图像,例如“一列火车”可以与所有火车图像匹配。然而,如图1(b)所示,确定性模型(例如CLIP(Radford等人,2021年))无法捕捉这种多发性,例如“火车站”的嵌入位置与其它火车图像和描述无关。这是因为CLIP损失迫使正样本对靠近且随机负样本远离,当作者将其映射到欧几里得空间中的一个点时,没有稳定解。
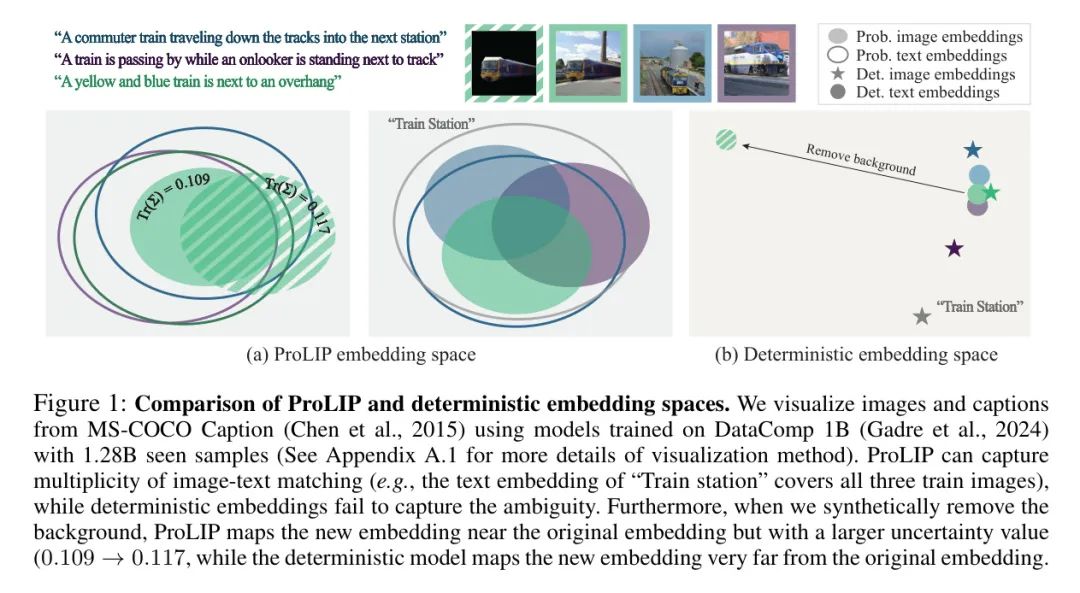
为了将输入映射到随机变量,而不是确定性的点向量,作者的概率VLM(PrVLM)方法可以处理多义性,例如,“火车站”的分布覆盖了所有火车图像分布。本文介绍了概率语言图像预训练(ProLIP),这是第一个仅使用概率目标在亿级图像文本对上进行预训练的PrVLM。与先前的PrVLM工作(Chun等人,2021;Ji等人,2023;Upadhyay等人,2023;Chun,2024)相比,ProLIP具有几个优势。
首先,尽管先前的方法需要专门的模块来预测不确定性,但ProLIP可以通过在输入中添加一个“不确定性 Token ”(}$)来非常高效地估计不确定性,而无需其他额外的参数。
其次,作者引入了一种新的包含损失,它强制图像-文本对之间以及原始输入数据和 Mask 数据之间的分布包含关系。作者的新目标可以帮助嵌入在人类中具有更好的可解释性。
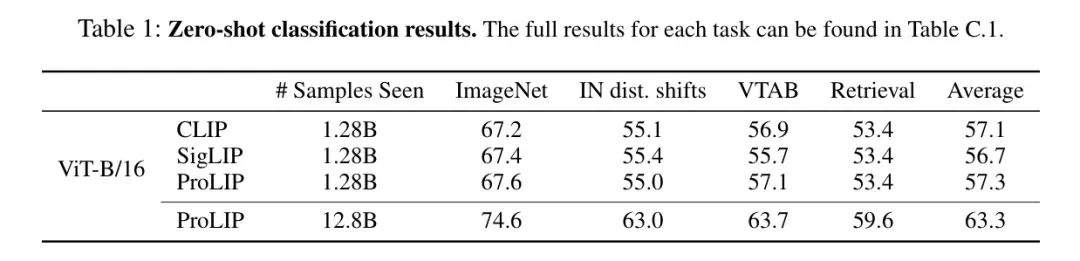
第三,ProLIP可以从零开始训练,无需任何预训练模型,并实现最先进的零样本学习能力,无需微调。此外,ProLIP实现了强大的零样本能力,例如,使用ViT-B/16 Backbone 网络实现了74.6%的ImageNet零样本准确性,而具有相同数量的可见样本的CLIP模型仅实现了73.5%(Ilharco等人,2021)。
在实验中,ProLIP在零样本分类(ZSC)任务中稍微优于确定性CLIP模型(例如,CLIP在ImageNet ZSC上的准确率为67.2%,而ProLIP为67.6%)。作者还展示了使用不确定性估计在图像文本任务中的好处。首先,作者观察到作者的直觉和学习的不确定性很好地一致。
例如,(1)文本通常“包含”图像(即,文本比图像更不确定),(2)较短文本往往更不确定,(3)更通用的文本/图像往往更不确定并包括更多具体的(例如,在图1中, Mask 图像和“火车站”)。此外,作者展示了两个在适当不确定性估计有帮助的应用;Baysian Prompt Re-Weighting(BPRW),一种完全贝叶斯方法,寻求更好的ImageNet零样本 Prompt ,从而将准确率从74.6%提高到75.8%),以及基于不确定性的数据集遍历,提供对数据集层次结构更好的理解。
2 Preliminary
Inherent ambiguity induced by the multiplicity of image-text pairs
图像文本匹配的性质是多对多。然而,在实际应用中,这种多样性并未在VL数据集中得到完全标注;
作者只将一个对应的描述符视为“正”描述符,而其他则被认为为“负”。例如,在COCO Caption(Chen等人,2015)中,超过80%的阳性对应关系被 Token 为“负”(Chun等人,2022)。正如Chun(2024)所观察到的,这种隐藏的多重性 inherently导致了VL数据集的歧义。
例如,假设作者有一个描述符“一辆火车在车站附近”,以及三个语义上相似的图像,显示一辆火车在车站附近。在这种情况下,由于VL数据集的构建协议,对描述符的只有一个阳性图像。
如果作者将这三个图像嵌入近似为同一个图像嵌入,那么这个近似嵌入与描述符之间的对应关系将是不确定的(即,可能是阳性也可能是阴性)。如果作者使用确定性匹配损失,如CLIP 所使用的对比损失。在这种情况下,最好的确定性映射将使描述符嵌入距离图像嵌入不远,但“恰当地”远离它们。CLIP没有足够的捕捉多重性和歧义的能力。
作者的目标是实现一个可以表示输入(也称为“ aleatoric不确定性”)的嵌入空间,从而使其更具有解释性和可理解性。
Probabilistic image-text representations
概率嵌入将每个数据点映射为一个随机变量(例如,高斯分布),而不是固定向量,从而捕捉到固有的不确定性和多样性。这种方法通过提供一个额外的不确定性轴,从而更好地理解语义空间,例如,作者可以通过估计不确定性来量化输入的不确定性。
最近,Kirchhoff等人(2023年)从理论上证明了,使用适当的概率匹配损失进行概率表示学习可以恢复正确的 aleatoric 不确定性。也就是说,概率映射可以捕捉输入的歧义性。概率嵌入在具有固有歧义的应用中得到了广泛研究,如词嵌入,图像嵌入,人脸理解,2D到3D姿态估计,说话人日记,视频理解和组合图像检索。
在第2.1节中,作者研究了VL任务也受到由图像文本匹配固有多义性和稀疏标注引起的 aleatoric不确定性。最近,有人尝试使用概率嵌入来解决VL任务的固有歧义。然而,这些方法的应用范围非常有限,不能作为通用的VLM(如CLIP)使用。例如,ProbVLM 是一个临时模块,部署在预训练的 CLIP上,限制了概率空间的充分探索。此外,ProbVLM仅在小型图像描述数据集(如CUB或COCO描述)上进行训练,使其不适用于更实际的零样本分类应用。
MAP(Ji等人,2023)提出了一种使用交叉注意力Transformer的预训练方法。然而,它具有有限的零样本能力,导致需要为每个下游任务微调模型。此外,其结构对检索系统非常低效;
需要图像文本对来计算它们之间的相似性,即作者必须计算所有可能的图像文本对才能获得全面相似性。最后,PCME++(Chun,2024)展示了预训练PrVLM的可能性,但其可扩展性仍然有限(例如,在ImageNet上的零样本准确率为34%)。
作者在实际观察中发现,PCME++的目标函数在大规模图像文本对下表现出慢或不稳定训练。此外,所有这些PrVLM都需要额外的重参数来估计数据的不确定性。ProLIP不需要专门用于不确定性估计的模块,但采用非常有效的策略使用UNC。
3 Probabilistic Language-Image Pre-training
Architecture
作者将输入模型为一个具有对角协方差的高斯随机变量,通过估计输入的均值向量μ和方差向量σ²来实现。类似于CLIP(Radford等人,2021年),ProLIP具有独立的视觉和文本编码器。作者使用VisionTransformer(ViT)(Dosovitskiy等人,2021年)作为视觉编码器,使用Transformer 作为文本编码器。
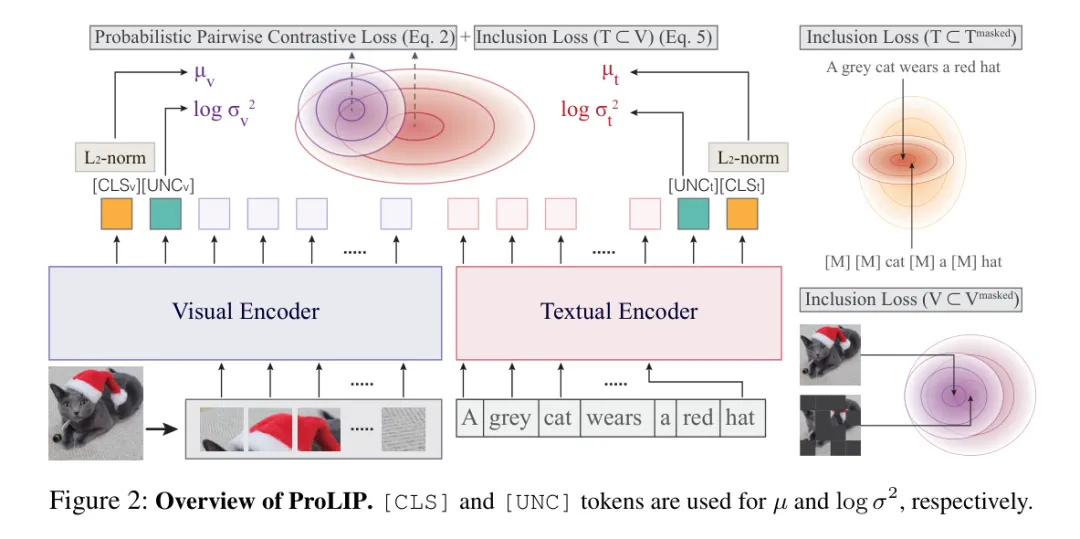
先前的概率视觉语言模型(PrVLMs)引入了额外的参数来估计不确定性。例如,PCME++(Chun,2024)使用了一个多头自注意力块来实现这一点。然而,这种方法需要额外的参数和计算成本,限制了其可用性。相反,作者引入了一个新的不确定性 Token [UNC],并将其与类 Token [CLS](参见图2)结合。与先前的PrVLMs相比,[UNC]所需的额外参数几乎可以忽略不计。视觉编码器在输入序列的开始位置处理[CLS]和[UNC],而文本编码器在输入的末尾处理[UNC]和[CLS]。
这是因为原始CLIP的文本编码器使用的是句末 Token 而不是[CLS]作为开始 Token 。请注意,作者假设协方差为对角线,即[UNC]与[CLS]具有相同的维度。作者将L2归一化的[CLS]输出用作,[UNC]输出用作。[UNC]与[CLS]一样,使用线性层将其映射到最终嵌入空间。作者将该层的偏置值设置为一个较小的值(例如,),以使初始的尺度较小(例如,对于每个维度)。这个简单的技巧有助于稳定训练。
Probabilistic pairwise contrastive loss
在本小节中,作者引入了概率对比损失(PPCL),它是ProLIP的主要目标函数。PPCL类似于PCME++中的概率匹配损失(PML),但作者对PML进行了基于SigILP(Zhai等人,2023年)的对数 sigmoid损失的稳定训练修改。
遵循PCME++,作者使用闭式抽样距离(CSD)作为作者的概率距离。
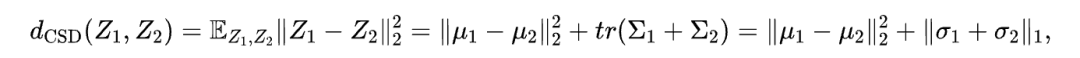
和 是具有对角协方差的高斯随机变量。PCME++ 使用的概率匹配损失采用成对二进制交叉熵(BCE),其中 被用作对数似然,其中 和 是可学习的标量。然而,作者在实践中观察到,PML 很快收敛到一个较小的值,且其梯度急剧减小,这使得整体学习过程变得缓慢或不稳定(见附录 A.2 以获取详细信息)。为了解决这个问题,作者采用对数 sigmoid 损失(Zhai等人,2023)。通过将平方 L2 距离 替换到方程(1)中,作者得到了一个新的概率对偶对比损失(PPCL):
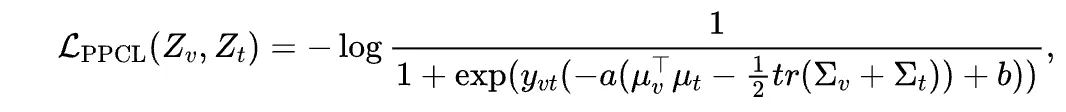
当 和 是可学习的标量值,且 和 匹配时, 为1,否则为-1。
Inclusion loss
尽管PPCL能够学习概率表示,但作者实际上观察到从数据中学习的 uncertainty 往往与人类直觉相反。例如,作者可能期望具有普遍意义的文本描述(例如,“照片”)具有非常大的协方差,可以覆盖所有摄影图像的嵌入,但有时并非如此。同样,作者可能期望如果一个文本或图像失去了一些信息(例如,某些 Token 被随机遮挡),其概率分布将包含原始样本的分布。然而,模型学习所需的不确定性并不总是可以保证,特别是在噪声图像-文本对应关系下。
为了应对这个问题,作者引入了一个新的目标函数,该函数强制随机变量 包含在另一个随机变量 中。假设 和 分别是它们的对应概率密度函数(pdf)。如果 包含在 中,那么作者可以假设具有高 的区域将被重叠到具有高 的区域。从这个观察中,作者提出了一种新的包含度量方法,强调具有高 的区域,并计算在 分布下强调的 的期望。具体而言,作者将平方设置为 ,并计算 。这种度量方法与 Bhattacharyya 距离()或内积()有关,但作者的度量方法是为了衡量“包含”(如果 包含在 中,则高;否则低)而其他方法是为了衡量“分布之间的距离”或“差异”。
对日志包含度量(忽略常数)的推导如下:
其中,。
现在,作者利用公式(3)提出一个假设检验,以判断 是否包含在 中,如下所示:
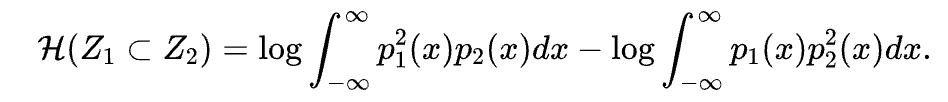
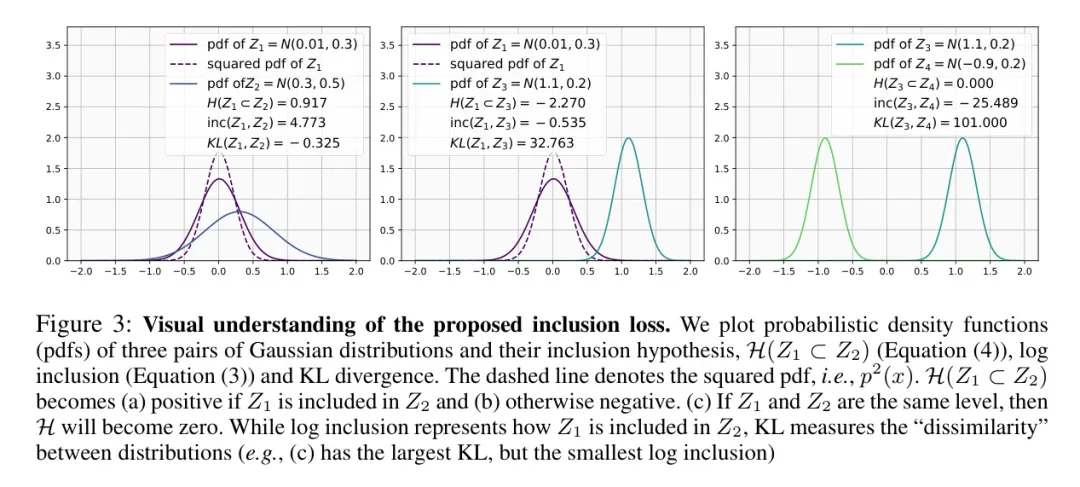
是正的,当假设为真时为正,否则为负(参见图3)。与其他概率度量相比,它有两个明显的特性。首先,是对称的。最常用的概率度量旨在测量两个分布之间的“距离”、“重叠”或“不相似性”,因此是对称的(例如,Wasserstein距离和Bhattacharyya距离)。
然而,作者衡量两个随机变量的“包含”程度,因此是非对称的:如果被包含在中,那么就不会被包含在中,即。与非对称度量(如KL散度)相比,作者旨在衡量是如何被包含在中的。相反,KL度量是基于相对熵它们之间的差异。如图3所示,即使和具有相同的方差,作者具有非常高的KL,而作者的度量变得非常小。
类似于PPCL,作者使用对数 sigmoid 损失以实现稳定收敛。作者将 作为对数似然值,当 包含在 中时,对数似然值变为正数。
现在,作者引入作者的新包含损失如下:
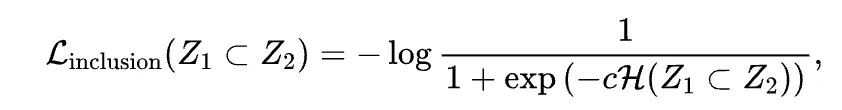
当是一个正标量值时。为了稳定性,作者将固定为一个较大的标量值,例如1000。与KL散度类似,当方差值变得非常小时,作者的包含损失可能会变得极不稳定。
为了防止损失爆炸,在训练期间,作者将一个较小的乘以来计算方程(3)中的,模拟每个高斯分布具有足够大的方差乘以。
利用包含损失,作者对模型施加两个约束。首先,作者让文本分布包括图像分布,即。这一直观来源于以前的研究,表明“文本蕴含图像”。概念上,当作者描述一张图像时,作者通过任意选择相关概念的乘积来选择产品。因此,文本通常比图像具有更广泛的信息。作为另一个约束,作者让部分信息的嵌入包括其全部信息的嵌入,即。例如,作者通过随机遮挡 Token 生成包含原始描述部分信息的文本。同样,作者通过遮挡图像 Token 生成部分图像。在实际中,作者遮挡输入 Token 的75%以生成部分信息。对于文本,作者用[MASK]替换输入 Token ,对于图像,作者删除输入的 Token 。
作者在Datacomp评估套件的38个任务上评估模型(附录B.2中列出全部评估数据集)。作者报告了五个类别:ImageNet,带有分布转移的6种ImageNet变体,13个VTAB任务,3个检索任务,以及38个任务的平均值。
此外,作者使用HierarCaps数据集(Alper和Averbuch-Elor,2024年),该数据集提供具有四个不同层次的描述(例如,“水上运动”“滑翔伞”“在滑翔伞板上滑翔伞”“在空中滑翔伞在红色板上”)。同样,作者构建了新的HierarImgs数据集,该数据集提供具有四个不同层次的图像(请参见附录B.1的示例)。
Main results
表格1显示了主要结果。作者针对每个任务使用多个 Prompt ,遵循DataComp评估套件。类似于CLIP零样本分类(ZSC),ProLIP使用多个 Prompt 的集成,即 ,其中 和 分别表示第i个 Prompt 的平均值和方差, 为 Prompt 的数量(例如,ImageNet上的80个)。需要注意的是,如果作者把这个操作看作是N个随机变量的“平均”,那么方差应为 ,但作者在实际观察中发现,除法会降低最终的ZSC性能,例如,在ImageNet上的74.51,作者的方法显示了74.58。作者在评估38个任务时没有使用第3.4节描述的不确定性基于ZSC。相反,作者使用CSD来找到最接近的类文本嵌入。
表1显示,ProLIP在所有指标上均优于CLIP,且在128亿个已见样本的训练下,实现了高性能的PrVLM后端。作者在附录C.2中提供了更多实验,包括正则化研究和其他后端。
Understanding the learned uncertainty
不确定样本可视化。
从公式(1)中,作者可以通过测量 定义给定输入的不确定性,即 (作者分别用 表示图像不确定性,用 表示其他不确定性)。图4显示了使用这种值表示的低和高不确定性值的样本。作者提取了通过CLIP相似性和英语过滤的12.8亿DataComp CommonCrawl小(Gadre等,2024)子集的样本。作者使用ProLIP分析了12.8亿已见样本。
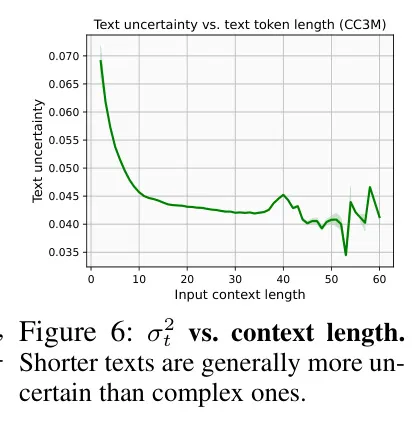
图4显示,具有更普遍意义的文本具有较高的不确定性,例如"截图"或"图形"。这是因为一个更短的文本具有更普遍的意义,有更大的机会与各种图像匹配。相反,某些标题描述了更长的和独特的上下文,如确切的地址或专有名词,这很难与多个图像匹配。作者将证明文本的上下文长度高度与不确定性值(图6)相关。有趣的是,尽管上下文长度很长,但有些标题具有很高的不确定性。作者实际观察到,这样的标题几乎没有任何信息,说明ProLIP很好地捕获了文本不确定性。这些例子在附录C.1中展示。
作者可以在图4的上行看到某些和不确定图像。在不确定图像的一侧,作者可以找到仅包含目标的图像(例如,一个时钟,一本书或一个剪贴图)在白色背景上的图像。
通常,这些图像可以与多个可能的描述相匹配,例如产品的名称、产品的详细解释,或者图像中的文字(例如图书的标题)。另一方面,某些图像具有更复杂的视觉线索,可以用更具体和详细的描述来描述。图C.1中可以找到更多具有高和低不确定性的样本。
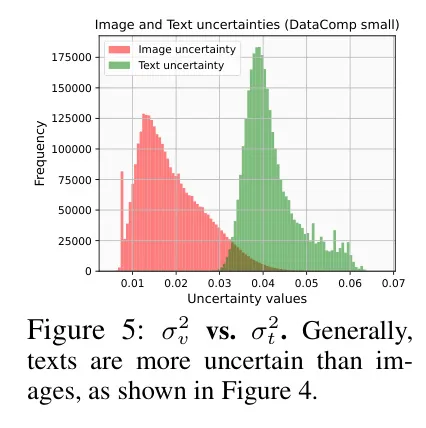
统计σv2和σt2。在图4中,作者还观察到σv2通常小于σt2,这可能源于方程(6)中的包含损失 。图5显示,图像嵌入和文本嵌入具有不同的不确定性值,正如作者所料。
什么导致了不确定性?作者通过分析文本上下文长度和数据层次来回答这个问题。首先,作者在ConceptualCaption 3M(CC3M)的描述中绘制文本不确定性(Sharma等人,2018)。如图6所示,较短的描述通常具有较大的不确定性值。例如,作者发现CC3M中描述不确定性最大的是“ 电影系列 ”,而最确定的描述是“匪帮说唱歌手,由人@人我差点死里逃生,你必须看一看!”。也就是说,不确定性更大的描述往往更具逻辑上的普遍性,如“连衣裙 - 缝纫图案”或“人 - 前后对比”,而确定性更大的描述则指定了一个具体情境。
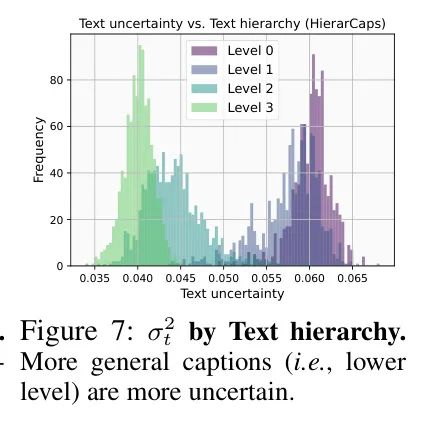
从这个观察中,作者探索了不确定性与不同描述 Level 之间的关系。作者使用了HierarCaps数据集,其图像具有从COCO Caption及其逻辑推论层次结构中包含的四种不同 Level 的描述(例如,“鸟”“蓝色鸟”…)。如图9所示。图7显示了文本不确定性与文本层次之间的关系。在这里,0表示最通用的描述,例如“椅子”或“鸟”,而4代表100OCO Caption的原始描述。如图所示,更通用的描述(较低的 Level )往往具有更大的不确定性,而更具体的描述(较高的 Level )往往具有较小的不确定性。
作者进一步研究是否视觉模态也出现类似现象,通过构建一个新的HierarchImgs数据集来表示逻辑视觉层次。如图8上 row 所示,作者的HierarchImgs数据集包括四个 Level :第4 Level 是原始图像,第0 Level 是最大的视觉分割。数据集构建的详细信息可以在附录B.3中找到。
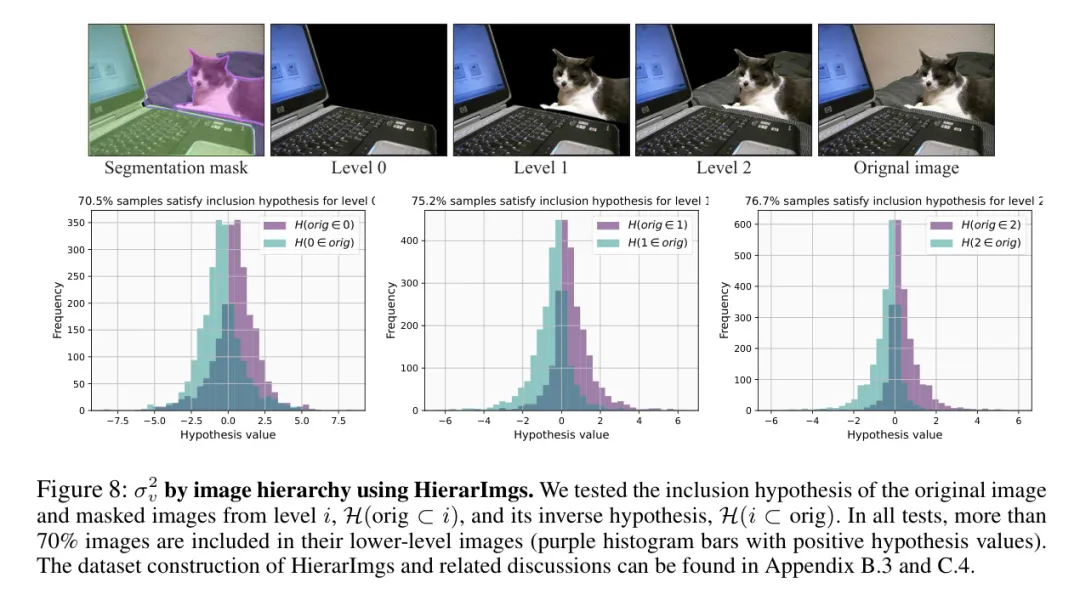
利用图像,作者分析了视觉不确定性与不同视觉信息水平之间的关系。作者通过应用包含假设来测试每个图像是否比原始图像更不确定。具体来说,作者通过公式(4)测试低级图像是否包含其原始图像。
如图8所示,大多数图像满足包含假设(例如,超过70%的图像),这意味着ProLIP也捕获了图像层次结构。在附录C.4中,作者详细解释了图像层次结构实验的更多细节,包括不同 Level 的绝对σ_{v}^{2}值以及HierarchImgs(例如,作者需要更谨慎地进行过滤以获得可靠评估)可能存在的陷阱。
Application using uncertainty
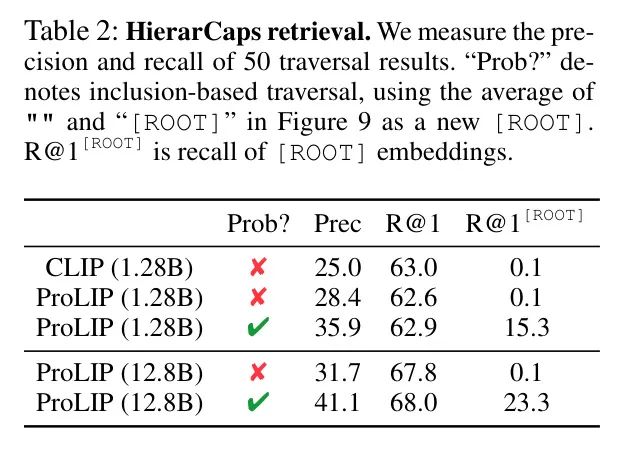
图像遍历。作者遵循Desai等人(2023年)的协议。首先设置[ROOT]嵌入。然后,获取给定图像的最接近的描述,并用50个等间距步骤插值[ROOT]和文本嵌入。Desai等人(2023年)使用空文本嵌入作为CLIP嵌入空间的[ROOT]。在ProLIP的情况下,作者可以利用额外的不确定性信息和包含假设。因此,作者通过搜索包含给定图像嵌入的文本嵌入来搜索给定嵌入的根嵌入。其他程序等于Desai等人(2023年)。作者在HierarchCaps上执行遍历。
作者在图9中展示了图像遍历的结果。有趣的是,每个图像的最包容性标题(i.e., [ROOT])并不总是与HierarchCaps的0级标题( GT 水平)相同。例如,作者对花瓶图片的估计[ROOT]是“花瓶”,而GT的0级标题是“目标”。从观察中,作者可以推测尽管作者的检索结果是合理的,但可能导致HierarchCaps检索结果不如 GT 水平。
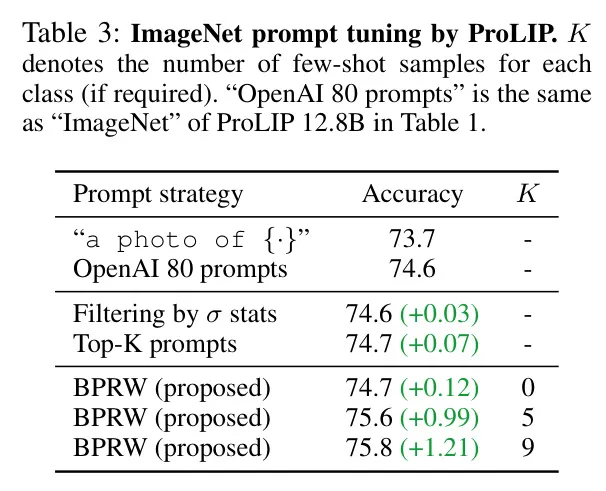
不确定性驱动的ImageNet Prompt 增强。如第3.4节所述,作者提出了一种新的 Prompt 重权方法BPRW,用于为每个类别找到一个权重π_c。由π_c加权的一个文本嵌入,即 将作为ZSC的新类别嵌入。表3显示了不同策略下ImageNet分类结果。首先,仅使用文本不确定性和过滤掉不确定文本策略并不足够有效,它们仅提高了约+0.05pp top-1准确率。另一方面,BPRW通过使用额外的视觉信息实现了更好的准确率,作者在ImageNet ZSC上取得了+0.12pp的改进。
如果作者能使用每个类别的一到几张 Token 图像(例如,每个类别五张),通过调整它们的重量,作者可以获得1.2%的准确率改进。作者描述了BPRW的更多细节,包括超参数和BPRW学习到的权重更多可视化结果。有趣的是,学习到的权重遵循实际图像分布;如果图像主要是低分辨率,那么“低分辨率” Prompt 变得最为重要。
5 Conclusion
在这项工作中,作者提出了概率语言图像预训练ProLIP方法,这是一种完全概率的视觉语言模型,通过捕获图像文本关系的固有多重性来解决确定性嵌入的局限性。
通过将输入映射到随机变量,并通过对"不确定性 Token "([ UNC])进行有效估计,ProLIP模型在不需要额外参数的情况下捕获了分布关系。
进一步的包含损失增强了图像文本对之间的分布包含关系,同时也增强了原始输入与遮挡输入之间的分布包含关系。作者的实验表明,ProLIP不仅在零样本分类任务中具有优势,而且通过捕获其不确定性,还能为理解输入数据提供额外的维度。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

 1211


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


