ACL24|知识图谱提示激发大模型的图推理

Atlas 300V 24G推理加速卡部署YOLO实战:从硬件解析到ACL推理全流程 在深度学习工程化落地中,推理加速硬件与模型部署工具链的选择往往决定项目上线效率。AI推理加速卡通过专用的NPU芯片和算子库,将训练好的模型高效转化为生产级服务,其核心原理在于将通用计算流程定制为并行化的张量运算,从而在低功耗下获得高吞吐。以昇腾Atlas 300V 24G为例,这款基于达芬奇架构的推理卡专为边缘与数据中心场景设计,支持将PyTorch等框架导出的ONNX模型通过ATC工具转换为OM离线模型,并结合ACL运行时完成高效推理。它具备24GB显存与INT8高算力,特别适合目标检测类任务。在实际工程 阅读详情

Introduction

将大模型的参数扩展至数十亿数量级、训练万亿级的语料库,在许多任务上都展现出了惊人的能力。然而在利用大模型进行生产活动时出现了一些困难:

  • Inflexibility. 大模型常常出现知识过时的现象,对于参数更新也不够灵活。而微调大模型则非常棘手,因为无论是收集高质量的训练数据还是建立训练流水线花费都很高昂。甚至会出现灾难性遗忘的问题。

  • Hallucination. 众所周知,大模型常常会产生看似正确实则错误的输出。对于医疗诊断等高风险的领域,这一问题非常严重。

  • Transparency. 大模型的黑盒本质直接导致其工作时的不透明性。其知识隐含在参数中,难以进行验证。且在深度神经网络中,推理过程难以解释。

而知识图谱可以提供明确的知识表示和可解释的推理路径,并且能够进行修改和添加知识。目前已有工作将知识图谱三元组添加到大模型的训练过程中,或将知识图谱编码与大模型进行结合,对图结构与文本数据及性能联合推理和优化。本文侧重于使用知识图谱与固定大模型进行协同推理。

Contribution

本文提出了一种即插即用的提示方法,增强了大模型在知识图谱上的推理能力。本文的方法称为思维图,大模型根据知识图谱构建思维图,理解图输入。(1)将知识图谱检索得到的事实与大模型本身的隐式知识进行融合。(2)挖掘知识图谱输入中的新模式。(3)基于思维图推理从而得到最终输出。

Background

  • Retrieval - Augmented LLM Inference. 检索增强生成(Retieval Augmented Generation, RAG)帮助大模型检索相关文档进行推理,但是由于检索的精确性、长文档理解能力问题,会影响RAG的工作效率。有工作尝试将提取出的知识图谱三元组作为提示帮助大模型回答相关问题。但是这种方法将知识图谱输入简单地作为文本,忽视了图谱本身的图结构信息,很可能引起幻觉。

  • Graph Mining with LLMs. 有工作对大模型进行提示,使其理解图输入,但主要是进行了图挖掘任务,例如链接检测和图总结等。但是很少有工作探索文本生成的任务,这些任务需要基于知识图谱的多个证据子图进行复杂推理。

  • Prompt Enginerering. “预训练、提示和预测”已成为自然语言处理少样本甚至零样本的经典范式。通过一定的上下文学习,大模型能够根据输入的上下文和指令解决新的任务。然而当提示文本过长时,大模型难以获取文本中间部分的知识,从而出现幻觉现象。

  • Knowledge Graph Augmented LLM. 利用知识图谱增强大模型的主流方向目前有两个:(1)将知识图谱融入大模型预训练阶段。(2)将知识图谱作用于大模型推理阶段。对于(1),常见的做法是把知识图谱的实体、关系作为训练数据作为训练目标,或是进行一些知识图谱的链接预测任务。但是增加预训练数据量,乃至万亿级的单词是难以实现的,也没有知识图谱具有这样的规模。而且将图谱知识压缩为大模型的参数并没有减轻大模型在灵活性、可靠性和透明度方面的限制。对于(2),有工作通过注意力机制将事实三元组加入大模型的输入,或是结合图编码与大模型编码来处理图谱输入。许多方法允许大模型理解图输入,但它们要么专门针对图谱任务,要么将检索到的事实翻译成纯文本,忽略了图谱的结构。

Method

MindMap的框架包含三个模块:

  1. Evidence graph mining. 根据原始输入识别实体集合,并查询知识图谱,构建多个证据子图。

  2. Evidence graph aggregation. 随后提示大模型理解并聚合得到的证据子图并构建推理图。

  3. LLM reasoing on the mind map. 最后提示大模型融合推理图和自身知识生成答案,并根据推理过程构建思维图。
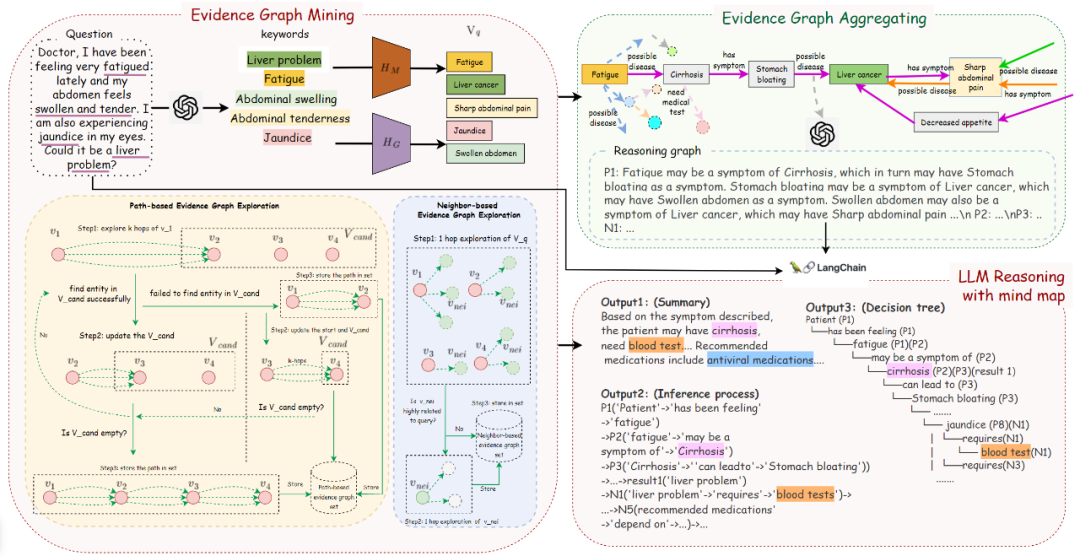
Step I: Evidence Graph Mining
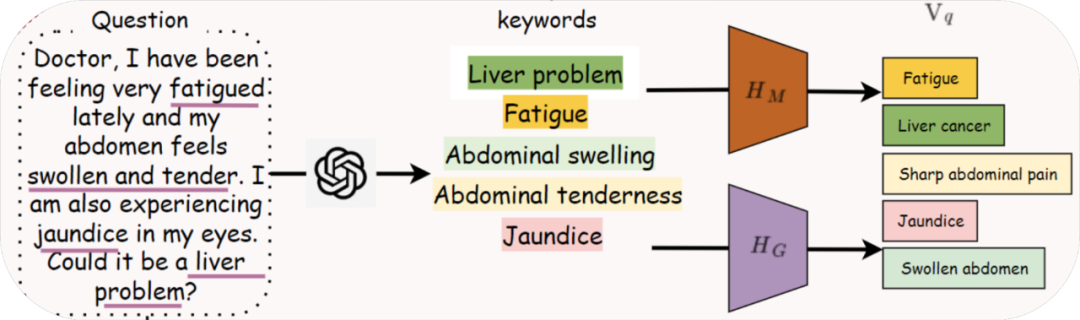
Entity Recognition

首先用大模型识别查询中的关键实体。具体而言,会使用一个提示,包含三个部分:需要分析的问题、模板句子“额外的实体为:”以及两个示例。

随后用BERT相似度匹配实体与关键词。具体而言,分别对LLM中的关键词实体和外部知识图谱的实体编码为密集嵌入和,随后计算它们之间的余弦相似度。对于每个关键词,获取一个相似度分数最高的实体集,该实体集被用于构造证据子图。

Evidence Sub-graphs Exploration

首先定义外部知识图谱为,分别表示实体集、关系集和文本集。根据提取到的实体集构建证据子图。本文使用了两种方法构建证据子图:

(1)基于路径来连接查询中的重要实体(DFS)。通过探索与V中选定节点相连的k跳节点形成路径段,重复这一过程直到所有路径段都相连为止,得到了一组路径子图.

(2)基于邻居连接与查询高度相关的实体(BFS)。对于查询实体集合中的每个节点,对其进行1跳邻居节点,对于新找到的邻居节点,如果它与查询相关,则继续进行1跳邻居扩展,加入到邻居证据图集合中。
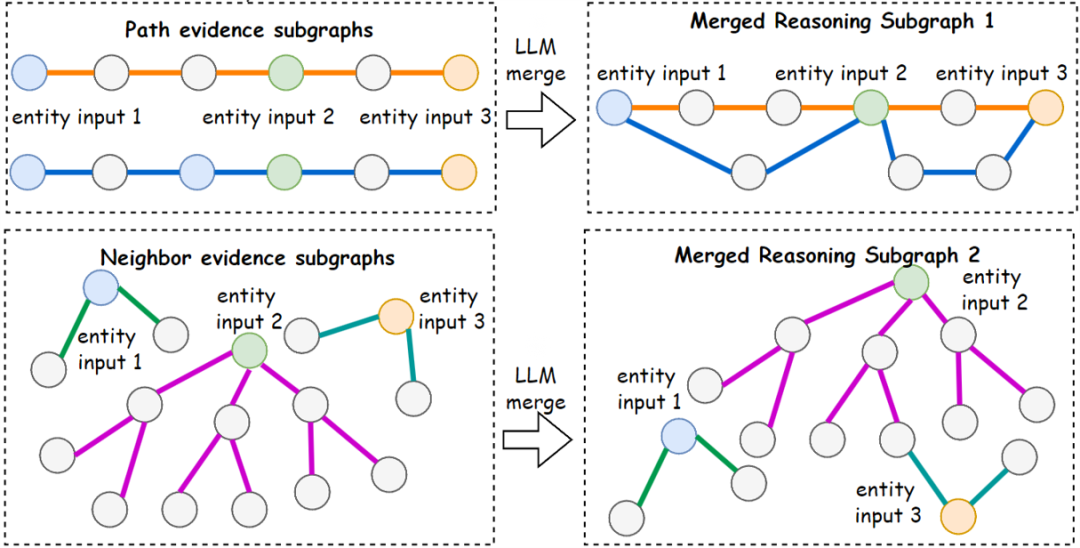
探索结束后,更新实体集,将桥连路径中的中间节点加入其中。为了管理信息、保持多样性,对路径图、邻居图通过聚类、基于头实体采样子图等方式删除部分子图。最后得到最终的证据子图,优化信息、保持多样性。

Step II: Evidence Graph Aggregation
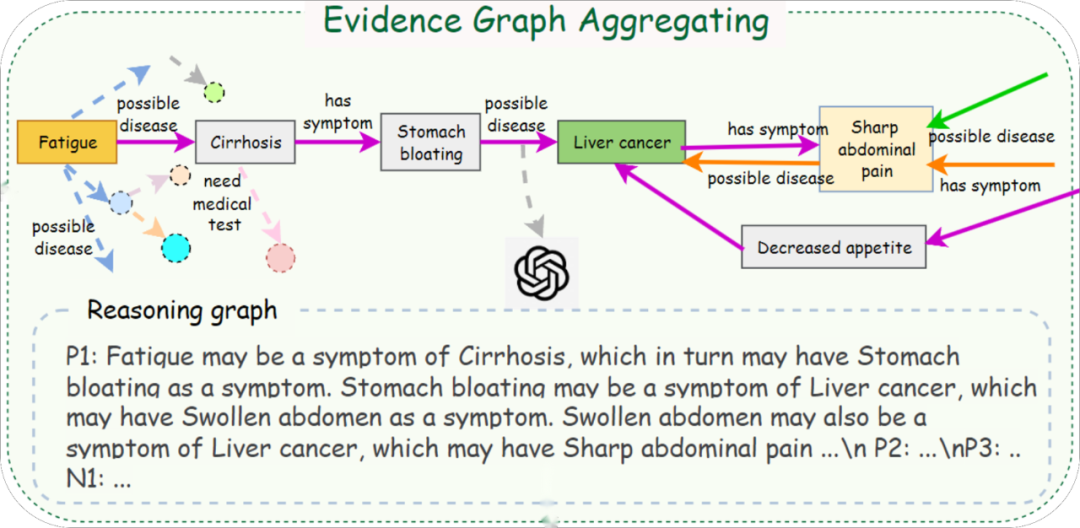
指导LLM融合不同的证据子图,得到一个统一推理图,该推理图一旦完成构建就成为了外部的增强知识,作用于下一步骤,也就是对所有的证据子图提供一个整体视角,来增强输出生成过程。

首先提取k张路径子图、k张邻居子图,每张图表示查询实体间的一种可能连接。随后将子图转换成实体链的形式。例如,然后为每个实体链分配一个序列号,例如,随后提示LLM将这些实体链转换成自然语言描述。两大优势:(a)将子图简化为一个准确、一致的格式并且能够获取重要信息。(b)利用大模型的自然语言理解能力、生成能力来统一语义相似的实体、避免了潜在的歧义。

Step III: LLM Reasoning with Mind Map

Prompting for Graph Reasoning
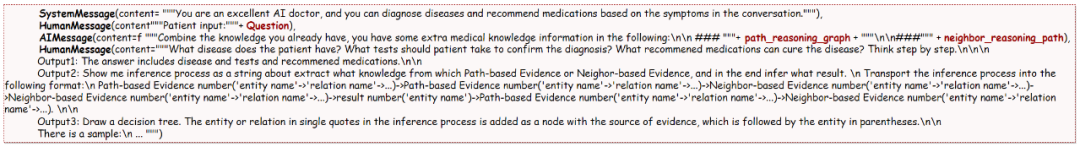
为了生成思维图和最终结果,向大模型输入一段提示,包含五个部分:系统指令、查询问题、推理图,图思维指令和示例。图思维提示利用Langchain技术引导大模型理解并增强输入,建立推理思维图并为知识源建立索引。

Synergistic Inference with LLM and KG Knowledge
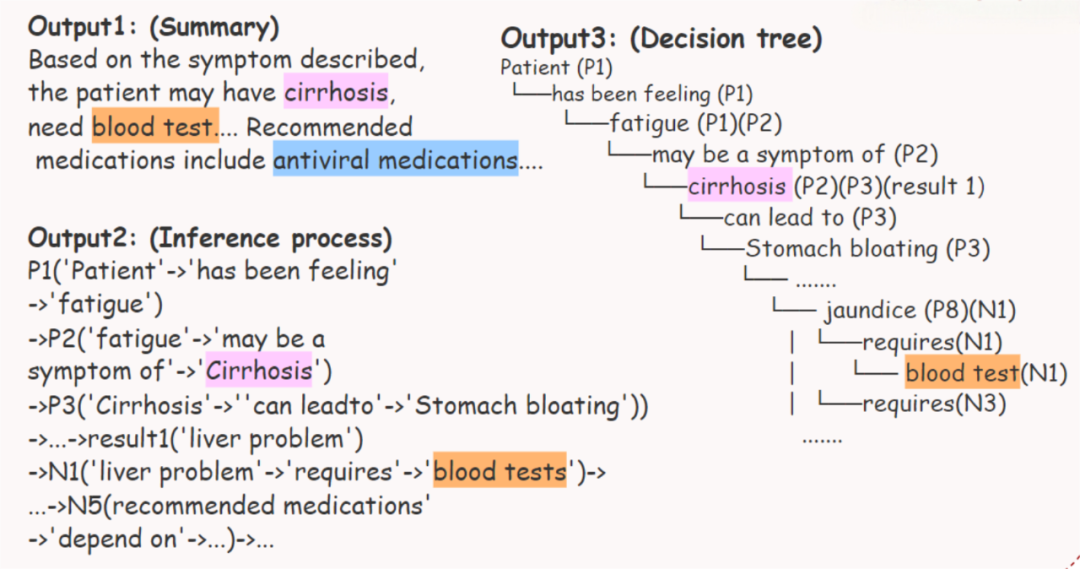
先前的检索增强方法只是令大模型改写相关知识而并未利用自身的能力。本文的MindMap方法能使得大模型利用自身知识与证据图进行协同推理。体现在三个方面:

(1)语言理解。大模型能够以一种自然语言方式理解并提取推理图和查询问题的知识。

(2)知识推理。大模型能消除实体间的歧义并根据思维图生成最终答案。

(3)知识增强。大模型能够利用自身的知识对新相关知识进行扩展、连接和提升。

Experiments

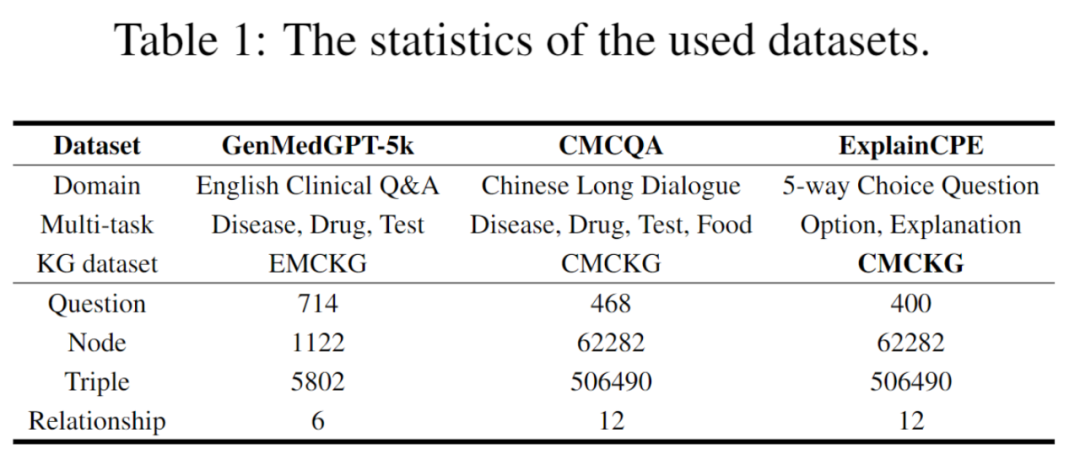
本文在三个医学领域数据集上进行问题回答,包含大量的复杂推理以及专业知识。
Evaluation Metrics

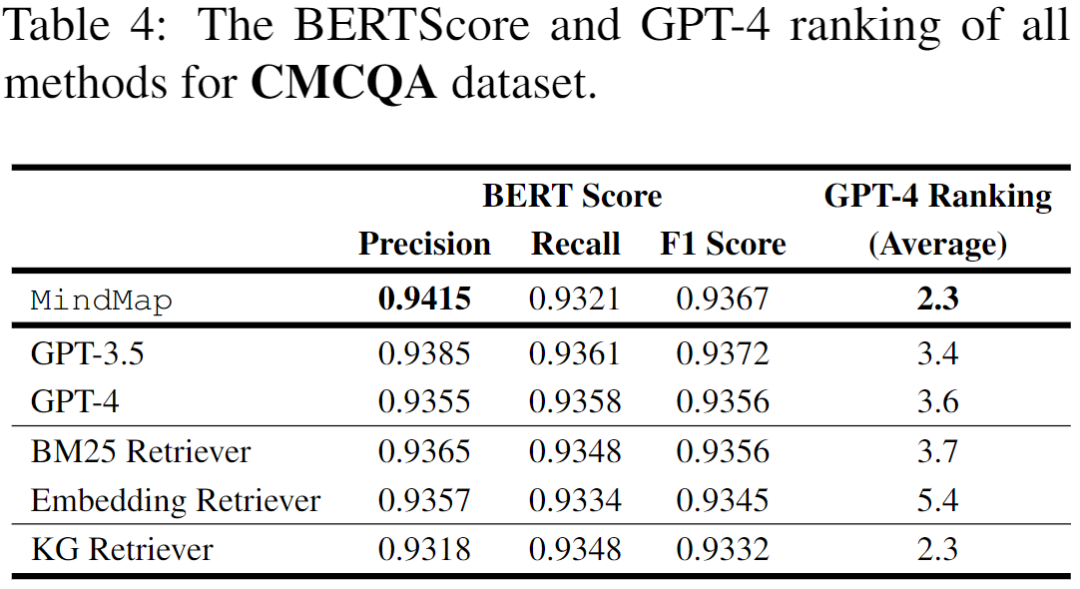
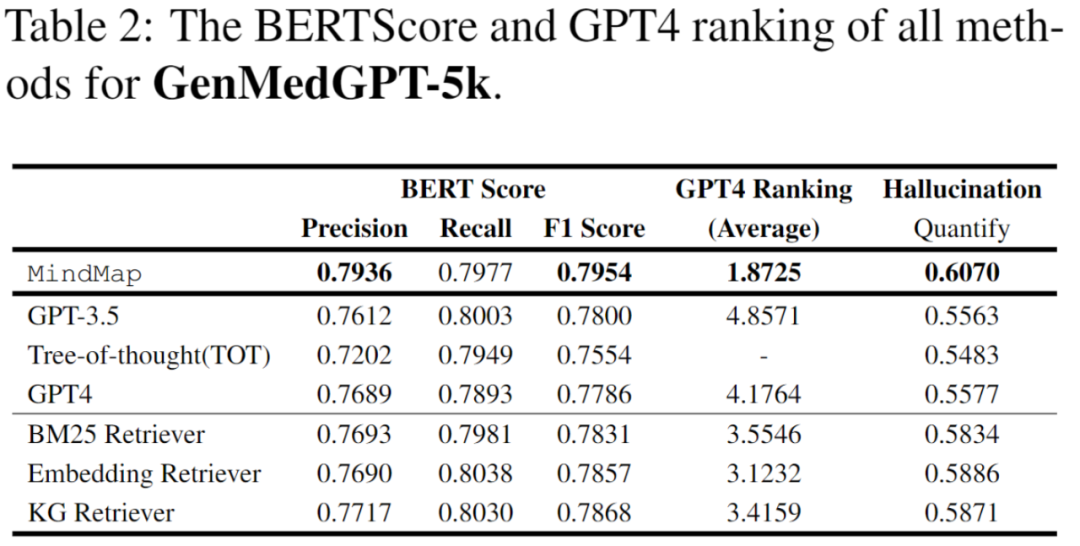
本文采用了三个评价指标:BERTScore,GPT-4 Rating_和_Hallucination Quantification。

_BERTScore_用于衡量生成答案与参考答案的语义相似度。

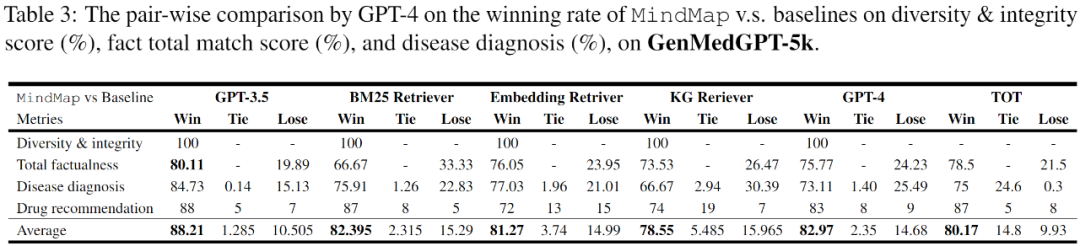
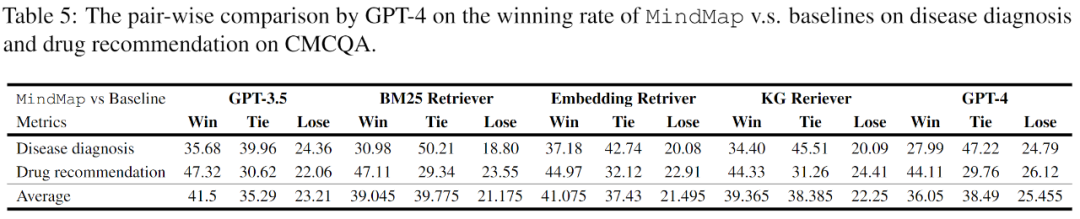
GPT-4 Rating*根据生成答案的质量进行排名、根据四个原则进行两两对比:

  • response diversity and integrity:答案多样性与完整性

  • overall factual correctness:总体事实正确性

  • correctness of disease diagnosis:疾病诊断正确性

  • correctness of drug recommendation:药物推荐正确性

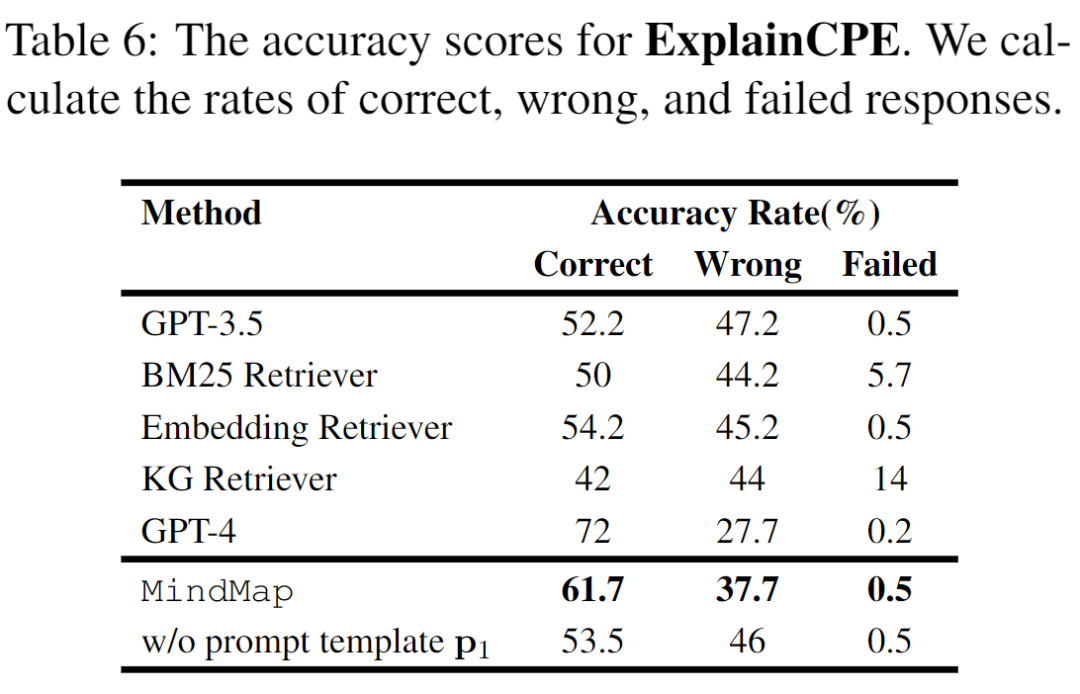
_Hallucination Quantification_用于计算生成答案与正确答案的偏离程度。本文基于mT5-large训练一个关键字提取模型,将不同方法得到的最终输出送入该模型得到对应的关键词列表。根据列表计算tfidf相似度分数,分数越低表示幻觉程度越高。

Results
Ablation Study
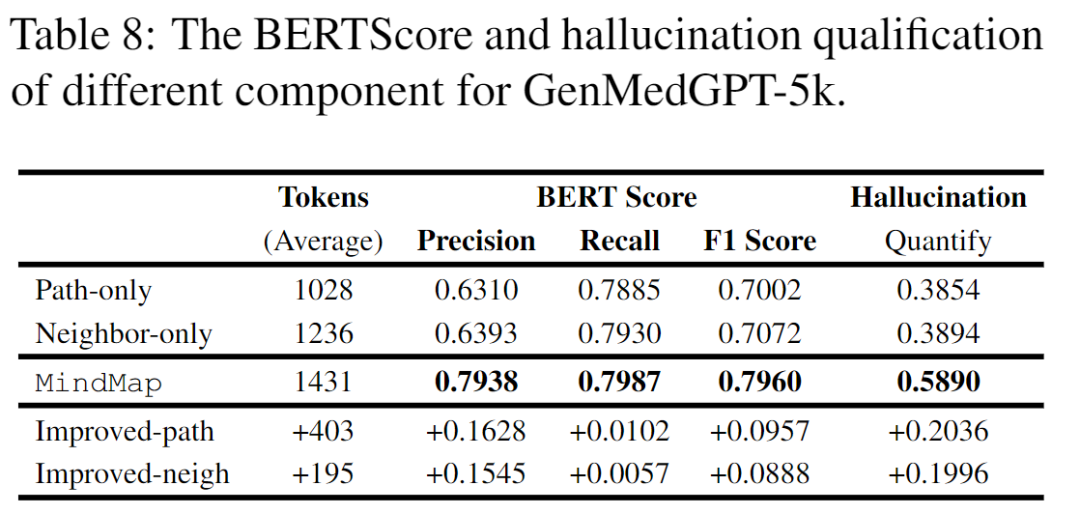
本文对子图抽取方法进行了消融分析,对于涉及医学查询的任务,基于路径的方法能更好地找到相关的外部信息。结合基于路径和邻居的方法能够有效减少幻觉现象。

Case Comparison
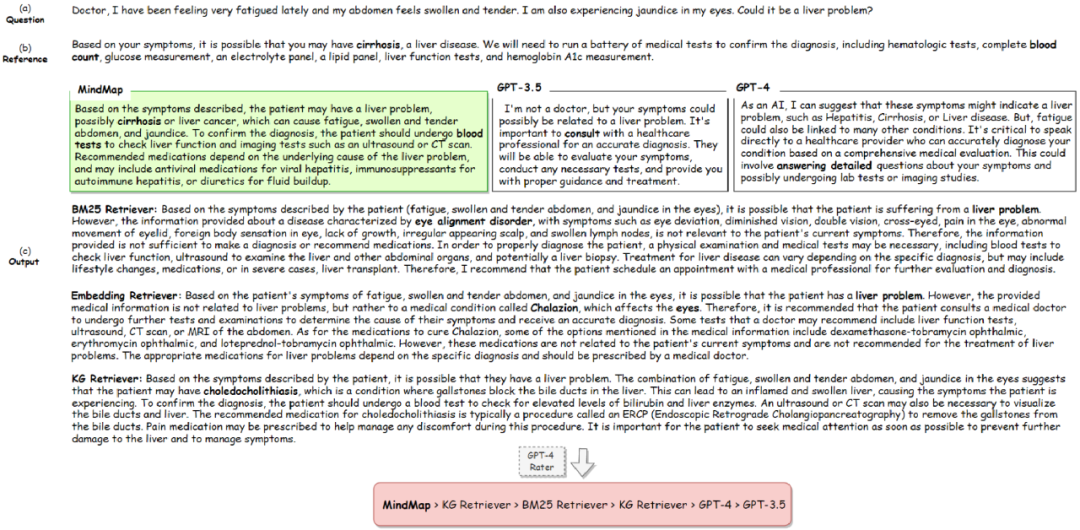
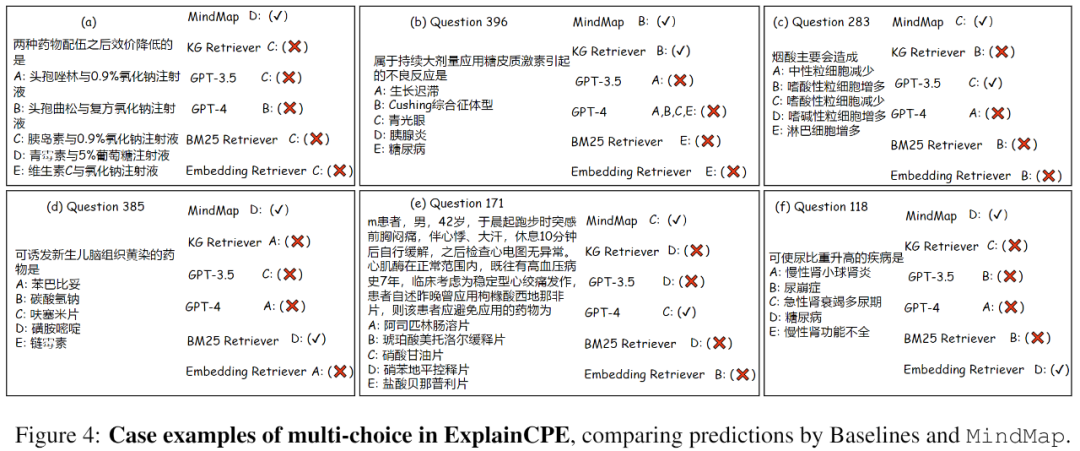
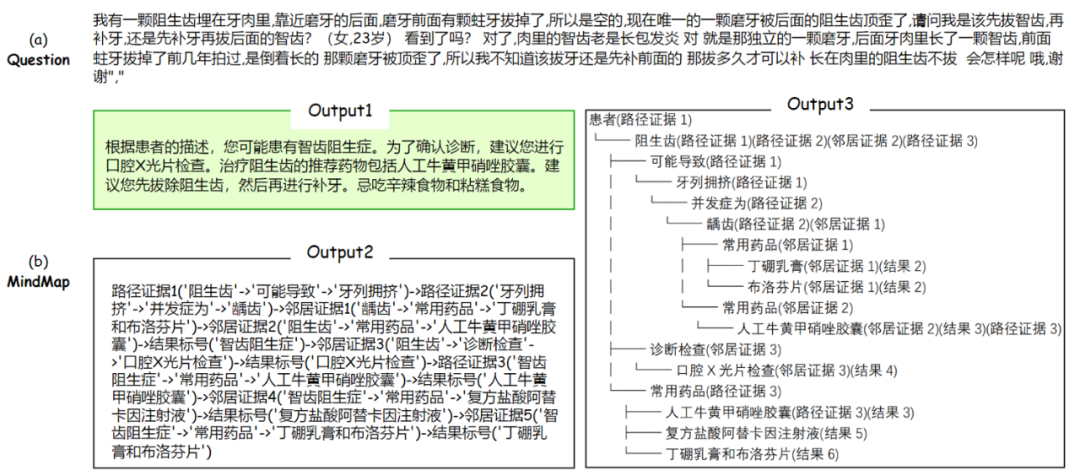
当问题包含误导性的症状事实,例如,眼球黄疸导致基准模型检索与“眼睛”相关的知识。这导致无法识别正确的疾病,推荐药物和测试与肝脏疾病无关。相比之下,本文模型 MindMap 准确识别了“肝硬化(cirrhosis)”并推荐相关的“血检”。展示了方法的鲁棒性。

Case Example
如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

Atlas 300V 24G上的YOLO部署:从OM转换到ACL推理 在深度学习工程化落地中,AI推理加速卡与模型转换是高效部署的关键环节。不同于通用GPU,专用推理卡(如华为Atlas 300V)通过内置AI Core实现高能效比,尤其适合边缘视频分析等场景。本文以YOLO目标检测为例,系统讲解从PyTorch/ONNX到OM离线模型的ATC转换原理,深入AIPP预处理配置、ACL推理接口调用以及多路视频流并行优化等实战要点,并对比Atlas与GPU的选型分工,帮助开发者在低功耗、高并发需求下快速掌握Atlas平台部署技能。 阅读详情

相关推荐

Atlas 300V 24G部署YOLO:ONNX转OM、ACL推理与避坑实战

在边缘AI部署中,推理加速卡的选择与模型迁移是关键环节。Atlas 300V 24G作为昇腾系列的视频解析推理卡,专为视觉模型批量推理设计,并非通用训练卡。通过理解ATC离线模型转换原理,可将PyTorch导出的ONNX模型编译为OM格式,在ACL运行时高效加载执行。配合AIPP硬件预处理,能显著降低CPU负载,提升YOLOv5/YOLOv8等检测模型的多路视频流处理能力。围绕Atlas 300V 24G的选型、ONNX转OM的完整流程、ACL推理中的常见陷阱,以及24G大显存的实际应用场景,帮助开发者规避

weixin_33708633的博客 207

ACL 2024 | Parrot(鹦鹉):增强大语言模型在多轮对话中的指令跟随能力

Parrot 通过提出 CaPO 训练策略以及新的多轮指令数据合成方法,提升了 LLMs 在多轮交互中的指令遵循能力。尽管存在数据集规模有限和依赖 ChatGPT 进行数据收集与评测的局限性,本文希望能为推动 LLMs 在多轮对话领域的研究和应用带来帮助。

xx_nm98的博客 2021

T型三电平关管顺序要求

摘要: T型三电平拓扑中,IGBT关断必须遵循“外管先关、内管后关”的时序,否则易导致器件损坏。正常导通时,外管与内管共同分担电压;正确关断时,外管先关使电流经内管续流至中点,避免电压过冲;若内管先关,电流路径被强制切断,杂散电感引发高压尖峰击穿器件。这一时序本质是为电流提供低应力续流路径,需通过硬件或软件严格保障。

yun0804的博客 2386

大模型论文 | MindMap:知识图谱提示激发大型语言模型中的思维图(ACL2024)

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

老皮的博客 1324

在abaqus中利用point-based 来快捷定义螺栓连接

abaqus中可以通过point-based方式定义连接点的位置,并对连接方式进行定义,可以进行螺栓连接的模拟。 可以通过逐点输入坐标或导入外部的坐标位置 也可以通过阵列的方式定义点 定义完点后就利用create fasteners,选择point-based,选取刚才创建好的点阵列,然后定义连接的属性,如下图 定义connector section时,类型选择translator,相当于只有1方向可以动,定义弹性模量以及破坏准则。 案例操作 假如有两个板,通过...

fiber_tape的博客 7353

FLUKA软件在Ubuntu的安装指南(亲测有效)

FLUKA其强大的蒙特卡洛模拟能力使得用户能够模拟复杂的辐射相互作用过程

chencheng1127的博客 2889

论文浅尝 | 从大型语言模型进行情境化提炼以完成知识图谱(ACL2024)

笔记整理:米尔扎提·阿力木,天津大学硕士,研究方向为大模型论文链接:https://aclanthology.org/2024.findings-eacl.32发表会议:ACL 20241. 动机知识图谱完成(KGC)是自然语言处理(NLP)的一项基本任务,旨在揭示不同知识图谱中隐藏的见解,以探索新的知识模式。传统的KGC方法通常通过根据其结构信息学习每个实体和关系的表示来预测三元组的缺失部分。然...

开放知识图谱 890

TK抓包协议分析:So层逆向

第三个参数是一个回调函数,这里他的返回值1表示成功,0表示失败,那我们手动把他Hook为0,让他不支持quic协议,实现降级。等,我们是为了解决抓包问题,那很有可能是在net目录下(network),那来搜索一下。开了抓包以后APP直接是网络无连接了,并且抓到的请求也是不正常的,下面我们就开始定位。看了半天感觉也没啥有用的东西,那下面我们整理一下已经有信息,来猜测一下,后续怎么进行。那可以猜测,我们真正需要Hook的那个函数也有可能是这样加载的,可以字符串搜索一下。

2503_90751938的博客 3424

图解推理大模型

直到2024年的一半时间,为了在预训练期间提高LLMs的性能,开发者们通常会增加以下方面的大小:模型(参数数量)数据集(标记数量)计算量(浮点运算次数,FLOPs)综合起来,这被称为train-time compute,它指的是预训练数据是“AI的化石燃料”。本质上,你的预训练预算越大,最终得到的模型就会越好。train-time compute可能包括训练期间以及微调期间所需的计算量。总的来说,它们一直是提高LLMs性能的主要关注点。

2401_85375151的博客 1054

thinkphp5.0.24反序列化漏洞分析

深知大多数初中级Java工程师,想要提升技能,往往是自己摸索成长或者是报班学习,但对于培训机构动则近万的学费,着实压力不小。自己不成体系的自学效果低效又漫长,而且极易碰到天花板技术停滞不前!因此收集整理了一份《Java开发全套学习资料》送给大家,初衷也很简单,就是希望能够帮助到想自学提升又不知道该从何学起的朋友,同时减轻大家的负担。

m0_67392182的博客 1871

14、深入解析Sigma - Delta调制算法:从原理到应用

本博客深入解析了Sigma-Delta调制(SDM)算法的原理与应用,特别是在Super Audio CD(SA-CD)音频编码中的作用。文章探讨了传统SDM的局限性,并介绍了一系列改进型前瞻式SDM技术,如Trellis Sigma-Delta调制、高效网格Sigma-Delta调制和修剪树Sigma-Delta调制。这些技术通过降低计算复杂度和提升信号转换质量,在音频处理和无损数据压缩领域展现出巨大潜力。此外,博客还对不同SDM技术进行了性能比较,并分析了如何实现最大信噪比(SNR),为未来音频技术和数

tgb34567890的博客 425

以知识图谱进行思考:通过结构化数据提升大型语言模型推理能力

大型语言模型 (LLM) 在自然语言理解和生成方面表现出卓越的能力。然而,他们经常与复杂的推理任务作斗争,并且容易产生幻觉。最近的研究表明,在利用知识图谱 (KG) 提高 LLM 性能方面取得了可喜的结果。KG 提供实体及其关系的结构化表示,提供丰富的信息源,可以增强 LLM 的推理能力。在这项工作中,我们开发了不同的技术,将 KG 结构和语义紧密集成到 LLM 表示中。我们的结果表明,我们能够显著提高 LLM 在复杂推理场景中的性能,并使用 KG 为推理过程奠定基础。

2401_85373898的博客 2283

在Simulink中进行基于强化学习控制策略的三相逆变器仿真

本文详细介绍了在Simulink中实现基于强化学习控制策略的三相逆变器仿真的完整流程。主要内容包括:1)准备工作,确保MATLAB/Simulink及相关工具箱安装;2)构建三相逆变器基础模型,包含电源、全桥电路、LC滤波器和负载;3)重点阐述强化学习控制器设计,涉及状态空间、动作空间定义,奖励函数设计和算法选择;4)实现控制逻辑,包括环境创建、代理配置和训练过程;5)仿真设置与结果分析。文章强调了模型调试优化的重要性,并建议结合文献研究提升控制效果。该方案为开发自适应电力电子控制系统提供了实用指南。

amy_mhd的博客 272

ACL24大会:知识图谱提示技术激活大模型图推理能力

目前已有工作将知识图谱三元组添加到大模型的训练过程中,或将知识图谱编码与大模型进行结合,对图结构与文本数据及性能联合推理和优化。该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。指导LLM融合不同的证据子图,得到一个统一推理图,该推理图一旦完成构建就成为了外部的增强知识,作用于下一步骤,也就是对所有的证据子图提供一个整体视角,来增强输出生成过程。

Everly_的博客 1139

杰理接入第三方升级协议OTA教程

本教程介绍了使用dual_bank_updata_api.h接口接入第三方协议进行固件升级的方法。主要内容包括:INI配置要求(需启用双备份并强制4K对齐)、7个核心API接口功能说明及参数详解(初始化、空间检查、数据写入、校验等)、标准升级流程步骤(初始化→检查→写入→校验→引导→清理)。特别强调了4K对齐配置的重要性以避免数据丢失,并提供了被动升级流程图。该方案支持用户自定义协议接入,需严格按照流程调用接口完成升级。

qq_42014563的博客 1432

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

ACL24|基于图结构增强LLM的推理能力

这些图的详细数据如下图所示。在使用LLMs进行推理的过程中,第一步是根据问题或之前迭代的上下文,让LLMs进行推理,以确定需要从图谱中获取哪些额外的外部信息,或者是否可以用当前图谱中的上下文来回答这个问题。为了使数据集全面,数据集包括了不同难度级别的样本:简单问题(可以通过图上的单跳推理回答),中等问题(需要图上的多跳推理),以及难题(需要在图上的信息作为上下文进行归纳推理)。为了确保这些问题的准确性和意义,作者请了受过良好训练的计算机科学博士生来撰写可能的问题,这些问题在给定图谱的上下文中可以得到答案。

m0_59164304的博客 950

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

【论文精读(KG-FiD)】KG-FiD: Infusing Knowledge Graph in Fusion-in-Decoder for Open-Domain Question Answeri

针对开放域问答(ODQA)中传统模型跨段落关系建模不足和计算效率低下的问题,本文提出KG-FiD框架,通过知识图谱(KG)构建检索段落间的结构关联,并利用图神经网络(GNN)实现段落重排序与剪枝。在 Natural Questions 和 TriviaQA 数据集上,KG-FiD 以40% 的计算成本实现了与 FiD 相当或更优的性能,为高效可信的开放域问答提供了新路径。

2301_79985417的博客 2230

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

Atlas 300V 24G部署YOLO:从ONNX转换到ACL推理实战

目标检测在工程落地中,推理阶段的硬件选型和软件栈部署往往成为瓶颈。YOLO作为单阶段检测器,凭借速度与精度的均衡被广泛用于安防、质检等场景。昇腾Atlas推理卡以低功耗和大显存为高并发视频流检测提供高性价比算力,其中Atlas 300V 24G基于昇腾310P芯片,专为推理设计,支持INT8量化,但需要借助CANN工具链将模型转换为OM格式,再通过ACL接口加载执行。从ONNX导出、ATC参数配置到ACL推理,完整链路涉及算子适配、AIPP预处理、显存管理与batch选择等关键环节。理解并跑通这一流程后,同

weixin_28706397的博客 173

Atlas 300V 24G推理卡部署YOLOv5实战:从模型转换到ACL推理

深度学习推理阶段通常需要专用加速硬件来平衡性能与成本。与传统GPU训练卡不同,推理加速卡专为模型部署优化,通过INT8量化与算子融合提升吞吐,降低功耗。Atlas 300V 24G是华为昇腾系列面向推理场景的AI加速卡,具备大容量板载内存,适合视频分析、工业质检等实时目标检测业务。要在其上运行YOLO模型,需掌握完整的模型转换链路:从PyTorch训练导出ONNX,通过ATC工具转换为OM离线模型,再基于ACL推理库编写应用。整个过程涉及环境配置、固定shape设置、预处理对齐和后处理实现,部署时可复用GP

weixin_32495691的博客 284

Atlas 300V 24G部署YOLOv5实战:从ONNX到ACL推理

在AI边缘计算与推理场景中,专用推理加速卡正在成为高能效比的核心选择。与通用GPU依赖CUDA生态不同,昇腾NPU通过CANN工具链和ONNX中间格式实现模型迁移。以Atlas 300V 24G为例,它基于昇腾310P芯片,以低功耗、大显存和PCIe形态满足工业质检、智慧园区等场景的实时检测需求。然而,PyTorch权重无法直接运行,必须经过ONNX导出、ATC转换生成OM模型,再通过ACL接口加载执行。本文系统梳理了在Atlas 300V 24G上从环境部署到YOLOv5推理落地的全流程,包括关键参数解析

weixin_28224217的博客 279

Atlas 300V 24G部署YOLO推理:从模型转换到ACL实战指南

AI模型部署是深度学习落地的关键一环,尤其在边缘计算场景中,推理加速卡的选择和工程化流程直接决定项目成败。以目标检测任务为例,YOLO系列模型凭借其高效性和易用性成为业界主流,而如何将这类模型高效运行在专用推理硬件上,是许多开发者面临的现实挑战。昇腾Atlas系列作为国产AI加速计算的代表,其工具链与主流训练框架存在差异,要求开发者理解模型转换、算子适配和硬件编译优化等核心原理。通过ATC工具将ONNX格式转换为OM格式,并利用ACL接口编写推理程序,能够实现高性能的实时检测应用。本文以Atlas 300V

weixin_29055137的博客 274

Atlas 300V 24G推理加速卡部署YOLO实战:模型转换与ACL推理全解析

深度学习模型训练完成后,如何高效、低成本地部署到生产环境,是许多工程师面临的现实问题。推理加速卡作为专门优化模型推理的硬件,与训练卡在架构和定位上截然不同。Atlas 300V 24G作为昇腾系推理加速卡,凭借其大显存和INT8量化优势,在边缘计算、视频结构化分析等场景中表现突出。然而,其软件栈依赖CANN工具链,无法直接运行PyTorch模型,需要通过模型转换链路将YOLO权重转为OM格式,并基于ACL编写推理程序。本文从推理卡与训练卡的本质区别出发,系统讲解YOLO模型从PyTorch到ONNX、再到A

weixin_29050513的博客 245

Atlas 300V 24G推理卡上部署YOLOv5:从硬件识别到ACL推理全流程实战

在边缘计算场景中,AI推理加速卡正成为视频分析与目标检测的核心硬件。不同于通用GPU,NPU推理卡需要配套的软件栈与模型转换工具链才能高效运行深度学习模型。Atlas 300V 24G作为一款基于昇腾芯片的推理加速卡,专为低延迟、高吞吐的固定模型推理设计,适合长时间运转的边缘设备。借助CANN工具链与ATC模型转换,可将PyTorch训练的YOLOv5模型转换为昇腾专用OM格式,并通过ACL接口高效执行。整个过程涉及驱动固件匹配、ONNX导出、算子兼容性处理及显存管理等多个关键环节,理解这些知识有助于快速上

weixin_29171129的博客 36

Atlas 300V 24G推理加速卡部署YOLO全流程解析:从环境配置到ACL推理

AI推理加速卡是当前边缘与云端目标检测场景的重要算力支撑。昇腾Atlas 300V 24G作为专用推理卡,凭借24GB显存与达芬奇架构的AI Core,在YOLO这类批量检测任务中展现出高能效比与低功耗优势。其部署链路与通用CUDA生态不同,需围绕驱动、固件与CANN工具链进行严格的版本匹配,并经历PyTorch模型到ONNX再到OM离线模型的转换过程。文章从硬件定位讲起,逐步解析ATC转换参数、静态Shape选择、ACL推理接口及预处理对齐等工程要点,同时分享多路视频流部署与AOE调优的实践经验,为在昇腾

weixin_29050513的博客 75

ACL-24,哈工大思维链推理技术综述

为了提升数学问题的求解效果,Chain-of-Expert、OptiMus、OptLLM、ORLM以及ICML-24运筹优化问题求解比赛的冠军方案等这些方案的共同特点是直接使用或者间接借鉴了大语言模型的核心技术 => 思维链(chain-of-thought,简称Cot)。简单来讲,思维链是一种让模型逐步求解推理问题的技术。如上图所示,在求解推理问题时,嵌入思维链能力的大模型不会直接输出答案,而是先逐步推理中间步骤(形成思维链),最终在思维链的引导下产出答案。

weixin_37912236的博客 344
上一篇: 吴恩达分享五个AI趋势,重点谈了多AI代理的美好前景
下一篇: 最强表格AI问世,浙大开源 TableGPT2!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2841原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值