【突破限制】免费使用Qwen大模型的API接口

跑在笔记本里的大语言模型 - GPT4All GPT4All支持多种不同大小和类型的模型,用户可以按需选择。序号模型许可介绍1商业许可基于GPT-J,在全新GPT4All数据集上训练2非商业许可基于Llama 13b,在全新GPT4All数据集上训练3商业许可基于GPT-J,在v2 GPT4All数据集上训练。4商业许可基于GPT-J,在v1 GPT4All数据集上训练5商业许可基于GPT-J,在v0 GPT4All数据集上训练6非商业许可。 阅读详情

Qwen 开放了众多 API 接口,新用户注册后会有一定的免费额度。如果赠送的额度也用完了,还想继续白嫖体验的话,有啥好办法吗?

本文就跟大家分享一个在GitHub上的一款开源项目 - qwen-free-api。项目可以通过“阅读原文”访问。

项目简介

qwen-free-api顾名思义,就是免费使用qwen API嘛,它具有以下特性:

  • 高速流式输出:实时生成文本,满足各种创作需求。

  • 联网搜索:整合搜索引擎,足不出户获取海量信息。

  • 长文档解读:轻松理解长篇大论,快速把握文章要点。

  • 图像解析:从图像中提取信息,洞察先机。

  • 多轮对话:与模型进行自然流畅的对话,享受智能交互体验。

  • 多路token支持:解除并发限制。

  • 自动清理会话痕迹:保护我们的隐私安全。

  • 零配置部署:无需繁琐配置,即可轻松使用。

目前支持与openai 兼容的 /v1/chat/completions 接口,可自行使用与openai或其他兼容的客户端接入接口,或者使用 dify 等线上服务接入使用。

同时,作者也声明,该项目纯粹研究交流学习性质,仅限自用。大家也是且用且珍惜,别用力过猛了。
在这里插入图片描述

项目展示

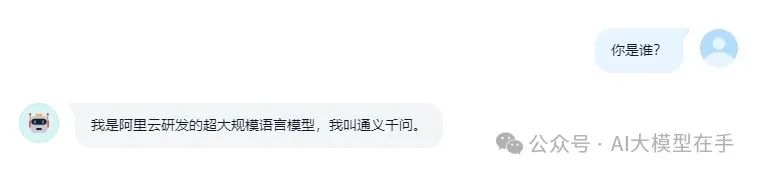
验明正身

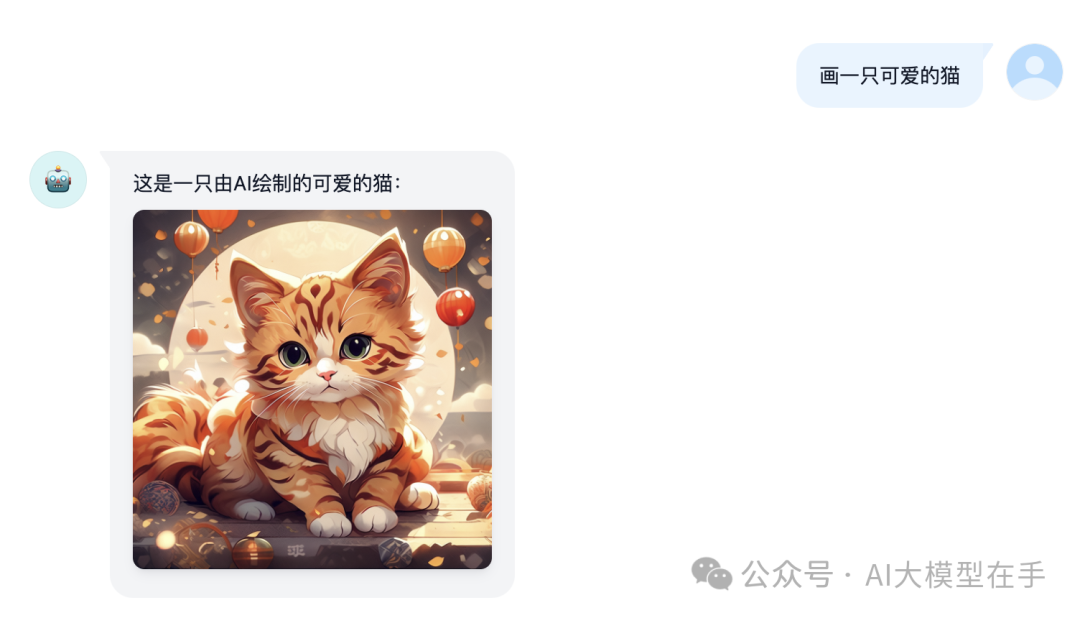
文生图

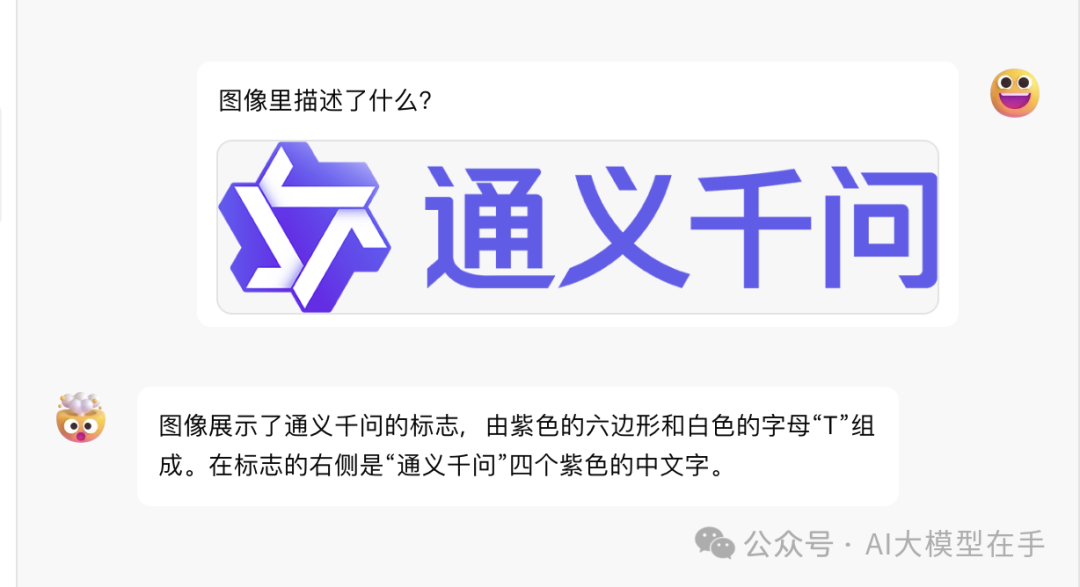
图片理解

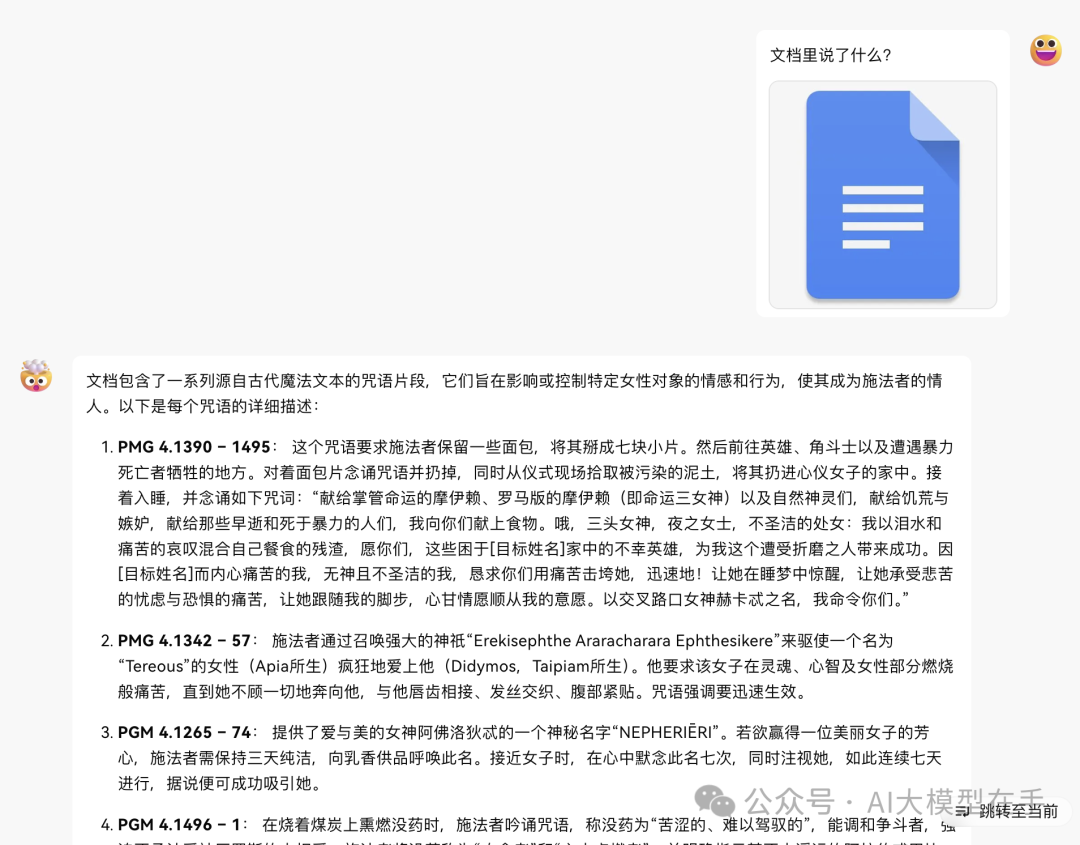
长文档解读

接入准备

进入通义千问的对话页面:https://tongyi.aliyun.com/qianwen/

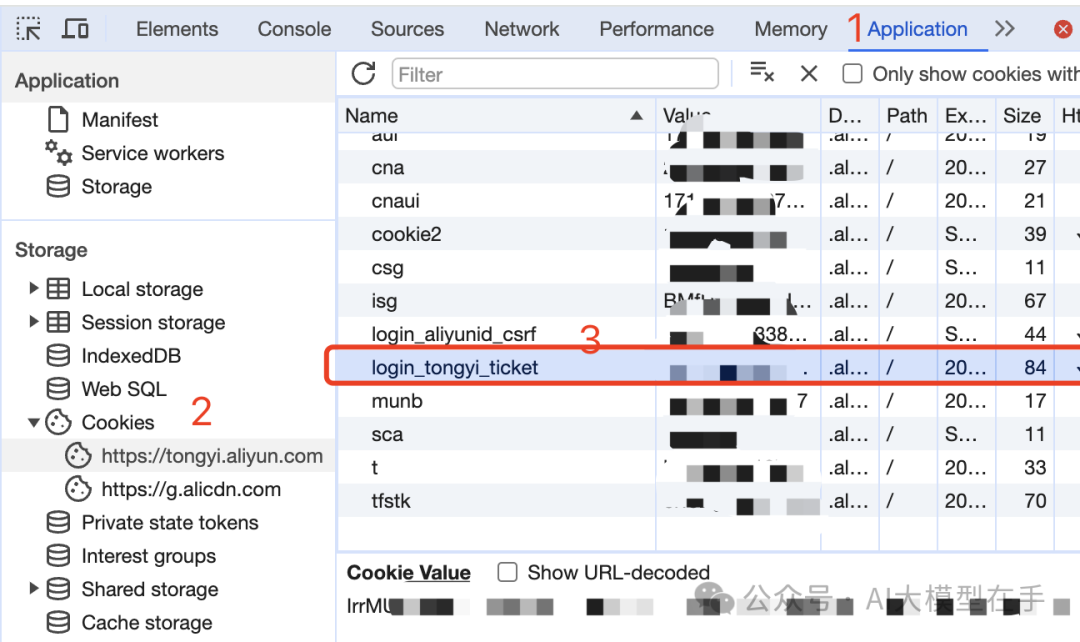
然后按 F12 打开开发者工具,从 Application > Cookies 中

找到**login_tongyi_ticket**的值,这将作为 Authorization 的 Bearer Token 值:

Authorization: Bearer TOKEN

其中的 TOKEN 用**login_tongyi_ticket** 的值替换。
你可以通过提供多个账号的login_tongyi_ticket,并通过以下方式拼接,每次请求服务会从中挑选一个:

Authorization: Bearer TOKEN1,TOKEN2,TOKEN3

安装部署

项目支持多种部署方式,包括本地部署、docker/Render/Vercel/Zeabur 部署 等等。

docker部署

docker run -it -d --init --name qwen-free-api -p 8000:8000 -e TZ=Asia/Shanghai vinlic/qwen-free-api:latest   

Docker-compose部署

version: '3'      services:     qwen-free-api:       container_name: qwen-free-api       image: vinlic/qwen-free-api:latest       restart: always       ports:         - "8000:8000"       environment:         - TZ=Asia/Shanghai   

本地部署

npm i  #安装依赖   npm i -g pm2 安装PM2进行进程守护   npm run build #编译构建   pm2 start dist/index.js --name "qwen-free-api" #启动服务   pm2 logs qwen-free-api #查看服务实时日志   pm2 reload qwen-free-api #重启服务   pm2 stop qwen-free-api #停止服务   

Qwen-Free-API仅供个人学习和研究使用,禁止用于商业目的。Qwen-Free-API的服务可能会受到限制,请酌情使用。

总的来说,Qwen-Free-API 是一个功能强大、易于使用的开源项目,可以帮助我们快速构建各种基于 Qwen 的应用。感兴趣的可以试试,但服务可能会受到限制,请酌情使用。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

qwen API调用 【代码】qwen API调用。 阅读详情

相关推荐

零代码调用国产大模型:Kimi/Qwen/DeepSeek官方免费通道实操指南

大语言模型(LLM)作为当前AI应用的核心技术,其真正价值不在于本地部署或参数大小,而在于稳定、低门槛、高语义契合度的服务化调用。国内主流大模型如Kimi Chat、Qwen3、DeepSeek-V2已通过官网提供免API密钥、免服务器配置、面向个人用户的高质量推理服务,依托万卡集群与中文原生训练语料,在长文档理解、结构化输出、代码解释等场景表现突出。这些服务并非临时福利,而是企业构建中文AI生态的可持续运营策略,适用于写作润色、资料摘要、逻辑校验、多轮对话等真实工作流。本文聚焦零技术背景用户,详解如何30

dianqi0560的博客 5511

GPT4All安装教程 一个能本地运行的GPT4!

GPT4All是能够在你的笔记本或者台式计算机运行的大型语言模型(LLMs)。它并不强制需要GPU,CPU也能流畅的运行该语言模型。

mc_dudu233的博客 1万+

大模型API计费本质与免费窗口避坑指南

大模型API是AI工程落地的最小原子单位,其本质并非流量套餐,而是GPU计算时间片的租用合约。理解token消耗逻辑、输入输出拆分、模型上下文开销及并发调度机制,是规避‘免费陷阱’的前提。本文基于OpenClaw实战场景,解析Qwen3-32B、GLM-4.7等主流模型的真实token账本,揭示百炼、NIM、OpenRouter等平台的额度分配暗规则,并给出从零配置到生产级监控的完整链路——涵盖API Key安全管理、指数退避重试、Redis令牌桶限流、Prometheus用量埋点等关键技术点,助力开发者建

weixin_33761747的博客 384

Anaconda中安装cv2包详细教程

OpenCV(开源计算机视觉库)是在 BSD 许可下发布的,因此它可以免费用于学术和商业用途。它具有 C++,Python 和 Java 接口,支持 Windows,Linux,Mac OS,iOS 和 Android。OpenCV 专为提高计算效率而设计,专注于实时应用。该库以优化的 C/C++ 编写,可以利用多核处理。 通过 OpenCL 启用,它可以利用底层异构计算平台的硬件加速

qq_44111805的博客 4万+

Qwen3.8 27B混合架构大模型:突破Transformer限制,实现百万级长上下文处理

Transformer架构作为现代大语言模型的核心,通过自注意力机制实现了强大的序列建模能力,但其在处理长文本时面临KV Cache(键值缓存)显存占用随序列长度线性增长的固有挑战。这一瓶颈限制了模型在长文档分析、代码库理解和多轮长对话等场景的应用。为了突破这一限制,业界探索了多种长上下文优化技术,其中混合架构设计成为一种重要的工程实践方向。Qwen3.8 27B模型创新性地采用了约75%非Transformer层的混合架构,旨在显著优化长序列处理效率,支持高达百万级别的上下文长度。该设计通过融合更高效的模

weixin_30694389的博客 268

2026大模型API调用避坑指南:免费额度、错误码与混合部署实战

大模型API调用已从简单接口请求演变为涉及成本控制、稳定性保障与合规治理的系统工程。其核心原理在于服务端对token计量、QPS限流、推理模式等维度的精细化策略调控;技术价值体现在降低隐性运维成本、规避‘免费陷阱’、提升生产环境可用率;典型应用场景覆盖金融风控、政务文书解析、教育智能问答等对延迟、准确率与数据主权有严苛要求的领域。本文基于真实故障日志与17家平台压测数据,深度解析vLLM部署大模型、ollama本地运行、llamafactory微调等关键技术在API降本增效中的落地路径。

dengkuituo0680的博客 448

Qwen3-ASR-Toolkit终极指南:如何轻松突破3分钟限制实现长时间音频转录

想要处理超过3小时的音频文件却受限于API限制?Qwen3-ASR-Toolkit就是你的完美解决方案!这个强大的Python工具包专门设计用于突破Qwen3-ASR API的3分钟音频长度限制,让你能够轻松转录任意时长的音频和视频文件。无论你是需要处理长达数小时的会议录音、讲座视频还是播客节目,这个工具都能帮你快速完成高质量的文字转录。 ## 🚀 为什么选择Qwen3-ASR-Toolkit

gitblog_00398的博客 1151

Qwen3.5-Plus与miniMax-M2.7免费调用实战指南

大语言模型(LLM)的免费调用能力是AI工程落地的关键起点。Qwen3.5-Plus和miniMax-M2.7作为当前中文场景下工具调用与对话拟人性的双标杆,其真实可用性不取决于‘破解’,而源于对官方免费额度、开源替代方案(如Qwen2.5-7B-Instruct)、混合架构设计及token资源精细化运营的系统性理解。本文从LLM基础能力差异切入,解析二者在工具调用、长程对话、响应延迟等维度的技术原理,阐明其在法律知识助手、AI原生应用、智能客服等场景中的不可替代价值,并提供可复用的额度管理、vLLM本地部

weixin_34008805的博客 507

突破限制:AIClient-2-API免费AI接入实战指南

在AI开发的道路上,你是否正面临这些困扰:如何降低高昂的API调用成本?怎样突破官方配额的限制?如何实现多模型的统一接入?AIClient-2-API作为一款强大的协议转换工具,为你提供了零成本接入Claude等顶级AI模型的解决方案,让AI开发不再受限于资源约束。 ## 一、问题解析:AI开发的三大痛点 ### 成本困境:API费用持续攀升 随着AI应用的深入,API调用费用逐渐成为开发成本

gitblog_00444的博客 682

在Anaconda中安装OpenCV

在Anaconda中安装OpenCV是一种常见的方式,因为Anaconda提供了一个方便的环境管理工具,可以轻松安装和管理Python库。如果遇到任何依赖项问题,请参考OpenCV的官方文档或Anaconda的文档,以获取更多信息和解决方案。虽然不是必需的,但为了保持环境的干净和隔离,您可以选择创建一个新的虚拟环境来安装OpenCV。安装完成后,您可以编写一个简单的Python脚本来验证OpenCV是否成功安装。如果一切顺利,您将在命令行中看到已安装的OpenCV版本号。根据安装向导的指示进行安装。

WzisTypescript的博客 7412

Nature风格的北半球投影图,几行代码就能绘制...

在子刊***Nat. Clim. Chang.***中,通过北极俯视投影表示NAO和AO的EOF分解。仅在定义图层的时候设置为该投影,其余设置content,绘制contourf都是PlateCaree。如子刊Nature Geosci中表示了海冰的漂移,还添加了DEM底图,非常美观。以海温数据为例,ERA5月温度平均,是一张721*1440的0.25degTIF。现在的结果看起来不错,但太大了,我们如果只需要北半球的数据,则需要指定经纬度。绘制完结果也是正方形,和ArcGIS差不多,见之前的推文。

wlh2067的博客 1292

Qwen3-VL解析网盘直链下载助手限速机制:突破带宽限制方法

利用Qwen3-VL多模态能力,自动识别网盘截图中的直链并代理下载,突破本地带宽限制。通过网页推理服务实现免部署使用,结合4B/8B双模型按需切换,兼顾速度与精度,构建高效、安全的智能下载代理系统。

weixin_31869917的博客 1100

C++游戏开发入门:从环境配置到第一个完整项目

C++ 作为游戏开发领域的关键语言,其学习路径常因语法枯燥而令初学者却步。以项目驱动的方式学编程,能帮助学习者将变量、循环、函数、指针等基础概念融入实际游戏逻辑中,获得即时反馈与完整项目经验。掌握合适的开发环境是高效实践的前提,例如在 Windows 下使用 VS Code 搭配 MinGW-w64 编译器,配合调试器与构建脚本,即可搭建轻量可扩展的 C++ 游戏开发工作流。此类课程通常面向无基础人群,从控制台小游戏逐步过渡到带游戏循环的完整作品,过程中还需关注性能观察、素材授权与版本管理。无论你是刚接触编

weixin_30621959的博客 542

Qwen2.5-7B API速率限制破解:并发请求技巧,成本不变

并发请求是突破速率限制的有效方法,原理类似增加服务员数量Python的aiohttp库提供了简单易用的异步请求实现分布式测试可以进一步提升压力测试规模监控和优化是确保测试效果的关键环节遵守合理使用原则,避免滥用API服务现在你就可以在优快云算力平台上部署Qwen2.5-7B实例,开始你的压力测试之旅了!💡获取更多AI镜像想探索更多AI镜像和应用场景?访问优快云星图镜像广场,提供丰富的预置镜像,覆盖大模型推理、图像生成、视频生成、模型微调等多个领域,支持一键部署。

QuartzStag78的博客 785

在VS2019里把JSBSim飞行模型集成到你的C++项目里(附完整配置流程和常见错误解决)

本文详细介绍了如何在Visual Studio 2019中将JSBSim飞行模型集成到C++项目中,包括环境准备、源码编译、项目配置和常见错误解决方案。通过实战技巧和优化建议,帮助开发者高效实现高精度飞行仿真功能,提升开发效率。

weixin_42620202的博客 413

深入解析MSPM0系列Keil开发中‘ti_msp_dl_config.h‘缺失问题的根源与修复

本文深入解析TI MSPM0系列Keil开发中'ti_msp_dl_config.h'文件缺失问题的根源与修复方法。该错误常见于编译时提示file not found,主要因SysConfig工具未正确生成或工程路径配置错误导致。文章提供了从环境检查、手动生成文件到工程配置调整的系统化解决方案,帮助开发者快速解决这一常见KEIL开发难题。

gold的博客 970

【Agent】大模型在线API接入

SDK(Software Development Kit,软件开发工具包)。SDK 是对 API 的封装,让开发者不需要手写复杂的 HTTP 请求,而是用简洁的代码就能调用 API。

weixin_51589123的博客 647

从零构建EtherCAT从站:SSC工具配置与TwinCAT3 PDO/SDO调试实战

本文详细介绍了从零构建EtherCAT从站的完整流程,重点讲解SSC工具配置与TwinCAT3 PDO/SDO调试实战。通过解析EtherCAT通信机制、PDO与SDO的核心概念,提供SSC工具配置技巧、XML文件生成与校验方法,以及TwinCAT3环境下的调试经验,帮助开发者高效完成EtherCAT从站开发与优化。

weixin_42520573的博客 342

Qwen3-8B API限流破解:云端自建服务避免调用限制

本文介绍了如何基于星图GPU平台自动化部署Qwen3-8B镜像,快速搭建私有化大模型推理服务。通过该方案,用户可摆脱官方API调用限制,适用于AI应用开发、模型微调等场景,实现高性能、低成本的本地化部署与OpenAI兼容接口的无缝迁移。

NightshadeStag56的博客 295

Catia二次开发QueryInterface的操蛋问题

探索了很久,尝试录制宏,打开部件属性窗口,然后随意设置一些属性(必须改变一些东西才能录制成功,否则不会录制到任何东西),再看录制的结果,发现原来CATIAAnalyze是从Product那里来的。例如获得一个部件的体积,找到相关接口CATIAAnalyze,但是这个部件的CATIAAnalyze的对象不知道如何获取。总结一下,写Catia二开代码,就像漂亮国那款《莫里秀》 又名《爸爸死哪了》的综艺节目,大部分时间都是在找爸爸!Catia二开很痛苦,明明已经找到接口类,但是却不知道怎么获得这个接口类的对象。

gergul的专栏 748

Western blot (WB) 灰度分析进阶指南:ImageJ 高效定量技巧与实战优化

本文详细介绍了使用ImageJ进行Western blot灰度分析的进阶技巧,包括批量处理、背景校正和疑难条带处理等实战优化方法。通过自动化宏脚本和动态背景校正,显著提升分析效率和准确性,特别适合科研人员处理复杂WB数据。

weixin_42557830的博客 900

大模型统一代理服务AIClient-2-API

AIClient-2-API 是一个能将多种仅客户端内使用的大模型 API(Gemini CLI, Antigravity, Qwen Code, Kiro ...),统一封装为本地 OpenAI 兼容接口的强大代理。

wbsu2004的博客 4097

【Unity 城市建模插件】POLY-Megapolis City Pack 提供超过数百种城市建筑、道路、车辆与城市家具模型,完美适用于构建现代化城市、模拟城市游戏、都市题材冒险类游戏和开放世界项目

POLY - Megapolis City Pack 是一套风格统一、内容丰富的低多边形城市建模资源包,专为 Unity 引擎设计。该资源包提供超过数百种城市建筑、道路、车辆与城市家具模型,完美适用于构建现代化城市、模拟城市游戏、都市题材冒险类游戏和开放世界项目。无论是快速原型开发还是正式发布项目,POLY 系列都能提供高效、风格统一的解决方案。

2403_88403568的博客 635

Qwen3大模型本地部署全攻略:从环境搭建到API集成实践

Qwen3作为新一代大语言模型,在架构设计上实现了多维度突破。其独创的双模式推理机制允许用户通过在提示词或系统消息中添加`/think`与`/no_think`指令,灵活切换模型运行模式。深度思考模式下,模型会进行多步逻辑推理,特别适合复杂问题求解;而快速响应模式则能实现近实时输出,满足高并发场景需求。语言支持方面,该模型已覆盖119种语言及方言,配合MCP多轮对话优化技术,显著提升了跨语言交互的...

gitblog_00769的博客 939

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

Mac用户怎么跑Qwen3?云端GPU完美替代本地部署

本文介绍了如何通过星图GPU平台自动化部署“AI 写作大师 - Qwen3-4B-Instruct”镜像,解决Mac用户因缺乏CUDA支持难以本地运行大模型的痛点。该平台预置完整环境,一键启动即可在云端高效运行Qwen3模型,适用于AI写作、智能对话生成等典型应用场景,实现低成本、高性能的AI内容创作。

SilverMoon18的博客 887

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

8、【AI】【Agent】联网使用大模型(一)

本文分析了自回归模型中上下文长度对token生成速度的影响,指出在CPU推理场景下,上下文长度(≤8K)对速度的影响远小于模型参数量,主要受限于数据搬运效率。作者建议在硬件受限时优先选择小模型或使用云端API,并比较了免费网页版与收费API的本质区别:前者是用户产品,后者是生产力工具。API收费的核心原因在于防止滥用并覆盖高昂的GPU成本,而网页版存在功能限制。最后强调应合法使用官方API,避免违规抓取网页版数据。

HIT_Weston的博客 813

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

上一篇: 10种软件开发模型整理
下一篇: Ollama本地部署Llama3-Chinese并进行测试
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2833原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值