二胎男孩幼儿园,20岁兄长为减轻父母压力,学编程月入过万

如何用Python爬取网页数据,Python爬取网页详细教程 阅读详情

我国人口增长率不断下跌,甚至徘徊在国际人口警戒线附近,近日就有一位砖家出主意让央行印2万亿推动人口生育率。实际上生育率降低的主要原因是生育成本太高了,老百姓根本就生不起,也养不起!前段时间有一位懂事的00后,弟弟上幼儿园,为减轻父母压力,主动承担起自己作为哥哥的义务,选择学习编程月入过万,感动了不少网友!

在这里插入图片描述
00年出生的小张同学老家在湖北随州,2018年小张同学到武汉一所大专院校上大学。当年除了高考,小张的人生还有一件喜事,爸妈在家里又生了一个二胎弟弟。自己上大学了,家里突然多了一个可爱的小弟弟,这种体验真的非常奇特。每次寒暑假回家,小张多多少少也会带点小玩意回去,逗逗连话都说不清的小不点。

在这里插入图片描述

在大学时,小张选择了计算机课程作为选修课程,学过一些最基础的计算机语言知识,但实际能力还是约等于零。

小张学习非常积极主动,每次上课都紧跟讲师节奏,认真听讲,从不迟到早退,上课主动上交手机,不聊天、睡觉、开小差、吃零食。小张的认真积极也给周围的同学极大的感染力,被选为了小组长。不仅是小组项目实训的负责人,还给予学习困难的组员施以援手,在力所能及的范围内给大家学习上的帮助!

在毕业一个星期之内,小张在武汉收到了三份入职通知书,他选择了其中工资最高的一家月薪10K,小张很开心,此时家里的小弟弟也要上幼儿园了,第一个月发完工资,就帮小弟弟买了个最酷的奥特曼玩具!

在这里插入图片描述
小张原本是一名大专学历的独生子女,但是在武汉上大学期间,父母给他生了个二胎小弟弟。快二十岁了突然多个萌萌哒的二胎小弟弟,感觉还是很奇妙的。小张也非常懂事,主动承担起了自己作为哥哥的责任,也考虑帮父母减轻压力,通过学习编程在武汉实现月入过万,真的非常优秀,怪不得身边的小伙伴都纷纷为他竖起了大拇指!

关于Python技术储备

学好 Python 不论是就业还是做副业赚钱都不错,但要学会 Python 还是要有一个学习规划。最后大家分享一份全套的 Python 学习资料,给那些想学习 Python 的小伙伴们一点帮助!

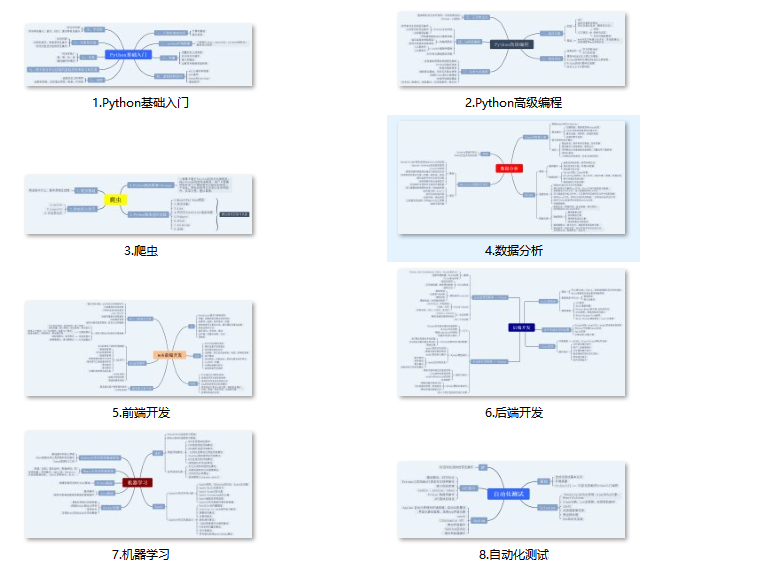
一、Python所有方向的学习路线

Python所有方向路线就是把Python常用的技术点做整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。
二、学习软件

工欲善其事必先利其器。学习Python常用的开发软件都在这里了,给大家节省了很多时间。

三、入门学习视频

我们在看视频学习的时候,不能光动眼动脑不动手,比较科学的学习方法是在理解之后运用它们,这时候练手项目就很适合了。

四、实战案例

光学理论是没用的,要学会跟着一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

五、面试资料

我们学习Python必然是为了找到高薪的工作,下面这些面试题是来自阿里、腾讯、字节等一线互联网大厂最新的面试资料,并且有阿里大佬给出了权威的解答,刷完这一套面试资料相信大家都能找到满意的工作。


这份完整版的Python全套学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】


python爬虫入门教程(非常详细) 爬虫指的是一种自动化程序,能够模拟人类在互联网上的浏览行为,自动从互联网上抓取、预处理并保存所需要的信息。爬虫运行的过程一般是先制定规则(如指定要抓取的网址、要抓取的信息的类型等),紧接着获取该网址的HTML源代码,根据规则对源代码进行解析和抽取,最后进行处理和保存。爬虫在实际应用中广泛使用,如搜索引擎、大数据分析、交易数据采集等领域,都需要用到爬虫技术来实现信息的定向采集和处理。 阅读详情

相关推荐

手把手教你python--爬取网站首页(学生必看)

0基础小白也能学会的用 python 爬取网站首页,方法超级简单,今天手把手教你。

qq_32139859的博客 9307

python爬取网页详细教程

可以使用Python中的Pandas库,将数据存储到Excel或CSV文件中,或者使用Python自带的sqlite3库,将数据存储到SQLite数据库中。随着互联网的高速发展,网页上的信息也越来越丰富,而Python作为一门高效的编程语言,可以帮助我们快速地获取所需的信息。requests库是Python中最常用的HTTP库,可以帮助我们向目标网站发送GET或POST请求,并获取网页上的数据。BeautifulSoup库是Python中最常用的HTML解析库,可以帮助我们快速地获取网页中的各种信息。

xiangxueerfei的博客 8952

Python网页抓取教程

​— Python网页抓取教程:循序渐进 — 抓取网页入门其实挺简单的。在之前的文章中我们介绍了怎么用C#和JAVA两种方法来抓取网页,这一期给大家介绍一种更容易,也是使用最广泛的一种抓取方法,那就是Python。 说起Python,大家应该并不陌生,它是目前入门最简单的一种方法了,因为它是一种面向对象的语言。Python的类和对象比任何其他语言都更容易使用。此外,Python存在许多库,因而在Python中构建用于网页抓取的工具轻而易举。 在这篇Python网络抓取教程中,我们将分步骤讲解如何利..

candice931020的博客 1万+

程序员成神之路,一年挖坑,五年扛旗,十年成神

自人类社会诞生以来,等级就一直存在,有人指点江山,称之为“大神” 有人卸瓦搬砖,称之为“小白” 在程序员的世界里,等级同样森严。特别是在1年、5年、10年时会有大不同 据说到达上面每一个级别,就会脱胎换骨一次 我们一起来看看。 每个人都做过小白,但不是人人都能成为大神 一年到十年,磨的不是时间而是汗水和经验 小白们,莫急莫燥且听我一言所谓“十年磨一剑”。听内心之声音,找前进之方向按自己之快慢! 关于Python技术储备 学好 Python 不论是就业还是做副业赚钱都不错,但要学会 P

Javachichi的博客 3302

利用HFSS仿真优化圆极化微带天线的耦合馈电设计

本文深入探讨了利用HFSS仿真软件优化圆极化微带天线性能的关键方法。通过对比传统直接馈电与耦合馈电方式,详细阐述了耦合馈电在提升阻抗匹配、改善轴比带宽及增强设计鲁棒性方面的显著优势。文章结合FR4板材的实战案例,逐步演示了在HFSS中建立模型、进行参数扫描与圆极化性能优化的完整流程,为设计高性能、高纯度的圆极化天线提供了实用指南。

weixin_29233333的博客 547

链式中介效应结果解读:从Bootstrap置信区间到实践意义

本文深入解析链式中介效应结果的解读方法,从Bootstrap置信区间的应用到实践意义的阐述。通过实际案例展示如何分析总效应、直接效应和间接效应,并强调效应量评估的重要性。文章还提供了构建逻辑解释的三步法,以及敏感性分析和报告撰写的实用技巧,帮助研究者准确解读链式中介效应。

weixin_33690367的博客 718

如何用python爬取网页数据,python爬取网页详细教程

大家好,本文将围绕python怎么爬取网站所有网页展开说明,如何用python爬取网页数据是一个很多人都想弄明白的事情,想搞清楚python如何爬取网页数据需要先了解以下几个事情。

aifans_bert的博客 2万+

海思Hi3061M MCU:为高速吹风筒市场注入智能动力

此外,海思还提供了丰富的软件开发工具和生态环境组件,帮助开发者快速实现复杂功能。高速吹风筒因其高效的风力和快速的干燥效果,近年来在市场上越来越受欢迎。然而,传统的高速吹风筒在性能、噪音和使用寿命等方面仍有改进的空间。凭借其高性能、低功耗、低噪声和易用的开发工具,为高速吹风筒市场带来了全新的解决方案。这不仅提高了用户的使用体验,还延长了电机的使用寿命。这不仅减少了电机的电磁噪声,还提高了电机的运行效率。还支持风机顺逆风启动适配多种电阻范围的电机,进一步提高了吹风筒的适用性和灵活性。

2401_83448585的博客 2016

4个详细步骤讲解Python爬取网页数据操作过程!(含实例代码)

今天为大家带来的内容是4个详细步骤讲解Python爬取网页数据操作过程!(含实例代码)本文具有不错的参考意义,希望在此能够帮助到大家!**提示:**由于涉及代码较多,大部分代码用图片的方式呈现出来!

WANGJUNAIJIAO的博客 1万+

高性能网站设计之缓存更新的套路

看到好些人在写更新缓存数据代码时,先删除缓存,然后再更新数据库,而后续的操作会把数据再装载的缓存中。然而,这个是逻辑是错误的。试想,两个并发操作,一个是更新操作,另一个是查询操作,更新操作删除缓存后,查询操作没有命中缓存,先把老数据读出来后放到缓存中,然后更新操作更新了数据库。于是,在缓存中的数据还是老的数据,导致缓存中的数据是脏的,而且还一直这样脏下去了。 我不知道为什么这么多人用的都是这

代码技巧 1万+

搞定ESD(五):静电放电问题分析与调试

前面深入分析了静电放电的干扰机理、耦合路径,从现在开始将进入下一个大家非常关注的环节:静电放电问题分析与调试,掌握静电放电问题的分析方法,快速锁定敏感设备或者耦合路径,可以达到事半功倍的效果。

记得诚 2797

30岁+,大龄青年转行程序员的切身经历

今天文章的主人公是我的一位读者,暂且称他为 A 君。不过 A 君有点特别,非科班,工作 10 年后才转行Python程序员。今年 36 岁,目前在某行业头部企业任职前端负责人,管理 40+ 人的前端团队。

h1453586413的博客 5514

【STM32实物】基于STM32设计的智能仓储管理系统

近年来,随着我国仓储发展的和药品需求的不断增多,许多医院都采用药物仓储管理系统。我国的药物仓储产业已经有了长足的发展,仓库的规模不断变大,对仓储的要求也不断增高,药物的存储,识别以及对仓储环境条件的要求成为仓储的重要决策,他们可以根据不同的特点在不同场景中使用。本文详细介绍了一个基于单片机技术的智能仓储管理系统的设计与实现,这个系统可谓是集射频识别(RFID)技术和环境监测传感器于一身,旨在提高仓储操作的自动化和精确度。

嵌入式阿齐Archie 1万+

python爬虫入门,轻松爬取网页上的数据(非常详细)

随着网络的普及和信息爆炸式增长,我们可以通过网络来获取各种各样的数据。而Python作为一门强大而灵活的编程语言,可以帮助我们快速地从HTML网页中提取数据。本文将介绍Python爬虫的入门知识,并详细讲解如何使用Python爬虫来爬取HTML网页上的数据。1.了解HTML和网页结构2.安装和导入相关依赖库3.发送http请求获取网页内容4.解析HTML网页内容5.定位内容和提取数据6.保存抓取的数据在开始编写爬虫之前,了解HTML和网页的结构是非常重要的。

优快云_430422的博客 11万+

【DeepSeek开发入门】DeepSeek API 开发初体验

在人工智能蓬勃发展的时代,DeepSeek作为一款功能强大的AI大模型,为开发者提供了丰富的接口和便捷的开发体验。本文将基于DeepSeek的几个关键接口,带你快速入门,开启DeepSeek开发的探索之旅。通过本文,你已经初步了解了DeepSeek开发中几个重要接口的使用方法,包括列出模型、对话补全和查询余额接口,以及开发过程中的常见问题及解决办法。这是你踏入DeepSeek开发领域的第一步。在后续的学习中,你可以深入研究模型的参数调优,探索不同模型在各种场景下的应用,如利用模型实现更复杂的推理对话功能。

寻道AI,探索AI无限可能! 2764

华为OD机考双机位C卷 - 螺旋数字矩阵 (Java & Python& JS & C/C++ & GO )

华为OD机考双机位C卷 - 数字螺旋矩阵(OD上机考试双机位C卷)。提供在线OJ刷题。Java、C++、Python、GO语言、C语言、JavaScript题解,并提供完整思路讲解。

算法大师! 3219

走好这六步,python爬虫爬取网页数据手到擒来~

用python的爬虫爬取数据真的很简单,只要掌握这六步就好,也不复杂。以前还以为爬虫很难,结果一上手,从初学到把东西爬下来,一个小时都不到就解决了。

大模型工程师老蓝的博客 1万+

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

Python3 注释

Python3 注释

xiqng17111342931的博客 2225

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

Python爬虫教学——简单爬取网页数据

本文是一篇介绍如何用Python实现简单爬取网页数据并导入MySQL中的数据库的文章。主要用到BeautifulSoup requests 和 pymysql。

xiaoganbuaiuk的博客 2万+

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

因为有了它,我用舍友玩王者的时间拿到了华为offer

在我们的大学生活中,卷王无处不在。如何在不知不觉超越我们的同学成了我们每个人的必修课。各种各样的语言应有尽有。我们可以随时安装各种插件,必备为各种语言配环境困扰!,输入我们云IDE的网址,我们就可以“”,你就彻底不用为此担心了。,即可开始创建工作空间啦~

20岁爱吃必胜客 1733

Python爬虫入门教程(非常详细)

爬虫的全称为网络爬虫,简称爬虫,别名有网络机器人,网络蜘蛛等等。网络爬虫是一种自动获取网页内容的程序,为搜索引擎提供了重要的数据支撑。搜索引擎通过网络爬虫技术,将互联网中丰富的网页信息保存到本地,形成镜像备份。我们熟悉的谷歌、百度本质上也可理解为一种爬虫。如果形象地理解,爬虫就如同一只机器蜘蛛,它的基本操作就是模拟人的行为去各个网站抓取数据或返回数据。

2201_75362610的博客 2万+

Python爬虫——简单网页抓取(实战案例)小白篇

在着手写爬虫抓取网页之前,要先把其需要的知识线路理清楚。 首先:了解相关的Http协议知识; 其次:熟悉Urllib、Requests库; 再者:开发工具的掌握 PyCharm、Fiddler; 最后:网页爬取案例;

m0_74942241的博客 2万+

Python网络爬虫使用教程

python爬虫资源抓取--urllib/requests/requests-html、正则表达式、数据解析-Beautiful Soup/lxml/selectolax、自动化爬虫--selenium、爬虫框架--Scrapy/pyspider、模拟登录与验证码识别、autoscraper

tttalk的博客 1万+

python爬取网页数据步骤,python爬取网页详细教程

Beautiful Soup提供一些简单的、python式的函数用来处理导航、搜索、修改分析“标签树”等功能。它是一个工具箱,通过解析文档为用户提供需要抓取的数据,因为简单,所以不需要多少代码就可以写出一个完整的应用程序。Beautiful Soup自动将输入文档转换为Unicode编码,输出文档转换为utf-8编码。你不需要考虑编码方式,除非文档没有指定一个编码方式,这时,Beautiful Soup就不能自动识别编码方式了。然后,你仅仅需要说明一下原始编码方式就可以了。

w666666Wwwwwww的博客 8072

蓝桥杯成绩公布啦,国赛将至?大一省一选手带你冲刺国赛

大一省一选手的总结与国赛冲刺计划

欢迎关注,一起进步! 4609
上一篇: 北京,北京,用Python解析生活成本之高,讨生活之不易啊
下一篇: 程序员工资三年只涨2000怒怼:努力3年就涨这么点,不干了
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2840原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
