KL社区发现算法概述与源码

GRPO、PPO与DPO:大模型微调对齐算法工程选型指南 大语言模型对齐(Alignment)是将模型输出与人类意图、安全规范及业务约束保持一致的关键技术,其核心在于通过偏好学习或强化学习优化策略分布。PPO(近端策略优化)、DPO(直接偏好优化)和GRPO(梯度正则化策略优化)代表了三种主流范式:PPO依赖奖励模型与Critic网络实现多目标平衡;DPO绕过显式奖励建模,将偏好学习转化为分类任务,提升训练效率;GRPO则在PPO基础上引入自适应梯度正则机制,在低资源场景下实现更精细的KL控制。三者在标注噪声鲁棒性、显存开销、收敛稳定性及行为约束精度上存在本质差异 阅读详情

本文在实现KL算法的过程中实现了社区划分结果,同时实现了不同社区的可视化结果。


GN社区发现算法传送门


author:xiao黄
缓慢而坚定的生长
公众号:Community Detection
本人更新在csdn关于社区发现(Community Detection)方面的知识会同步更新到公众号中。


KL算法介绍

Kernighan-Lin算法是一种试探优化的方法,其基本的思想是为网络引入一个试探函数Q,Q代表某两个准社团内部的边数减去两个准社团之间的边数的差值,然后得到使Q值最大的划分方法。

首先将整个网络的节点随机的或根据网络的现有信息分为两个部分,在两个社团之间考虑所有可能的节点对,试探交换每对节点并计算交换后的ΔQ,ΔQ=Q交换后-Q交换前,记录ΔQ最大的交换节点对,并将这两个节点互换,记录此时的Q值。规定每个节点只能交换一次,重复这个过程直至网络中的所有节点都被交换一次为止。需要注意的是不能在Q值发生下降时就停止,因为Q值不是单调增加的,既使某一步交换会使Q值有所下降,但其后的一步交换可能会出现一个更大的Q值。在所有的节点都交换过之后,对应Q值最大的社团结构即被认为是该网络的理想社团结构。

KL算法是将网络分成两个指定规模大小的社区。

算法参数介绍

kernighan_lin_bisection(G, partition=None, max_iter=10, weight=‘weight’, seed=None)
G:图
partition:(元组格式)一对包含初始分区的iterables。如果未指定,则使用随机平衡分区。
max_iter:尝试交换在放弃前找到改进的最大次数。
weight:权重。如果没有,则所有权重都设置为1。
seed:随机数生成状态的指示器。
return:表示两个社区的一对节点。
返回类型:tuple(元组)

代码

import networkx as nx
import matplotlib.pyplot as plt
from networkx.algorithms import community  
from networkx.algorithms.community import kernighan_lin_bisection


def draw_spring(G,com):
    '''
    G:图
    com:划分好的社区
    node_size表示节点大小
    node_color表示节点颜色
    node_shape表示节点形状
    with_labels=True表示节点是否带标签
    '''
    pos = nx.spring_layout(G) # 节点的布局为spring型
    NodeId = list(G.nodes())
    node_size = [G.degree(i)**1.2*90 for i in NodeId] # 节点大小

    plt.figure(figsize = (8,6)) # 图片大小
    nx.draw(G,pos, with_labels=True, node_size =node_size, node_color='w', node_shape = '.')
    
    color_list = ['pink','orange','r','g','b','y','m','gray','black','c','brown']
    # node_shape = ['s','o','H','D']

    for i in range(len(com)):
        nx.draw_networkx_nodes(G, pos, nodelist=com[i], node_color=color_list[i],  with_labels=True)
    plt.show()

if __name__ == "__main__":
    G = nx.karate_club_graph() # 空手道俱乐部

    # KL算法
    com = list(kernighan_lin_bisection(G))
    print('社区数量', len(com))
    print(com)
    draw_spring(G,com)

结果:
这就是KL算法划分的结果,分为两个社区,用不同的颜色表示出来。
可以用print(com)语句查看划分后社区中的节点。
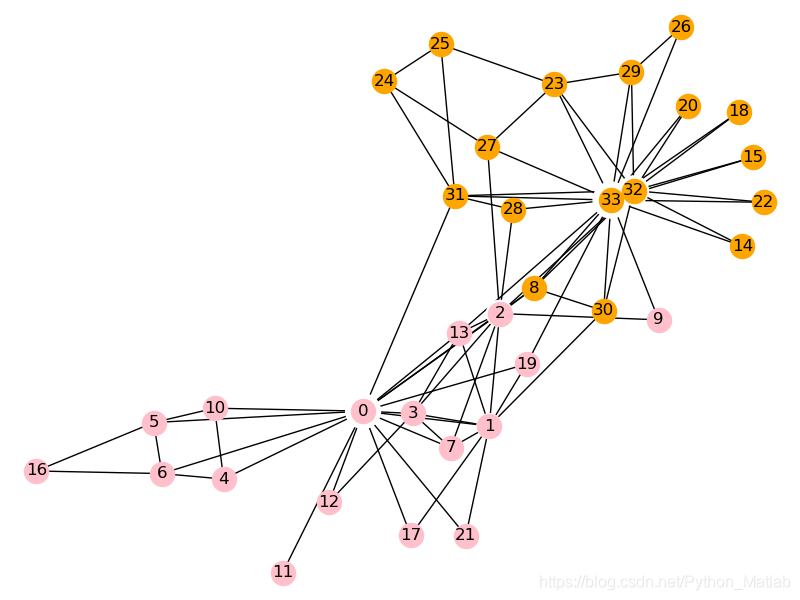
在这里插入图片描述
参考文献:Kernighan B W, Lin S. A efficient heuristic procedure for partitioning graphs. Bell System Technical Journal, 1970 (49): 291-307.
论文地址:传送门
MNN量化源码深度解析:int8校准与weight重排实现原理 量化是模型压缩与端侧部署的核心技术,其本质是将浮点计算映射为低比特整型运算,在精度、速度与内存间寻求工程平衡。MNN采用后训练量化(PTQ)架构,以校准(Calibration)生成activation histogram、per-channel weight scale计算、NEON友好的weight reorder等机制,实现硬件亲和的int8推理。关键技术价值在于避免FP32副本、支持自定义算子扩展、提供可hook的量化回调链路。典型应用场景包括嵌入式AI、边缘NPU适配及国产SoC模型落地。本文聚焦 阅读详情

相关推荐

DeepSeek-V2大模型知识蒸馏实战指南:Logits蒸馏、Reverse KL与GKDTrainer避坑

知识蒸馏是大语言模型轻量化部署的核心技术,其本质是通过教师模型输出分布指导学生模型学习。在LLM时代,传统基于隐藏层特征对齐的蒸馏方法(如TinyBERT)因参数冗余性差异、注意力机制不兼容及训练不稳定等问题已失效;当前主流实践转向仅利用预测层logits进行分布匹配,关键在于选择Reverse KL损失、合理设置温度系数T与JSD beta值,并规避RoPE位置污染、logits偏移等DeepSeek-V2特有陷阱。该技术广泛应用于边缘推理加速、API服务降本及多端模型部署等场景,本文聚焦DeepSeek

weixin_33805743的博客 464

社区检测

社区检测常用算法1.Kernighan–Lin二部算法2.派系过滤算法(cliquepercolationmethod,CPM) 1.Kernighan–Lin二部算法 核心思想:通过对节点的迭代交换将网络分割成两组,以减少两组节点之间的边缘切割。 Kernighan-Lin算法可描述为下面的步骤: Step1:给定N个节点的图,随机划分图节点到两个指定规模大小的 n1,n2 群组; Step2:分别从 n1,n2 群组中选择节点i和节点j组成顶点对(i, j),交换i和j的位置,并计算交换前后群组之间割集

weixin_42244879的博客 2378

KL算法C++实现

KL算法C++实现,可直接运行,经典社区划分算法之一

Kernighan-Lin算法

注意:之前对于公式用LATEX编写,复制的图片,不知怎么就显示不出,凡是框框的地方,用文字表示了公式。          Kernighan-Lin算法是一种启发式算法,基于贪婪原理将网络划分为两个大小已知的社团。     所要解决的问题描述:给定一个无向带权图G=(V,E,C),其中V为一含有2n个节点的集合,E为边集合,C为2n*2n且对称的权重矩阵(Cij表示节点i和节点j直接

u011089523的博客 1万+

Kernighan-Lin-algorithm:为了实现针对图划分问题的Kernighan-Lin算法,该算法考虑了将图的节点(其边沿上的成本)划分为给定大小的子集的问题,以最大程度地减少所有切边上的成本之和。 我们可以使用该算法来使电路板上的电路连接数最少。 我使用C ++来实现此算法

克尼根·林算法 为了实现针对图划分问题的Kernighan-Lin算法,该算法考虑了将图的节点(其边沿上的成本)划分为给定大小的子集的问题,以最大程度地减少所有切边上的成本之和。 我们可以使用该算法来使电路板上的电路连接数最少。 我使用C ++来实现此算法。 使用UCI基准

Kernighan-Lin-Algorithm:KL的简单Java实现

克尼根·林算法 KL的简单Java实现 通过csv文件接收目标地图,该文件的数据格式设置为“起始顶点,终止顶点,边缘权重”。 您可以从控制台输入初始分组状态。 由于没有异常检测机制,因此输入数据应以正确的格式发送。

社区发现算法——KL算法

K-L(Kernighan-Lin)算法 原始论文(An efficient heuristic procedure for partitioning graphs) K-L(Kernighan-Lin)算法是一种将已知网络划分为已知大小的两个社区的二分方法,它是一种贪婪算法。 它的主要思想是为网络划分定义了一个函数增益Q。 Q表示的是社区内部的边数与社区之间的边数之差。 根据这个方法找出使增益函数Q的值成为最大值的划分社区的方法。 具体策略是,将社区结构中的结点移动到其他的社区结构中或者交换不同社区结构中

qq_16543881的博客 7891

TSP 的 Lin-Kernighan 启发式实现_C++_代码_下载

LK启发式TSP 实施解决旅行商问题的 Lin-Kernighan 启发式算法 步骤1 编译代码 g++ LKMain.cpp LKMatrix.cpp -o LKSolver 第2步 运行代码 更多详情、使用方法,请下载后阅读README.md文件

Kernighan-Lin

Kernighan-Lin算法 算法伪代码 输入 待划分的大图G=(V,E) 输出 划分后子图A、B 1、将图G平均划分为A、B两个初始子图 do ​ 计算A、B子图中各个节点的D_values值 ​ for i in range(|V|/2) ​ 从A和B两个子图中,分别找出a、b,使得gain=D_values[a] + D_values[b] - (2 * c_ab)最大 ​ 将a、b移除,不参与后面过程;将a、b、gain存入gains[] ​ 更新A、B

石径的博客 2631

ADS SerDes仿真实战:深入解析Tx_Diff均衡器(EQ)参数对眼图质量的影响

本文以ADS仿真平台为基础,深入解析了SerDes设计中Tx_Diff均衡器(EQ)参数对信号完整性的核心影响。通过实战演示,详细对比了去加重(De-emphasis)与FIR抽头系数两种调节模式,揭示了它们如何有效对抗信道损耗与码间干扰,从而显著改善眼图的高度、宽度与抖动性能,为高速串行链路设计提供关键调优思路。

weixin_29230901的博客 228

Flowable多数据源实战:从配置到指定Schema的避坑指南

本文详细介绍了Flowable多数据源配置的实战指南,包括基础配置、数据源Bean创建、指定Schema的进阶配置以及常见问题排查。通过具体代码示例和避坑建议,帮助开发者高效实现多租户系统中的工作流引擎集成,特别强调了schema设置和事务管理的注意事项。

weixin_30824599的博客 486

社区发现算法 python源码_KL社区发现算法概述与源码

本文在实现KL算法的过程中实现了社区划分结果,同时实现了不同社区的可视化结果。author:xiao黄缓慢而坚定的生长公众号:Community Detection本人更新在博客园关于社区发现(Community Detection)方面的知识会同步更新到公众号中。KL算法介绍Kernighan-Lin算法是一种试探优化的方法,其基本的思想是为网络引入一个试探函数Q,Q代表某两个准社团内部的边数减...

weixin_39639260的博客 617

使用HFSS仿真分支波导耦合器

本文介绍了分支波导耦合器的HFSS仿真设计过程。首先给出了器件关键参数(t=0.365mm,l=1.600mm等),详细说明了建模步骤:包括创建中心分支、设置变量参数、镜像复制两侧分支、矩形波导端口设计等操作。重点阐述了激励端口设置方法,包括四个端口的积分线绘制,以及求解频率设定。最后展示了S参数、幅度平衡度和相位差等关键性能指标的仿真结果提取方法。整个设计过程体现了HFSS在微波器件仿真中的参数化建模和结果分析能力。

shao666888的博客 180

从聊天里长出知识图谱:MyContext kl-graph 两阶段摄取与多分辨率社区检测完全指南

MyContext 是一款本地优先的桌面知识工作应用,其核心模块 [kl-graph](https://link.gitcode.com/i/d44a273287ab5e8f22383dc69e6e77f6) 能把你的聊天记录、文档、邮件等日常沟通数据,自动提取成实体与事实,构建成一张**知识图谱**,再用**两阶段摄取**(Phase A + Phase B)和 **L0–L3 多分辨率社区检测

gitblog_00449的博客 360

别再只用线性回归了!用sklearn的核岭回归搞定非线性数据(附RBF核调参实战)

本文详细介绍了如何使用sklearn的核岭回归处理非线性数据,特别是RBF核的应用与调参实战。通过网格搜索找到最佳参数组合,核岭回归能有效捕捉数据中的复杂波动,显著提升模型性能。适合需要解决非线性问题的数据科学家和机器学习工程师。

weixin_34246529的博客 338

Multisim14.3中FPGA接口电路设计:原理图项目应用

深入讲解在multisim14.3环境下构建FPGA接口电路的方法,结合原理图设计与项目实践,展现multisim14.3强大的电路仿真能力,提升数字系统开发效率。

weixin_42578963的博客 1158

【LLM】VeRL训练框架源码分析

「VeRL(Volcano Engine Reinforcement Learning for LLMs)」 VeRL 是什么 开源的 LLM 后训练(RL/RLHF/RLAIF)框架,由字节 Doubao/Seed 团队主导。它把算法流和分布式执行解耦,既能像写“数据流”一样拼装 RL 步骤,又能在多种训练/推理引擎上高效跑(FSDP、Megatron-LM、vLLM、SGLang 等)。官方称相较已有系统在多种 RLHF 算法上可达 1.53×–20.57× 吞吐提升(论文实验)。(GitHub)

发现问题,并解决问题,批判性思维 4483

SAP_SD模块深度解析SAP信用检查中的“未清数量”取值逻辑

确认数量 vs 订单数量:如果系统配置了可用性检查(ATP),并且订单只确认了部分数量,信用检查通常只占用已确认数量的额度(具体取决于信用组的配置)。在SAP中,未清订单数量的计算并非简单读取订单行项目的目标数量(VBAK-KWMENG),而是基于**计划行(Schedule Lines)**层级来汇总的。状态的转换点:当交货单创建(VL01N)并保存时,这部分数量对应订单的“未清订单数量”减少,“未清交货数量”增加。业务人员眼中的未清数量很简单:“我卖了100个,发了30个,未清就是70个”。

我小时候很黑的博客 314

2025阿里算法岗面试高频题解析与备战策略

算法面试中,对基础原理的深度理解往往比刷题数量更重要。以KMP算法为例,next数组的构建体现了利用已知信息避免重复计算的核心思想;而KL散度与ELBO的推导,则是理解VAE等生成模型损失函数的关键。从经典算法到机器学习理论,再到PID控制、粒子群优化等工业界常见算法,这些知识点共同构成了算法工程师的底层能力框架。它们不仅应用于搜索引擎、推荐系统、AI内容生成等实际业务场景,也正成为大厂筛选中考察候选人思维深度的高频切入点。理解从概念到原理再到技术价值的完整链条,能帮助求职者更好地应对系统设计、模型推导与业

weixin_34279246的博客 342

焊缝缺陷智能检测:基于 YOLO 的工业质检系统实战

从焊缝缺陷数据集的构建到模型训练,从桌面检测界面到缺陷统计输出,本文覆盖了一套工业焊缝质检系统的完整路线。这个场景的核心难点在数据层面——气孔和裂纹这类小目标的标注质量直接决定了模型的最终表现。建议先在开源数据集上跑通全链路,确认 mAP 达到可接受的水平后,再通过补充特定类型的小目标数据和提升输入分辨率来做精度优化。工业场景中,漏检一个气孔的成本和误报一个假阳性的成本不一样——根据对两类成本的承受力,调整置信度阈值来找到业务上的最佳平衡点。

m0_71589036的博客 202

MinerU在线API异步调用代码开发示例

本文展示了如何使用Python异步编程调用MinerU在线API进行文件批量上传。代码示例包含三个主要功能:1) 通过API密钥获取文件上传URL;2) 使用信号量控制并发上传多个文件;3) 获取提取结果。实现采用httpx异步客户端和asyncio库,支持文件存在性检查、错误处理和日志记录。示例中演示了如何上传PDF文件到MinerU平台,并提供了获取批量处理结果的接口。该代码可作为异步调用MinerU API的参考实现。

拥抱具身智能,昇腾Ascend C 353

OpenClaw-RL源码解析:离线策略蒸馏框架与智能体化强化学习实践

强化学习通过智能体与环境的交互学习最优策略,其核心在于从经验中高效提取知识并做出决策。离线强化学习作为关键分支,专注于从静态数据集中学习,避免了在线交互的高成本与风险。离线策略蒸馏技术在此基础上,旨在将多个专家策略的知识整合到一个更强大的单一智能体中,解决了多源异构策略数据的融合难题,提升了策略的鲁棒性与泛化能力。这一方法在机器人控制、游戏AI、自动驾驶等需要安全、高效地从历史经验中学习的场景中具有重要价值。OpenClaw-RL项目正是这一技术思想的工程化典范,其源码深度实现了智能体化强化学习与离线策略蒸

weixin_34408624的博客 379

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

RLHF实践指南:从higgsfield源码理解人类反馈强化学习训练链路

在大型语言模型的对齐训练中,人类反馈强化学习(RLHF)已成为关键技术。其核心思想是通过奖励模型模拟人类偏好,并借助近端策略优化(PPO)指导策略模型更新,同时利用KL散度约束防止模型偏离原始分布。这一套机制虽然概念清晰,但工程实现却涉及奖励模型训练、旧策略logprobs计算、广义优势估计(GAE)等多个复杂环节。higgsfield账号下的开源项目提供了直白、可运行的PyTorch实现,让研究者和开发者能够低成本复现完整训练流程。借助小模型和少量偏好数据,即可在单张消费级显卡上观察模型行为随人类反馈的演

weixin_30952479的博客 288

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

人工智能——最大熵与EM算法,腾讯面试几面

1 机器学习======2 最大熵与EM算法==========2.1 最大熵。

2401_84252890的博客 465

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

DPO+算法深度评测:从原理到实践,全面解析偏好对齐的工程化改进

在大型语言模型(LLM)的微调领域,监督微调(SFT)教会模型完成任务,而偏好对齐则旨在让模型的输出更符合人类的价值观和喜好。其核心原理是通过优化算法,利用人类对成对答案的偏好数据,直接调整模型参数,使其倾向于生成更受青睐的响应。这项技术的核心价值在于能够高效、低成本地塑造模型的“品味”和风格,对于提升模型输出的安全性、有用性和用户体验至关重要,广泛应用于对话系统、内容生成和代码助手等场景。本文聚焦于DPO+这一改进算法,它通过引入稳健化损失函数和隐式数据重要性加权等机制,显著提升了训练稳定性与数据效率,为

weixin_33182798的博客 323

对CbAS优化算法的简单介绍

对CbAS优化算法的简洁介绍

2302_79787639的博客 932
上一篇: python实现一个简单的猜数游戏
下一篇: LVQ神经网络的分类——乳腺肿瘤诊断
xiao黄
xiao黄 优质创作者: 人工智能技术领域 优质创作者: 人工智能技术领域 领域专家: 数据科学与机器学习技术领域 领域专家: 数据科学与机器学习技术领域
博客等级 码龄8年 1万+粉丝 250原创
评论 5
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

xiao黄

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值