《封号码罗》python爬虫之60行代码破解CSS偏移反爬虫(三)

用Frida-RPC搞定大麦App最新版签名:一个脚本解决x-sign和x-mini-wua 本文深入解析大麦App最新版签名机制(x-sign和x-mini-wua),详细介绍如何利用Frida-RPC技术开发稳定脚本获取签名参数。通过实战案例展示Java上下文切换、参数序列化等关键技术解决方案,为安全研究和技术验证提供可靠方案。 阅读详情

CSS偏移反爬虫,利用爬虫程序无法渲染css,但是浏览器能渲染css的特性设计出来的反爬虫手段
在这里插入图片描述
在这里插入图片描述
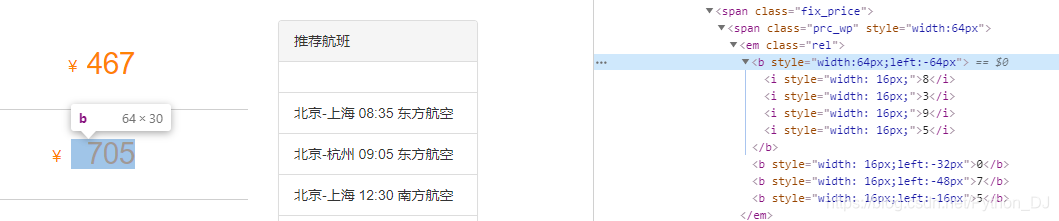
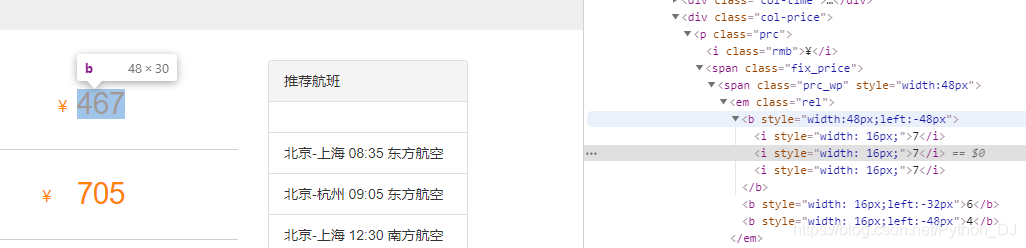
上面的网页信息,页面显示的内容和实际的HTML文档不一样,这样爬虫就不能拿到准确的数据,因为网页显示数据不仅使用来i标签的数据,也使用来b标签的数据
观察发现:没有i标签的b标签都有一个left属性,利用left的值来做偏移,覆盖掉i标签中的数据

import requests
import re
from parsel import Selector

url = "http://www.porters.vip/confusion/flight.html"
resp = requests.get(url)
sel = Selector(resp.text)
em = sel.css("em.rel").extract()  # 定位到所有的em标签
# 提取数据
for element in em:
    element = Selector(element)
    # 定位所有b标签
    element_b = element.css("b").extract()
    b1 = Selector(element_b.pop(0))	# 删除0号元素,并返回0号元素
    # print(element)
    # print(element_b)
    # print(b1)
    # 获取第一对b标签中的值(列表)
    # base_price = b1.css("i::text").extract()    # - 需要删减的行
    b1_style = b1.css("b::attr('style')").get()  # + 需要添加的行
    # 获得具体的位置
    b1_width = "".join(re.findall("width:(.*)px;", b1_style))
    number = int(int(b1_width) / 16)
    # 取第一对b标签中的值(列表)
    print(number)
    base_price = b1.css("i::text").extract()[:number]
    # print(base_price)
    # 提取其他b标签的偏移值和数字
    alternate_price = []
    for eb in element_b:
        eb = Selector(eb)
        # 提取style属性
        style = eb.css("b::attr('style')").get()
        # print(style)
        # 获取具体的位置
        position = "".join(re.findall("left:(.*)px", style))
        # print(position)
        # 获得该标签下的数字
        value = eb.css("b::text").get()
        # 将b标签的位置信息和数字以字典的格式添加到替补票价列表中
        alternate_price.append({"position": position, "value": value})
    # 然后根据偏移量决定基准数据列表的覆盖元素
    for al in alternate_price:
        position = int(al.get("position"))
        value = al.get("value")
        # 判断位置的数值是否为正数
        plus = True if position >= 0 else False
        # 计算下标,以16px为基准
        index = int(position / 16)
        # 替换第一对b标签里面的值,也就是完成值覆盖操作
        base_price[index] = value
    print(base_price)
    # 输出结果中第一组正常,第二组不同,因为第二个基准数据值有4个值
    # 覆盖操作是根据偏移量计算得出的下标进行的,实际上就是列表元素的替换,当基准值的元素数量
    # 超过实际的宽度时就进行切片,有时候网页显示错误也是正常的情况
# print(em)
# 总结:
#   首先需要几个基准值,就是单个字符偏移的值,是一个常数的倍数
#   拿到每个数据的偏移量,与基准值做商
#   以商为列表索引,替换列表里面的数据

数字 IC 笔试面试必考点(2)FPGA 开发流程 FPGA 的详细开发流程就是利用 EDA 开发工具对 FPGA 芯片进行开发的过程,所以 FPGA 芯片开发流程讲的并不是芯片的制造流程,区分于 IC 设计制造流程哟(芯片制造流程多麻烦,要好几十亿的费用呢,而且国内也貌似没有哪家像样的 Foundry 厂,除了台湾的 TSMC 在世界有立足之地,Fabless 的 IC 设计公司倒是挺强的如 Hisilicon,这也是它为什么会被 USA 针对的原因)。 阅读详情

相关推荐

雷达原理习题答案【西电】

  目前教材用的是陈老师新版的,但是,我发现课后题有一部分是之前某本书里的。答案如下【建议参看原题→查阅答案】 【原题点这里!!点这里!!】 目录跳转功能目前好像只支持网页版 文章目录% 第一章、第二章% 第三章% 第四章% 第五章% 第六章% 第七章% 第八章 % 第一章、第二章 % 第三章 % 第四章 % 第五章 % 第六章 % 第七章 % 第八章 ...

薛定谔的壳的博客 1万+

python无效语法封号_无效语法-python

我有一组参数,它们的目的都是'search_and'、'search_not'、'search_start'、'search_then'和'filename'我必须捕获错误的代码是if ( options.filename is None) and ( (options.search_and is None) or (options.search_not is None) or (options...

weixin_39684995的博客 330

跟着团子学SAP PS:项目计划成本与项目预算设计思路

​在做SAP PS模块概览培训的时候,很多时候都会用到下面的一页PPT片子讲到项目计划成本与预算的关系,但真正这幅片子想表达的具体内容甚至大部分PS顾问也是无法阐明清楚的。 而SAP PS的设计其实是在丰富的项目管理学的基础上而开展的,所以今天从业务上结合SAP中的功能点讲一下项目成本计划及预算的逻辑。 在项目管理的十大知识领域中,项目成本管理主要是包括为使项目在批准的预算内完成而对成本进行规划...

Lucas1211的博客 3万+

“由于一段 Python 代码,我的号被封了”

你是否有对重要内容进行备份的习惯?

优快云资讯 1万+

《解锁GCC版本选择的奥秘:从入门到精通》

GCC 版本的选择是一项复杂而关键的决策,犹如一场精心策划的战略布局,贯穿于软件开发的整个生命周期。从项目需求与兼容性的深度考量,到性能与稳定性的权衡抉择,再到硬件与系统适配的精准对接,每一个环节都紧密相连,相互影响。在游戏开发行业,对性能的极致追求促使开发者青睐较新的 GCC 版本,以实现更流畅的游戏体验和更震撼的视觉效果;科学计算领域则依赖于 GCC 版本对复杂数学运算的高效优化,以应对大规模数据处理的挑战;嵌入式开发行业因硬件资源的限制和对稳定性的严苛要求,通常选择经过长期验证的稳定版本;

zheng_ruiguo的专栏 1415

手把手教你用微信小程序实现智能硬件音视频通话(含Linux/RTOS适配)

本文详细介绍了如何利用微信小程序硬件框架(WMPF)和音视频SDK,在智能硬件(包括Linux与RTOS设备)上实现音视频通话功能。文章从架构设计、设备端SDK集成、小程序VOIP插件开发到跨平台调试与性能优化,提供了全链路实战指南,帮助开发者打通微信小程序与嵌入式设备间的实时音视频通信。

ooo22的博客 328

python爬虫进阶-每日一学(CSS反爬-偏移+混淆)

目的 了解更多的css反爬策略 详细需求 url:http://glidedsky.com/level/web/crawler-css-puzzle-1 思路分析 一、审查 二、分析 以上三种情况可以自由结合: 1.css混淆+css偏移 2.css混淆+before处理 等等 三、具体逻辑 有点懒,见源码 四、汇总 1.请求源网页 2.正则获取col-md-1每组数据 3.获取每组数据下的所有cls为列表 4.cls列表值判定处理,根据判定结果进入CSS处理逻辑或者before处理逻辑 5

jia666666的博客 975

手机端实时检测:YOLOv8n轻量化改进,骁龙865上35FPS,mAP+3.2%

YOLOv8n-Lite的改进不是简单的“砍通道、降分辨率”,而是结合手机端硬件特性(NPU加速、内存限制)和场景需求(小目标检测),通过“卷积拆分减少计算、通道瘦身适配内存、特征强化保留精度”的协同策略,在骁龙865上实现35FPS实时性与mAP+3.2%的双赢。该方案已在手机端AR应用中落地,支持实时手势识别、物体测量等功能,功耗比原始模型降低40%(连续检测1小时仅耗电12%)。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 723

Python爬虫反反爬:CSS反爬加密彻底破解

点击“简说Python”,选择“星标公众号”福利干货,第一时间送达!@老表家的猫本文授权转载自数据EDTA禁止二次转载大家好,我是老表阅读文本大概需要 10分钟今天,爬...

简说Python的博客 1097

VTK实战完整教程介绍

该专栏以VTK提供的Example为基础,讲解VTK中的相关接口和使用方法。订阅该专栏,带你了解所有VTK的功能,以便VTK更好的解决工作中遇到的问题。一起学习起来吧!

qq_40041064的博客 2502

电机驱动和电源等大电流设计中的并联 MOSFET设计

在电机驱动等应用中,半桥拓扑(通常为 3 相)用于生成在电机中产生正扭矩或负扭矩的交流电源信号。想要更高的输出电流能力,只有通过并联形成每个功能开关的 MOSFET,才能实现高输出电流。当多个功率 MOSFET 并联以增加系统整体电流能力容量时,通常假设电流在并联器件之间均等分配或均等共享。然而,在并联 MOSFET 时,需要考虑并联器件之间的电流分配。PCB 布局的若干特性和特定的MOSFET 参数会影响这种分配,并在参数不匹配或布局不对称时导致均流不平衡。

小幽余生不加糖 2484

Python--简单 Js 破解。

本篇是针对 国家会展中心的访问量,以及百度企业信用网站的简单小破解,博客仅作为学习,不支持商用。谢谢配合。 1. 开胃菜 会展中心访问量 目标网址:http://www.eshow365.com/zhanhui/html/127989_0.html 需要解决问题: 实际我们在请求的时候,这个访问量并不在源码中,可看源码如下图: 可以看到其中<span id="txtClicks" st...

后青春诗ing 5455

【大模型】SpringBoot整合LangChain4j实现RAG检索实战详解

SpringBoot整合LangChain4j实现RAG检索实战详解

congge 1万+

Python爬虫如何解密css

(6)在这几个 woff 文件里所有的文字数据都一样,顺序也一样。但是每个文字对应的unicode 码在不同文件里可能不一样。这样我们在生成字典的时候,就要注意,可能 2 个 key 对应值是一样的。例如:{”ee0b”:”园”,” f3e9” :”园”},如果有重复的键那么用第一次出现的,这个地方需要根据具体情况具体分析。(4)此处我们需要用到 fontcreator 软件(备注:在普通的网站开发中我们可以直接用百度。(8)我们通过分析以上文件。(3)从以上两个图可以看出,此处使用了字体加密。

a1309525802的博客 4136

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

Python3.X 爬虫实战(动态页面爬取解析)

【工匠若水 http://blog.youkuaiyun.com/yanbober 未经允许严禁转载,请尊重作者劳动成果。私信联系我】1 背景不知不觉关于 Python 3.X 爬虫系列已经介绍了如下系列:《正则表达式基础》 《Python3.X 爬虫实战(先爬起来嗨)》 《Python3.X 爬虫实战(静态下载器与解析器)》 《Python3.X 爬虫实战(并发爬取)》 《Python3.X 爬虫实战

工匠若水 8万+

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

python-css反爬之偏移加伪元素(三)

目标网站:http://glidedsky.com/level/crawler-css-puzzle-1 在此感谢https://blog.youkuaiyun.com/weixin_40576010/article/details/89885515,学习了,具体解析可去查看 from parsel import Selector import requests import re def spid...

qq_42748190的博客 549

python-css偏移反爬(一)

目标网站:http://www.porters.vip/confusion/flight.html# 采用三种方法。 css法详解可到崔佬的https://cuiqingcai.com/8678.html查看,在此以表感谢。,学习了。 import requests import re from parsel import Selector # css法 def spider(): ...

qq_42748190的博客 471

Python爬虫反反爬:CSS反爬加密彻底破解!

0 惯性嘚瑟 刚开始搞爬虫的时候听到有人说爬虫是一场攻坚战,听的时候也没感觉到特别,但是经过了一段时间的练习之后,深以为然,每个网站不一样,每次爬取都是重新开始,所以,爬之前谁都不敢说会有什么结果。 前两天,应几个小朋友的邀请,动心思玩了一下大众点评的数据爬虫,早就听说大众点评的反爬方式不一般,貌似是难倒了一片英雄好汉,当然也成就了网上的一众文章,专门讲解如何爬取大众点评的数据...

PythonJavaPHP的博客 952

《封号码罗》python爬虫之企某科技网站js逆向(十四)

首先查看ajax加载,可以发现,其所有的数据都是加密方式到前端页面,由前端页面js解密之后再渲染到网页中 根据其关键字 encrypt_data进行全局搜索,寻找js的解密代码 这个地方就是解密代码,但是这里仅仅是调用,所以要进到代码里面去查看 看到这里已经发现t已经是ajax请求过来的数据了,然后是json被返回,所以重点分析这个区域的代码,可以看到,只有a.a.decode(t)调用了t,所以这个地方需要生成两个函数,一个是s,另一个是其包含的这个函数,其他都是固定的字符串,扣下来js直接调用就行

Python_DJ的博客 2万+

关于javaScript逆向hook里面的cookie以及其他常用hook汇总

个人理解:hook某个元素,实际上就是定位某个元素,例如cookie里面有个abc为名字,123为值,我们要查找设置cookie={abc:123}的位置,首先就要知道,cookie的设置是set方法,再例如发送一个ajax请求,就需要明确的知道,发送ajax需要有一个XMLHttpRequest对象,这个对象会用到open方法,在open方法中使用了url,要hook到url,实际上就是对open方法的重写,同理,hook到cookie时,也是对设置cookie的set方法进行重写...

Python_DJ的博客 8209

记忆碎片之python爬虫scrapy框架settings.py参数

# -*- coding: utf-8 -*- # Scrapy settings for morekeywords project # # For simplicity, this file contains only settings considered important or # commonly used. You can find more settings consulting ...

Python_DJ的博客 4730

python爬虫80行代码拿下喜马拉雅有声书

声明:本文仅作为学习爱好者编写,请勿商业和恶意攻击源网站,本文所有解释权归作者 本文没有使用爬虫框架,仅用了三个Python的常用库 本文适合新手参考,文章里面有大量注释为理解提供便利 # 爬网易云音乐 import requests from lxml import etree import os headers = { "User-Agent": "Mozilla/5.0 (Windo...

Python_DJ的博客 4305

关于某壳找房webpack+RSA的js逆向

第一步:切换登陆方式 第二步:查看抓包情况 第三步:模拟登陆后抓包 查看发包参数,本次主要处理password这个参数 l是对字符串处理的方法 可以看出先对原密码进行了加密,然后用l方法对密码又进行了处理 将代码添加到浏览器的Overrides,方便改写调试 第四步:改写js并进行分析 定义一个全局变量,把加载器赋值到全局变量,查看该变量 控制台打印输出,可以看出导出了59个方法 加密位置 所有代码: js太多,放图片代替 最后一步:模拟请求......

Python_DJ的博客 2620

关于python爬虫逆向RPC的基础使用

rpc使用在爬虫中的使用方式

Python_DJ的博客 1672

记忆碎片之python爬虫APP数据爬取(一)

# app数据 # 简单 # 比web端更容易,反爬虫不太强,大部分是http/https协议,大多返回json # 困难 # 01 可能需要适当的反编译,分析出加密算法并抓取到信息 # 02 可能加固,需要脱壳,然后反编译,分析出加密算法并抓取到信息 # 03 需要破解通过各式各样的签名,整数,设备绑定等方法,找到隐藏加密算法 # 技术要求 # python爬虫开发经验 app逆向 java开...

Python_DJ的博客 1670

记忆碎片之python爬虫APP数据爬取fiddler抓包及多线程爬取流程分析(四)

无敌免责声明:本案例用到的app仅仅做为学习使用,切勿使用爬虫程序恶意攻击该服务器。 有了前面三节内容的铺垫,相信对抓包和模拟器配置都有了一些了解,这里实现一个完整的案例,仅做为入门学习记录。 第一步:启动fiddler,并启用抓包 第二步:启动安卓模拟器,设置代理,并启动APP应用,明确抓取内容 接着向下翻页,滚动鼠标滚轮,之后回到顶部,点击第一个菜谱进入菜谱的详情页,回到fiddle...

Python_DJ的博客 1303
上一篇: 《封号码罗》python爬虫之10行代码破解网页动态反爬虫(二)
下一篇: 《封号码罗》python爬虫之70行代码破解CSS映射SVG反爬虫(四)
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值