


Part 4|架构复盘:一个内容产品的结构性失误
📌 本章要点
· 核心失误:拿着屠龙刀(优化能力)砍柴,却用木棍(创造能力)屠龙
· SFT陷阱:在注定演进的基座上雕花,新模型发布后投入归零
· 隐性救赎:用慢变量(Workflow/RAG)对抗快变量(Model),获得架构韧性
· 真正的护城河是承载真实世界复杂性的系统,而非模型有多聪明
为了更深入地理解这套理论,我复盘一个曾经操盘过的 AI 内容产品。这个产品旨在辅助创作者从 0 到 1 产出高质量文章。
站在今天的系统工程视角看,该产品早期的困境,并非单一的决策失误,而是典型的技术周期与产品愿景的错配。我们试图在基础设施尚未成熟时(2023年),去构建一个过于理想化的智能系统。
今天的复盘不包含战略层面的反思(当时选择的用户群、产品价值承诺也存在重大失误),本文重点讨论产品架构设计层面的部分。
🎞️ 第一幕:能力错配 —— 在错误的能力区间对赌
我们犯了一个早期产品常见的错误:无视模型物理特性,试图用短板攻克天险。
错误诊断:核心价值的误判
-
当时的模型具备两大类能力:
-
创造力(0 到 1): 弱。就像一根脆弱的木棍,容易断裂(幻觉、逻辑混乱)。
-
优化力(1 到 100): 强。就像一把锋利的屠龙刀,削铁如泥(改写、总结、润色)。
-
-
决策失误: 我们虽然开发了基于素材的「仿写/改写」功能,却将其视为边缘辅助;反而将极其依赖模型内功的「从0 到 1 自由创作」,定义为产品的核心主流程。
-
实质:这是一种典型的架构重心战略误判。我们拿着屠龙刀(1-100 的优化能力)去砍柴(做边缘功能),却试图用木棍(0-1 的创造能力)去屠龙(做核心主流程)。
-
后果: 我们强行要求模型承担它扛不住的创造压力,结果无论如何微调 Prompt,产出始终徘徊在60分上下不可用状态。而真正能打的优化能力,却被埋没在工具箱的角落。

图示:能力错配对比图
架构教训:产品架构的首要职责是扬长避短。如果模型本质上是一个金牌编辑(擅长润色),就不该在架构设计上强行逼它去当一个天才作家(负责原创)。
🎞️ 第二幕:SFT 的陷阱 —— 资产泡沫化
为了弥补创造力的不足,我们采取了当时行业最主流的技术路线:垂直领域微调 (SFT)。我们和大多数 AI 创业团队一样,希望能通过微调建立壁垒。
错误诊断:战术上的勤奋,掩盖了战略上的代差
-
雕花的艺术(形似): 我们收集了大量优质内容,试图通过 SFT 让模型学会高质量写作。在技术上,我们做到了形似,模型学会了 Emoji、三段式结构和网感文风。
-
基座的局限(神散): 但皮囊的精致掩盖不了灵魂的空洞。由于当时的底座模型本身逻辑推理能力不足,SFT 只是让它学会了用最潮流的语气说废话。这就是典型的在屎上雕花。
-
资产的泡沫(归零): 更致命的是,我们是在一个注定演进的基座上进行这些投入。当下一代更强的通用大模型发布时,我们辛苦积累的SFT 专用模型,其表现瞬间不如新基座的 Zero-shot 能力。这其实早有预兆,GPT-3.5 的出现就已然干倒一批基于 GPT-3 微调的 AI 应用公司。

图示:SFT资产泡沫化示意图
架构教训:永远不要试图用 SFT 去修补通用智能的缺陷,对于通用能力的不足,等待(Waiting)往往比微调(Tuning)更具性价比。
🎞️ 第三幕:隐性的救赎 —— 双轨制的防御性胜利
在激进的技术探索之外,出于产品经理的职业直觉,我们还保留了另一条务实的产品线。
当时的判断是:面对一个尚不稳定的概率性模型,普通用户无法靠对话框完成复杂的生产任务。为了兜底,我们坚持引入了厚重的 SaaS 业务流程。
没想到,正是这套用来防御的传统架构,最终成为了产品的救生艇。
1. 交互的防御:用 GUI 流程对抗不确定性
-
设计逻辑: 我们没有采用当时最酷炫的单一大框对话模式,而是构建了一套全流程的 GUI 交互(选题-RAG检索-生成-配图-分发)。
-
实质: 这是Workflow的显性化。我们用刚性的业务流程(SOP),去对冲了模型胡说八道的风险。当模型生成失控时,结构化的流程保证了用户体验没有崩盘。
2. 场景的防御:把「改写」作为基础配置
-
设计逻辑: 我们保留并打磨了基于选题素材/用户指定材料的仿写/改写功能,并引入 RAG(知识库)来管理用户素材。
-
实质: 事实证明,用户的高频痛点往往不是无中生有,而是借题发挥,这成为了对模型能力边界的有效补充。
深度解构:为什么防御反而成了核心?
现在回看,我们其实在过程中完成了一个关键转移:从模型能力产品到行业系统产品。
-
价值锚点的转移:用户的价值感知从生成质量过渡到到流程完整性。用户觉得:虽然它写得不够完美,但这个流程帮我理清了思路,而且管理素材很方便。这类价值,不会便因为模型升级而消失。
-
敏捷度的解耦:把模型短板变成了系统的一部分。模型只负责某一步的生成,而非全部承担最终的质量责任,这也大幅降低了产品对模型版本的敏感度。
-
用慢变量对抗快变量:
-
模型时间尺度: 3~6 个月(极速迭代,易被颠覆)。
-
行业时间尺度: 3~5 年(相对稳定,SOP 不变)。
-
我们构建的这套 Workflow,本质上是用一个慢变量(行业系统),去对抗一个快变量(模型迭代)。
-

图示:慢变量对抗
总结:架构的韧性
这次复盘也呈现了我们在那个混沌时期双重下注的结果:
-
进攻端(SFT): 我们紧跟当时的技术潮流,试图冲击创造力的上限,但遗憾地遭遇了基座模型代差的降维打击。
-
防守端(Workflow): 我们坚守了产品的可用性底线,通过流程和知识库,稳住了用户的基本盘。
我并没有陪这个产品走到最后。但在我离开后,它维持着这种分裂但平衡的状态,并依然运营至今。
这也揭示了 AI 产品真正的护城河:
不纯粹依赖模型有多聪明,而是产品承载了多少真实世界的复杂性。正是因为我们把业务逻辑从模型中解耦出来,固化在 Workflow、RAG 中,这个产品才没有随着早期模型策略的失误而崩塌,而是获得了一个边跑边修的机会。
Part 5|重构蓝图:如果今天重来,我会怎么做
📌 本章要点
定位升级:放弃全自动幻想,从内容创造者转型为内容放大器,以对抗平庸、责任与同质化三大陷阱。
架构哲学:构建最小完备业务内核(Model + RAG + 官方 Skill + Workflow),确保可靠闭环。
交互克制:拒绝全自动黑箱,建立Agent处理模糊意图 + Workflow 锁死执行边界的人机共驾模式。
生态壁垒:通过 MCP 与自定义 Skill 开放接口,让用户沉淀的资产成为对抗模型快速迭代的终极护城河。
如果今天让我重新面对当年那个产品命题:辅助创作者产出高质量内容,我会怎么做?
虽已离开原团队近两年,不再有实际操盘的机会。
但也正是这段距离,让我能更冷静地审视:在技术红利与惨烈竞争并存的当下,一个真正有壁垒的内容智能产品,应该长成什么样子?
简单的套壳生成已无路可走。但也正是在这种压力下,我当年未能实现的个人工作台愿景,可能反而有了最坚实的落地土壤。
其核心架构:Agen + 工具集(Skill/Workflow)+ 知识库(RAG),早在2023年中就已成型(见下图),从运营工作台延伸至千行百业的个人工作台。它用刚性流程对抗模型不确定性,用开放生态沉淀用户资产。
虽然当时受限于模型能力不够强而未能完全落地,但这些早期的架构思考,为今天的架构推演提供了最坚实的起点。

图示1:运营工作台架构图

图示2:个人工作台架构图
立足当下,我不会再追求「更好的生成器」,而是利用当下技术红利,把它重构成一个:懂业务的智能参谋。
以下设计构思不涉及具体的业务,仅是一份基于血泪教训的架构推演。
我想,真正的实践,不仅是动手建造,更是把经验变成他人的路标。
推演开始👇
1. 定位重构:从创造者转向放大器 (Product Redefinition)
核心反思:模型越强,我们越要警惕全自动的诱惑。
这是此次重构的灵魂。即使在模型能力极强的今天,我依然坚定地认为:产品必须定位为内容放大器,而非内容创造者。
新形态定义:
-
Input: 用户的火种(一段录音、一篇喜欢的内容、一份草稿)。
-
Output: AI 的燎原(全平台的优质内容矩阵、多文体分发、风格化润色)。
这会是一个痛苦但很有必要的市场筛选。
如果做创造者,取悦想要一键生成、无上下文需求的低投入用户,就要面临大厂免费工具的降维打击和用户的极低忠诚度。
如果做放大器,服务的就是有较高投入时间、有一定的上下文和工作流资产的高锁定性用户。只有在这个领域,产品的壁垒才成立。
这意味着,产品需要对抗三个致命的陷阱:
🪤 陷阱一:平庸陷阱 —— AI生成的都是废话?
核心逻辑:AI 无法创造金子,但它可以帮你找到金子、打磨金子并量产金子。
如果定位为创造者(直接0到1),AI 只能产出平庸的废话。而作为放大器,就可以利用当下的技术红利,实现3个放大:

图示:三个放大器的工作原理
-
决策放大(提升胜率)—— 帮你找对
-
痛点: 很多时候,内容平庸不是因为写得差,而是因为选题本身就平庸。用户的灵感往往是随机的,不知道哪个选题能火。
-
解法: 利用 RAG + 数据分析 充当情报雷达,分析全网爆款,在杂乱信息中放大最有价值的选题信号。
-
-
纵向放大(提升品质)—— 帮你写好
-
痛点: 很多专家拥有 100 分的洞察,但只有 60 分的表达(逻辑跳跃、口语化)。
-
旧瓶颈(2023): 早期的模型往往会产生磨皮效应,在润色时把犀利的观点稀释成平庸的片汤话。
-
新红利(Now): 现在的模型已经具备了高保真的重构能力。它能在完全保留你 100 分洞察(棱角、情绪、黑话)的前提下,完美地把口语草稿清洗、结构化为 80 分的专业表达。
-
-
横向放大(提升声量)—— 帮你传开
-
痛点: 好内容不应是孤品。一篇深度长文(1个80分),应该能转化为小红书笔记、推特金句、短视频脚本(N个80分)。
-
旧瓶颈(2023): 早期的改写是机械切割。它只会机械地缩短字数、堆砌 Emoji,产出的内容充满AI 味,缺乏真正的平台原生感(Native Feel)。
-
新红利(Now): 利用 Skill 引入不同平台的流量密码(如小红书的情绪钩子),实现一次生产,全域爆火。
-
🪤 陷阱二:责任陷阱 —— 出错了算谁的?
核心逻辑:重新划分执行与决策的边界,重新分配不确定性。
- 痛点与悖论: 这是一个关于价值与责任的跷跷板,单纯替用户写(创造者),一旦出错就是产品的锅。单纯让用户自己写(工具),产品又显得价值单薄。

图示:责任分配的新契约
-
解法: 将产品定位为放大器,建立一种新型的人机契约:
-
产品承担 100% 的执行责任: 保证文笔流畅、格式精准、分发高效。
-
产品分担 50% 的决策压力: 不替用户拍板,但提供数据支撑(如:基于历史数据,这个标题的点击率预测比那个高 20%)。
-
归还 100% 的最终决策权: 最终选哪个,依然由用户按下确认键。
-
-
价值控制: 产品不再是一个不可控的枪手,而是一套自带战术雷达的外骨骼机甲。雷达提供情报,机甲提供动力,但扣动扳机的,永远是人类指挥官。
🪤 陷阱三:同质化陷阱 —— 凭什么用户付费?
核心逻辑:构造产品的关键壁垒
-
逻辑: 如果产品只是用来生成内容,竞争对手将是各种免费的大模型底座。它们模型迭代更快,产品将没有任何胜算。
-
解法: 用户付费买单的理由,可以是买那套确定性的 SOP,而不是买那个人人都有的生成能力。产品本身,不试图创造正确性,而是收敛不确定性、放大有效信号、并对结果进行校验与兜底。
2. 架构重构:构建最小完备内核 (The Core Kernel)
核心洞察:架构设计的首要原则是关注点分离。为了支撑放大器定位,我们需要先把内核做实,再把生态做开。
在 Part 2 中,我们解剖了智能系统的六大理论组件。但在重构的起步阶段,我们需要区分系统内核与外部连接。
我将 Agent 定义为交互模式,将 MCP 定义为外部协议(这两者将在后文详述)。剥离掉它们后,剩下的四个实体层,构成了直接承载业务逻辑的最小完备内核。 这是一个官方预置的、保证产品能跑通放大器闭环的刚性骨架。

图示:最小完备内核架构
第一层:核心动力层 (Model) —— 极简的无状态底座
-
重构思路:彻底剥离模型层的记忆和业务属性,将其视为纯粹的文本推理引擎。在代码层面,它仅仅是一个标准化的 API 调用接口。
-
预期价值: 这种热拔插设计意味着:当更高级的模型发布时,只需修改一行 API 配置,整个产品就能原地升级,而无需重训任何数据,也不会丢失任何用户资产。
第二层:知识与事实层 (RAG) —— 高频更新的私有素材库
-
重构思路: 构建一个秒级更新的向量数据库,专门存储用户的过往爆文、收藏素材、品牌/内容调性文档、个性化知识素材等。
-
预期价值:这解决了灵感时差问题。用户上一秒在浏览器插件里保存的素材,下一秒就能在写作中被精准引用。
第三层:能力执行层 (Skill) —— 经验的原子化封装
-
重构思路: 将虚无缥缈的内容创作心法,翻译成确定性的能力,强制模型在特定环节调用。注意,本层级仅讨论系统自带的能力(如官方提供的风格保真器),用户自定义的扩展能力将在生态层详述。
-
典型场景:
-
风格保真器: 基于 RAG 读取用户历史语料库,提取个人化特征(高频词汇、情绪浓度等),在润色时强制模型保持这些特征,确保输出像你的内容。
-
平台适配器: 将不同平台的流量密码封装成规则(小红书的 Emoji 密度与分段节奏等),将一篇长文重构为符合各平台原生语言的多个版本。
-
-
预期价值: 让输出结果从看运气变成了保下限,同时建立了通用模型无法复制的个性化壁垒。
第四层:流程与调度层 (Workflow) —— 锁死的生产流水线
-
重构思路: 将金牌写手的方法论(选题策划 -> 内容借鉴 -> 骨架生成 -> 填充润色 -> 多渠道分发),固化为不可跳跃的 DAG(有向无环图)。
-
预期价值: 它负责按住模型的手,保障生产流程,进一步提升效果下限。
3. 交互重构:Agent 的极度克制 (Restrained Agency)
既然有了灵魂(定位)和内核(架构),接下来我们要解决的是:这个前额叶如何与作为指挥官的人进行交互?
在2023年的规划中,我曾激进地设想过全自动 Agent:用户给一个目标,大模型自动生成规划并执行。但受限于当时的技术可行性(指令遵循差),我们做了一个极端的决定:彻底摒弃 Chat 对话框,回退到纯 GUI 的 Workflow。
站在今天,技术红利已允许重启 Agent,但我依然坚持极度克制。在工作台模式下,Agent 不应该试图成为替代你的CEO,而是听你调遣的实习生。
我们需要构建一种 LUI(自然语言)+ GUI(图形界面)的混合交互模式:
-
守正(收敛):
-
场景: 确定的生产环节(如排版、审查、分发)。
-
策略: 坚持用 Workflow + Skill。哪怕 Agent 现在能做,也不让它自由发挥。
-
价值: 必须保证SOP 的刚性。这些环节需要的是 100% 的精确和可控,而非AI的惊喜。
-
-
出奇(发散):
-
场景: 任务目标模糊的环节(如“不知道写什么选题”、“帮我规划下周内容”)。
-
策略: 重新引入 Chat 界面,允许用户输入模糊意图,利用 Agent 的推理能力进行意图对齐。
-
价值: 处理模糊性(Ambiguity)。这恰恰是 Workflow 的短板,却是 Agent 的天赋。
-
-
交互重构:从填空题到选择题
-
旧模式(2023): 用户必须在 GUI 上填完所有复杂的参数表单(痛苦的填空题),系统按部就班执行。
-
新模式(Now) —— 提案决策流:
-
用户给模糊目标(Chat): 下周要推新品,帮我规划 3 个选题。
-
Agent 给具体提案(Proposal): AI 调用 RAG 和 Skill,生成 3 个方案卡片。
-
用户做决策(Decision):用户点击其中一个方案。
-
系统跑流程(Workflow):确认后,系统界面重心切换至流水线开始生产。 同时,保留侧边栏入口,允许随时唤起Agent进行局部调整。
-

图示:Chat + GUI 混合交互流程图
4. 生态重构:从工具到平台
真正的壁垒,不是你预置了多少内核能力,而是用户能通过接口长出多少私有资产。
前文所述的四层架构(Model/RAG/Skill/Workflow)构成了产品的业务内核,但这只是一个更好用的工具。
如果只停留在内核层,依然会陷入同质化陷阱。竞争对手可以抄袭你的 Skill 库,可以复制你的 Workflow 模板。
为了建立壁垒,还需要把内核打开,通过开放性接口,让工具进化为平台。我们将重点重构两个关键接口,让用户资产沉淀进来:
第一层:连接接口——以MCP为代表的基础设施
MCP(Model Context Protocol)不仅是模型的能力扩展协议,更是产品打破孤岛、连接外部世界的关键接口。
MCP与 Function Calling 的区别: MCP 旨在成为跨模型、跨厂商的通用协议,而当前主流的 Function Calling(如 OpenAI)仍是特定平台的私有接口。采用 MCP 有助于降低未来被单一厂商锁定的风险。
-
官方预置:常见工具的 MCP 连接器(如 Notion、飞书文档、WordPress、数据分析工具)
-
用户自接:提供 MCP 配置界面,让技术用户接入自己的私有工具
-
社区生态:建立 MCP 连接器市场,用户可以分享/购买连接器
价值: 让产品从内容生产的孤岛,变成用户整个工作流的中枢节点。用户连接的工具越多,迁移成本越高。
第二层:定义接口 —— Skill 的用户级封装
如果说内核层里的Skill 是官方教给系统的能力(保下限),那么这一层级的 Skill 则是用户教给系统的能力(拓上限)。
-
低代码模式: 提供可视化的 Skill 编辑器。
- 例如:我的智能引流。扫描全文核心知识点,在我的私有产品库(如付费课程、电子书)中进行 RAG 检索,若匹配度 > 80%则在文章末尾自动生成一段痛点+解决方案的转折文案并插入对应的商品购买卡片。
-
代码模式(面向高级用户):提供沙箱环境下的 Skill SDK,允许用户用 Python/JavaScript 编写自定义函数。
- 例如:我的选题雷达。一个科技博主写了个 Skill,每天自动抓取他关注的 20 个特定 RSS 源 + 他的飞书收藏夹,用他自己训练的关键词权重模型(打分排序,每周一早上 9 点推送 Top 5 选题到他的工作台。
-
价值: 让产品从固定能力变成可自定义平台。用户封装的 Skill 越多,产品对他的价值就越大。
战略意义:从 SaaS 到 PaaS
这种开放性设计,本质上是一次商业模式的跃迁:
-
慢变量资产沉淀:用户积累的 Skill 库和 MCP 连接,成为时间尺度为 3-5 年的慢变量资产。这是对抗模型快速迭代(3-6 个月)的终极武器。
-
对抗同质化:当所有 AI 写作工具都在拼谁的模型更好时,你在拼谁的生态更开放。模型可以被超越,但用户的资产沉淀无法被快速迁移。
-
用户锁定效应:用户在你的平台上封装的 Skill 越多,连接的工具越多,他们就越离不开你。这是比纯订阅付费更深的护城河。
尾声:义肢时代的思考
在结束这篇架构复盘之前,我必须向自己,也向所有阅读此文的从业者提出最后一个问题:
我们费尽心力搭建的这套精密系统(Model + RAG + Skill + Workflow),是 AI 的终局形态吗?
我的判断是:不是。这只是一个中间态。我们当前正处于一个义肢时代。
必须承认,我们今天之所以要外挂 RAG、封装 Skill、硬编码 Workflow,本质上是因为核心模型还不够强。
我们是在给一个尚有缺陷的婴儿神,搭建一套复杂的学步车和矫正器。真正的工程智慧,始于承认局限。
未来的趋势一定是能力的内化。 随着模型参数的扩张和推理能力的进化,那些原本属于系统层的能力,终将被吃进模型层。
-
当 Context Window 无限大且便宜时,复杂的 RAG 检索机制可能会演变为精细化的上下文筛选器,而不仅仅是挂在数据库;
-
当模型具备原生计算机操作能力时,预定义的Skill可能会消失,变为模型动态生成的动作;
-
当 System 2 的逻辑推理达到专家水平时,死板的 Workflow 路径可能会软化,变为模型自主规划的思维链。
那么,我们今天构建这套架构的意义何在?一旦模型变强,这套系统会沦为废铁吗?
绝不会。 即便技术上的补丁属性会减弱,但这套架构在商业与管理上的价值将永存。随着模型越来越强,我们的架构重心将发生一个微妙而深刻的转移:
从为了能力增强转移到为了安全控制,从指导 AI 如何作业转移到定义 AI 的业务边界。
即便未来的大模型强到能自动规划一切,商业公司依然不敢让它裸奔。
因为商业世界需要的不仅仅是强大的智能,更是可解释、可审计、可控的智能。
-
可解释性 (Explainability):
-
黑箱模式(AGI): “因为我直觉认为这笔贷款风险大。”
—— 无法审计,合规挂科。
-
系统模式(Workflow): “因为我在 Step 3 查到他征信分低于 600。”
—— 逻辑透明,合规通过。
-
价值:Workflow 将永远存在,这是一套独立于模型智力之外的业务宪法。
-
-
数据主权 (Sovereignty):
-
你敢把公司的核心财务报表训练进通用的公有大模型里吗?
-
价值:RAG 层将永远存在,作为私有数据资产的物理隔离带。
-
-
算力成本 (Cost):
-
杀鸡焉用牛刀。1个写死的 Python 脚本(Workflow)运行一次是 0.0001 美元,耗时 10ms。让 o1 思考出来可能需要 0.1 美元,耗时 5s
-
以 OpenAI o1 为代表的推理模型虽然展现了惊人的复杂推理能力,但其高成本、低吞吐的物理特性,决定了它短期内无法替代确定性代码。对于高频、确定性的业务流程(如格式校验、数据转换、审批流转),Workflow目前依然是性价比最优解。
-
价值:Workflow 不仅仅是为了控制,更是为了降本增效。
-
这套架构确实是时代的产物,但它不会随时代消失。 这套架构在今天看来是拐杖(因为模型不够强,需要辅助)。在明天看来则是缰绳(因为模型太强,需要约束)。
只要人类还需要对结果负责,这套将不确定性关进笼子里的架构,就是我们手中最后的底牌。
除此之外,还有我1年半前的其他几个判断,文章链接大模型中的两个概念:Agent与记忆组件:
如今看来仍不过时:
-
从用户视角出发,用什么方式来解决问题,根本不重要。重要的是,能不能稳定的,持续的、较好的解决问题。
-
一个所谓长期有价值的事情,不意味着从始至终要用同一种手段,甚至是同一种技术,解决同一个问题。这个过程中,重要的是拿认知、拿反馈、拿迭代的方向。然后在技术成熟的时刻,切换为代价更小的方案。
-
技术快速迭代时期,充满了很多变数。需要做的:
1)确保自己正在解决真问题,或提供新价值;
2)紧跟技术演进方向,确保自己在问题上所花费的时间不会因为技术迭代而被快速的抹掉;
-
一张有趣的图,用于警示:警惕自己以为是路子2,实际是路子1,这也是我曾经犯过最大的错,后面有机会再继续唠。

最后,回顾从单体黑箱到精密机器的演进,我们其实一直在回答同一个问题:如何与一个概率性的智能共存?
-
不要试图把神(模型)降维成机器,去强求它绝对精准。
-
也不要试图把机器(流程)神话为智能,去指望它自动涌现智慧。
最优秀的 AI 架构,一定是中庸的。 它用 RAG 承载记忆,用 Skill 封装经验,用 Workflow 约束边界,最后把 Model 放在核心,让它作为引擎轰鸣运转。
从0到1!大模型(LLM)最全学习路线图,建议收藏!
想入门大模型(LLM)却不知道从哪开始? 我根据最新的技术栈和我自己的经历&理解,帮大家整理了一份LLM学习路线图,涵盖从理论基础到落地应用的全流程!拒绝焦虑,按图索骥~~
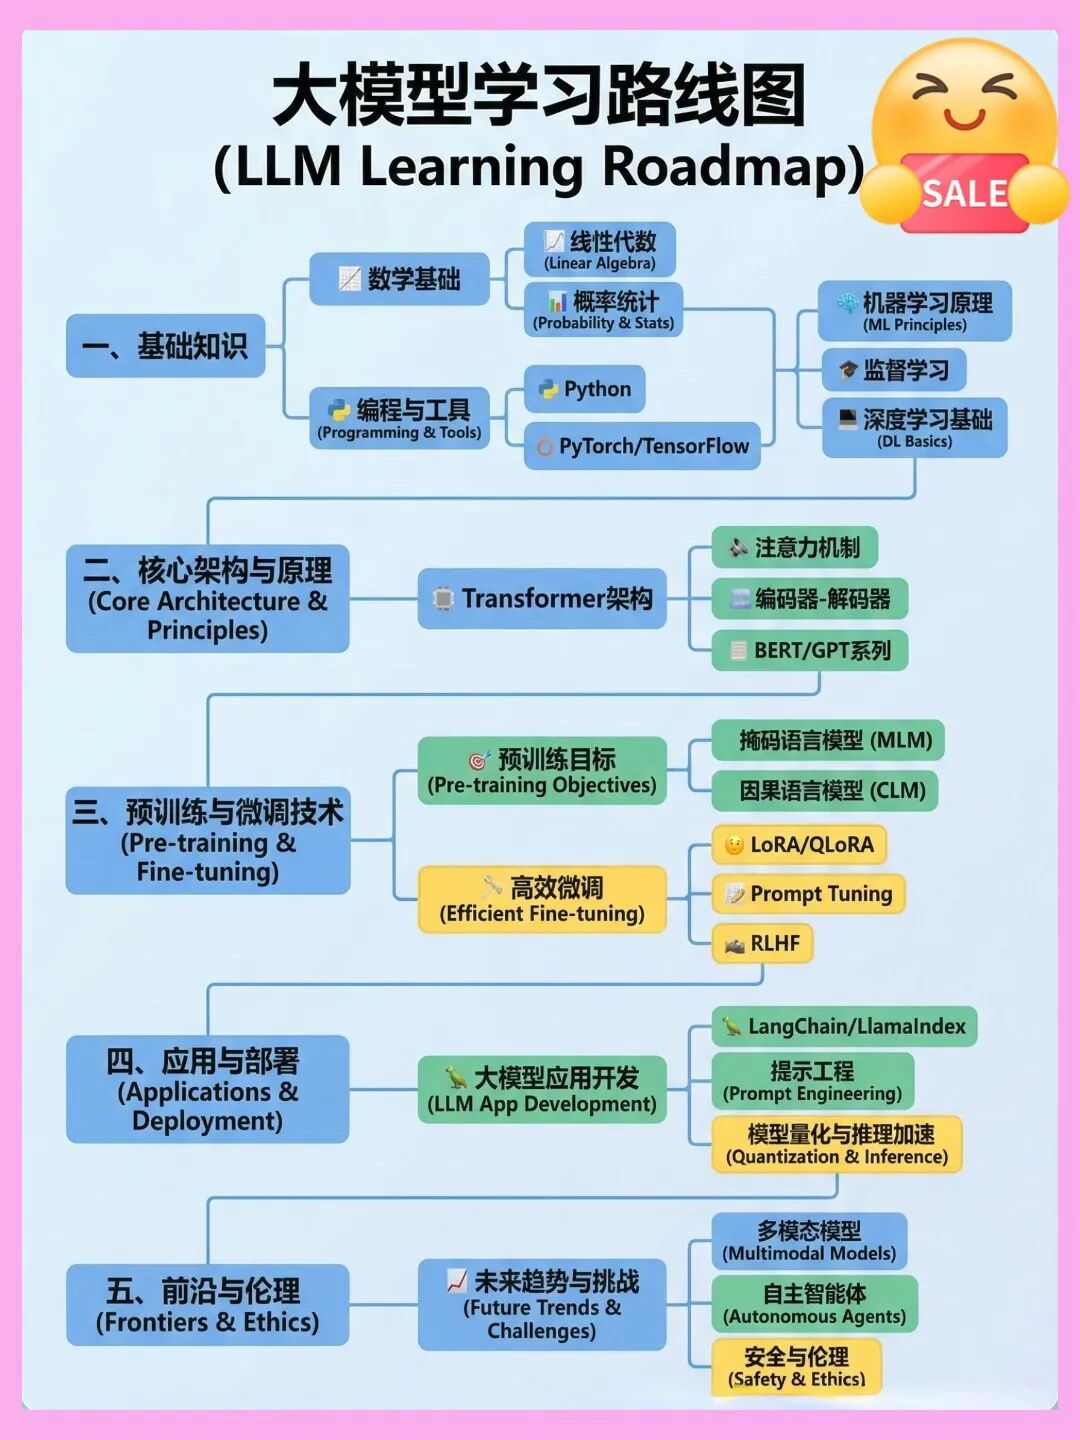
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取