推理性能PK,华为+DeepSeek>英伟达?

Python量化交易实战:从零搭建你的第一个多因子选股模型(附完整代码) 本文是一份详细的Python量化交易入门实战指南,手把手教你从零搭建第一个多因子选股模型。内容涵盖环境配置、数据获取、因子挖掘与有效性检验、多因子合成以及完整的策略回测与绩效评估,并附有可直接运行的完整代码,帮助初学者快速掌握量化交易的基本概念与实践流程。 阅读详情

“大模型江湖,落地为王。”这句话的含金量还在提升。随着DeepSeek V3/R1在春节期间一夜爆火,基于超大规模MoE(Mixture of Experts)架构的大模型正在从训练开发转向推理应用的落地。

对于MoE推理部署来说,效率一直是一个痛点。谁能将部署计算效率提升至最高,才能真正获得大模型商业成功。但受限于庞大的模型容量与计算需求,传统部署方案通常依赖于多张数据中心级GPU(如H20)。你我都知道,英伟达不仅贵,而且不断受到地缘政治摩擦的影响,不断降低自己的性能来满足监管需求。

而在最近,华为全面揭秘超大规模MoE模型推理部署技术,不仅实现了国产的进一步突破,更全面超越了基于英伟达Hopper架构的推理部署性能。

他们是怎么做到的?

数学补物理,极致提升计算效率

“数学补物理”,这种通过数学理论、工具、算法和建模等方式,来弥补硬件和工艺的局限性,实现最大化发挥芯片和系统能力效果。华为轮值董事长孟晚舟曾在2025年新年致辞中提到:

“华为十多个实验室与伙伴们的工程师组成“大杂烩”团队,面对天成AI集群系统和单芯片性能的严峻工程挑战,他们创造性应用数学补物理、非摩尔补摩尔、系统补单点等思想,在散热、供电、高速、高密及大芯片在板可靠性等工程领域突破极限。”

华为技术团队面向超大规模MoE模型的推理技术优化也是围绕着数学补物理这一思路,充分发挥等价数学变换,也就是在保持数学对象本质属性不变的前提下,通过数学变形、逻辑转换或结构重构等方式提升计算效率的方法,极致的提升了硬件集群的算力利用率,包括从点到面的推理框架侧优化技术,把数学最优实现变为物理最优的FlashComm通算优化技术,把串行计算变成四流并发的通算极致掩盖技术,以加法代乘法昇腾MLA最优实现,硬件感知亲和的大量创新算子等一系列核心技术孕育而生,并将通过一连串的技术报告首次全面披露这些宝贵的技术细节。

这次昇腾超大规模MoE模型推理部署技术的揭秘,除了通过技术报告分享昇腾在超大规模MoE模型的推理部署技术之外,在近一个月的时间内,这些核心技术的相关代码也都会陆续开源出来。在与业界分享技术思路的同时,也通过开源的方式共同打造长期持续的开放协作生态环境,让昇腾亲和的技术能力通过这些开源项目真正的活跃起来,这体现出华为坚定建设开放生态的决心,让所有愿意尝试使用昇腾能力的专家有信心长期投入,也让所有积极参与贡献的开发者有信心持续耕耘,一起努力让昇腾生态在中国茁壮成长。

超大MoE大模型推理的挑战

拥有6710亿参数,采用混合专家架构,在各种榜单表现出色的DeepSeek V3某种程度上代表了大模型发展的一个新趋势,即基于软硬件协同优化的模型架构,能够最大性能的发挥硬件平台的能力,在多种任务中表现出色,包括自然语言理解、代码生成和数学推理。我们暂且把DeepSeek V3为代表的大模型统称为超大MoE类模型。

尽管在性能上表现出色,并且有着大量开源的模型权重以及很多的包括DeepEP等在内的工具类项目,但对于想使用这类大模型的企业来说,能够高效部署完整版本的超大MoE类模型目前依旧面临多重挑战:

首先,硬件部署规模要求更高。现在我们在和大模型进行交互聊天的时候,无时无刻不在使用大模型的推理。而由于其自身的尺寸规模,这不再是此前小尺寸模型在单机多卡甚至单机单卡就可以运行能够相比的。硬件集群逐渐成为“满血版”超大MoE类模型的标配。

其次,模型规模庞大对推理效率提出了高要求。庞大的专家数量给硬件内存使用效率提出了很大挑战,每个专家权重约44MB,而共有58个MoE层14906个专家的超大MoE类模型,对于一般的AI硬件来说,需要合理的分布式并行和通信策略设计,才能将如此大量的专家有效的跑在硬件集群上。

再次,超大MoE类模型的诸多架构创新,也带来了很多实际部署上的困难。比如其多头隐式注意力机制(MLA - Multi Head Latent Attention),虽然可以通过将原有的注意力机制的键值对通过一个投影矩阵压缩到一个较小的隐式向量空间中,但这种创新也为算子优化带来了新的挑战,比如其带来了中间变量膨胀且向量计算占比显著增加,这样给硬件对计算的加速提出了新的要求

华为的解法

为了解决如上提到的实际部署中遇到的问题,从模型和算子两个方面入手,基于昇腾硬件和组网方式,团队提出了多个亲和的优化策略,开发出了一整套面向集群的大规模专家并行的解决方案。

昇腾服务器有多种配置和型号,团队针对:

• CloudMatrix 384 超节点

• Atlas 800I A2 推理服务器

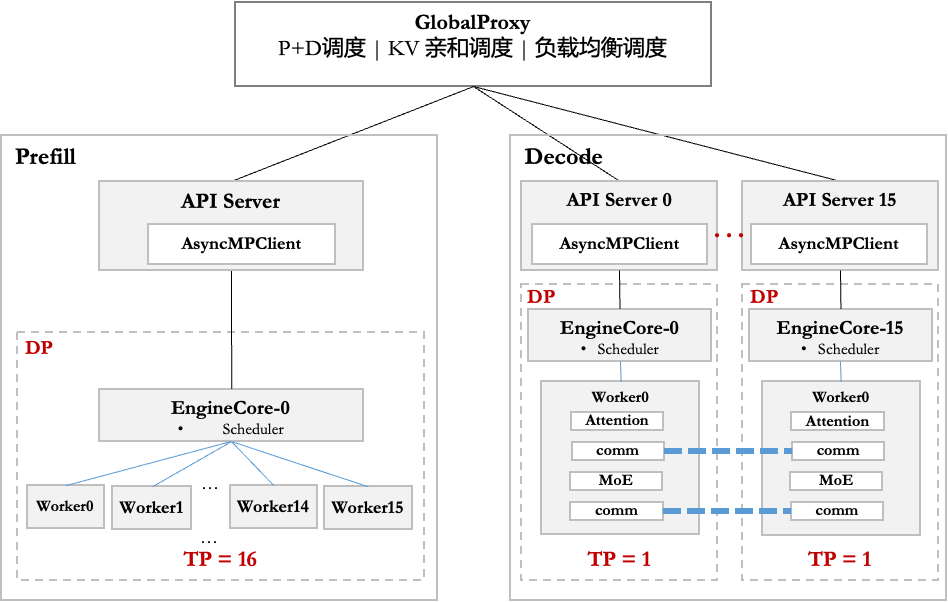
两种典型机型进行部署。为了解耦prefill 阶段的首token 时延约束和decode 阶段的解码时延约束,采用了PD 分离部署的方式。在框架侧,团队基于vLLM 框架,为了适配昇腾服务器,针对DP和EP 并行策略做了相应适配,在调度和KV 传输方面分别采用了Prefill调度分桶和灵衢互联与分层传输的技术来降低调度开销,在请求下发、调度策略、系统建链和框架前后处理方面做了性能优化,以实现整个系统的最优性能。模型方面,采用了A8W8C16 的量化策略,其中A8W8 采用INT8 的数据类型,C16 采用BF16 的数据类型进行量化。在具体部署方面,由于两种机型的定位和配置(尤其是网络配置)存在较大差异,所以具体部署方案也不尽相同。
图片

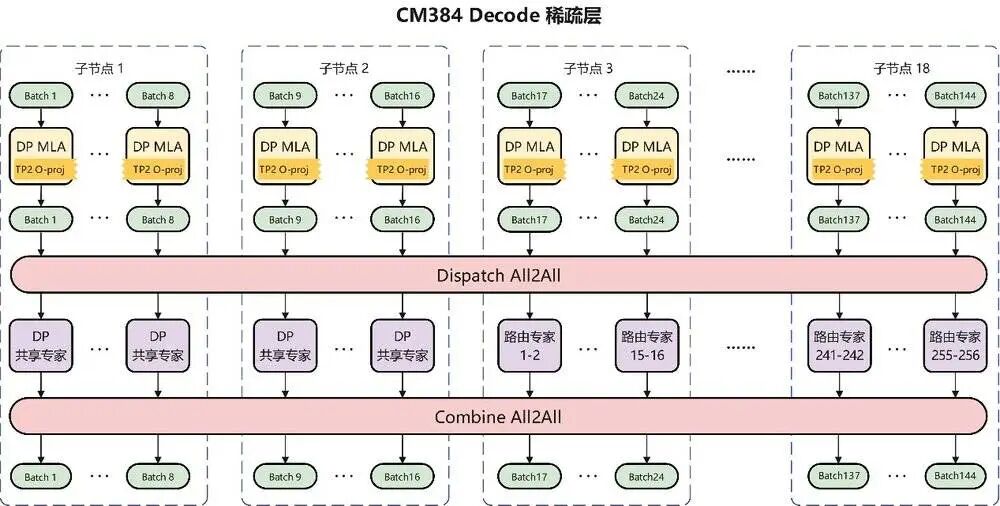
针对 CloudMatrix 384 超节点,其特殊的组网方式使其具有很高的通信带宽。按照 DeepSeek的论文所述,Decode 部分是严重的通信瓶颈,在 Micro-batch 技术的加持下,几乎可以做到通信掩盖其他所有计算类操作。而 CloudMatrix 384 的独特组网使得通信耗时大幅降低,可以有效释放昇腾芯片的算力。因此,针对超节点我们采用大规模 EP 并行的方式来部署:Prefill 使用 16 卡,Decode 使用 144 卡。其中 Decode 部分使用 128 卡通过大规模 EP 的方式部署路由专家,16 卡通过 DP 的方式部署共享专家,MLA 部分使用 DP 的方式进行部署。按照理论分析,超节点可以获得非常高的理论吞吐。实际场景下,由于各种因素的影响,包括 Decode 时延的约束使得各部分耗时未能达到理想的线性度,带宽抢占带来一部分性能劣化,框架的耗时和调度开销带来了额外的时延增加,MLA 部分的序列负载均衡和 MoE 部分的专家负载均衡带来进一步的性能恶化;最后多种因素综合在一起,华为团队实现在保证 50ms 时延下单卡 Decode 吞吐达到 1920 Tokens/s。
图片

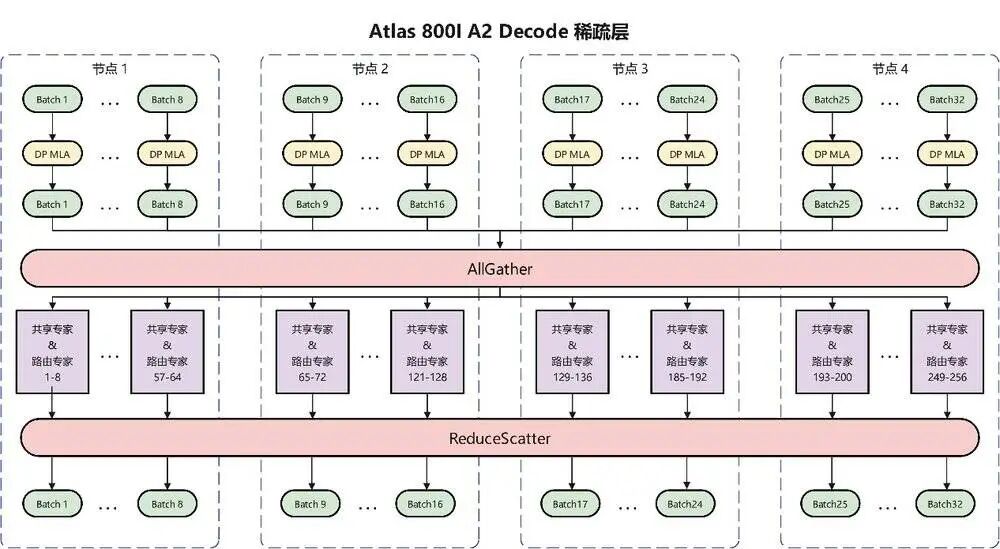
针对 Atlas 800I A2 服务器,由于每个节点包含 8 张昇腾芯片,我们需要采用多节点互联的方式来进行部署。综合考虑模型吞吐和部署灵活性,我们选定使用 2 节点 16 卡作为一个Prefill 实例,4 节点 32 卡作为一个 Decode 实例。为了部署时尽可能灵活,这里选用的卡数较少,这使得整个系统采用较小规模的 EP 并行策略:每张卡上部署 8(Decode)/16(Prefill)个路由专家和 1 个共享专家。在 Decode 阶段,MLA 部分采用 DP 并行策略,通信方式采用AllGather/ReduceScatter 方案。这种部署方式可以在卡数较少的情况下依然达到相当可观的吞吐。值得一提的是,在真实负载下, AllGather/ReduceScatter 通信方案比 Dispatch/Combine 通信方案具有更好的性能表现。综合上述优化方案,我们实现了在 100ms 时延下单卡吞吐达到 723∼808Tokens/s。
图片

推理框架侧优化技术

1. API Server 扩展技术

团队提出了API Server 扩展技术,通过支持API Server 水平扩容策略,可以有效提升框架请求处理能力,降低用户请求延迟,提高系统吞吐量(QPS)。结合包括组网方案优化和全并行、全异步前后处理,可进一步实现最佳TTFT,提升推理服务的可用性与处理效率

2. MoE模型负载均衡

团队提出了一种高效的负载均衡策略,通过动态负载均衡,热专家冗余部署,实时调度和动态监控等核心技术,显著提升MoE模型推理性能。

FusionSpec推理投机加速技术

在实际应用中,投机推理技术更多聚焦于小批量(batch)低时延场景,如何将其高效应用于高吞吐量场景并实现性能收益最大化,成为当前亟待攻克的技术难题。

投机推理在模型解码阶段的高计算密度,天然匹配昇腾高计算带宽比的特点。为了能够充分发挥昇腾算力大的优势,在低时延大并发场景下实现高吞吐,团队提出了投机推理引擎FusionSpec 深度优化MTP 在昇腾上的推理性能:

● 流程拼接:在推理流程上,将投机模型置于主体模型之后,直接使用主体模型的输出,并复用主体的控制参数,大幅减少了框架耗时,适配PD 分离的部署场景。

● 轻量步间准备:在投机场景中针对框架与算子优化,实现了轻量步间准备,适配多核并行全异步框架,降低端到端时延。

模型侧性能优化技术

1. 模型侧通信优化

FlashComm :主流张量并行(TP) 中使用AllReduce 进行通信的方案存在通信次数多,通信数据量大等问题,且AllReduce 之后的残差连接和归一化计算存在计算冗余,没有充分利用多卡并行能力。为此团队提出了FlashComm 网络通信方案:在 Prefill 阶段针对DeepSeek V3 网络 MLA 层前后的 AllReduce 通信,基于相同的集合通信逻辑将张量并行中的AllReduce 通信算子进行替换,并对通信算子在网络中位置进行编排,实现了低比特和低维度数据通信,从而有效降低了通信数据量和通信时延,并消除了网络中存在的冗余计算。FlashComm 技术应用于 DeepSeek V3 模型 Prefill 阶段,降低 25% 的通信量,提升 10%的推理性能。

● 层内并行转换技术:在FlashComm 的基础上,为进一步优化通信算子的时延,团队提出层内并行转换的优化方案:针对Prefill 阶段网络MLA 层的节点内通信重新设计了单层内使用的并行策略,灵活做到张量并行(TP)与数据并行(DP)的转化,消除节点内卡间求和的需求,且充分利用网络中低数据维度和量化特性实现节点间通信量的大幅降低,从而显著优化了通信时延。这一技术术应用于 DeepSeek V3/R1 模型 Prefill 阶段,降低 71%的节点内通信量,提升 10% 以上的推理性能。

2. 模型侧并发优化

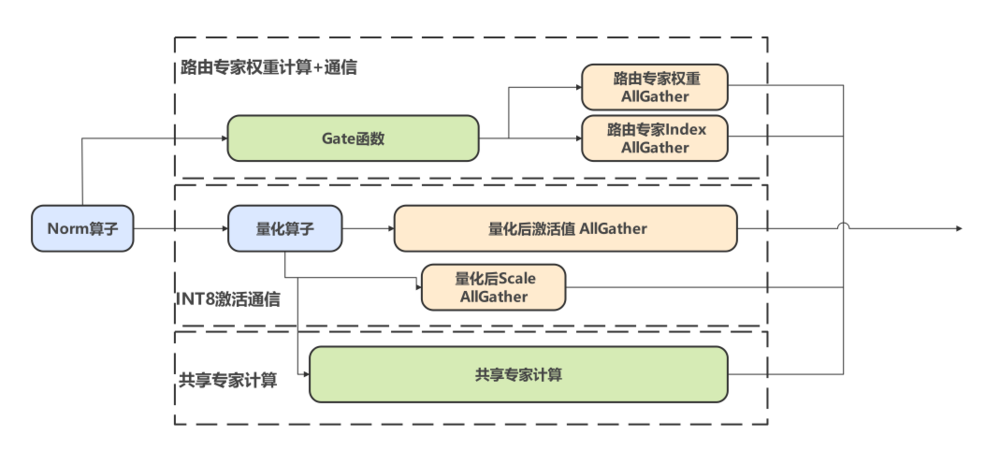
● 计算通信并发:昇腾芯片提供了计算和通信的并发机制。MoE 层的计算过程中需要使用AllGather 汇聚各张卡上的Token 的特征进行激活专家的筛选和计算。方案中,对于Gating函数使用先计算后通信的方法,对共享专家使用DP部署,从而保证了Gate 函数的计算和通信、共享专家的计算,以及特征汇聚的AllGather 函数之间没有依赖关系。团队利用昇腾的多流机制,将这三部分进行并发处理,从而最大化推理模型的性能。此技术在 DeepSeek V3模型的大并发场景下可以实现 Decode 性能提升 15%。

● 通信通信并发:昇腾芯片也提供了通信和通信并发的机制。当通信带宽利用率比较低的时候,可以把两个通信算子并发起来以掩盖通信算子的启动开销,同时提高通信带宽的利用率。DeepSeek V3模型在进行AllGather 等通信时,可以将Norm 算子和量化算子移到AllGather 通信的前面,从而降低通信的数据量,进而提高通信的效率。但是由于量化算子的前移,需分别通信量化后的激活值和scale,进而增大了通信算子启动开销。由于量化scale 的数据量较小,对带宽的占用较低,因此团队采用通信通信并发的机制,将通信激活值和通信量化scale 并发起来,在不增加激活值通信开销的前提下,掩盖掉量化scale 的通信代价。

● 通信和权重预取的并发:昇腾芯片提供了缓存机制,算子在进行计算时,会优先从缓存中寻找数据,如果命中,则直接从缓存中读取数据,否则从HBM 中读取数据,而缓存的带宽是HBM 带宽的数倍。由于通信算子进行过程中HBM 带宽占用率较低,在通信算子进行过程中可以将后续算子需要的权重提前预取到缓存中,从而降低后续算子计算过程中的权重搬运开销。同时昇腾芯片支持灵活限定预取带宽,因此在通信过程中预取对通信性能影响很小。对于DeepSeek 模型,在MoE 模块末尾的ReduceScatter 预取MLA 中权重矩阵和KV cache,可以提升MLA 部分约10%计算性能。
图片

昇腾亲和的创新算子

1. MLA 算子优化

Attention 算子:MLA 相较于传统的Attention 算子(如MHA, GQA 类显著带宽瓶颈的算子),由于其中间变量膨胀且计算量显著增加,为算子优化带来了新的挑战。针对昇腾处理器的架构特性,团队对MLA 场景的FA 算子进行了算法重构以及硬件亲和的性能优化。

• 提出AMLA(Ascend MLA)算法,通过二进制编码解析及存内计算,实现乘性计算的加性等价转换,从而实现直接在Global Memory 上更新O 的步骤,无须进入Vector core,大幅降低中间变量的重复搬运。

• 对L1 缓存进行了细致规划,尽可能地减少数据重复搬入搬出的过程。

• 在工程实现方面,通过优化计算流程提高L2 cache 命中率,并且利用K-buffer 流水排布等策略,实现Cube 计算和Vector 计算互相掩盖,提高了算子整体性能。

上述优化方案提升 Attention 算子性能接近 1 倍,非 MTP 场景算力利用率达到 55%,使用一个 MTP 模块场景算力利用率达到 60%。

MLA 前序算子:针对复杂的MLA 前序算子,分别在Prefill 阶段和Decode 阶段采取了不同的优化策略:

• 在Prefill 阶段,通过双流并发等技术实现了流水掩盖,同时增加了FA 算子对多种输入输出模式的支持以消除纯访存类冗余算子。

• 在Decode 阶段,团队采用权重吸收,同时将前序算子深度融合为MLAProlog 算子,并且针对昇腾硬件架构进行了全方位的深度优化。

具体优化措施包括:采用权重预取减少流水线空泡;基于最小化搬运以及最大化带宽的tiling 策略;通过计算解耦降低指令依赖与等待;利用局部计算融合消除全核同步开销;运用昇腾定制指令集实现ICache 压缩,规避issue queue 阻塞风险等。

通过上述优化方案,MLAProlog 算子性能提升 30%以上。

2. MOE 算子优化

Dispatch/Combine 通算融合算子:在EP 部署模式中,MoE 中的专家分布在较大的通信域的各个卡上,每个Token 需要分发到对应的卡上进行计算,原始的实现方式使用InitialRouting 根据专家排序对所有Token 进行重排,再用AllToAll 以及AllToAllv通信算子进行交换token。该实现方式在通信域比较大的场景下,存在通信次数多、卡间同步开销严重等问题,阻碍了整网端到端时延的提升。因此团队提出MoeDistributeDispatch 和MoeDistributeCombine 两个通算融合算子技术:将计算和传输拆解为Token 粒度的计算单位,通过流水排布实现通信和计算的并行执行;同时利用内存语义的通信技术直接向不同卡上的共享内存传输数据,从而减少了本地拷贝和等待数据的开销;团队还通过本地内存筛选和拷贝的机制,减少了数据传输次数和卡间同步开销。

SMTurbo-CPP 算子:针对MOE 层大通信域场景下,小数据量传输效率低的问题,团队提出SMTurbo-Concurrent Push and Pull (SMTurbo-CPP)技术:在内存语义级别对通信算子AllToAll(v) 进行优化,充分利用硬件并发能力,使用读写混合、聚合流水、批量检测等技术,提升了线程的访存效率与吞吐,显著降低Dispatch 和Combine 场景通信算子的时延。

细粒度分级流水算法:基于Atlas A2 系列产品,HCCL 支持细粒度的分级流水算法,可大幅提升集群中Allgather、ReduceScatter、AlltoAll 等集合通信算子的执行效率。该算法利用A2 组网的特性,实现了节点内/节点间的并发执行,以提高带宽利用率。

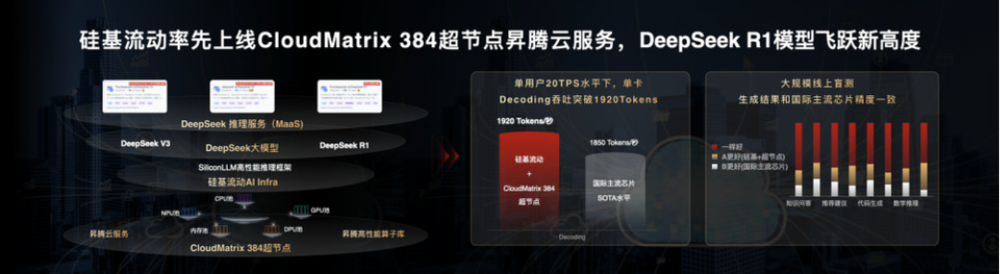
在2025 年4 月,硅基流动联合华为云基于CloudMatrix 384 超节点昇腾云服务和高性能推理框架SiliconLLM,用大规模专家并行最佳实践正式上线DeepSeek-R1。该服务在保证单用户20 TPS 水平前提下,单卡Decode 吞吐突破1920 Tokens/s,可比肩H100 部署性能。同时,经过主流测试集验证及大规模线上盲测,在昇腾算力部署DeepSeek-R1 的模型精度与DeepSeek 官方保持一致。
图片

写在最后

在大模型产业加速落地的关键节点,华为玩了波“硬核操作“—— 用“数学补物理的创新思路”硬刚硬件瓶颈,拿通算融合玩转集群调度,靠算子重构榨干芯片性能。这场全链路技术优化不仅实现了超大规模模型在国产硬件上的高效部署,更以开源共享的姿态激活了本土 AI 生态的协同创新活力。

如何学习AGI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

**

一、2025最新大模型学习路线

一个明确的学习路线可以帮助新人了解从哪里开始,按照什么顺序学习,以及需要掌握哪些知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

L1级别:AI大模型时代的华丽登场

L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的核心原理,关键技术,以及大模型应用场景;通过理论原理结合多个项目实战,从提示工程基础到提示工程进阶,掌握Prompt提示工程。

L2级别:AI大模型RAG应用开发工程

L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3级别:大模型Agent应用架构进阶实践

L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造我们自己的Agent智能体;同时还可以学习到包括Coze、Dify在内的可视化工具的使用。

L4级别:大模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调;并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

整个大模型学习路线L1主要是对大模型的理论基础、生态以及提示词他的一个学习掌握;而L3 L4更多的是通过项目实战来掌握大模型的应用开发,针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

二、大模型经典PDF书籍

书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)

三、大模型视频教程

对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。

四、大模型项目实战

学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。

五、大模型面试题

面试不仅是技术的较量,更需要充分的准备。

在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。


因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

【漏洞修复】Diffie-Hellman Key Agreement Protocol 资源管理错误漏洞(CVE-2002-20001) Diffie-Hellman Key Agreement Protocol 存在安全漏洞,远程攻击者可以发送实际上不是公钥的任意数字,并触发服务器端DHE模幂计算。 阅读详情

相关推荐

ByteTrack参数调优全攻略:从原理到实战(含YOLOv8示例)

本文深入解析了ByteTrack多目标跟踪算法的核心原理与参数调优策略。通过拆解其独特的两阶段关联机制,并结合YOLOv8检测器,提供了针对不同应用场景(如拥挤行人、高速车辆)的精细化参数调整指南与实战示例,旨在帮助开发者解决ID切换、目标丢失等工程落地难题,提升跟踪系统的鲁棒性与实用性。

cheese的博客 323

高通正面挑战英伟达、华为腾讯百度抢机器人大脑、A股反弹

本文内容综合自公开媒体报道,仅供参考,不构成任何投资建议。股市有风险,投资需谨慎。作者不对因使用本文内容而产生的任何损失承担责任。🔥① 高通宣布史上最激进转型:自研服务器 CPU 正面挑战英伟达 AI 霸权,Meta 微软已是大客户 ② 华为腾讯百度齐下场"机器人大脑"生态战,具身智能资本从"本体"转向"大脑" ③ A 股反弹:沪指涨 1.16%,上周五大跌后企稳回升。

weixin_45526015的博客 430

AI 与新媒体

AI重构新媒体生态:从生产到分发的全链路变革 AI正成为新媒体领域的核心基础设施,通过五大能力重塑内容产业:自动化生产(AIGC写作/制图/剪辑效率提升5-10倍)、智能分发(算法精准匹配用户)、数据洞察(实时舆情分析)、风险管控(审核效率提升12倍)和运营优化(A/B测试自动化)。这推动行业从"人找内容"转向"内容找人",制作成本下降90%的同时,也带来同质化加剧、版权争议和职业重构等挑战。当前阶段,人机协同成为主流——AI处理标准化生产,人类专注创意与价值观把控。

eastyuxiao的专栏 384

DeepSeek推动大语言模型发展进入新阶段

过年,最火的还是国产AI,无论是Deepseek V3 R1模型超越ChatGPT 4o,还是国产机器人春晚亮相,不仅让国人眼前一亮,也让IT界大跌眼镜。Deepseek仅凭一己之力,让英伟达芯片商总市值大跌5520亿美元,就连特朗普也不得不承认,来自中国公司的AI模型“DeepSeek”给我们(美国)的AI行业敲响警钟。

henanlion的博客 1495

Simulink模块库介绍(一)——信号源模块

Simulink模块库介绍(一)——信号源模块库目录Clock模块Digital Clock模块Band-Limited White Noise模块 目录 simulink模块库中提供了丰富的信号源模块组。逐一介绍,算是对之前做个总结吧 Clock模块 通过时钟模块,输出的时间作为判断呢,如下图,前2s之前为高斯白噪声,后2s为正弦曲线,共计10s。 Digital Clock模块 数字时钟模块主要用于离散系统的计时,sample time表示采用时间,如下图:分别是1s和0.5s的采样时间 Band-

5万+

机器视觉--线扫相机触发:从原理到选型,构建高效成像方案

本文深入解析线扫相机触发技术,从硬件编码器触发到软件触发方案,提供详细的性能对比和选型指南。通过实际案例展示如何构建高效成像方案,特别适合机器视觉领域需要精准控制的应用场景,如工业检测和自动化生产线。

weixin_42531886的博客 419

IPD咨询洞察:华为项目管理:分析价值创造的来源

华为项目管理中,价值交付不是笼统的完成任务,而是从两个角度拆解:价值的形态和归属。价值有三个维度——当期商业价值、未来战略目标、整体能力提升。价值归属四类对象:客户、企业、伙伴、团队。先定义价值,再对齐对象,项目才算真正交付了价值。

weixin_58096508的博客 250

MFC工具栏增加EditBox和Button

1. 在资源视图中增加EditBox, Button控件,ID分别为ID_EDIT_SEED, ID_BTN_SEED 2. 在CMainFrame中增加成员变量 CMFCToolBarEditBoxButton *m_editSeed; CMFCToolBarButton *m_btnSeed; 3. 在CMainFrame::OnCreate中创建控件 m_editSeed = new CMFCToolBarEditBoxButton(ID_EDIT_SEED, GetCmdMgr()-&.

学习是为了探索这个世界的本质 804

华为直连PBR去往多个目的地址走不同路径互通

PC1、PC2、PC3三个网段回访需要经过上方的防火墙(防火墙未找到授权,本次使用路由器模拟),并且PC1访问PC2走1.1.1.1-1.1.1.2互联地址;PC2访问PC3走2.2.2.1-2.2.2.2互联地址,因为上面为防火墙,需要来回路径和接口要一致才行;但是这对于防火墙造成了接口的相同设备不同接口异步路由,对与路由器没有问题,但是对于安全设备就出现来回路径不一致,最终造成业务不通。但是PC3访问PC1走的是1.1.1.1的路径。访问PC3走的是11.1.1.1的路径。和PC3路径不一致了。

huainingning的博客 226

基于XGBoost的混凝土力学性能预测系统

本文介绍了一个基于XGBoost算法的混凝土力学性能预测系统。该系统通过模拟生成3000组混凝土配合比数据(包含水灰比、水泥用量和龄期三个关键特征),利用XGBoost强大的非线性建模能力预测混凝土抗压强度。研究背景源于传统混凝土性能测试方法耗时耗力的痛点,该系统可显著减少实验次数,优化配合比设计。系统实现包括:数据生成与特征工程(模拟真实工程数据并添加噪声和异常值)、XGBoost模型构建、以及预测性能评估。XGBoost算法因其处理非线性关系能力强、鲁棒性好等优势被选用,可为智能建造和数字化施工提供技术

huanghm88的专栏 131

当启动容器的时候提示:exec format error?如何解决问题

Docker容器出现"exec format error"的主要原因是架构不兼容(如ARM设备运行x86镜像)。解决方案包括:1)匹配镜像与宿主机架构;2)构建时指定平台;3)安装QEMU模拟器;4)修复文件权限和格式;5)验证基础镜像兼容性。排查流程应从检查架构匹配开始,逐步验证权限、解释器和换行符等问题。建议优先使用多架构镜像,构建时明确指定平台,并使用buildx工具生成多平台镜像。调试时可进入容器手动验证文件格式和兼容性。

weixin_39291964的博客 2721

华为 C++ 二面追问虚函数表:我们用 g++ 把虚表打印出来逐项核对

这道题来自题库里一场 2026 年的华为 C/C++ 软件开发二面。面试官从一个很大的问题开始,一路往下追了 5 问:C++ 的特性有哪些?→ 怎么实现多态?→ C++ 虚函数 → 在继承中子类虚函数表怎么生成?→ 构造和析构函数能不能写为虚函数,为什么?前两问谁都答得上:封装、继承、多态;多态靠虚函数。后三问要你讲清楚虚表长什么样,以及对象在构造和析构的过程中发生了什么。这些说法方向都对,但有几处说得太粗,被追问一句就容易卡住。我们在服务器上用 g++ 13.3 把虚表直接打印出来,逐条核对了一遍。

muyuyuzhong的专栏 142

详细解读经典跨模态对齐技术Q-Former代码

介绍BLIP2的博客层出不穷,介绍Q-Former的博客也不少,但是详细解读Q-Former代码的博客很少。这篇博客希望以代码为基础,讲明白Q-Former的原理和核心思想,并详细解读一些值得注意的细节。希望读者们能从这一经典技术中朝花夕拾,得到启发。

沉迷单车的追风少年 2465

阳光与华为 API 差异多大?50MW 电站数据归一化的架构实践

去年 10 月在山东做那个 40MW 的工商业分布式项目时,业主为了平衡供应链,硬是选了 50% 阳光电源和 50% 华为的组串式逆变器。当时对接文档发过来,我扫了一眼,觉得无非就是两个 RESTful 接口的事儿。结果项目上线第一周,运维后台的数据就开始打架:这边发电量算的是累计值,那边给的是当日增量值;这边时间戳是

2601_96401599的博客 231

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

【2026-11-06】华为研发机试三道编程题解

本文整理了华为11月6日研发岗三道编程题解法:第一题为按列填充句子,通过枚举行数模拟列宽计算,求最小行数;第二题为生鲜库存优化,利用动态分配思想,预处理“采购-销售”成本,贪心选择最便宜来源满足需求;第三题涉及AC自动机与动态规划结合的序列化奖励问题。代码均以Java实现,思路清晰,适合笔试刷题参考。关注公众号【TechGuide】获取更多真题解析。

试问道几许 405

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

华为OceanStor卷丢失数据恢复实战【东方护航数据恢复深圳店】

华为OceanStor存储卷丢失故障中,因NAS卷跨双LUN条带化分布,恢复需先解析LUN映射关系,通过镜像副本虚拟重组逻辑卷,再逐层重建文件系统结构。基于目录项、节点与文件特征多重匹配,结合日志残留信息,成功提取办公文档、图片视频等数据。关键经验:及时停写、分层诊断、镜像操作、多线索验证,确保数据安全高效恢复。

dfhuhangdr的博客 188

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

华为运维面试题

华为面试注重真实经历与价值观契合,主管面采用STAR+价值观锚点+反思闭环框架,强调“我”的决策与量化结果。运维手撕题重思路表达与边界处理,需清晰复述、分步讲解、主动验证。云场景设计题须先澄清需求,再分层设计,兼顾可靠性与成本,突出取舍意识。通用心法:聚焦“我”、结构先行、主动说明边界与改进,以数字和反思收尾,展现复盘能力与华为文化匹配度。

dp340823的博客 212

鸿蒙手机远程控制Windows电脑:华为手机控电脑实操完全指南

对于鸿蒙(HarmonyOS)用户来说,用华为手机/平板远程控制Windows电脑,ToDesk是目前最佳选择

球球!? 301

华为HCIP网络工程师认证—网络管理与运维

随着网络的规模越来越庞大,网络中的设备种类繁多,如何对越来越复杂的网络进行有效的管理,从而提供高质量的网络服务,已成为网络管理所面临的巨大挑战。网络的管理与运维手段多样,本博客将对几种网络管理与运维手段展开介绍。网络管理与运维,就是让你从“一台一台跑去敲命令的消防员”,变成“坐在总控室看大屏的指挥官”的一套技术体系。 它的核心目标就四个字:可视、可控——你得先“看见”网络在发生什么,然后才能“控制”它不出事。网络管理与运维,在 HCIP 里不像 OSPF、VLAN 那样需要算得很深,但它是一个“框架性”……

极客园地 317

华为鲲鹏920s芯片serdestool工具使用说明

目前鲲鹏920s上面可以使用华为提供的serdestool进行眼图查看,查看100G网卡的眼图等2、操作步骤首先需要安装欧拉系统安装后可以使用everything源进行图形化配置将华为提供的serdestool工具拷贝到模块上面主要有三个文件下载地址见步骤1将serdestool工具放置到/usr/bin目录下。步骤2进入该目录执行赋予权限。步骤3将文件放到对应填好的目录下,默认是在root目录下,可自行执行装载环境。步骤4将文件放。

无知的我 297

华为昇腾计算卡全解析:从 910 架构到 CANN 软件栈与超节点实践

昇腾的价值不能只用"单卡跑分"衡量。它是一套从达芬奇架构、910/950/960 系列芯片、超节点互联,到 AscendC 编程范式、CANN 软件栈、PyTorch/Triton/TileLang 适配的完整体系。这套体系目前的短板在软件生态成熟度和算子覆盖深度,优势在于自主可控、系统级协同和推理场景的能效比。

Maxwell_Newton的博客 802

HUAWEI HiPlay 认证费用构成拆解:测试费、平台服务费明细

入口在华为开发者联盟伙伴平台,签生态框架协议、提交资质,这一步本身不收会员费或接入费,但会卡进度 —— 资质审核、协议来回,时间成本要算进去。协议一致性(设备发现、连接建立、音频流协商、编解码匹配、断连重连)、音频客观指标(频响、失真、信噪比、声道分离)、无线射频性能,三块跑完才算完整。所以问 HiPlay 费用,别只问总价,让对方把准入、开发、测试、复测、变更、维护分开列。音频主控、无线模组、天线设计对接华为技术团队预审,这一轮通常不额外收费,但硬件不达标被要求换方案,后面的采购和改板就是实打实的支出。

BlueAsia_TechSvc的博客 324

IPD咨询洞察:华为项目管理:如何以价值交付为中心

华为项目管理的关注重心经历了三个阶段:以质量为中心,满足基本业务需求;以客户满意为中心,提升客户黏性与响应速度;以价值交付为中心,围绕客户战略与商业目标展开交付。先讲清楚价值,再呈现价值、证明价值,项目才算真正完成。

weixin_58096508的博客 192

存储 HCIE 是什么:华为存储认证三级体系与 V4.0 考纲变化

华为存储HCIE-V4.0于2026年9月30日起正式适用,聚焦AI驱动的存储应用与运维,新增AIFabric智能预测性维护等AI内容,实验考试增设15分故障排查模块(含预置与动态场景故障)。三大能力模块为CCSS、CCSN、CDPS,知识框架升级。备考需按官方考纲清单化训练,实验在云端限时演练。V3.0预计2027年3月30日下线,期间可选考。

370

华为VPLS over SRV6

IGP IPv6:在 P 与 PE 上启用 IS-IS Level-2 和 IPv6 拓扑,并在物理接口与 LoopBack0 上使能 IS-IS IPv6,打通底层 IPv6 可达性。BGP 邻居:以 LoopBack0 为源建立 IBGP 邻居,P 作为反射器,为 EVPN 路由传递提供通道。EVPN 对等体:在 l2vpn-family evpn 下使能邻居并声明 SRv6 封装类型,确保 EVPN 路由可正常收发。locator 与 SID 动态分配。

322

华为CE设备配置EVPN OVER VXLAN

本文基于华为 CE 交换机,完整演示 EVPN 与 RFC 5549 的配置过程。全文以 IPv6 链路本地地址建立 EBGP 邻居,无需配置互联接口 IP,即可用 IPv6 下一跳转发 IPv4 地址;随后通过 EBGP 发布环回地址,并用 IPv6 环回地址建立 EVPN 邻居。内容依次覆盖接口配置、BGP unnumbered、EVPN BGP 邻居、EVPN VXLAN、分布式网关与 TYPE5 路由引入、三层 VPC 模拟,以及 TYPE2/TYPE5 路由与三层 VPN 路由表的查看验证。

80
上一篇: 这是我见过的讲解大模型最易懂、也最漂亮的PPT(开发篇)
下一篇: 大模型推理,不再是“一根筋”
程序员_大白
博客等级 码龄5年 1万+粉丝 4001原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值