构建一个最小可行性的Rag系统,(非常详细)从零基础到精通,精通收藏这篇就够了!

RAG 入门指南:从零开始构建一个 RAG 系统 在开始之前,我还是打算再次简要的介绍一下 RAG。在 Meta 的官方 Blog 上有这样一段话:这段话主要讲述了一个新的模型架构,也就是RAG (检索增强生成)的重要性和优势。可以概括为以下几点:1. 构建一个能够进行研究和上下文分析的模型虽然更具挑战性,但对未来的技术进步非常关键;2. 通过在知识密集的下游任务上微调,RAG 可以实现最先进的结果,比现有的最大的预训练序列到序列语言模型还要好;3. 与传统的预训练模型不同,RAG 的内部知识可以轻松地动态更改或补充。 阅读详情

前言

在《AI大模型实战篇》系列文章中,小编从最经典的ReAct模式开始,沿着规划路线介绍了REWOO、Plan&Execute和LLM Compiler,沿着反思路线介绍了Basic Reflection、Self Discover和Reflexion,并以最强大的设计模式LATS作为收尾。
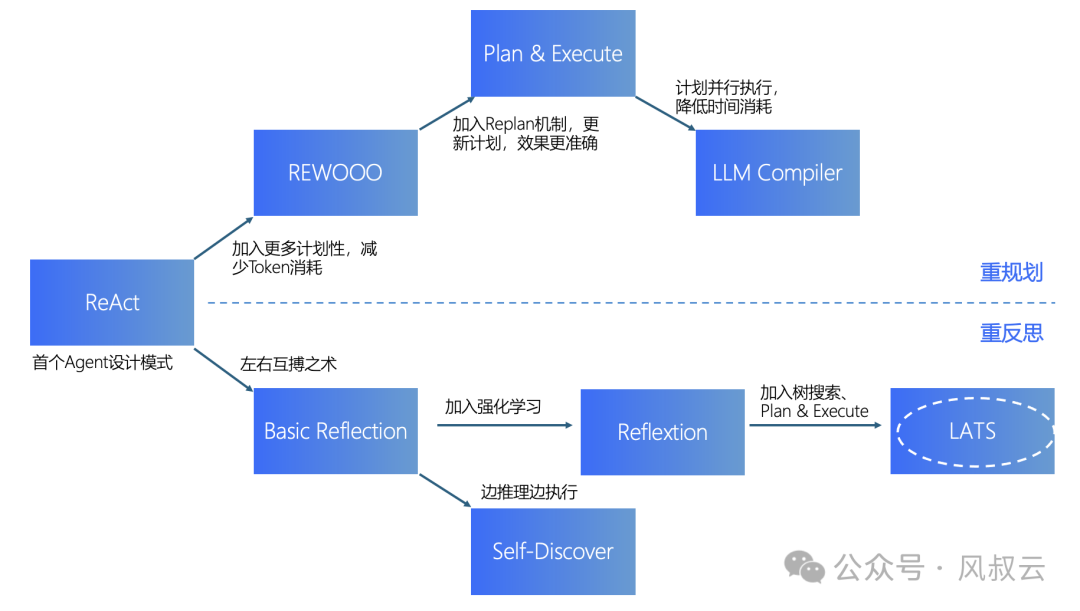
但是,所有的这些设计模式,都只是在告诉AI Agent应该如何规划和思考,且只能依赖于大模型既有的知识储备。而实际应用中,我们往往更希望AI Agent结合我们给定的知识和信息,在更专业的垂直领域内进行规划和思考。

比如我们希望Agent帮我们做论文分析、书籍总结,或者在企业级场景中,让AI Agent写营销计划、内部知识问答、智能客服等等非常多的场景,只靠上面几种Agent设计模式是远远不够的,我们必须给大模型外挂知识库,并且通过工作流进一步约束和规范Agent的思考方向和行为模式。

解决这个问题的最佳方式是利用RAG技术,接下来我们正式开启《RAG实战篇》系列。对于RAG还不太熟悉的朋友,可以先参考下面两篇文章:

聊聊炙手可热的Rag:产生原因、基本原理与实施路径

Rag系统的发展历程,从朴素、高级到模块化

RAG系统实现方案概览

我们将基于下图所示的框架,来构建一个完整的RAG系统。
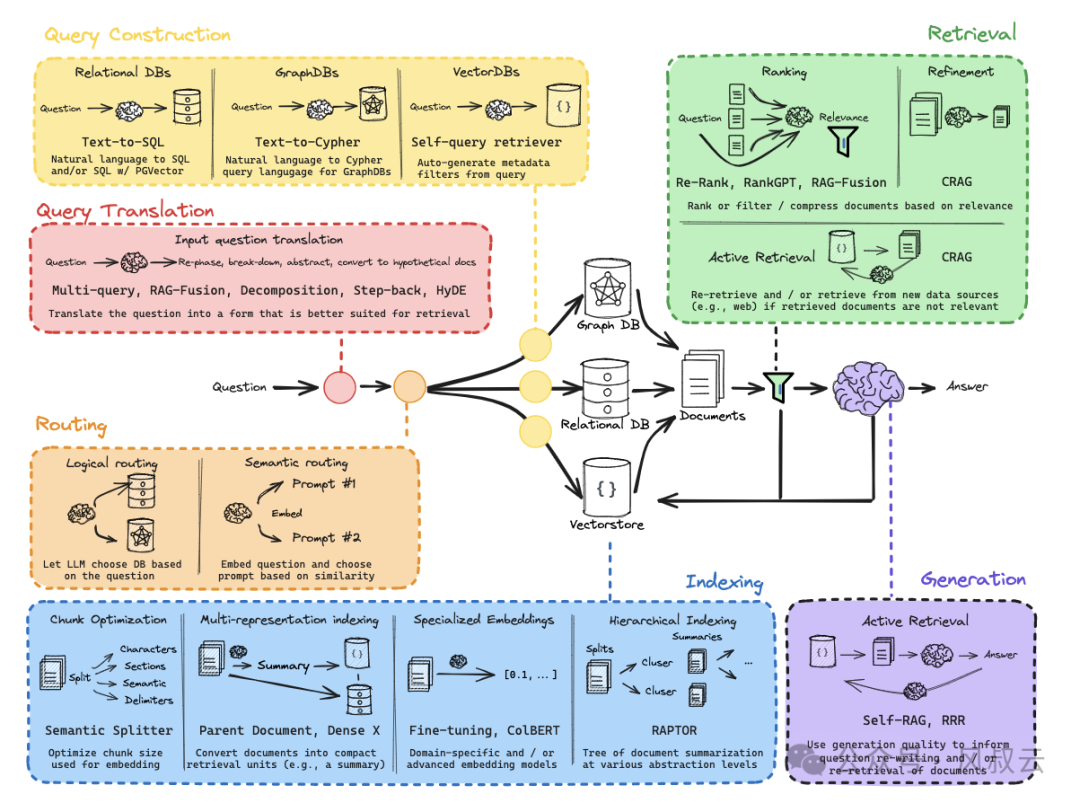
1. Indexing(索引)

Indexing是任何RAG系统的第一步,在实际应用场景中,文档尺寸可能非常大,因此需要将长篇文档分割成多个文本块,以便更高效地处理和检索信息。

Indexing环节主要面临三个难题

  • 首先,内容表述不完整,内容块的语义信息受分割方式影响,致使在较长的语境中,重要信息被丢失或被掩盖。

  • 其次,块相似性搜索不准确,随着数据量增多,检索中的噪声增大,导致频繁与错误数据匹配,使得检索系统脆弱且不可靠。

  • 最后,参考轨迹不明晰,检索到的内容块可能来自任何文档,没有引用痕迹,可能出现来自多个不同文档的块,尽管语义相似,但包含的却是完全不同主题的内容。

在这个框架中,我们将在索引环节实现Chunk optimization(块优化)、Multi-representation indexing、Specialized Embeddings(特殊嵌入)和Hierachical Indexing(多级索引)这四种优化方案。

2. Query Translation

Query Translation主要处理用户的输入。在初始的RAG系统中,往往直接使用原始query进行检索,可能会存在三个问题:

  • 第一,原始query的措辞不当,尤其是涉及到很多专业词汇时,query可能存在概念使用错误的问题;

  • 第二,往往知识库内的数据无法直接回答,需要组合知识才能找到答案;

  • 第三,当query涉及比较多的细节时,由于检索效率有限,大模型往往无法进行高质量的回答。

在这个框架中,我们将在这个环节实现Multi-query(多查询)、Rag-Fusion、Decomposition(查询分解)、Stepback和HYDE这五种优化方案

3. Routing(路由)

路由的作用,是为每个Query选择最合适的处理管道,以及依据来自模型的输入或补充的元数据,来确定将启用哪些模块。比如在索引环节引入多重索引技术后,就需要使用多级路由机制,根据Query引导至最合适的父级索引。

在路由环节,我们将实现Logical routing(基于逻辑的路由)和Sematic Routing(基于语义的路由)两种方案。

4. Query Construction(查询构建)

查询构建主要是为了将自然语言的Query,转化为某种特定机器或软件能理解的语言。因为随着大模型在各行各业的渗透,除文本数据外,诸如表格和图形数据等越来越多的结构化数据正被融入 RAG 系统。

比如在一些ChatBI的场景下,就需要将用户的Query内容,转化为SQL语句,进行数据库查询,这就是Text-to-SQL。再比如工业设计场景下,可能需要将用户的Query转化为设计指令,或者设备控制指令,这就是Text-to-Cypher。

在查询构建环节,我们将实现Text-to-SQL、Text-to-Cypher和Self-Query(让大模型自行构建Query)三种优化方案。

5. Retrieval(检索)

在检索的时候,用户的问题会被输入到嵌入模型中进行向量化处理,然后系统会在向量数据库中搜索与该问题向量语义上相似的知识文本或历史对话记录并返回。

在朴素RAG中,系统会将所有检索到的块直接输入到 LLM生成回答,导致出现中间内容丢失、噪声占比过高、上下文长度限制等问题。

在检索环节,我们将实现Reranking(重排序)、Refinement(压缩)、Corrective Rag(纠正性Rag)等方案。

6. Generation(生成)

在生成环节,可能会出现以下问题:

  • 第一,当系统忽略了以特定格式(例如表格或列表)提取信息的指令时,输出可能会出现格式错误;

  • 第二,输出错误或者输出不完整,比如对于一些比较类问题的处理往往不尽人意,以及可能出现的幻觉问题;

  • 第三,可能会输出一些不太符合人类/社会偏好,政治不正确的回答

在生成环节,我们将重点介绍Self-Rag方案。

要覆盖所有上面提到的优化环节,需要较长的内容篇幅,因此风叔会分成几篇文章来写。接下来,我们先从整体上,看看一个最小化的RAG系统是如何实现的。

构建最小化的Naive Rag系统

RAG发展初期,其核心框架由索引、检索和生成构成,这种范式被称作Naive RAG。Naive Rag的原理非常简单,包括以下三个步骤:

  1. 索引:这一过程通常在离线状态下进行,将原始文档或数据进行清洗并分块,然后将分块后的知识通过embedding模型生成语义向量,并创建索引。

  2. 检索:对用户输入的Query问题,使用相同的embedding模型,计算Query嵌入和文档块嵌入之间的向量相似度,然后选择相似度最高的前N个文档块作为当前问题的增强上下文信息。

  3. 生成:将原始Query和相关文档合并为新的提示,然后由大型语言模型基于提供的信息回答问题。如果有历史对话信息,也可以合并到提示中,用于进行多轮对话。

下面,风叔通过实际的源码,详细介绍如何构建一个最小化的Naive Rag系统,具体的源代码地址可以在文末获取。

第一步 建立索引
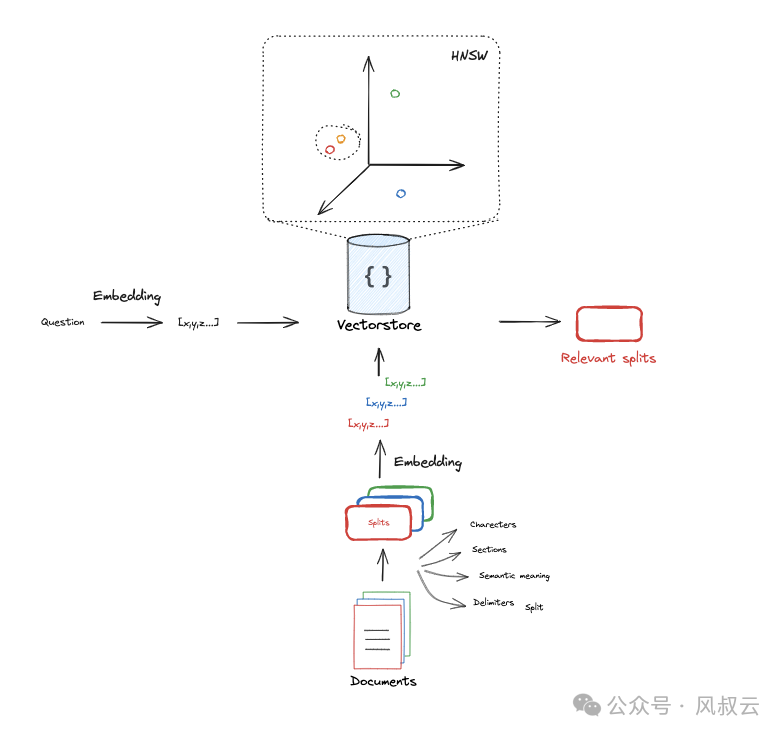
首先,我们导入一些示例Documents,以导入外部博客为例,我们直接使用WebBaseLoader从目标地址读取数据。

import bs4``from langchain_community.document_loaders import WebBaseLoader``loader = WebBaseLoader(`    `web_paths=("https://lilianweng.github.io/posts/2023-06-23-agent/",),`    `bs_kwargs=dict(`        `parse_only=bs4.SoupStrainer(`            `class_=("post-content", "post-title", "post-header")`        `)`    `),``)``blog_docs = loader.load()

然后我们需要对文档进行分块。在这个例子中,我们先把流程跑通,采用最简单的文本分割器,尽量按照段落进行分割。

# Split``from langchain.text_splitter import RecursiveCharacterTextSplitter``text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(`    `chunk_size=300,``    chunk_overlap=50)``   ``# Make splits``splits = text_splitter.split_documents(blog_docs)

接下来,我们需要将文本分割的结果存入向量数据库,默认使用了OpenAI的Embedding模型。

# Index``from langchain_openai import OpenAIEmbeddings``from langchain_community.vectorstores import Chroma``vectorstore = Chroma.from_documents(documents=splits, embedding=OpenAIEmbeddings())

第二步 检索

检索过程非常简单。首先构建检索器retriever,设置K=1,即只召回最相关的一个内容块;然后根据问题找到最相关的内容,存入docs

retriever = vectorstore.as_retriever(search_kwargs={"k": 1})``docs = retriever.get_relevant_documents("What is Task Decomposition?")

第三步 生成
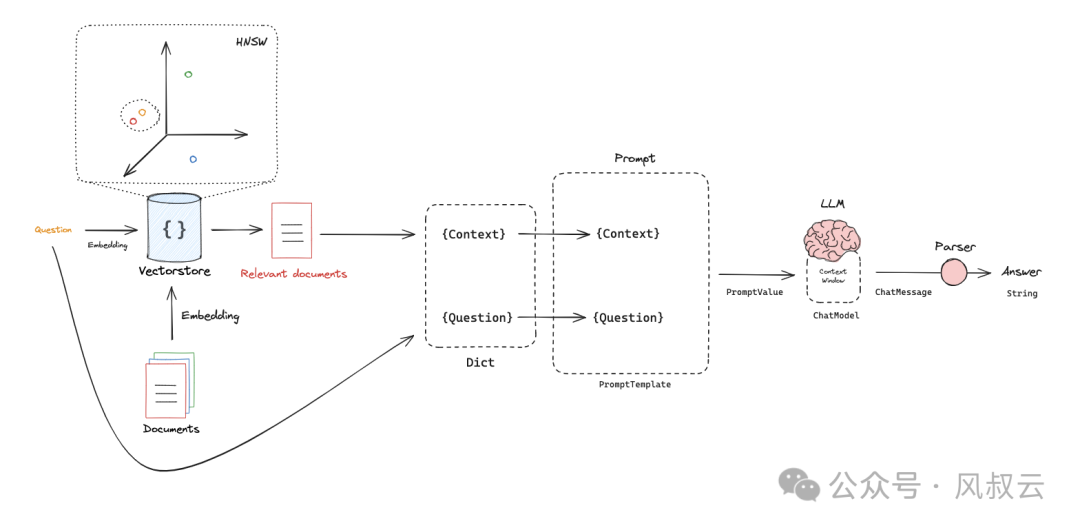
生成环节,我们先定义Prompt。先跑通流程,我们定义一个最简单的Prompt

from langchain_openai import ChatOpenAI``from langchain.prompts import ChatPromptTemplate``   ``# Prompt``template = """Answer the question based only on the following context:``{context}``   ``Question: {question}``"""``   ``prompt = ChatPromptTemplate.from_template(template)

然后调用大模型生成最终回复,我们使用了gpt-3.5-turbo。我们先把temperature调到0,减少大模型输出的随机性。

from langchain_core.output_parsers import StrOutputParser``from langchain_core.runnables import RunnablePassthrough``   ``llm = ChatOpenAI(model_name="gpt-3.5-turbo", temperature=0)``   ``rag_chain = (`    `{"context": retriever, "question": RunnablePassthrough()}`    `| prompt`    `| llm`    `| StrOutputParser()``)``   ``rag_chain.invoke("What is Task Decomposition?")

到这里,一个最最简单的Rag系统就搭建完了,其原理非常简单易懂。“麻雀虽小,五脏俱全”,大家也可以拿这段代码自己做一些修改,比如读取pdf文件、word文档等等。

总结

经过上述流程,我们搭建了一个非常简单的Naive RAG系统,这个系统解析了一篇博客文章,然后接收用户提问,并使用博客的内容做增强生成。这是一个非常简单的框架,也很易于理解。

但是在实际应用中还有非常多需要优化的地方,包括Indexing(索引)、Query Translation(查询转换)、Routing(路由)、Query Construction(查询构建)、Retrival(检索)和Generation(生成),每个环节都有多种有效的优化方式。

## AI大模型学习福利

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2025最新版优快云大礼包:《AGI大模型学习资源包》免费分享

一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2025最新版优快云大礼包:《AGI大模型学习资源包》免费分享

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2025最新版优快云大礼包:《AGI大模型学习资源包》免费分享

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2025最新版优快云大礼包:《AGI大模型学习资源包》免费分享

四、AI大模型商业化落地方案

img

因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2025最新版优快云大礼包:《AGI大模型学习资源包》免费分享

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

大模型学习笔记五:RAG 1、LLM 的知识不是实时的2、LLM 可能不知道你私有的领域/业务知识搭建过程:1、文档加载,并按一定条件切割成片段2、将切割的文本片段灌入检索引擎3、封装检索接口4、构建调用流程:Query -> 检索 -> Prompt -> LLM -> 回复1、文档加载2、文档切分3、向量化4、灌入向量数据库。 阅读详情

相关推荐

自己手写了一个大模型RAG项目-04.知识库构建

大家好,我是程序锅。github上的代码封装程度高,不利于小白学习入门。常规的大模型RAG框架有langchain等,但是langchain等框架源码理解困难,debug源码上手难度大。因此,我写了一个人人都能看懂、人人都能修改的大模型RAG框架代码。整体项目结构如下图所示:手把手教你大模型RAG框架架构整个小项目分为10个章节,和github高度封装的RAG代码不同,我们将从0到1搭建大模型RAG问答系统,所有代码评论区回复rag免费获取!本篇文章将介绍。

qq_35054222的博客 4822

RAG与知识库搭建,手把手教你构建RAG系统

自从发现可以利用自有数据来增强大语言模型(LLM)的能力以来,如何将 LLM 的通用知识与个人数据有效结合一直是热门话题。关于使用微调(fine-tuning)还是检索增强生成(RAG)来实现这一目标的讨论持续不断。检索增强生成 (RAG) 是一种使用来自私有或专有数据源的信息来辅助文本生成的技术。它将检索模型(设计用于搜索大型数据集或知识库)和生成模型(例如大型语言模型 (LLM),此类模型会使用检索到的信息生成可供阅读的文本回复)结合在一起。

qkh1234567的博客 5180

【AI大模型应用开发】3.2 RAG实战 - RAG应用+UI实现加载本地文件并对话

前面我们实现了RAG基本流程,今天我们在此基础上给它加个UI界面,在浏览器打开,实现上传本地文件、解析,并用大模型实现与该文档的对话。也就是一个阉割版demo版的ChatPDF或知识库对话系统。

同学小张的博客 3054

RAG是什么?一文讲清楚RAG原理与典型系统架构!

RAG,全称为Retrieval Augmented Generation,即检索增强生成。它是一种将外部知识检索与大型语言模型的生成能力相结合的人工智能技术框架。其核心思想是在大型语言模型(LLM)处理用户查询并生成回答之前,首先从一个或多个外部知识源(如数据库、文档集合、API等)中检索与查询相关的、最新的信息片段。然后,这些检索到的信息将作为额外的上下文(Context)注入到LLM的提示(Prompt)中,从而引导LLM生成更准确、更相关、更具事实性的内容。

kaka0722ww的博客 4231

Ferromagnetic soft continuum robots

本文来自机器人领域顶刊,Science Robotics。介绍了一种铁磁软连续体机器人,主要贡献为1)介绍了一个基于磁性微粒和聚合物的软连续体机器人的制造方法,在机器人外表面涂了一层水凝胶,极大地降低了摩擦阻力;2)并研究了在磁场下,不同粒子体积分数下,此机器人的驱动性能;利用手动操控的磁铁,进行了许多实验证明该机器人性能的优异性。 铁磁软连续体机器人 Ferromagnetic soft continuum robots [1] Paper Link Authors: Kim, Yoonho, et al

XU Yangxin的博客 1373

USB2.0基础知识总结

目录 1、协议层: 1.1、域分类 1.2 、USB传输方式: 1、协议层: 域和包定义:包是一次传输的单位,每个包由多个域组成; USB中是按照LSB进行字节传输; 1.1、域分类 1.1.1: 同步域(SYNC field) 所有的包都开始于同步域,在低速和全速通信中SYNC field用7个0和1个1来表示。 由于USB2.0使用了NRZI编码(0用翻转来表示,1用不翻转表示),所以00000001就是上图那样。 ...

qq_32938605的博客 4409

【2025版】构建一个最小可行性的Rag系统,从零基础到精通,精通收藏这篇就够了!

在《AI大模型实战篇》系列文章中,小编从最经典的ReAct模式开始,沿着规划路线介绍了REWOO、Plan&Execute和LLM Compiler,沿着反思路线介绍了Basic Reflection、Self Discover和Reflexion,并以最强大的设计模式LATS作为收尾。但是,所有的这些设计模式,都只是在告诉AI Agent应该如何规划和思考,且只能依赖于大模型既有的知识储备。而实际应用中,我们往往更希望AI Agent结合我们给定的知识和信息,在更专业的垂直领域内进行规划和思考。

Javachichi的博客 1309

DEXPI与Proteus XML:解锁过程工业P&ID数据互操作性的技术核心

本文深入探讨了DEXPI与Proteus XML在过程工业P&ID数据互操作性中的核心技术。通过解析DEXPI标准的开源特性和Proteus XML的架构设计,揭示了其在跨平台数据交换中的关键作用,并结合CADMATIC和西门子COMOS的实战案例,展示了如何实现高效的数据集成与转换。

weixin_29195615的博客 383

RAG实战篇:构建一个最小可行性的Rag系统

经过上述流程,我们搭建了一个非常简单的Naive RAG系统,这个系统解析了一篇博客文章,然后接收用户提问,并使用博客的内容做增强生成。这是一个非常简单的框架,也很易于理解。但是在实际应用中还有非常多需要优化的地方,包括Indexing(索引)、Query Translation(查询转换)、Routing(路由)、Query Construction(查询构建)、Retrival(检索)和Generation(生成),每个环节都有多种有效的优化方式。

xx_nm98的博客 2597

台式机ubuntu系统屏幕无法调节的问题(已解决)(汇总)

背景:新配了一台主机,安装了双系统,windows下屏幕在带鱼屏上显示良好,但Ubuntu系统屏幕拉伸严重。 问题描述:系统没有适应屏幕被整个拉伸了,进入设置界面,显示Built-in Display,分辨率只有1024*768无法设置。 尝试一:网上最多的方法就是使用xrandr, 结果显示:xrandr:Failed to get size of gamma for output default 尝试二: 第一次进入命令行页面:login:填你的用户面 password:使用字母上方的数字键输入你的密码

weixin_45626706的博客 4625

Mac上IDEA的PlantUML插件报错‘找不到Graphviz’?手把手教你用Homebrew搞定(附阿里云镜像避坑)

本文详细解决了Mac上IDEA的PlantUML插件报错‘找不到Graphviz’的问题,通过Homebrew安装Graphviz并配置阿里云镜像源,特别针对Apple Silicon芯片用户提供了优化方案。文章还涵盖了IDEA中PlantUML插件的正确配置和常见问题排查,帮助开发者高效使用PlantUML进行UML图表设计。

weixin_42619742的博客 468

大模型 | RAG实战篇:构建一个最小可行性的Rag系统

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

老皮的博客 1395

基于图神经网络强化学习解决车辆路径规划问题(完整代码+报告)

基于图神经网络强化学习解决车辆路径规划问题(完整代码+报告)

3055

大模型rag技术,什么是RAG?大模型入门到精通,收藏这篇就够了

RAG(Retrieval-Augmented Generation)即检索增强生成,为大模型提供了从特定数据源检索到的信息,以此来修正和补充生成的答案。

Python_0011的博客 7564

QGis二次开发 —— 1、win10/win11搭建Vs2017-QGis3.40.12环境(附Vs2017环境效果,附全部问题解决方法)(附:Qt助手加入QGis接口说明文档)

QGis二次开发 —— 1、Windows10搭建Vs2017-QGis环境(附Vs2017环境效果)(附:Qt助手加入QGisA接口说明文档)

1362

Deeplabv3+改进1:添加CBAM注意力机制|有效涨点

我们提出卷积块注意力模块(CBAM),这是一种简单而有效的前馈卷积神经网络注意力模块。给定一个中间特征图,我们的模块会依次沿两个独立维度(通道和空间)推断注意力图,然后将注意力图与输入特征图相乘,以实现自适应特征细化。由于 CBAM 是一个轻量级且通用的模块,它可以无缝集成到任何 CNN 架构中,几乎不会增加开销,并且可以与基础 CNN 一起端到端训练。我们通过在 ImageNet-1K、MS COCO 检测和 VOC 2007 检测数据集上进行的大量实验验证了 CBAM。

AIcurator的博客 1691

LangChain构建RAG,从入门到精通!从0到1打造对话系统,收藏这篇就够了!

本文用LangChain/LangGraph完整拆解RAG(Retrieval-Augmented Generation)架构,并给出工程模板:从最小可用的RAG系统,进化到带聊天历史和过滤的检索,以及使用Agent进行自治式检索。

xx_nm98的博客 1106

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

大模型rag技术,什么是RAG?(非常详细)从零级入门到精通,收藏这篇就够了

RAG(Retrieval-Augmented Generation)即检索增强生成,为大模型提供了从特定数据源检索到的信息,以此来修正和补充生成的答案。

leah126的博客 2206

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

大模型rag技术,什么是RAG?(非常详细)从零基础入门到精通,收藏这篇就够了

RAG(Retrieval-Augmented Generation)即检索增强生成,为大模型提供了从特定数据源检索到的信息,以此来修正和补充生成的答案。

leah126的博客 794

RAG是什么?RAG综述,从原理到实战一篇搞懂!(非常详细)从零基础到精通,收藏这篇就够了!

RAG 作为人工智能领域极具创新性的技术,通过检索增强生成的独特架构,有效弥补了大语言模型在知识更新和特定领域知识储备上的不足。从基础的索引构建、检索和生成原理,到不断发展演进的不同阶段,再到查询优化、嵌入技术等关键技术细节,RAG 形成了一套完整且不断完善的技术体系。在实际应用中,无论是智能客服系统提升客户服务效率,还是医疗知识问答系统辅助专业决策,RAG 都展现出强大的实用价值和广阔的应用前景。

Python_0011的博客 1160

【2025版】知识图谱增强的RAG(KG-RAG)详细解析,从零基础到精通,精通收藏这篇就够了!

KG-RAG 表示基于知识图谱的RAG(Retrieval Augmented Generation)检索增强.

Python_0011的博客 1745

RAG从入门到精通,收藏这篇万字长文就够了!5步流程+12个策略,全讲透了!

ChatGPT、GLM等生成式人工智能在文本生成、文本到图像生成等任务中表现出令人印象深刻的性能。但它们也存在固有局限性,包括产生幻觉、缺乏对生成文本的可解释性、专业领域知识理解差,以及对最新知识的了解有限。为了克服这些限制,提高模型的能力,有两种主要途径:一种是微调(Fine Tune)来更新模型,另一种是让他们能够与外部世界互动,以不同的形式和方式获取知识。

Python_cocola的博客 1258

RAG技术全解析:从经典范式到Agentic RAG,收藏这篇就够了!

你有没有遇到过AI回答问题时给出过时或者不准确的内容?那是因为传统的AI系统依赖静态数据,没办法实时更新信息。 但现在,有了Agentic RAG,它就像给AI装上了“智能小助手”,能够实时检索最新数据,还能根据复杂任务灵活调整策略,让回答更准确、更贴近我们的需求!

m0_59164520的博客 981
上一篇: 一文搞懂LangChain是什么?(非常详细)从零基础到精通,收藏这篇就够了
下一篇: 密码学基础 -- ECC从入门到永不放弃(非常详细),从零基础到精通,收藏这篇就够了!
程序员_大白
博客等级 码龄5年 1万+粉丝 4001原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值