2025版最新大语言模型的指令微调,零基础入门到精通,收藏这篇就够了

Instruction Tuning(FLAN、instructGPT、chatGPT) 首页最近被chatGPT刷屏,但翔二博主左看右看发现很多想法似乎都是一脉相通的,于是连夜从存档中找了一些文章尝试理一理它的理论路线。博主个人理解,它以更为embodied AI形式的指令作为输入,以训练/微调大规模的信息模型,并基于强化学习与真实世界做持续交互,已经很接近此处所提到的“数字超人”了。 阅读详情

当前的大语言模型主要是预训练大模型,在大规模无监督数据上训练之后,再经过有监督微调和对齐之后就可以完成很多任务。尽管如此,面对垂直领域的应用,大模型依然需要微调才能获得更好地应用结果。而大模型的微调有很多方式,包括指令微调、有监督微调、提示工程等。其中,指令微调(Instruction Tuning)作为改进模型可控性最重要的一类方法,目前并没有很好的资料参。浙江大学研究人员联合Shannon AI等单位发布了一篇最新的关于指令微调的综述,详细描述指令微调的各方面内容。

本文原文来自DataLearner官方博客:https://www.datalearner.com/blog/1051692954155639
  • 大模型微调简介

  • 指令微调简介

  • 指令微调常用的数据集总结

  • 不同领域的指令微调

  • 高效指令微调技术

大模型微调简介

此前,我们已经介绍了大模型的三类微调技术(实际案例说明AI时代大语言模型三种微调技术的区别——Prompt-Tuning、Instruction-Tuning和Chain-of-Thought:https://www.datalearner.com/blog/1051681306547159)。但实际上,大模型的微调还可以分成很多种。

从微调的参数规模来说,可以简单分为全参数微调和高效参数微调。前者一般是用预训练模型作为初始化权重,在特定数据集上继续训练,全部参数都更新的方法。而后者则是期望用更少的资源完成模型参数的更新,包括只更新一部分参数或者说通过对参数进行某种结构化约束,例如稀疏化或低秩近似来降低微调的参数数量。

如果按照在模型哪个阶段使用微调,或者根据模型微调的目标来区分,也可以从提示微调、指令微调、有监督微调的方式来。本次的综述文章主要就是指令微调的综述。

指令微调简介

指令微调是一种通过在由(指令,输出)对组成的数据集上进一步训练LLMs的过程。其中,指令代表模型的人类指令,输出代表遵循指令的期望输出。这个过程有助于弥合LLMs的下一个词预测目标与用户让LLMs遵循人类指令的目标之间的差距。

指令微调可以被视为有监督微调(Supervised Fine-Tuning,SFT)的一种特殊形式。但是,它们的目标依然有差别。SFT是一种使用标记数据对预训练模型进行微调的过程,以便模型能够更好地执行特定任务。而指令微调是一种通过在包括(指令,输出)对的数据集上进一步训练大型语言模型(LLMs)的过程,以增强LLMs的能力和可控性。指令微调的特殊之处在于其数据集的结构,即由人类指令和期望的输出组成的配对。这种结构使得指令微调专注于让模型理解和遵循人类指令。

总的来说,指令微调是有监督微调的一种特殊形式,专注于通过理解和遵循人类指令来增强大型语言模型的能力和可控性。虽然它们的目标和方法相似,但指令微调的特殊数据结构和任务关注点使其成为SFT的一个独特子集。

指令微调常用的数据集总结

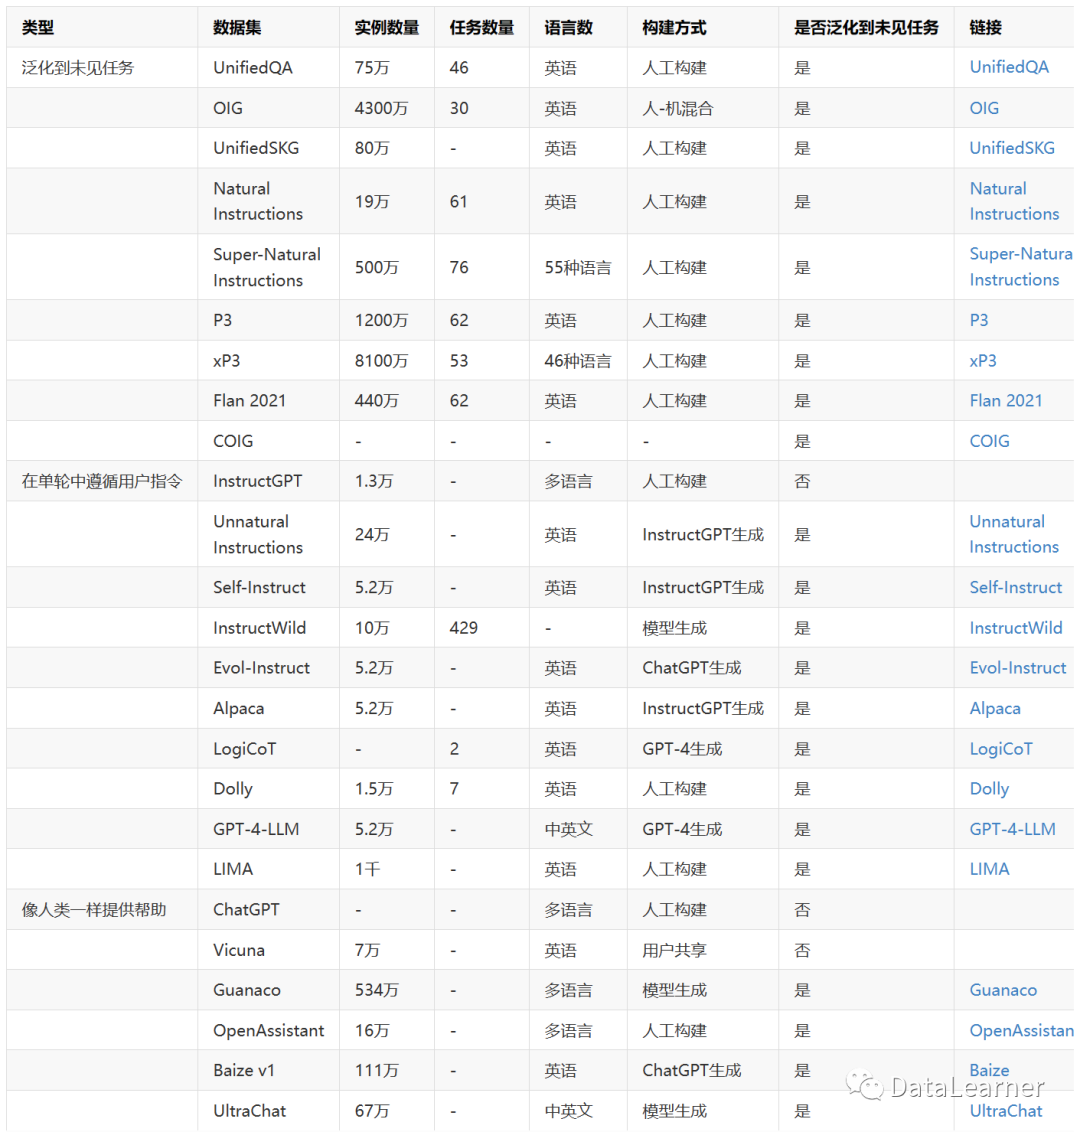
在这篇综述中,作者总结了25个指令微调数据集。并将指令微调的数据集分为以下三大类:

泛化到未见任务
这类数据集通常包含多样化的任务,每个任务都有专门的指令和数据样例。模型在这类数据集上训练后,可以泛化到未见过的新任务上。

在单轮中遵循用户指令
这类数据集包含指令及其对应的响应,用于训练模型单轮回复用户指令。训练后,模型可以理解指令并作出回复。

像人类一样提供帮助
这类数据集包含多轮闲聊对话。训练后,模型可以进行多轮交互,像人类一样提供帮助。

总体来说,第一类数据集侧重任务泛化能力,第二类侧重单轮指令理解能力,第三类侧重连续多轮对话能力。研究人员可以根据所需的模型能力选择不同类型的数据集进行指令调优。

所有的25个用以大语言模型的指令微调数据集列表如下:
不同领域的指令微调

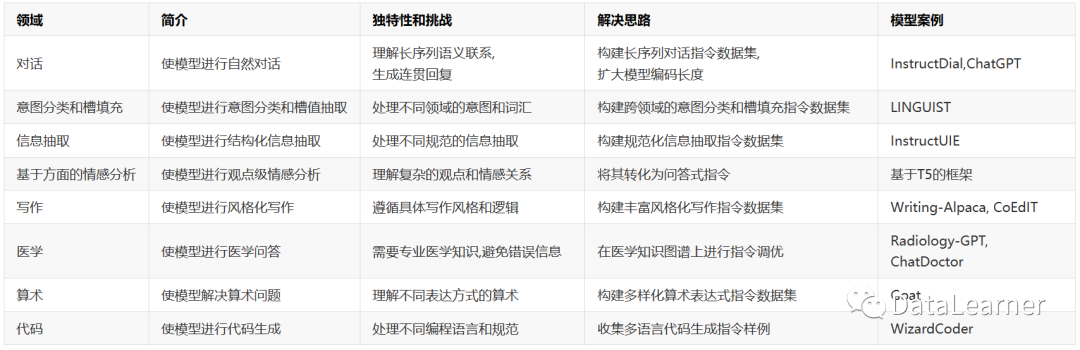
其实,很多领域都有对大模型做指令微调的需求,但是不同领域的指令微调需求可能也有差异。

这篇综述总共总结了8种不同领域的大模型指令微调情况,如下表所示:

好的,已补全所有8个领域的指令调优对比情况:
高效指令微调技术

高效指令微调技术的主要目的在于可以利用一小部分参数的更新来使得模型达到训练效果。其实与有监督学习里面或者大语言模型里面的高校参数微调基本一致。高效微调技术主要包括如下几类:
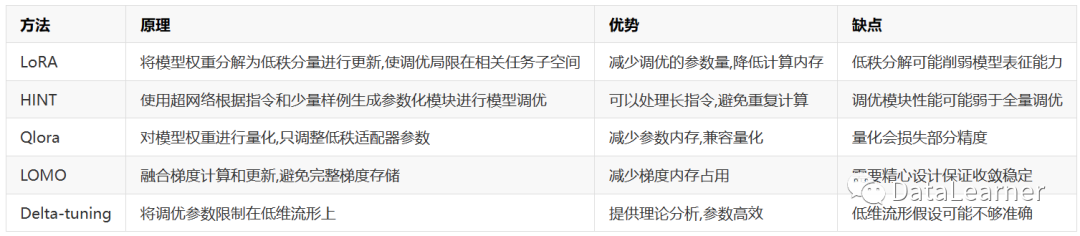
总体来说,当前的高效指令调优技术主要是通过参数量减少、梯度压缩、量化等方式来降低计算和内存消耗。这些方法在降低资源占用方面非常有效,但也存在一定的缺点,如精度损失、收敛稳定性等问题。

下面给大家分享一份2025最新版的大模型学习路线,帮助新人小白更系统、更快速的学习大模型!
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享**

一、2025最新大模型学习路线

一个明确的学习路线可以帮助新人了解从哪里开始,按照什么顺序学习,以及需要掌握哪些知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

L1级别:AI大模型时代的华丽登场

L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的核心原理,关键技术,以及大模型应用场景;通过理论原理结合多个项目实战,从提示工程基础到提示工程进阶,掌握Prompt提示工程。

L2级别:AI大模型RAG应用开发工程

L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3级别:大模型Agent应用架构进阶实践

L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造我们自己的Agent智能体;同时还可以学习到包括Coze、Dify在内的可视化工具的使用。

L4级别:大模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调;并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

整个大模型学习路线L1主要是对大模型的理论基础、生态以及提示词他的一个学习掌握;而L3 L4更多的是通过项目实战来掌握大模型的应用开发,针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

二、大模型经典PDF书籍

书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)

三、大模型视频教程

对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。

四、大模型项目实战

学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。

五、大模型面试题

面试不仅是技术的较量,更需要充分的准备。

在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。


因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享

大语言模型的指令微调(Instruction Tuning)最全综述:从数据集到技术全解析 此前,我们已经介绍了大模型的三类微调技术(实际案例说明AI时代大语言模型三种微调技术的区别——Prompt-Tuning、Instruction-Tuning和Chain-of-Thought:https://www.datalearner.com/blog/1051681306547159)。但实际上,大模型的微调还可以分成很多种。从微调的参数规模来说,可以简单分为全参数微调和高效参数微调。前者一般是用预训练模型作为初始化权重,在特定数据集上继续训练,全部参数都更新的方法。 阅读详情

相关推荐

【LLM大模型】指令微调、peft高效参数微调

LLaMA 是 Meta AI 发布的包含 7B、13B、33B 和 65B 四种参数规模的基础语言模型集合,LLaMA-13B 仅以 1/10 规模的参数在多数的 benchmarks 上性能优于 GPT-3(175B),LLaMA-65B 与业内最好的模型 Chinchilla-70B 和 PaLM-540B 比较也具有竞争力。通过使用与 ChatGLM(chatglm.cn)相同的技术,ChatGLM-6B 初具中文问答和对话功能,并支持在单张 2080Ti 上进行推理使用。

发现问题,并解决问题,批判性思维 1万+

什么是指令微调?如何微调

然后,爸爸给小暗安排了一个任务,让他在动物园里找一种他从没见过的动物,叫斑马,并告诉了小暗有关于斑马的信息:“斑马有着马的轮廓,身上有像老虎一样的条纹,而且它像熊猫一样是黑白色的。与面向plm的指令不同,面向人的指令通常是一些人类可读的、描述性的、段落风格的特定于任务的文本信息,包括任务标题、类别、定义和需要避免的东西等。随着神经网络和预先训练好的语言模型的出现,(ii)。LMs的最终输入可以描述为x 0 = f (x)或f(x,I),即任务不可知的模板f(·)是必需的,但特定于任务的信息I是可选的。

qq_41106932的博客 4394

HTTPS接口测试翻车实录:为什么浏览器能访问而curl报证书错误?

本文深入分析了HTTPS接口测试中浏览器访问正常而curl报证书错误的典型问题。通过对比浏览器、Postman和curl的工具行为差异,结合Nginx日志与Wireshark抓包,揭示了问题根源在于网络架构中HTTPS请求被意外“降级”为HTTP传输,导致SSL握手失败。文章重点探讨了curl工具严格验证机制暴露的`Peer's Certificate issuer is not recognized`错误,并提供了网络配置修正方案与标准化测试流程。

u9v0w的博客 278

【大模型系列】指令微调

大模型系列之指令微调笔记。

靖待的优快云博客 8108

在Windows11下安装完Ubuntu20.04双系统后配置环境的过程

在Windows11下安装完Ubuntu20.04双系统后配置环境的过程 1.NVIDIA驱动检测及安装 2.Anaconda的安装 3.安装cuda、cudnn、pytorch 4.其他报错

aaaccc444的博客 2424

SAP SD跨公司销售IDOC自动记账配置实战指南

本文详细介绍了SAP SD模块中跨公司销售IDOC自动记账的配置实战指南。通过IDOC技术实现集团企业间交易的自动化处理,显著提升财务效率和准确性。文章涵盖前置配置、RFC连接、合作伙伴参数设置及财务科目分配等关键步骤,并提供了常见错误排查和性能优化建议,帮助用户快速掌握这一高效业务流程。

weixin_29284885的博客 769

2025版最新大语言模型的指令微调,零基础入门到精通,收藏这篇就够了_大模型指令

此前,我们已经介绍了大模型的三类微调技术(实际案例说明AI时代大语言模型三种微调技术的区别——Prompt-Tuning、Instruction-Tuning和Chain-of-Thought:https://www.datalearner.com/blog/1051681306547159)。但实际上,大模型的微调还可以分成很多种。从微调的参数规模来说,可以简单分为全参数微调和高效参数微调。前者一般是用预训练模型作为初始化权重,在特定数据集上继续训练,全部参数都更新的方法。

HUANGXIN9898的博客 1296

GPU运维基础知识

常见的GPU型号如NVIDIA Tesla系列(V100、A100)、GeForce RTX系列(3090、4090)和AMD Instinct系列(MI250X)。硬件监控工具包括NVIDIA的nvidia-smi和AMD的rocm-smi,用于实时监控GPU状态、温度、功耗和显存使用情况。NVIDIA和AMD是主流GPU供应商,NVIDIA的CUDA架构和AMD的ROCm生态是核心。GPU包含流处理器、显存、显存带宽等关键组件,不同型号的GPU在计算能力、显存容量和功耗上存在差异。

云原生运维的博客 762

2025版最新大语言模型的指令微调,(非常详细)零基础入门到精通,收藏这篇就够了

此前,我们已经介绍了大模型的三类微调技术(实际案例说明AI时代大语言模型三种微调技术的区别——Prompt-Tuning、Instruction-Tuning和Chain-of-Thought:https://www.datalearner.com/blog/1051681306547159)。但实际上,大模型的微调还可以分成很多种。从微调的参数规模来说,可以简单分为全参数微调和高效参数微调。前者一般是用预训练模型作为初始化权重,在特定数据集上继续训练,全部参数都更新的方法。

Libra1313的博客 1184

OpenClaw人人养虾:接入即时通讯平台Zalo

通过 Zalo Official Account(OA,官方账号)API,可以将 OpenClaw 接入 Zalo,实现面向越南用户的自动化客服和互动。

王国平的博客 437

PINN:当深度学习遇上朗伯-比尔定律

光谱数据处理中引入PINN的三种架构设计

qq_53529450的博客 154

2025版最新如何微调(Fine-tuning)大语言模型?零基础入门到精通,收藏这篇就够了

图片由DALL-E 生成阿里妹导读本文介绍了微调的基本概念,以及如何对语言模型进行微调。从 GPT3 到 ChatGPT、从GPT4 到 GitHub copilot的过程,微调在其中扮演了重要角色。什么是微调(fine-tuning)?微调能解决什么问题?什么是 LoRA?如何进行微调?本文将解答以上问题,并通过代码实例展示如何使用 LoRA 进行微调。

Libra1313的博客 4492

华为OD机考真题 新系统 - 数列求值(Java/Py/C/C++/Js/Go)

华为OD机试真题 新系统【数列求值】,提供C语言、Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解,以及在线OJ模拟做题。华为OD机试真题 【数列求值】多语言题解。

qq_45776114的博客 664

2025版最新大模型微调入门实战,零基础入门到精通,收藏这篇就够了

Qwen2是通义千问团队最近开源的大语言模型,由阿里云通义实验室研发。以Qwen2作为基座大模型,通过指令微调的方式做高精度文本分类,是学习LLM微调的入门任务。在本文中,我们会使用 Qwen2-1.5b-Instruct 模型在 复旦中文新闻 数据集上做指令微调训练,同时使用SwanLab监控训练过程、评估模型效果。采用了Lora方法,所以显存要求不高,10GB左右就可以跑。代码:完整代码直接看本文第5节 或 Github,Jupyter Notebook。

leah126的博客 1270

基于matlab目标雷达横截面建模(附源码)

雷达系统依靠目标反射或散射来检测和识别目标。目标反射越强,雷达接收器返回的回波就越大,从而获得更高的信噪比(SNR)和更高的检测可能性。在雷达系统中,从目标反射的能量由雷达横截面(RCS)决定,定义为sigma代表RCS,R是雷达与目标之间的距离,Es是从目标反射的信号的场强,以及Ei是入射到目标上的信号的场强。通常,目标向各个方向散射能量,RCS是入射角,散射角和信号频率的函数。RCS 取决于目标的形状和构建目标的材料。用于RCS的常用单位包括平方米或dBsm。

珞瑜的博客 3083

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

2025版最新大语言模型进阶:什么是微调?零基础入门到精通,收藏这篇就够了

在当今数字化时代,餐饮企业面临着激烈的市场竞争和不断变化的消费者需求。为了提高运营效率和客户满意度,越来越多的企业开始借助大语言模型进行数据分析和决策支持。然而,通用大语言模型往往无法满足特定行业的需求,这时微调技术便显得尤为重要。不仅可以提升其在特定领域的表现,还能帮助餐饮企业更好地理解市场动态、优化菜单设计和提升客户体验。本文将深入探讨微调大语言模型的必要性、市场上的微调方向以及餐饮企业可以参考的微调策略,旨在为企业提供切实可行的建议和解决方案。

leah126的博客 1162

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

2025版最新大语言模型进阶:什么是微调?(非常详细)零基础入门到精通,收藏这篇就够了

在当今数字化时代,餐饮企业面临着激烈的市场竞争和不断变化的消费者需求。为了提高运营效率和客户满意度,越来越多的企业开始借助大语言模型进行数据分析和决策支持。然而,通用大语言模型往往无法满足特定行业的需求,这时微调技术便显得尤为重要。不仅可以提升其在特定领域的表现,还能帮助餐饮企业更好地理解市场动态、优化菜单设计和提升客户体验。本文将深入探讨微调大语言模型的必要性、市场上的微调方向以及餐饮企业可以参考的微调策略,旨在为企业提供切实可行的建议和解决方案。

Libra1313的博客 1068

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

2025版最新如何微调大语言模型?(非常详细)零基础入门到精通,收藏这篇就够了

本文介绍了微调的基本概念,以及如何对语言模型进行微调。从 GPT3 到 ChatGPT、从GPT4 到 GitHub copilot的过程,微调在其中扮演了重要角色。什么是微调(fine-tuning)?微调能解决什么问题?什么是 LoRA?如何进行微调?本文将解答以上问题,并通过代码实例展示如何使用 LoRA 进行微调。

leah126的博客 887

2025版最新初学者怎么入门大语言模型开发?(非常详细)零基础入门到精通,收藏这篇就够了

Prompt Engineering 涉及为大型语言模型设计有效的输入(Prompts),以引导模型生成所需的输出。这个过程不仅需要精确表达问题或需求,而且要格式化输出以适应特定应用。

leah126的博客 1617

2025版最新大模型微调实战,零基础入门到精通,收藏这篇就够了

大模型微调本身是一件非常复杂且技术难度很高的任务,因此本篇文章仅从零开始,手把手带你走一遍微调大模型的过程,并不会涉及过多技术细节。希望通过本文,你可以了解微调大模型的流程。微调大模型需要非常高的电脑配置,比如GPU环境,相当于你在已经预训练好的基础上再对大模型进行一次小的训练。但是不用担心,本篇文章会使用阿里魔塔社区提供的集成环境来进行,无需使用你自己的电脑配置环境。本次微调的大模型是零一万物的 Yi 开源大语言模型,当然微调其他大模型的过程和原理也有差不多。

Python_0011的博客 1952

2025版最新如何微调大语言模型?零基础入门到精通,收藏这篇就够了

本文介绍了微调的基本概念,以及如何对语言模型进行微调。从 GPT3 到 ChatGPT、从GPT4 到 GitHub copilot的过程,微调在其中扮演了重要角色。什么是微调(fine-tuning)?微调能解决什么问题?什么是 LoRA?如何进行微调?本文将解答以上问题,并通过代码实例展示如何使用 LoRA 进行微调。

Javachichi的博客 1484

2025版最新提升大语言模型的三大策略,零基础入门到精通,收藏这篇就够了

在提升大语言模型(LLM)性能的过程中,我发现了三种高效的策略:提示工程、检索增强生成(RAG)和参数高效微调(PEFT)。这三者各有特点,能根据不同需求大幅提升模型表现。首先,提示工程通过优化提问方式,能够显著提高模型的输出质量。这是最简单且立竿见影的方式,尤其适合任务明确且数据量不大的场景。接着,RAG通过引入外部知识库,使得模型能够“查找”最新或领域特定的信息,增强回答的准确性。最后,PEFT利用LoRA等方法,在不修改大部分模型参数的情况下进行高效微调,节省资源同时提升定制化能力。

Javachichi的博客 1610

2025版最新手把手带你零基础快速入门大模型微调,(非常详细)零基础入门到精通,收藏这篇就够了

微调大模型通常需要非常高的电脑配置,比如GPU环境,相当于你在已经预训练好的基础上再对大模型进行一次小的训练,但是咱们很多伙伴的电脑配置可能有些困难,不过不用担心,本次咱们使用阿里魔塔社区提供的集成环境来进行,无需使用你自己的电脑配置环境,只需要一个浏览器即可。本次微调的大模型是零一万物的Yi开源大语言模型,当然微调其他大模型的过程和原理也有差不多。这里说明一下,阿里魔塔社区对于新用户提供了几十小时的免费GPU资源进行使用,正好学习一下大模型的微调****。话不多说,直接开始。

Javachichi的博客 1272
上一篇: 维护社会安全有哪些主要任务?从零基础到精通,收藏这篇就够了!
下一篇: 如何建设系统的安全风险管控体系,从零基础到精通,收藏这篇就够了!
程序员_大白
博客等级 码龄5年 1万+粉丝 4001原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

