数据库基础问答(二) —— 为什么like不会像范围查询那样使索引失效

携程2016Java研发笔试题深度解析:从基础到实战 在Java后端开发者求职与自查过程中,扎实的编程基础与源码级理解始终是核心竞争力的基石。从String常量池到HashMap的线程安全,从volatile的可见性到synchronized的原子性,这些看似基础的知识点恰恰决定了系统在高并发场景下的稳定性与性能表现。工程实践中,无论是排查线上问题还是优化SQL索引,都需要开发者深入理解底层原理,而不仅仅是调用API。通过对一套经典Java研发笔试题的剖析,可以系统梳理集合框架、多线程、数据库索引等高频考点,帮助开发者识别自身知识盲区,提升用工程化思维解决实际 阅读详情

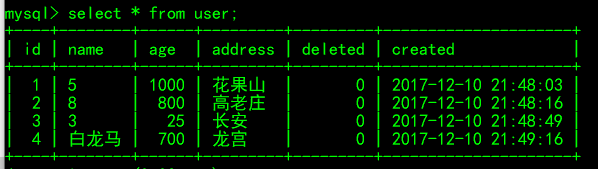
先看例子:

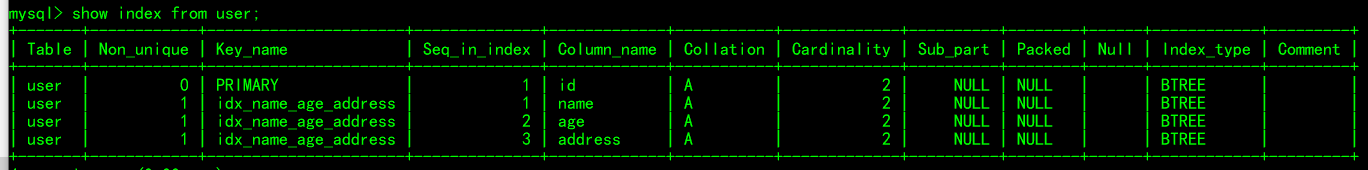
建立了name_age_address组合索引:
最普通的全匹配索引查询:

最左匹配不用多说;

name_age_address相当于建立了三个索引:

name索引,name_age索引,name_age_address索引。

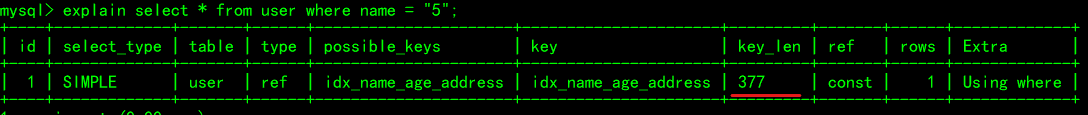
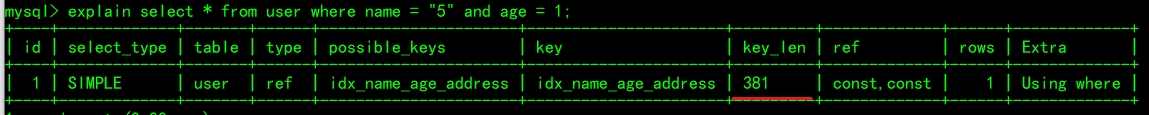
可以分别看一下长度:

name —— 377:
name_age —— 381:
name_age_address —— 533:

where的限制条件只能只用这“三个”(其实还是一个)索引中的一个,要么就完全没有使用(没有符合最左匹配原则),如:

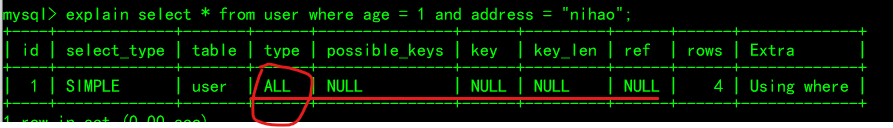
没有name,只有age_address,索引失效:
漏掉age,只有name_address:
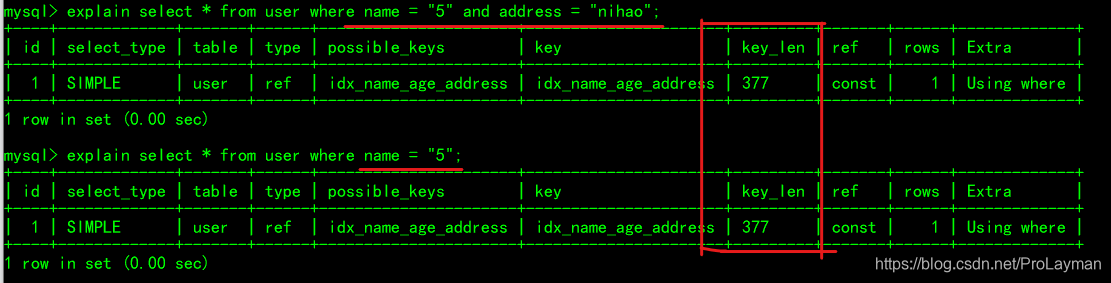
可以看到,由于age缺失,索引到age列即失效,即使用where name = "5"和where name = "5" and address = “nihao”是一样的。这也是了解了机制之后,我们才能更好地利用MySQL的例证之一。


那么除了缺失,其他什么情况会使索引匹配终结呢?

一个重要的一项是:范围查询
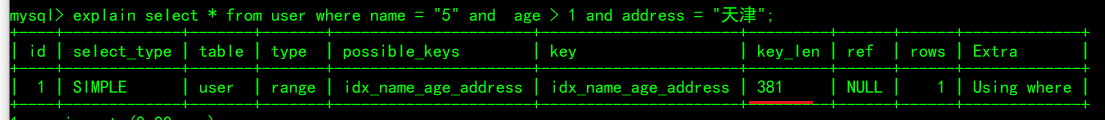
可以看到,name_age_address索引的age使用范围限制条件时,利用的索引长度只有381而不是533,即使用的是name_age索引,到age就失效了。原因很好理解,考虑B+树的结构,数据的相对大小是像“字典序”一样,从左往右定义的,举个例子,B+树的最后一层(叶子层),(name , age, address)的三元组,("a", 11, "上海")必然是在 ("b", 1, "北京")左侧的。但是(XXX, 11, "上海")和(YYY, 1, "北京")(注意name是未知)的相对顺序是不定的。

不过应该注意到,MySQL的查询是寻找代价最小的执行计划,不是说理论上可以利用的索引就一定利用了,用上面的理论,看下面的例子:
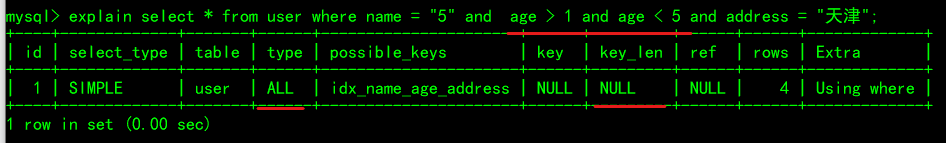
按说age > 1 and age < 5 和 age > 1没有本质区别,这里可以看到根本就没有使用任何索引,退一步讲,就算使用不了name_age索引,至少也可以使用name索引,在name_age_address B+树的叶子层拿到一个范围的数据后,带着该id去主表中拿数据,再使用age > 1 and age < 5 and address = "天津"进行普通的where筛选。现实是,一个索引都没有用,直接走全表扫描。目前不知道是MySQL在编译阶段就确定了不走任何索引(看见闭区间直接不走blablabla),还是查询优化器计算得出走索引带来的优化太小(name的筛选条件过滤得太少),这样得到的成本还不如直接走全表扫描(省去了查找name_age_address  索引树的过程)。


当然,这里都不是本文要讲的重点 —— like不像范围查询,竟然可以继续进行索引匹配。

看演示:
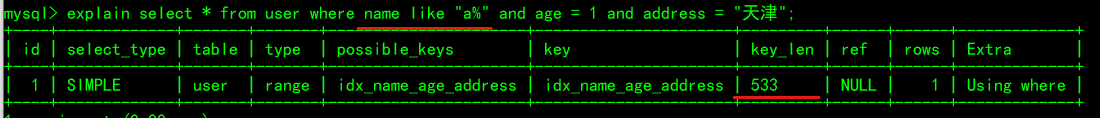
按说like就像查字典一样,name like "a%"只会匹配到所有name以a开头的记录,接下来索引匹配就终结了,就像上面 age > 1就不能继续匹配address字段一样,在叶子层取了n个小区间,每个小区间内都满足name = "5" and age > 1,但是内部的address没有进行判断了,直接拿着这n个小区间内的id去主表中取记录,再对这些记录进行过滤(address = "天津")。更不要说age > 1 and age < 5时,直接完全不走扫描。

但这里的name like "a%"竟然一直匹配到索引结束,即 name like "a%"会直接找到当前节点的name首字母为a的节点,以该节点为根的B+树必然全部满足条件,此时对该B+树使用age_address索引即可。

那么按这个理论,name = "5" and age > 1可以完全匹配索引吗?

不能,注意,name like "a%",这里的like "a%"其实表现在B+树上并不是一个范围值,而是一个确定值,建立B+树时,一定以单个字符为单位建分支节点,如ab和ac一定是同层不同节点。

按说age也可以啊。。。不然age > 5是怎么实现利用的。。。。


另外注意,name like “%5”,“%5%”都是不能利用索引的,而name like 5可以。

2023贝壳Java春招笔试解析:并发、JVM与数据库实战考点 Java工程师面试中,并发编程与JVM内存管理是区分基础扎实与否的核心分水岭,而大厂笔试题往往将这些知识点与实际业务场景深度绑定。本文以贝壳找房春招Java笔试卷为例,从集合类与线程池参数计算出发,剖析HashMap在JDK 1.8中的优化、volatile的可见性与原子性边界、MySQL索引失效的典型场景以及Redis缓存穿透应对策略。通过对Bean生命周期与循环依赖的解读,揭示Spring框架在工程落地中的设计取舍。文章还讨论了快速排序等算法题的边界处理,并给出从错题复盘中延伸面试追问的技巧,旨在帮助求 阅读详情

相关推荐

PostgreSQL+pgvector向量数据库实战:从语义搜索到生产部署

向量数据库是将非结构化数据(如文本、图像)转化为可计算向量并支持相似性搜索的技术基础设施。其核心原理在于通过嵌入模型(如Amazon Titan Embedding)将语义映射到高维空间,再借助高效索引(如IVFFlat)实现近似最近邻检索。相比传统关键词匹配,它能理解‘表格数据’与‘快速上手’之间的语义关联,显著提升RAG、智能客服、知识库搜索等场景的召回准确率。技术价值体现在ACID事务保障、标量+向量混合查询、与现有PostgreSQL生态无缝集成等工程优势。本文聚焦pgvector这一轻量、可靠、易

anvt77205的博客 346

like使用索引如何避免失效

1、创建表 2、准备数据 3、在name和address上创建索引,不对fav创建索引 3.1.1 使用like模糊查询全部字段的的情况 a、当两边使用%时: 结果是全表扫描,索引失效 b、当左边使用%时: 结果也是全表扫描,索引失效 c、当右边使用%时 结果是range,索引生效 由上述三种情况:当使用like模糊查询所有字段(包括不包含在索引列中的字段)时,只有%放在右边索引...

Scouldfield的博客 2380

面试数据库篇(mysql)- 07索引创建原则与失效及优化

1). 针对于数据量较大,且查询比较频繁的表建立索引。2). 针对于常作为查询条件(where)、排序(order by)、分组(group by)操作的字段建立索引。3). 尽量选择区分度高的列作为索引,尽量建立唯一索引,区分度越高,使用索引的效率越高。4). 如果是字符串类型的字段,字段的长度较长,可以针对于字段的特点,建立前缀索引。5). 尽量使用联合索引,减少单列索引,查询时,联合索引很多时候可以覆盖索引,节省存储空间,避免回表,提高查询效率。

Emperor_CJ的博客 289

《MySQL》索引篇:使用`like %x`索引就一定会失效吗?

使用`like %x`索引就一定会失效吗?

m0_56199449的博客 613

数据库原理实战:从ER建模到索引优化与事务恢复

数据库原理不只是理论考试,而是每个后端工程师必须掌握的工程能力。从ER建模到SQL编写,从索引优化到事务隔离,原理决定实践。本文以学生选课系统为例,演示第三范式建表、字段类型选型、EXPLAIN慢SQL定位、B+树索引失效场景、ACID与WAL日志机制,以及基于mysqldump和binlog的备份恢复演练,帮助读者建立从数据库设计到故障恢复的完整认知。适用于数据库课程设计、后端面试复习和生产环境排障。

weixin_34038293的博客 321

用MySQL构建中文词典数据库:从汉字到歇后语的设计实践

在中文信息处理领域,词典类数据的高效组织与检索始终是工程实践中的典型难题。关系型数据库以其稳定的事务支持和成熟的索引机制,为多类型结构化词条提供了可靠底座。通过合理设计表结构、建立统一检索索引、实施数据清洗与ETL流程,能够有效解决汉字、词语、成语和歇后语等多源异构数据的存储与查询效率问题。本文从数据库建模的基本原理出发,梳理了一整套基于MySQL的词典库落地方法,涵盖模糊查询优化、全文索引应用及并发一致性保障,适用于语文学习工具、文本检索系统或相关课程项目,帮助研发者快速搭建可扩展的中文语言资源数据库。

weixin_34128839的博客 466

MySQL 使用 like “%x“,索引一定会失效吗?

大家好,我是小林。 昨天发了一篇关于索引失效的文章:谁还没碰过索引失效呢 我在文末留了一个有点意思的思考题: 这个思考题其实是出自于,我之前这篇文章「一条 SQL 语句引发的思考」中留言区一位读者朋友出的问题。 很多读者都在留言区说了自己的想法,也有不少读者私聊我答案到底是什么? 所以,我今晚就跟大家聊聊这个思考题。 题目一 题目一很简单,相信大家都能分析出答案,我昨天分享的索引失效文章里也提及过。 **「题目 1 」**的数据库表如下,id 是主键索引,name 是二级索引,其他字段都是非索引字段。

小林coding 8769

别再纠结VS还是VSCode了!新手C#环境搭建保姆级指南(含.NET Core安装验证)

本文为C#新手提供Visual Studio与VS Code的深度对比及环境搭建指南,涵盖.NET Core安装验证、工具选择决策框架及实战配置技巧。帮助开发者根据项目需求选择合适工具,快速搭建高效开发环境,提升编码效率。

weixin_30455023的博客 561

MySQL问答200

本文涵盖MySQL全栈面试核心内容,包括:基础概念(关系型数据库特性、体系结构);存储引擎对比(InnoDB/MyISAM);索引原B+树、聚簇索引)与优化策略;事务ACID与隔离级别实现;锁机制(行锁、间隙锁)与MVCC原理;日志系统(redo/undo/binlog);SQL优化与执行计划分析;高可用方案(主从复制、分库分表);InnoDB底层机制(Buffer Pool、Checkpoint);以及MySQL 8.0新特性。

weixin_72753562的博客 827

【Unity3D】RTS Engine 笔记一

RTS Engine 中配置一个新场景, 初步认识GameManager、设置地形以及配置地形网格搜索

ViYeye的博客 1648

Cadence SKILL 语言实战指南:从函数列表到高效自动化脚本

本文是Cadence SKILL语言实战指南,旨在帮助芯片设计工程师从掌握核心函数列表出发,高效构建自动化脚本。文章详细解析了数据处理、数据库访问、流程控制及错误处理四类关键函数,并通过版图层批量修改与参数化单元生成两大实战场景,演示如何将函数组合成解决实际问题的自动化方案,从而显著提升Virtuoso环境下的工作效率。

beta5的博客 705

SQL 基础面试考点总结

本文系统总结了SQL面试的七大核心考点,包括基础概念、查询语法、聚合分组等高频内容。重点解析了SQL执行顺序、NULL判断、模糊查询索引失效等易错点,通过典型例题对比正确与错误写法。特别强调WHERE与HAVING的区别、EXISTS与IN的性能选择,以及分组统计的规范写法。文章提炼了"通配符%放前索引失效""大表优先EXISTS""WHERE行过滤→GROUP BY→HAVING组过滤"等面试口诀,帮助考生快速掌握80%的SQL面试题型,适合数据开发、分析等岗位求职者重点复习。

basketball616的博客 672

实例讲解Simulink应用层开发CAN报文解包及CAN信号设置方法

本文通过讲解MCU CAN解包模块的模块设置、输入输出信号的设置及仿真测试验证,说明了CAN解包模块的设置方法、CAN解包模块输入输出信号的设置方法以及CAN解包模块的仿真测试及修正方法。在模型搭建过程中,建议养成一种搭建完成仿真测试验证的习惯,在模块阶段发现错误,解决错误,避免在后期模块集成之后报出大量错误,增加解决错误的工作量和难度。希望通过本文的介绍能给相关技术人员带来一些参考和帮助。

qq_43011586的博客 5680

Qwen3-14B真实效果分享:Chainlit界面中生成的10个高质量技术问答案例

本文介绍了如何在星图GPU平台上自动化部署Qwen3-14b_int4_awq镜像,实现高效技术问答功能。该量化模型通过AWQ技术优化,在保持高质量文本生成能力的同时降低资源消耗,特别适用于编程问题解答、系统设计咨询等专业场景。通过Chainlit界面,用户可快速获得准确、结构化的技术问题解答。

weixin_35935514的博客 17

深入解析 RLHF(Reinforcement Learning from Human Feedback)

随着人工智能(AI)技术的快速发展,大规模语言模型(如 OpenAI 的 GPT、Anthropic 的 Claude 等)已经能够生成高质量的文本。RLHF 是一种基于强化学习(Reinforcement Learning, RL)的优化方法,它结合人类反馈(Human Feedback)来训练奖励模型(Reward Model, RM),进而优化语言模型的生成策略。整个强化学习的目标是找到最优策略 π∗\pi^*π∗,使得模型在与环境交互的过程中,最大化累积奖励。RLHF 是一种结合强化学习(RL)

lqq 1771

高德地图-获取定位-失败原因-浏览器定位异常场景

提示:也能实现,但是需要https协议,而且请求时间很长,要么你用梯子,还是不太合适.

shi15926lei的博客 4206

MySQL索引的分类、何时使用、何时不使用、何时失效?

MySQL每次查询只使用一个索引。与其说是“数据库查询只能用到一个索引”,倒不如说,和全表扫描比起来,去分析两个索引B+树更加耗费时间。所以where A=a and B=b这种查询使用(A,B)的组合索引最佳,B+树根据(A,B)来排序。主键,unique字段;和其他表做连接的字段需要加索引;在where里使用>,≥,=,<,≤,is null和between等字段;使用不以通配符开始的like,where A like ‘China%’;聚集函数MIN(),MAX()中的字段;

2401_84009215的博客 427

Python爬虫-爬取汽车之家各品牌周销量榜数据,进行数据分析

本文是该专栏的第57篇,后面会持续分享python爬虫干货知识。本文中,笔者已经整理20篇汽车平台相关的爬虫项目案例。对此感兴趣的同学,可以直接翻阅查看。同样,笔者在本文中将继续以汽车之家平台为例子。基于Python爬虫,实现批量爬取“各品牌周销量榜单”的数据。废话不多说,具体实现思路和详细逻辑,笔者将在正文结合完整代码进行详细介绍。接下来,跟着笔者直接往下看正文详细内容。(附带完整代码)

Python进阶专栏《爬虫实战进阶》,《Pyppeteer从入门到精通》原创作者 365

LatticeDB:融合图、向量与全文索引的嵌入式数据库探索

嵌入式数据库以进程内运行和本地文件存储为特点,适合单机与离线环境。属性图模型用节点、边和属性表达复杂关系,而原生向量索引和全文索引则分别支撑语义相似检索与关键词命中。当三者融合在同一存储引擎中,数据只需写入一份,便可在图遍历、向量召回和文本搜索间自由切换,避免了多系统数据同步的一致性问题。这种能力在知识图谱、本地RAG应用、嵌入式设备数据组织等场景中尤为实用。LatticeDB正是这样一款将嵌入式属性图数据库、原生向量索引与全文索引组合在一起的新项目,为中小规模混合检索提供了新的技术路径。

weixin_34056162的博客 802

24、中性原子量子计算:原理、方法与实验

本文系统介绍了中性原子量子计算的原理、方法与实验进展。重点阐述了利用碱金属原子作为量子比特,通过磁光阱、光偶极阱和光晶格等技术实现原子捕获与控制的方法。同时,详细分析了单量子比特门操作和量子态工程的实现手段,并总结了相关实验结果与未来发展方向。该技术路线为构建大规模量子计算系统提供了可行方案。

ol789012的博客 243

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

2016京东技术岗笔试题解析:从数据结构与算法看校招备考

互联网技术岗笔试中,数据结构与算法始终是核心考察模块,二叉树遍历、排序算法复杂度、哈希冲突处理等基础概念,不仅决定笔试成绩,更映射候选人解决实际问题的能力。理解这些概念的原理——如前序中序推导二叉树结构、基本有序序列下插入排序优于快排——能帮助求职者建立系统化知识框架。结合操作系统、计算机网络、数据库等基础科目,技术岗笔试本质上是在检验完整的知识体系与工程实践思维。从算法题到场景化复习法,再到索引失效、死锁等高频考点,本文通过对2016年京东实习生招聘技术岗选择题B卷的逐题精讲与失分点复盘,为校招求职者提供

weixin_30437847的博客 414

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

技术岗电话面试通关指南:项目深挖与基础考点全解析

在分布式系统与高并发场景日益普及的今天,技术面试对候选人的工程实践能力与底层原理理解提出了更高要求。电话面试作为低成本高杠杆的初筛工具,其核心考察逻辑在于验证技术底子真实性、沟通表达清晰度以及项目经历的可信度。从计算机基础原理切入,面试官重点关注编程语言特性、数据库索引与事务、网络协议等高频考点,同时通过项目深挖验证候选人在缓存方案、消息队列削峰等实际场景中的技术选型与取舍能力。掌握STAR+技术讲述结构、场景化答题方法以及边界意识表达,能够显著提升在电话面试中的通过率,为后续现场面试环节奠定坚实基础。

weixin_33755649的博客 473

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

RDS MySQL AI助手:开箱即用的数据库智能运维实践

数据库智能运维(AIOps)正从概念走向落地,其核心在于将DBA经验工程化为可感知、可决策、可执行的自动化能力。基于MySQL性能优化、慢查询诊断、DDL变更风控等基础技术场景,AI助手通过动态基线异常检测、SQL指纹聚类、知识图谱驱动建议等机制,实现对索引失效、JOIN顺序错误、函数导致全表扫描等典型问题的精准识别与结构化响应。相比通用大模型,它聚焦数据库垂直领域,依托RDS内核探针与十年运维规则沉淀,在故障定位、性能调优、变更预检等高频场景中显著降低认知负荷与操作风险,成为企业数据库自治演进的关键技术杠

weixin_34121304的博客 309

2018 CVTE秋招内推一面面经

项目做过什么Web项目? 大二的时候接了一个其他学院的外包,在实验室里面做后台,主要管理数据库的东西。数据库 用的什么数据库 MySQL 有那些常见数据类型 VARCHAR, CHAR, TEXT, BIGINT,INT等 VARCHAR和CHAR的区别 VARCHAR不定长,CHAR是定长的 INT(5) 和 INT(11)的区别 int(M) M指示最大显示宽度。最大有效显示宽

github_39312083的博客 1万+
上一篇: 数据库基础问答(一) —— 为什么B+树更适合做文件索引和数据库索引
下一篇: 高性能MySQL(3th)(第六章 sql优化) —— 07 执行引擎层面的连接运算
ProLayman
博客等级 码龄10年 105粉丝 192原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值