PYSpark环境构建总结

Pyspark-windows环境构建 Pyspark windows开发环境构建 windows开发环境构建 windows安装C:\hadoop-2.6.0 windows安装spark的版本:spark-2.3.2-bin-hadoop2.6.tgz注意spark的版本,更高版本的Spark需要resource模块的支持,2.3.2不需要: 降低版本解决:No module named ‘resource’ 的问题 参考链接:h... 阅读详情

一、需要的软件及版本

    • jdk版本:1.8
    • spark 版本:-2.4.0-bin-hadoop2.7
    • scala版本:2.12 (可选)
    • hadoop版本:2.7 ====另外需要
    • python版本:3.7 或者anaconda
    • pyspark以及py4j
    • pycharm的安装,暂时用社区版吧

二、环境变量配置:

JAVA_HOME=C:\gyhProgramFiles\jdk\jdk8

SPARK_HOME=C:\gyhProgramFiles\spark-2.4.0-bin-hadoop2.7

HADOOP_HOME=C:\gyhProgramFiles\hadoop-2.7.7

SCALA_HOME=C:\gyhProgramFiles\scala-2.12.8

PYTHON_PATH=%SPARK_HOME%\python;%SPARK_HOME%\python\lib\py4j-0.10.7-src.zip

PATH=.;%JAVA_HOME%\bin;%JAVA_HOME%\jre\bin;%SPARK_HOME%;%SPARK_HOME%\bin;%SPARK_HOME%\sbin;%SCALA_HOME%\bin;%HADOOP_HOME%\bin;%HADOOP_HOME%\sbin;C:\gyhProgramFiles\Python\Python37\;C:\gyhProgramFiles\Python\Python37\Scripts\;%USERPROFILE%\AppData\Local\Microsoft\WindowsApps;%PyCharm Community Edition%;

三、安装注意事项:

1、spark依赖scala,scala依赖jdk,所以scala和jdk都要安装;jdk尽量用1.8的。别用11;

2、spark和hadoop的版本要注意尽量匹配;

3、spark启动spark-shell的时候会报错winutil.exe的错误,解决方法是在安装完hadoop后下载相关文件替换hadoop下面的bin目录里:

4、pyspark和py4j是否需要单独安装??有的文件说只要安装完spark了,并配置了PATH=%SPARK_HOME%;%SPARK_HOME%\bin;%SPARK_HOME%\sbin; 了就可以用pyspark了。但大多数的帖子里是说要单独安装:   pip3 install py4j --proxy=proxy.cmcc:8080      pip3 install pyspark --proxy=proxy.cmcc:8080  

另外:py4j也可以:在pycharm上的project interpreter上下载py4j 

5、注意:spark要链接mysql,需要把 链接jar包  放到spark/jars 目录底下。在spark_en.sh里面配置的不起作用。

6、以上安装后用了在pycharm里面调试程序时候,不需要事先手动启动spark,直接运行程序即可。

四、pycharm集成spark的操作步骤

第一个地方:打开RUN->Edit Configurations ;添加  SPARK_HOME和PYTHONPATH等;

SPARK_HOME为spark的绝对路径;PYTHONPATH为spark的绝对路径下的python目录;

即:SPARK_HOME=C:\gyhProgramFiles\spark-2.4.0-bin-hadoop2.7

PYTHONPATH=C:\gyhProgramFiles\spark-2.4.0-bin-hadoop2.7\python

另外JAVA_HOME不设置的话会报错:Java not found and JAVA_HOME environment variable is not set.

HADOOP_HOME不设置的话会报错:Failed to locate the winutils binary in the hadoop binary path


第二个地方:在setting==》perferences中的project structure中点击右边的“add content root”,添加py4j-some-version.zip和pyspark.zip的路径(这两个文件都在Spark中的python/lib文件夹下)

有很多帖子没有执行这个操作就可以,但我必须这样操作才行。


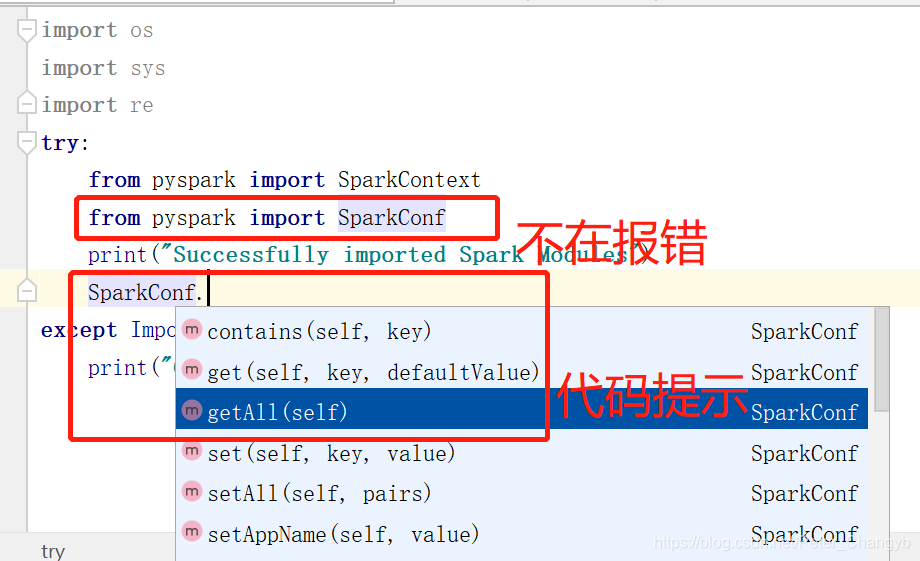
第三个地方:拷贝spark下的两个目录到python目录下,据说这样能实现在pycharm里面的代码自动补全功能

效果:
 

五、测试

from __future__ import print_function

from pyspark.sql import SparkSession


def json_dataset_example(spark):
    sc = spark.sparkContext
    path = "C://people.json"
    peopleDF = spark.read.json(path)
    peopleDF.printSchema()
    peopleDF.createOrReplaceTempView("people")
    teenagerNamesDF = spark.sql("SELECT name FROM people WHERE age BETWEEN 13 AND 19")
    teenagerNamesDF.show()

def jdbc_dataset_example(spark):
    myDF = spark.read \
        .format("jdbc") \
        .option("url", "jdbc:mysql://10.1.4.64:3306/myd?characterEncoding=gbk") \
        .option("dbtable", "gyh_menzhen") \
        .option("user", "root") \
        .option("password", "zhaowei") \
        .load()

    myDF.createOrReplaceTempView("gyh_menzhen")
    spark.sql("select count(*) from gyh_menzhen ").show()

if __name__ == "__main__":
    spark = SparkSession.builder.appName("Python Spark SQL data source example").getOrCreate()
    ##json_dataset_example(spark)  ##############################################################
这里测试成功
   
jdbc_dataset_example(spark)  ##################################这里连接数据库测试报错:py4j.protocol.Py4JJavaError: An error occurred while calling o32.load.

: java.sql.SQLException: No suitable driver
    spark.stop()

####################测试证明这个错误需要把 mysql的链接jar文件放到  spark安装目录下的jars文件夹下面。像有的帖子说在spark_env.sh里面加入export SPARK_CLASSPATH=C:\gyhProgramFiles\mysql-connector-java-5.1.35.jar;$SPARK_CLASSPATH  好像从没有成功过。

 

【Python】PySpark 数据处理 ② ( 安装 PySpark PySpark 数据处理步骤 构建 PySpark 执行环境入口对象 )_pip install pyspark 不知道你们用的什么环境,我一般都是用的Python3.6环境和pycharm解释器,没有软件,或者没有资料,没人解答问题,都可以免费领取(包括今天的代码),过几天我还会做个视频教程出来,有需要也可以领取~给大家准备的学习资料包括但不限于:Python 环境、pycharm编辑器/永久激活/翻译插件python 零基础视频教程Python 界面开发实战教程Python 爬虫实战教程Python 数据分析实战教程python 游戏开发实战教程Python 电子书100本。 阅读详情

相关推荐

基于YARN集群构建运行PySpark Application

作者:Yanjun Spark Application可以直接运行在YARN集群上,这种运行模式,会将资源的管理与协调统一交给YARN集群去处理,这样能够实现构建于YARN集群之上Application的多样性,比如可以运行MapReduc程序,可以运行HBase集群,也可以运行Storm集群,还可以运行使用Python开发机器学习应用程序,等等。 我们知道,Spark on YARN又分为c

36大数据 4088

pyspark基础学习——环境配置

python在代码的编辑上具有简单易懂的效果,而spark在处理大数据的功能在行业内已经得到了广泛的应用,如今我们可以通过python语句来实现spark的相关功能,本文提供pyspark的安装方法,请大家自行取用............

qq_55054198的博客 5049

如何在PySpark中调用Scala/Java代码

前言 虽然有充分的理由使用Python API开发Spark应用程序,但不可否认的是Scala是Spark的原生语言,有一些功能或第三方库并没有直接提供python版本。 那么当我们想要使用一些PySpark不支持的功能,或者只是想在Python应用程序中使用Scala库该怎么办呢? 下面的示例展示了如何在PySpark应用程序中调用Scala代码。 示例 Pyspark在解释器和JVM之间建立了...

Lestat.Z.的博客 2706

pyspark集群环境中jdk版本不兼容,python无相应模块的包的解决办法

问题:在某些情况下,我们会用到其他厂商的大数据平台,而我们是没有相关管理权限的,但是集群和我们已有的代码所需要的环境存在差异,所以我们要向集群设置我们自己的运行环境的参数等,主要解决方案如下 1、对于pyspark,首先我们需要一个我们的相关的所有包的python虚拟环境,这里推荐anaconda的虚拟环境,里面包含很多科学计算的模块便于数据分析使用,在任意一台能联网的机器上创建一个con...

maketubu7的博客 1796

Pyspark案例实战

1.了解什么是Spark、PySpark2.了解为什么学习PySpark3.了解课程是如何和大数据开发方向进行衔接Spark是什么Apache Spark是用于大规模数据处理的统一(unified)分析引擎简单来说,Spark是一款分布式的计算框架,用于调度成百上千的服务器集群,计算TB、PB乃至EB级别的海量数据Spark作为全球顶级的分布式计算框架,支持众多的编程语言进行开发。而Python语言,则是Spark重点支持的方向。

weixin_50911515的博客 950

大语言模型在建筑规范自动化合规审查中的微调策略与规模效应实践

大语言模型(LLM)通过在海量文本数据上预训练,具备了强大的语言理解和生成能力。其核心原理是基于Transformer架构,通过自注意力机制捕捉长距离依赖关系。在工程实践中,为了将这种通用能力适配到建筑、法律、金融等高度专业化的垂直领域,通常需要采用领域微调技术。微调通过使用特定领域的高质量指令数据对模型参数进行更新,使其掌握专业术语、逻辑规则和任务范式,从而解决通用模型在专业场景下知识匮乏和“幻觉”问题。结合检索增强生成(RAG)技术,将动态外部知识库作为模型的“参考手册”,能进一步提升事实准确性并降低幻

weixin_30667831的博客 369

jdk版本与各软件版本之间的关系

jdk版本与tomcate版本、servlet关系。jdk版本与eclipse版本关系。

xiaozaq的博客 828

FeynRules的上手使用3--运行

FeynRules的运行 接上两篇,在我们正确的设定模型参数和拉氏量之后,就可以运行FeynRules来推导费曼规则。 装载文件 首先需要设定FeynRules文件所在位置,并装载FeynRules模块: $FeynRulesPath = SetDirectory[ ] << FeynRules` 接下来是装载写好的模型文件: LoadModel[ < file.fr >, < file2.fr >, … ] 模型文件后缀为".fr",可以分几块构成。模型描述可以写在

cool_bot的博客 1076

py4j实现python与java通信环境配置及实例

py4j的安装 在pycharm中调试好基本配置后,安装py4j,然后找到py4j源文件的位置(一般在anaconda创建的python模拟器中),然后复制这个文件到桌面,并改名为py4j。 安装jdk 这部分网上教程很多,大家按照网上流程安装即可,选择合适的版本(我装的jdk11)。 jdk安装教程 eclipse安装并为其配置jdk、Tomcat eclipse为免安装软件,解压后打开eclipse.exe即可 eclipse安装教程 加压完成后打开,设置工作区路径,开始配设置jdk环境 eclips

onlyyyyyyee的博客 1670

历年北京理工大学复试专业综合题

。

A place to record sth. 2万+

嵌入式人工智能(18-基于树莓派4B的继电器JQC-3FF-S-Z)

本次实验的输出端控制不会接强电,就用LED灯来模拟即可,由于我那个流水灯模块是低电平点亮,所以接线稍有不同,同学们注意。只有继电器吸合,输出端的NO与COM就导通,给LED低电平然后就亮,否则继电器断开,NO与COM不导通,LED不亮。原理都一样,控制电流的接通与断开,这个模块看起来还简单点,毕竟还有2个指示灯,下端IN如接上电源红灯亮,继电器动作有电流通过绿灯亮。在实际应用中,可以通过编程控制继电器的通断状态,例如在Python编程中设置继电器模块的通断时间,从而实现自动化控制。

u010152658的博客 2533

hadoop集群搭建、spark集群搭建、pyspark搭建(linux+window)

linux和window上安装pyspark库。

lfx1997的博客 2689

STM32F103 RTC闹钟唤醒Stop模式的EXTI17中断实现

本文详细介绍了STM32F103如何通过RTC闹钟触发EXTI17中断实现从Stop模式的高效唤醒。针对低功耗应用场景,提供了完整的硬件配置、CubeMX设置及代码实现方案,包括时间格式转换、中断处理和功耗优化技巧,帮助开发者可靠实现定时唤醒功能。

ol78901234的博客 231

【Python】PySpark 数据处理 ② ( 安装 PySpark | PySpark 数据处理步骤 | 构建 PySpark 执行环境入口对象 )

一、安装 PySpark 1、使用 pip 安装 PySpark 2、国内代理镜像 3、PyCharm 中安装 PySpark 二、PySpark 数据处理步骤 三、构建 PySpark 执行环境入口对象 四、代码示例

让 学习 成为一种 习惯 ( 韩曙亮 の 技术博客 ) 1万+

ESP32蓝牙配网实战:微信小程序中的blufi协议实现与优化

本文详细介绍了在微信小程序中实现ESP32蓝牙配网的实战经验,重点解析了blufi协议的应用与优化。内容涵盖从开发环境配置、协议帧格式解析,到小程序端蓝牙通信、数据转换的核心步骤,并提供了配网状态机设计、错误处理及性能调优等进阶方案,旨在帮助开发者高效、稳定地完成物联网设备配网功能开发。

weixin_29159613的博客 460

unity从3D升级到urp管线,打包ab包后,材质全部变紫色

确保材质中的被转换为 URP 兼容的着色器。在打包 AssetBundle 时,确保所需的着色器被正确打包。确保运行 AB 包的目标项目中正确配置了 URP 渲染管线。如果加载后材质丢失,检查 AB 包的加载逻辑,确保材质正确应用了着色器。通过这些步骤,你应该能够解决从标准渲染管线切换到 URP 渲染管线后,材质在 AB 包中变紫色的问题。如果问题仍然存在,请根据具体错误日志进一步排查。希望如上措施及解决方案能够帮到有需要的你。

**My Coding Family** 1967

python:使用PySpark基础准备-安装、构建PySpark执行环境入口对象、编程模型

python:使用PySpark基础准备-安装、构建PySpark执行环境入口对象、编程模型

听海边涛声 407

C# WPS操作PPT,全屏,缩率图,备注,跳转播放

本文介绍了一个使用C#开发的PPT操作工具,主要功能包括检测当前打开的PPT文件、获取选中PPT路径、指定播放PPT、获取PPT页面序号和缩略图、提取备注内容等。文章展示了操作界面效果图,并重点解决了用户手动退出PPT后重新获取路径时报错的问题。核心代码实现了通过WPS API进行PPT文件的打开、全屏播放、页面跳转、获取当前页位置等功能,同时支持生成PPT缩略图预览和备注信息提取。当用户未通过工具按钮打开PPT时,程序会自动初始化PPT信息确保功能正常使用。

遇见--专栏 312

【Python】PySpark 数据处理 ② ( 安装 PySpark PySpark 数据处理步骤 构建 PySpark 执行环境入口对象 )_pip install pyspark(1)

RDD 对象处理完毕后 , 写出文件 , 或者存储到内存中;数据的初始形态 , 一般是 JSON 文件 , 文本文件 , 数据库文件;通过 SparkContext 读取 原始文件 到 RDD 中 , 进行数据处理;数据处理完毕后 , 存储到 内存 / 磁盘 / 数据库 中;

2401_84139963的博客 927

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

PySpark开发环境搭建全攻略:从零开始构建大数据分析平台

新建项目时选择Existing interpreter。# 推荐使用Miniconda管理Python环境。# 可选:安装jupyterlab用于交互开发。安装Python扩展和Jupyter扩展。指定conda环境的Python解释器。内存:8GB(16GB以上更佳)建议使用集群部署,至少3节点。# 编辑~/.bashrc。每个节点16GB内存起步。硬盘:50GB可用空间。# 安装PySpark。# 启动Jupyter。# 读取HDFS数据。# 设置允许远程访问。

2401_84460368的博客 930

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

PySpark基础准备

同其他的Python第三方库一样,PySpark同样可以使用pip程序进行安装。PySpark的执行环境入口对象是:类 SparkContext的类对象。想要使用PySpark库完成数据处理,首先需要构建一个执行环境入口对象。SparkContext类对象,是PySpark编程中一切功能的入口。PySpark的功能都是从SparkContext对象作为开始。2.掌握PySpark执行环境入口对象的构建。3.理解PySpark的编程模型。1.掌握PySpark库的安装。3.PySpark的编程模型是。

weixin_50911515的博客 309

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

docker 搭建pyspark环境

文章目录来看下Linux的demo文件目录software文件夹内容编写简单的demo.pydockerfiledocker builddocker run 来看下Linux的demo文件目录 software文件夹内容 编写简单的demo.py ''' from pyspark import SparkContext import os os.environ['JAVA_HOME'] = '/home/software/jdk1.8.0_144' # 这里的路径为java的bin目录所在路径,我这

WGS. 2002

【python】-pyspark应用

Spark。Spark是一个强大的工具,适用于大数据处理和分析,无论是学术研究还是工业应用,都能找到其用武之地。

weixin_63106307的博客 2793

docker安装spark、pyspark环境

1. 下载spark :spark-2.4.4-bin-hadoop2.7.tgz,以当前最高版本为准 2. 解压后找到kubernetes/dockerfiles/spark目录,查看Dockerfile文件,注意注释部分中有一条执行命令(其中的目录结构需特别注意),执行命令时需按照此目录结构位置执行。 3. 复制文件注释中的执行命令,并执行;生成spark镜像。此时生成的镜像中只有sp...

随风*惊云的博客 2599

python学习之路 - PySpark快速入门

pyspark快速入门

qq_41444892的博客 4754

PySpark+Prophet

目录 一.背景 二.制作Prophet离线环境 2.1 下载Miniconda3 linux安装包并安装 2.2 安装python3.7(Prophet不支持3.8)虚拟环境及Prophet 2.2.1 问题一:使用清华源安装失败 2.3 制作压缩虚拟环境fbprophet.tar.gz包 2.4 使用fbprophet离线包 三.PySpark中使用指定的python版本 3.1 方法一:所有节点部署离线环境 3.2 方法二:仅在driver所在节点部署离线环境 四.PySpark开

五哥的酒馆 685
上一篇: AI技术栈实践分析
下一篇: 卷积神经网络的原理深入探讨
常耀斌
常耀斌 领域专家: 后端开发技术领域 领域专家: 后端开发技术领域
博客等级 码龄8年 1812粉丝 611原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值