WGAN的概念和应用

WGAN(Wasserstein GAN)看这一篇就够啦,WGAN论文解读 WGAN本作引入了Wasserstein距离,由于它相对KL散度与JS 散度具有优越的平滑特性,理论上可以解决梯度消失问题。接 着通过数学变换将Wasserstein距离写成可求解的形式,利用 一个参数数值范围受限的判别器神经网络来较大化这个形式, 就可以近似Wasserstein距离。WGAN既解决了训练不稳定的问题,也提供了一个可靠的训 练进程指标,而且该指标确实与生成样本的质量高度相关。 阅读详情

GAN面临的问题

生成式对抗网络(GAN, Generative Adversarial Networks),使用判别器(Discriminator)对生成器(Generator)进行不断优化,并需要Discriminator和Generator共同进步才行,但Discriminator往往不稳定,很容易出现梯度消失的情况。
Discriminator一般使用JS散度(Jensen-Shannon Divergence, JSD)来计算两个分布之间的差异,如果真实数据和生成数据没有重合,那么JSD的结果都是log2log2log2梯度就会消失(数学推导见后文)就没有办法往更好的方向进行训练,有可能就突然坏掉了
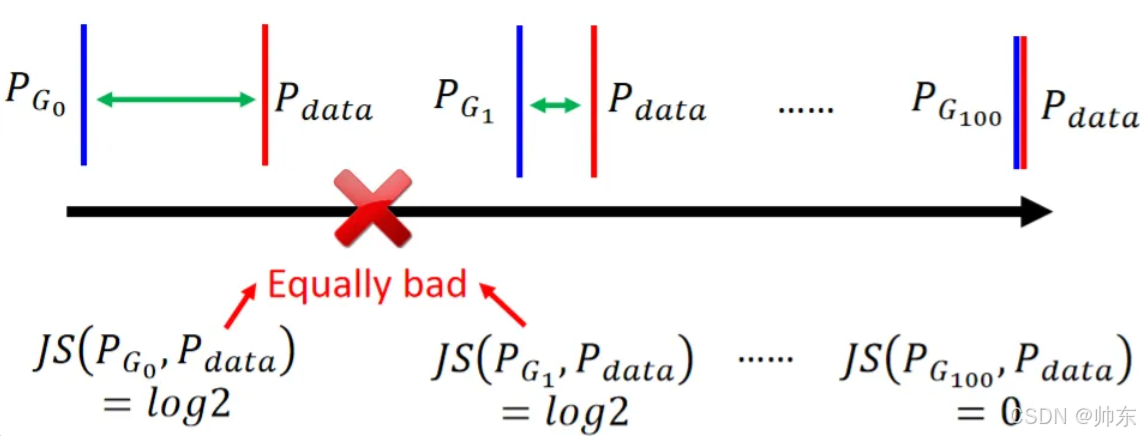
在这里插入图片描述

为什么真实数据和生成的数据会没有重合?

  1. sample的点不够多
  2. 在高维度上来看想要每次都重合概率很低。就像在1维上选取2个范围,它们还挺容易重叠,但如果在二维上选取2个范围,它们重合的概率就大大降低了。

实验效果

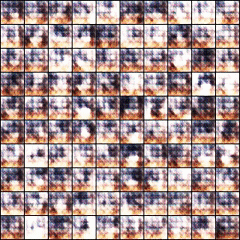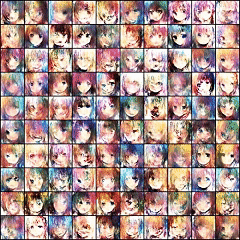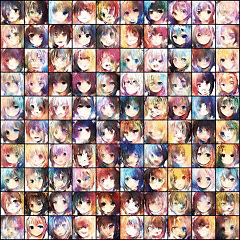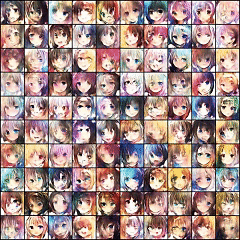
实验训练的是一个随机生成动漫头像的模型,1W张动漫一个Epoch,一个Epoch输出100张中间图片,接下来看看实际效果。
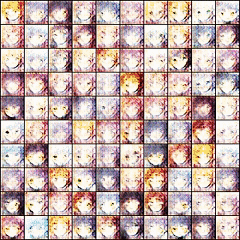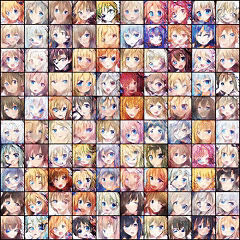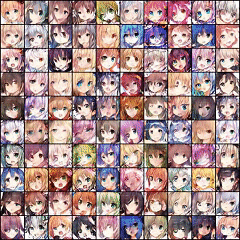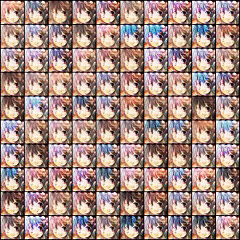
请添加图片描述
前面都还好好的,第18次的时候就完全崩掉了,而且后面怎么也训练不起来了。

WGAN介绍

Wasserstein GAN简称WGAN,17年1月份提出,目的是为了解决GAN训练不稳定的问题。训练 WGAN 不需要在判别器和生成器的训练中保持仔细的平衡,也不需要仔细设计网络架构。

核心思想

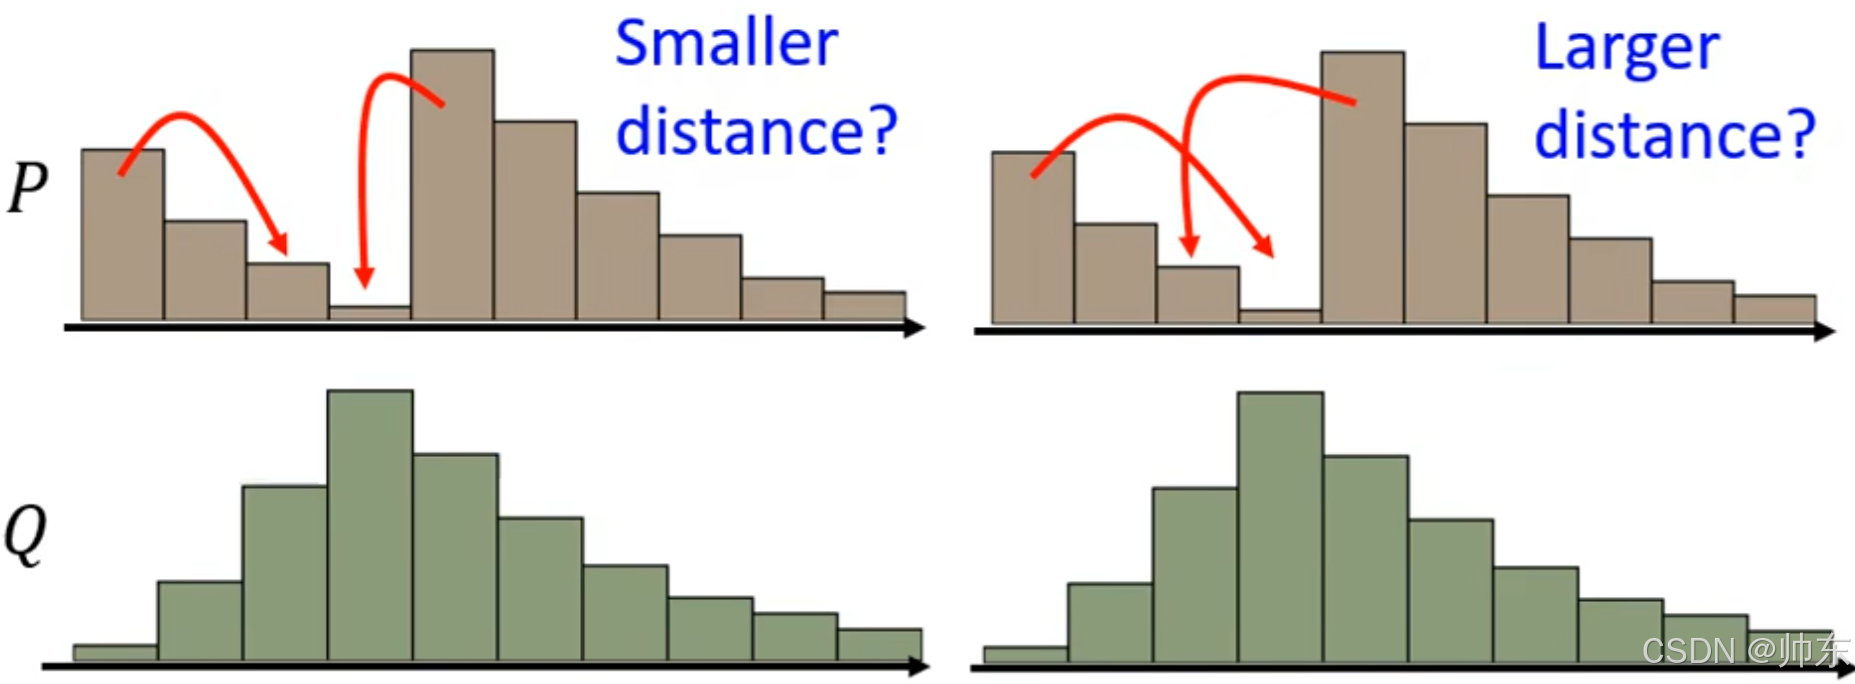
用 Wasserstein-1距离(Earth-Mover距离) 替代JS散度,衡量两个分布(真实分布、生成分布)之间的差异,解决GAN的训练不稳定、梯度消失问题。
在这里插入图片描述
我们要找到所有把P分布,移动到Q分布的方法,在这些方法里面找到最小的移动距离,这个距离就是P、Q分布的距离,两个分布总是有距离的,Simple出来的分布不同,距离往往不同,所以WGAN就会很稳,梯度消失的概率就很低。

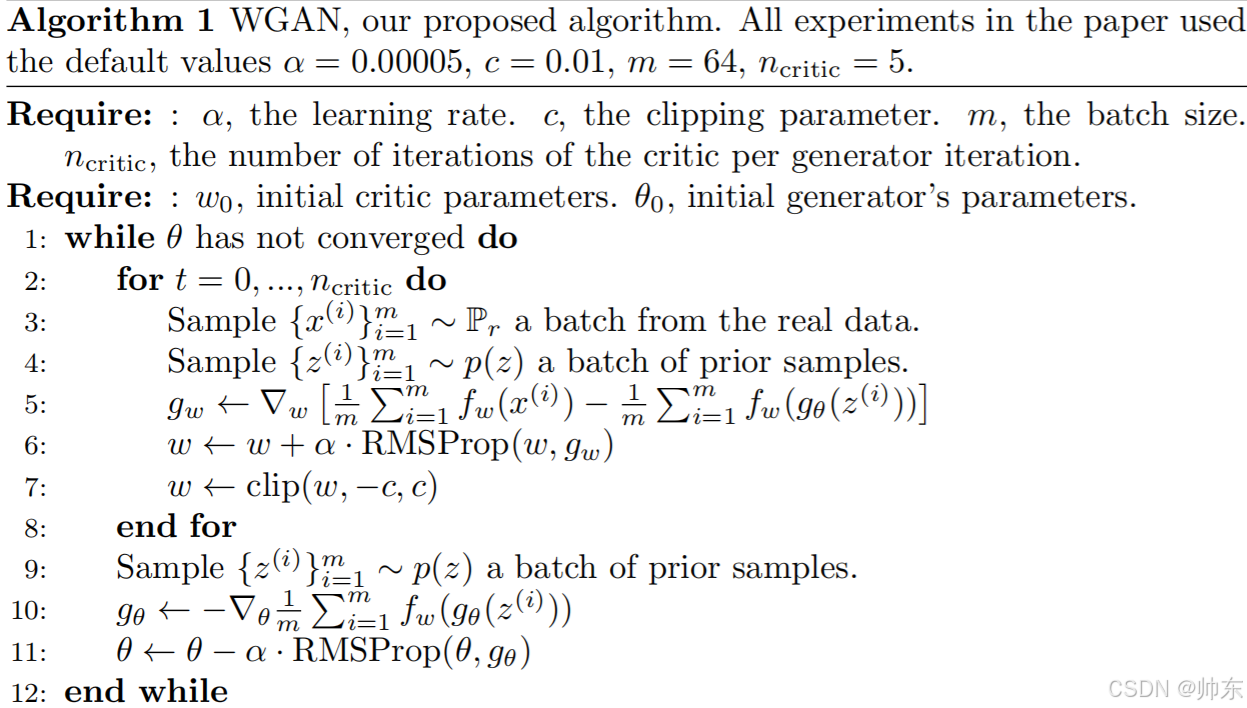
先不管作者是怎么推导出来的(数学推导见后文),但是这个思路是OK的,接下来就是看具体怎么训练,代码怎么写了。
在这里插入图片描述

  1. 设置默认值 α=0.00005\alpha = 0.00005α=0.00005,c=0.01c = 0.01c=0.01,m=64m=64m=64,ncritic=5n_{\text{critic}}=5ncritic​=5
  2. 循环直到 θ\thetaθ 收敛
    1. 循环训练5次critic(批评家)
      1. 抽取一组真实数据
      2. 抽取一组之前的样本(随便从正态分布中选)
      3. 计算gradient
      4. 使用 RMSProp\text{RMSProp}RMSProp更新参数
      5. 参数裁剪(限制在[-0.01,0.01])
    2. 抽取一组之前的样本(随便从正态分布中选)
    3. 计算Generator的gradient
    4. 使用 RMSProp\text{RMSProp}RMSProp更新参数

作者还把Discriminator改了一个名字叫做Critic,毕竟不再使用二元分类的办法区分了,也不用再叫做鉴别者了

乍一看感觉和理论没有任何关系,感觉和之前也没多大差别,对参数就行裁剪就OK?

Weight clipping is a clearly terrible way to enforce a Lipschitz constraint. If the clipping parameter is large, then it can take a long time for any weights to reach their limit, thereby making it harder to train the critic till optimality. If the clipping is small, this can easily lead to vanishing gradients when the number of layers is big, or batch normalization is not used (such as in RNNs). We experimented with simple variants (such as projecting the weights to a sphere) with little difference, and we stuck with weight clipping due to its simplicity and already good performance. However, we do leave the topic of enforcing Lipschitz constraints in a neural network setting for further investigation, and we actively encourage interested researchers to improve on this method.
如果裁剪参数很大,则任何权重都可能需要很长时间才能达到极限,从而使训练批评者达到最优变得更加困难。如果裁剪很小,当层数很大或未使用批量归一化时,这很容易导致梯度消失。我们坚持使用权重裁剪,因为它简单且性能已经很好,我们积极鼓励感兴趣的研究人员改进这种方法。

一句话总结:当时还没有找到更好的办法,参数裁剪的实验效果还可以,就先用它

GAN和WGAN在实际效果上的差异

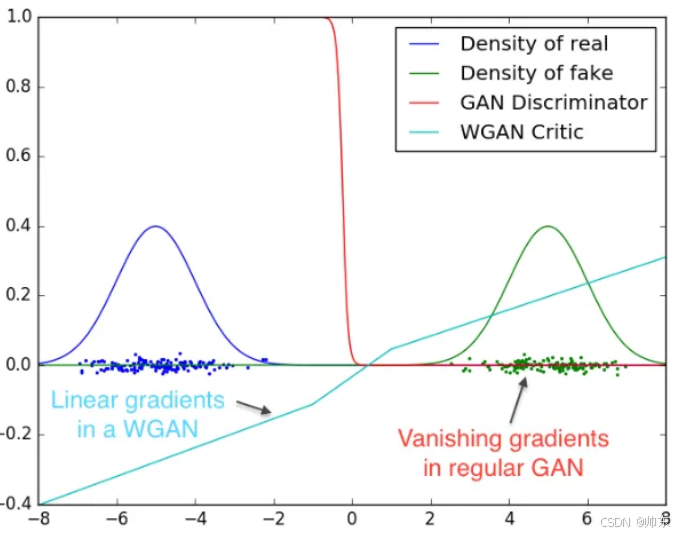
we show a proof of concept of this, where we train a GAN discriminator and a WGAN critic till optimality. The discriminator learns very quickly to distinguish between fake and real, and as expected provides no reliable gradient information. The critic, however, can’t saturate, and converges to a linear function that gives remarkably clean gradients everywhere. The fact that we constrain the weights limits the possible growth of the function to be at most linear in different parts of the space, forcing the optimal critic to have this behaviour.
我们训练 GAN 鉴别器和 WGAN 批评器,直到达到最优。 鉴别器可以很快学会区分 假的和真的,并且如预期的那样没有提供可靠的梯度 信息。然而,批评家无法饱和,并且会聚 变成一个线性函数,在各处都能给出非常干净的梯度。 事实上,我们限制了权重,从而限制了可能的 函数在不同部分的增长至多为线性 空间,迫使最佳评论家采取这种行为。
在这里插入图片描述
搞笑:老张家的人能力强,梯的猛;还是老C力度把控好,稳定又持久。

实验效果
在这里插入图片描述
虽然效果没有特别好,训练也慢,但过程很稳定,不会突然吃个饭回来就垮掉了

简单对比

特性 GAN WGAN
距离度量 JS散度 Wasserstein距离
约束方式 无约束 权重裁剪(强制Lipschitz)
梯度稳定性 差(易梯度消失) 好
训练难度 不稳定,易崩溃 稳定但收敛慢

数学推导

1.为什么是log2

KL散度(Kullback-Leibler Divergence,KLD),又称相对熵,是信息论中用于衡量两个概率分布差异的重要工具。它不是一个真正的“距离”(因为不对称),但可以量化一个分布 P 相对于另一个分布 Q 的不相似性。
DKL(P∥Q)=∑xP(x)log⁡P(x)Q(x)D_{KL}(P \| Q) = \sum_{x} P(x) \log \frac{P(x)}{Q(x)}DKL​(P∥Q)=x∑​P(x)logQ(x)P(x)​

JS散度是基于KL散度,取了一个平均值来定义:
JS(P∥Q)=12DKL(P∥M)+12DKL(Q∥M)JS(P \| Q) = \frac{1}{2} D_{KL}(P \| M) + \frac{1}{2} D_{KL}(Q \| M)JS(P∥Q)=21​DKL​(P∥M)+21​DKL​(Q∥M)
M=12(P+Q)M = \frac{1}{2}(P + Q)M=21​(P+Q),最终公式:
JS(P∥Q)=12∑xP(x)log⁡P(x)M(x)+12∑xQ(x)log⁡Q(x)M(x)JS(P \| Q) = \frac{1}{2} \sum_{x} P(x) \log \frac{P(x)}{M(x)} + \frac{1}{2} \sum_{x} Q(x) \log \frac{Q(x)}{M(x)}JS(P∥Q)=21​

生成对抗网络的Wasserstein距离:度量两个概率分布之间距离 生成对抗网络(Generative Adversarial Network,GAN)是近年来机器学习领域最重要的创新之一。GAN通过训练两个相互竞争的神经网络模型—生成器(Generator)和判别器(Discriminator),从而学习生成接近真实数据分布的样本。这种对抗训练的方式可以让生成器生成出高质量、接近真实数据分布的样本。传统的GAN模型使用Jensen-Shannon散度作为生成器和判别器之间的损失函数。 阅读详情

相关推荐

gan判别器的loss接近零_GAN论文阅读笔记4:最小二乘GAN/f-GAN

在学习完GAN和WGAN的原理后,总结出GAN的套路如下:用判别器D去区分真实的数据分布 和伪造的数据分布 的差异,再用生成器G来最小化这个差异。在原始GAN中,当D达到最优时,这个差异为两个分布之间的JS散度;在WGAN中,当D达到最优时,这个差异为两个分布之间的W距离。除了JS散度和W距离之外,还有别的选择吗?答案是肯定的:LSGAN(Least Squares GAN,最小二乘GAN)把...

weixin_30430333的博客 1067

GAN学习

开始学习GAN生成对抗网络相关知识,将要点和心得总结于此。

lx_xin的博客 1307

WGAN (Wasserstein Generative Adversarial Networks) 详解与实现

WGAN 是 GAN 的一种变体,通过使用 Wasserstein 距离来衡量生成样本与真实样本之间的差异。在本节中,我们学习了如何使用 Wasserstein 损失函数以解决经典 GAN 训练过程中的模式坍塌和梯度消失等问题,使得 GAN 的训练过程更加稳定和可靠。

盼小辉丶的博客 3950

WGAN:Wasserstein生成对抗网络

WGAN: Wasserstein 生成对抗网络 1. 背景介绍 生成对抗网络(Generative Adversarial Networks, GANs)是近年来机器学习领域最为重要的突破性进展之一。它由 Ian Goodfellow 等人在 2014 年提出,通过训练两个

AI天才研究院 1824

Pytorch Note45 生成对抗网络(GAN)

Pytorch Note45 生成对抗网络(GAN) 文章目录Pytorch Note45 生成对抗网络(GAN)GANsDiscriminator NetworkGenerator Network简单版本的生成对抗网络判别网络生成网络 全部笔记的汇总贴:Pytorch Note 快乐星球 2014年,深度学习三巨头之一 lan Goodfellow 提出了生成对抗网络( GenerativeAdversarial Networks, GANs)这一概念,刚开始并没有引起轰动,直到2016年,学界、业界对它

风信子的猫Redamancy的快乐星球 2661

单细胞转录组数据分析全流程:从原始数据到细胞注释

本文详细介绍了单细胞转录组数据分析的全流程,从原始数据读取、环境搭建、数据质控与标准化,到降维聚类、细胞类型注释,以及高级质控与多样本整合。重点阐述了如何利用Seurat等工具进行数据处理,并通过标志基因比对与自动注释方法完成细胞身份鉴定,为研究者提供了一套清晰、可操作的分析指南。

coffee的博客 549

Deepseek 10分钟化身理性荐股神器:触碰程序员不敢想的天花板

在这个消息疯狂、波动频繁的市场,“理性”两字显得弥足珍贵。通过Deepseek+AkShare+Aktools+Dify四位一体的方案,能帮我们降低信息搜集成本,并在短期投资领域搭建出一套“可解释、低门槛、易定制”的量化荐股流程。不要再盲目听小道消息或依赖情绪驱动,不妨给自己一个机会,让数据说话。而要注意的是,“理性荐股”并非万能,它只是工具,最终的收益还得依赖投资者自身对风险和机遇的权衡。祝大家都能在这股市里收获理性的底气,寻得更精准的入场时机。

qqxdh的博客 3750

基于STM32的简易电压、频率、占空比测量仪

任务详解:我们需要实现三个功能: 第一个是测频率的功能,输入信号为频率为1kHz~10kHz的三种波形(方波、三角波、正弦波),这也是我们最常见的三种波形。幅度是不需要测量的,所以先不关心幅度。 第二个是电压报警功能,当输入信号的幅度超过15V时,我们需要报警(这里我用了一个红色LED当报警器,有条件的还可以加个蜂鸣器)并且把此时的信号幅度显示在OLED屏幕上。 第三个是通信方式的要求,需要有串口通信功能。 第四个是计算占空比的任务,这个任务的输入是幅度为1V~10V、频率为20Hz ~1kHz的方波,需要

weixin_43469377的博客 7251

Quanto option期权公式推导(更新中)

Quanto期权不同于以标的股票或资产的计价货币支付最终收益的普通欧式期权,它以另一种货币以预先确定的汇率支付最后的收益。以股票B的计价货币来计价的quanto看涨期权的收益为F0×max⁡(Sa(T)−K,0)×Sb(T)F_0 \times \max(S_a(T)-K, 0) \times S_b(T)F0​×max(Sa​(T)−K,0)×Sb​(T) 其中SaS_aSa​以货币A计价,SbS_bSb​以货币B计价,F0F_0F0​是预先固定的汇率. 假设上述股票均遵循几何布朗运动,可以得到以下恒等式

qq_41782124的博客 3683

Ubuntu桌面消失?可能是lightdm配置在捣鬼:详细解析/etc/lightdm.conf的优先级机制与实战修复

本文详细解析了Ubuntu系统因lightdm显示管理器配置错误导致桌面消失的问题。通过分析/etc/lightdm.conf的优先级加载机制,提供了从systemctl诊断、调试模式运行到实战修复配置语法错误(如缺失[Seat:*]组)的完整方案。文章还探讨了在系统无法启动时使用chroot或恢复模式进行高级救援,并对比了lightdm与gdm3在NVIDIA驱动环境下的不同表现,帮助用户高效恢复图形界面。

weixin_29313547的博客 420

WPS集成DeepSeek最新教程,附详细图文,让文案生成更智能

本文将为大家详细介绍如何将 DeepSeek 功能集成到 WPS 中,通过 OfficeAI 插件,你无需进行复杂的本地部署,只需通过官网连接即可快速启用 DeepSeek 强大的 AI 功能。不论是文案生成、翻译校对,还是深度推理、决策支持,DeepSeek 都能为你提供便捷的解决方案。让我们一起来看看如何操作吧!

Java徐师兄的博客 6万+

ZYNQ RFSoC 的DAC如何做到从 0到Fs频段 信号输出

之前一直没太了解 RFSoC 的DAC如何输出在 Fs/2 到 Fs 频率范围内的信号,例如 ZCU216中的 ZU49DR,其RF-DAC最大采样率是 9.85GSPS,如果想输出的信号中心频率在5.8G,它是如何有效输出在第二奈奎斯特区域范围的信号的。

weixin_44630490的博客 1551

芒果YOLOv7改进48:主干篇:独家首发改进:目标检测新范式骨干PPHGNetv2改进版,充分融合信息特征,提升YOLOv7检测能力

YOLOv7代码改进实践 | 独家首发改进 PPHGNetv2 改进版结构

包括YOLOv5、YOLOv7、YOLOv8等模型改进 1847

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

上一篇: 分类模型为什么使用交叉熵作为损失函数
下一篇: Mysql为什么有时候会选错索引
帅东
博客等级 码龄11年 676粉丝 88原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
