- 博客(17)
- 收藏
- 关注
 RSS订阅
原创 【动手学深度学习】第九课 具体的卷积神经网络
将pooling层换成MaxPooling,激活函数换成ReLU,结果会发现,损失完全不收敛...然后发现应该是学习率的原因,我们的lr设为了0.9,但开始使用的是sigmoid,梯度变化比较平缓,而ReLU的梯度变化比较大,配合大学习率导致梯度爆炸了。(暂退法,随机失活神经元)来控制全连接层的模型复杂度,因为后面的全连接层参数非常多、输出数量也是LeNet的好几倍,所以使用dropout减轻过拟合。其实,更多的3*3的卷积层要比更少的5*5的效果好,也就是神经网络深但窄的效果更好。
2026-03-29 16:13:07
 427
原创 【动手学深度学习】第八课 卷积神经网络
假如我们采用一个12M像素的相机采集图片,那么RGB图片就有36M像素,我们使用100大小的单隐藏层MLP(已经很小了),这样算下来模型至少有3.6B个参数,=14GB,也就是你光存这些参数就花了14个G的内存,更何况这只是单层、并且我们还没做运算!(1)我们注意到,卷积核移动的时候,输入图像二维矩阵的中间位置每次都被计算了,而边缘却只计算了一次,这样我们得到的特征图就会丢失。(2)并且,一个图片经过卷积操作总是会使输出变小的,例3*3的图片经过2*2的卷积核后会变为2*2的特征图,如果我们想使。
2026-03-23 17:28:08
431
原创 【动手学深度学习】第七课 不知道取什么标题
这里,原始训练数据被分成个不重叠的子集。然后执行次模型训练和验证,每次在个子集上进行训练, 并在剩余的一个子集(在该轮中没有用于训练的子集)上进行验证。梯度消失(gradient vanishing): 参数更新过小,在每次更新时几乎不会移动,导致模型无法学习。当训练数据稀缺时,我们甚至可能无法提供足够的数据来构成一个合适的验证集。梯度爆炸(gradient exploding): 参数更新过大,破坏了模型的稳定收敛。其实我觉得理解了上面这句话就够了,如果想更具体地学习可以看一下李沐老师这部分的教材。
2026-03-18 15:44:24
397
原创 【动手学深度学习】第六课 多层感知机
这里我用自己的话解释一下,现实中大部分任务都是无法用简单的线性模型来预测或分类的,所以输入到输出层之间无法用简单的一层线性模型来进行链接,于是我们可以在中间加入若干隐藏层。由于我们已经从零实现过softmax函数, 因此在这里我们直接使用高级API中的内置函数来计算softmax和交叉熵损失。多层感知机的训练过程与softmax回归的训练过程完全相同。这个图自行理解一下吧,大概是1、4是一组,2、3是一组,那怎么划分它们呢?可以看到,效果跟上小节实现的softmax相比,损失降下来了,但精度没什么提升。
2026-03-17 16:20:46
399
原创 【动手学深度学习】第五课 softmax回归
首先我们来回顾一下矩阵相加的操作:定义softmax操作后,我们可以实现softmax回归模型。下面的代码定义了输入如何通过网络映射到输出。注意,将数据传递到模型之前,我们使用reshape函数将每张原始图像展平为向量。还是拿一个例子:y_hat是一个数据样本,包含2个样本在3个类别的预测概率。
2026-03-09 21:13:53
415
原创 【动手学深度学习】第四课 线性神经网络
在每次迭代中,我们读取一小批量训练样本,并通过我们的模型来获得一组预测。计算完损失后,我们开始反向传播,存储每个参数的梯度。最后,我们调用优化算法sgd来更新模型参数。下面代码需要看懂!!(1)lr 是超参数,指学习率,可以理解为梯度下降中参数更新的 “步长”。它不能过大也不能过小。太大了可能导致一步跨到头,导致梯度爆炸。太小了走得很慢,可能训练了很多个epoch还是损失很大。(2)net 这里使用线性模型,以后也可以很方便地换成其他模型。这里使用 PyTorch 的。
2026-02-27 16:59:59
1034
原创 【动手学深度学习】第三课 数据预处理
比如Alley这一列,它就只有两个类别值:Pave和NaN,pandas会自动将这一列转换为“Alley_Pave”和“Alley_NaN”,然后用0和1来表示这一行的类别值。现在inputs和outputs里都是数值类型,我们需要将它转换为Tensor格式。当然,在实际应用中,如果某一列缺失值占比极高,我们还会采用删除法,见作业第一题。首先,通过位置索引iloc,将data分为inputs和outputs。对于inputs中缺少的类别值或离散值,我们将NaN看作一个类别☝️。
2026-02-01 17:57:15
592
原创 机器学习简介
从广义上来说,机器学习是一种能够赋予机器学习的能力以此让它完成直接编程无法完成的功能的方法。从实践意义上来说,机器学习是一种利用数据训练出模型,然后使用模型进行预测的一种方法。传统预测:店铺销量预测、量化投资、广告推荐、企业客户分类、SQL语句安全检测分类。自然语言处理:文本分类、情感分析、自动聊天、文本检测。3、机器学习与人工智能、神经网络、深度学习。自然语言处理 + 文本处理 + 机器学习。语音识别 = 语音处理 + 机器学习。1、机器学习是计算机从。统计学习 ~ 机器学习。4、机器学习能做什么?
2023-03-18 15:54:23
218
原创 【初入前端】第六课 课前预习
文章目录一、DOM1. DOM树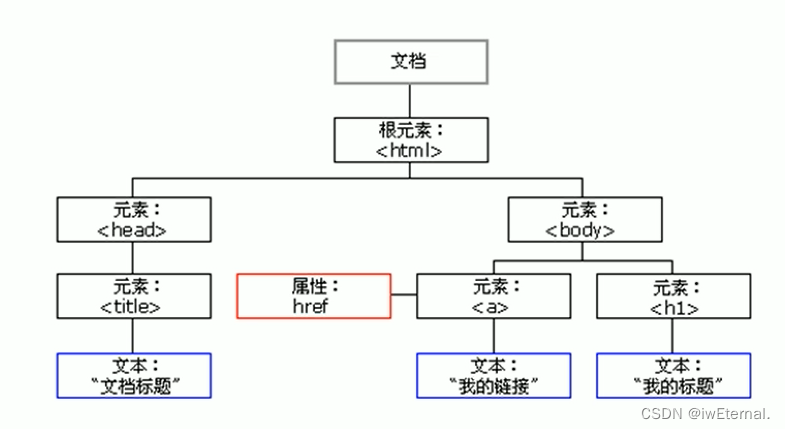2. 获取元素3. 修改元素内容二、EOM一、DOM1. DOM树2. 获取元素getElementById 通过 id 获取<body> <div id="time">2019-9-9</div> //id <script>
2022-05-27 19:23:38
211
原创 【初入前端】第五课 课前预习
提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档文章目录一、js基础引用输出注释二、语法1.标识符2.数据类型类型分类typeof 运算符StringNumberBooleanUndefinedNull3、强制类型转换转换为String类型转换为Number类型转换为Boolean类型语句三、函数1.函数创建2.函数调用嵌套函数匿名函数对象中的函数一、js基础引用1.标签引用<script> alert("Hello,World!");</scri.
2022-05-20 20:35:43
315
原创 【初入前端】第四课 课前预习
提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档文章目录前言一、浮动(float)1、什么是浮动2、浮动的特性3、与标准流父级搭配使用二、使用步骤1.引入库2.读入数据总结前言提示:这里可以添加本文要记录的大概内容:例如:随着人工智能的不断发展,机器学习这门技术也越来越重要,很多人都开启了学习机器学习,本文就介绍了机器学习的基础内容。提示:以下是本篇文章正文内容,下面案例可供参考一、浮动(float)1、什么是浮动css提供的三种传统布局方式:普通流(标准流)、浮动.
2022-04-29 14:54:26
481
原创 【初入前端】第三课 课前预习
文章目录一、css高级选择器1.后代选择器2.子选择器3.并集选择器二、伪类选择器1.链接伪类选择器2.focus伪类选择器3.总结三、盒子模型1.边框 border2.内边距 padding3.外边距 margin四、背景、阴影、圆角边框1.背景 bcakground2.阴影 box-shadow、text-shadow3.圆角边框 border-radius一、css高级选择器1.后代选择器后代选择器又称为包含选择器,其语法如下(表示选择元素1里面的所有元素2):元素1 元素2 { 样式声明
2022-04-17 19:40:49
789
原创 【初入前端】第二课 课前预习
目录一、样式表1.行内样式2.内部样式3.外部样式二、css字体、文本样式1.字体属性2.文本属性三、css的基础选择器1.标签选择器2.类选择器3.ID选择器4.权重四、css样式的三大特性1.层叠性2.继承性3.优先级五、行内元素、块级元素1.行内元素2.块元素3.行内块元素4.元素显示模式转换**感谢您的浏览!**一、样式表1.行内样式<body> <div style="width: 200px; height: 50px; border: 5px solid pink;
2022-04-14 19:54:12
315
原创 【初入前端】第一课 课前预习
目录一、HTML、CSS、JS 简介HTML CSS JavaScript二、HTML常用标签一、HTML、CSS、JS简介1、HTMLHTML 指的是超文本标记语言(Hyper Text Markup Language)(h5 audio video) HTML 不是编程语言,是一种标记语言(markup language) 标记语言是一套标记标签(markup tag) HTML 使用标签来描述网页...
2022-04-07 14:58:37
923

空空如也
空空如也
TA创建的收藏夹 TA关注的收藏夹
TA关注的人