向量数据库 PieCloudVector 进阶系列丨基于图片数据打造商品推荐系统

在人工智能迅猛发展和数据量不断膨胀的当下,传统数据库在面对高维度和大规模的数据处理时早已力不从心。为应对这一挑战,拓数派团队凭借在分布式数据库领域的深厚积累,打造了云原生向量数据库 PieCloudVector。本系列将分为三篇,分别以图片、音频、文本三种典型非结构化数据类型为例,为大家介绍 PieCloudVector 的应用。

拓数派旗下云原生向量数据库 PieCloudVector 采用了将业界成熟开源算法实现与自研的基于 postgres 内核的关系型数据库对接起来的技术路线,能够存储和管理原始数据的向量表示,同时支持精确查询与模糊查询功能,用户可以通过 Postgres 客户端进行高效的相似性搜索。

PieCloudVector 利用其分布式架构显著提升了向量计算的效率,并在此基础上提供了一整套上下游工具。在技术架构上,PieCloudVector 按照向量数据的实际应用流程划分为五个核心层级:原始数据存储、嵌入(Embedding)、索引构建、向量检索以及数据应用。这些层级分别对应于向量数据处理和分析过程中的不同应用场景,构成了一个完整的技术框架,如下图所示:
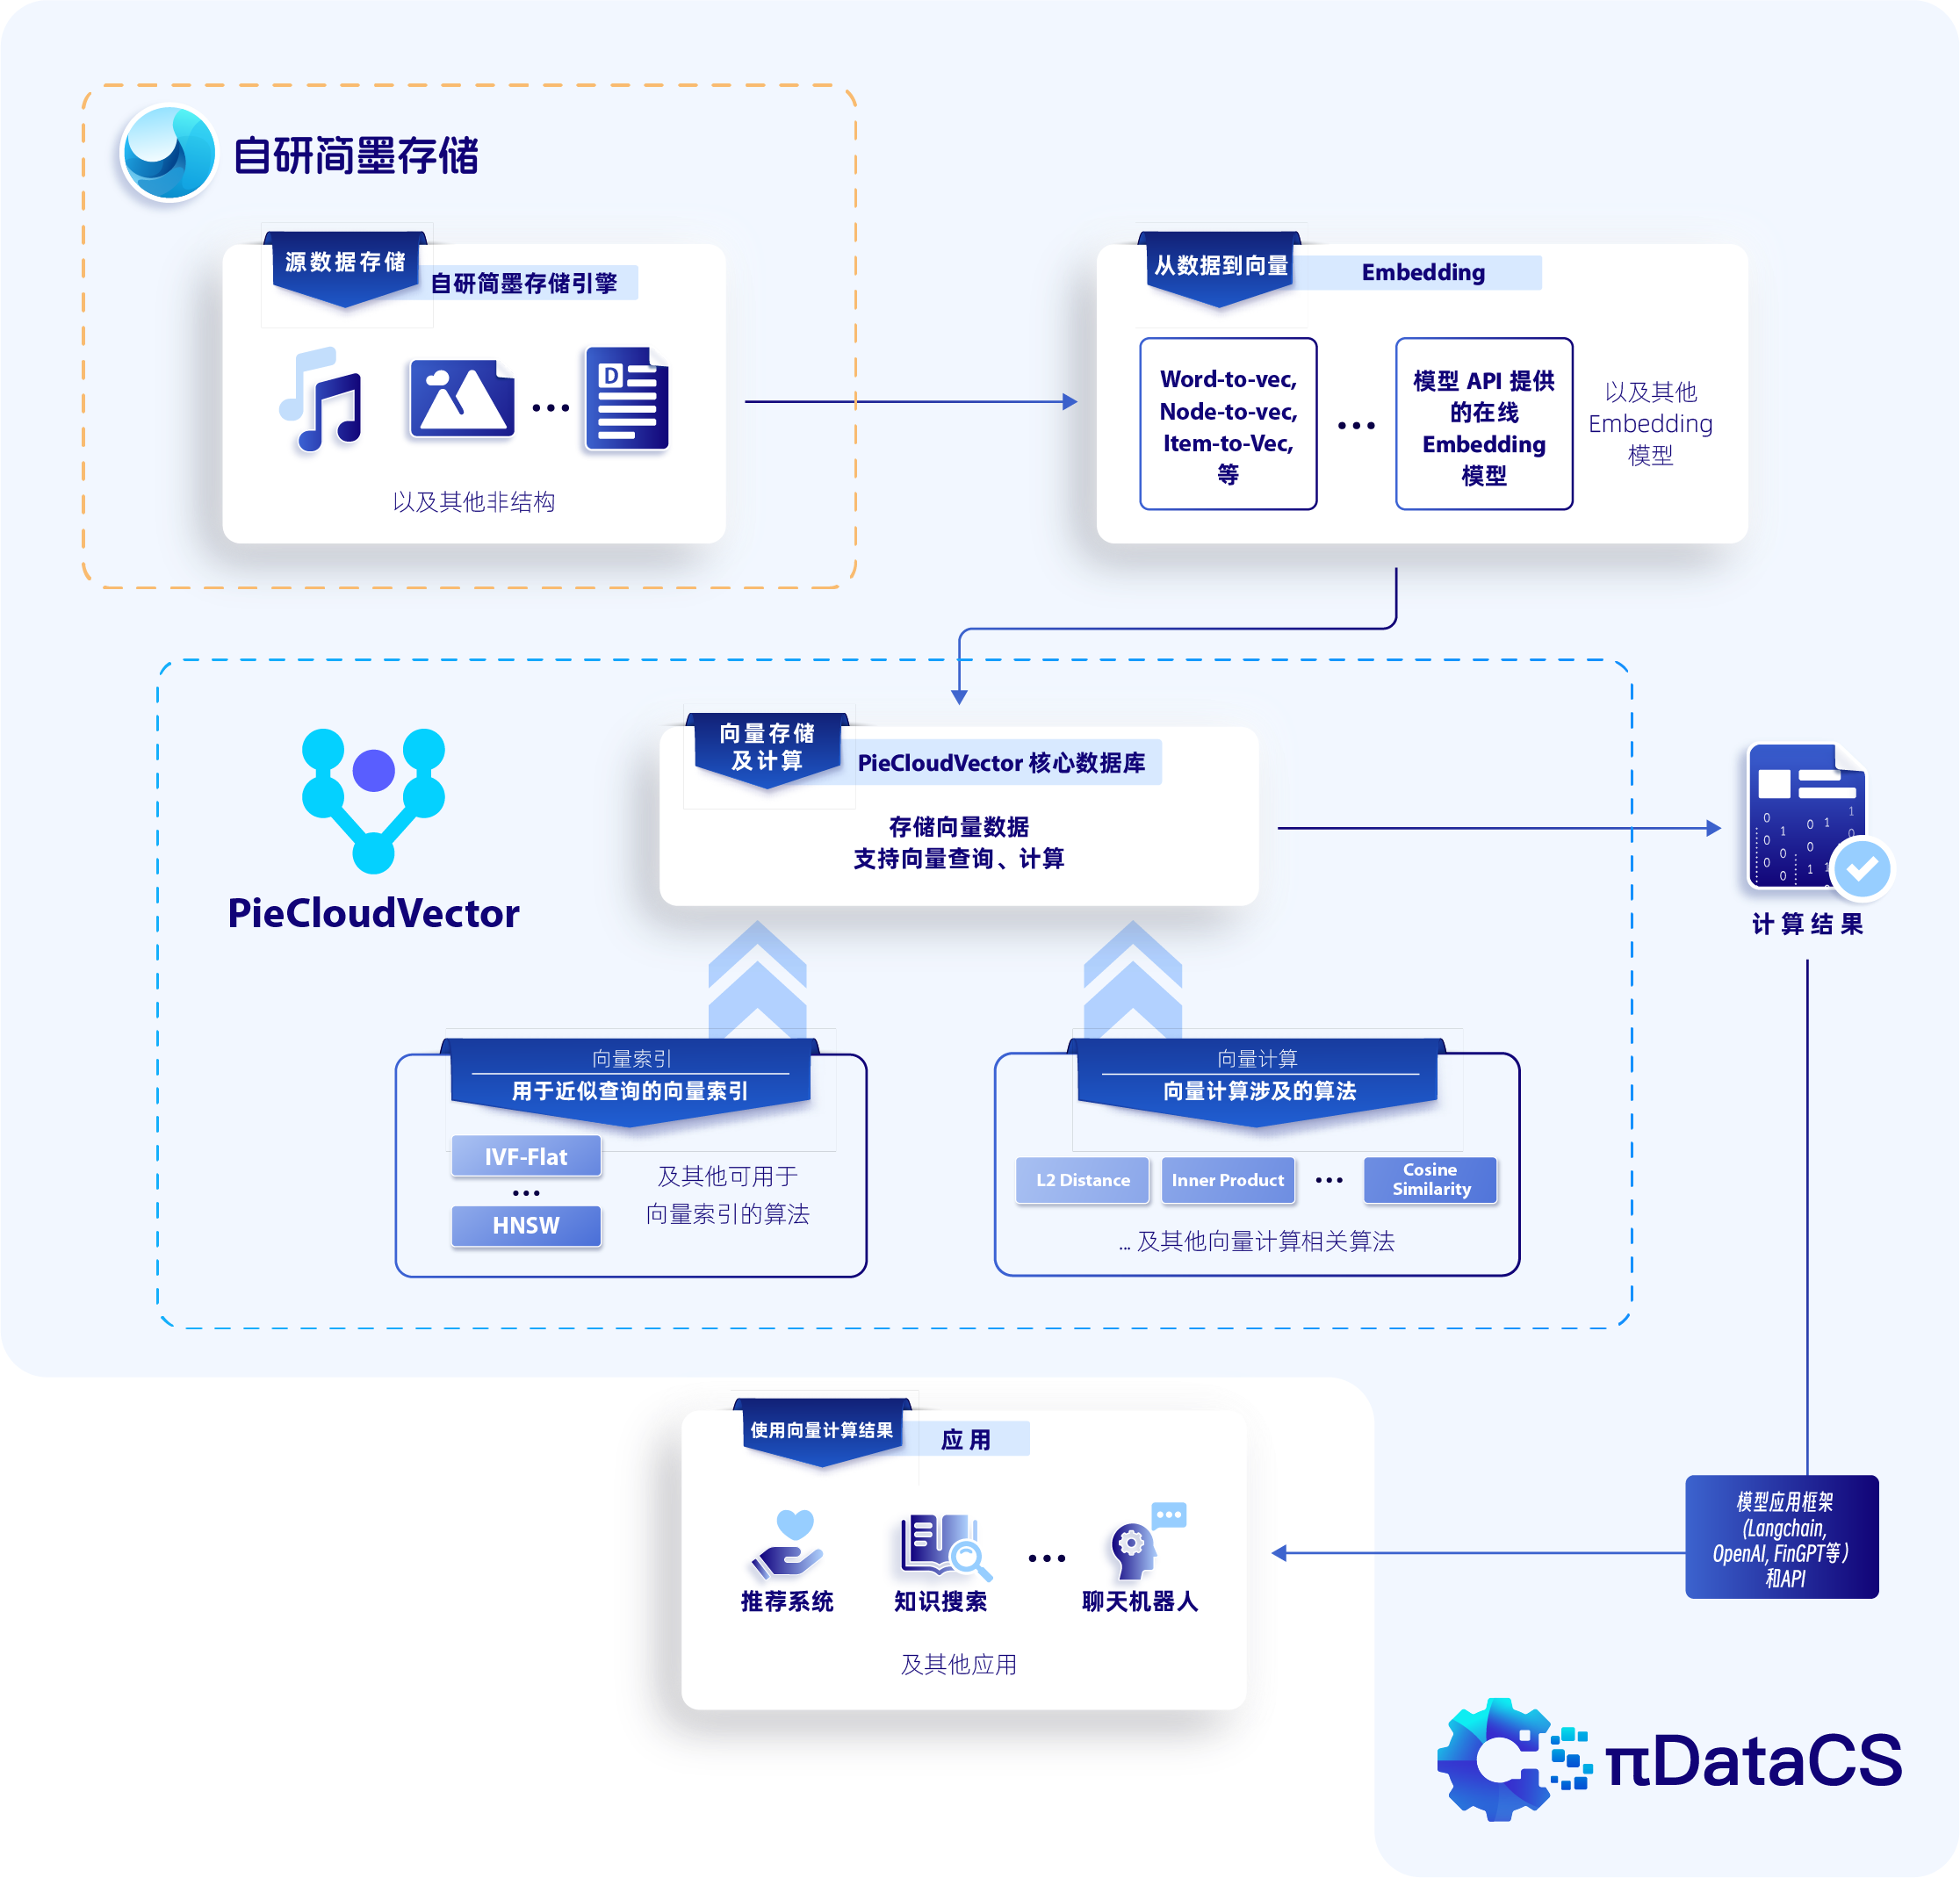
image.png

PieCloudVector 整体技术框架

本文为《PieCloudVector 进阶系列》的第一篇,将以图片数据为例,一步步展示如何使用 PieCloudVector 构建商品推荐系统,深入探讨数据向量化的关键步骤,包括 Embedding 计算、将向量写入数据库,以及相似性搜索。 (本文演示数据均来自 Hugging Face)

基于图片数据打造商品推荐系统

向量数据库在执行相似性查询任务中扮演着关键角色,以服装行业的应用场景为例,通过结合商品图片的向量表示与 K-最近邻(KNN)算法,PieCloudVector 能够帮助系统有效地在现有商品库中检索并推荐与目标商品相似的候选商品。整体框架如下图:
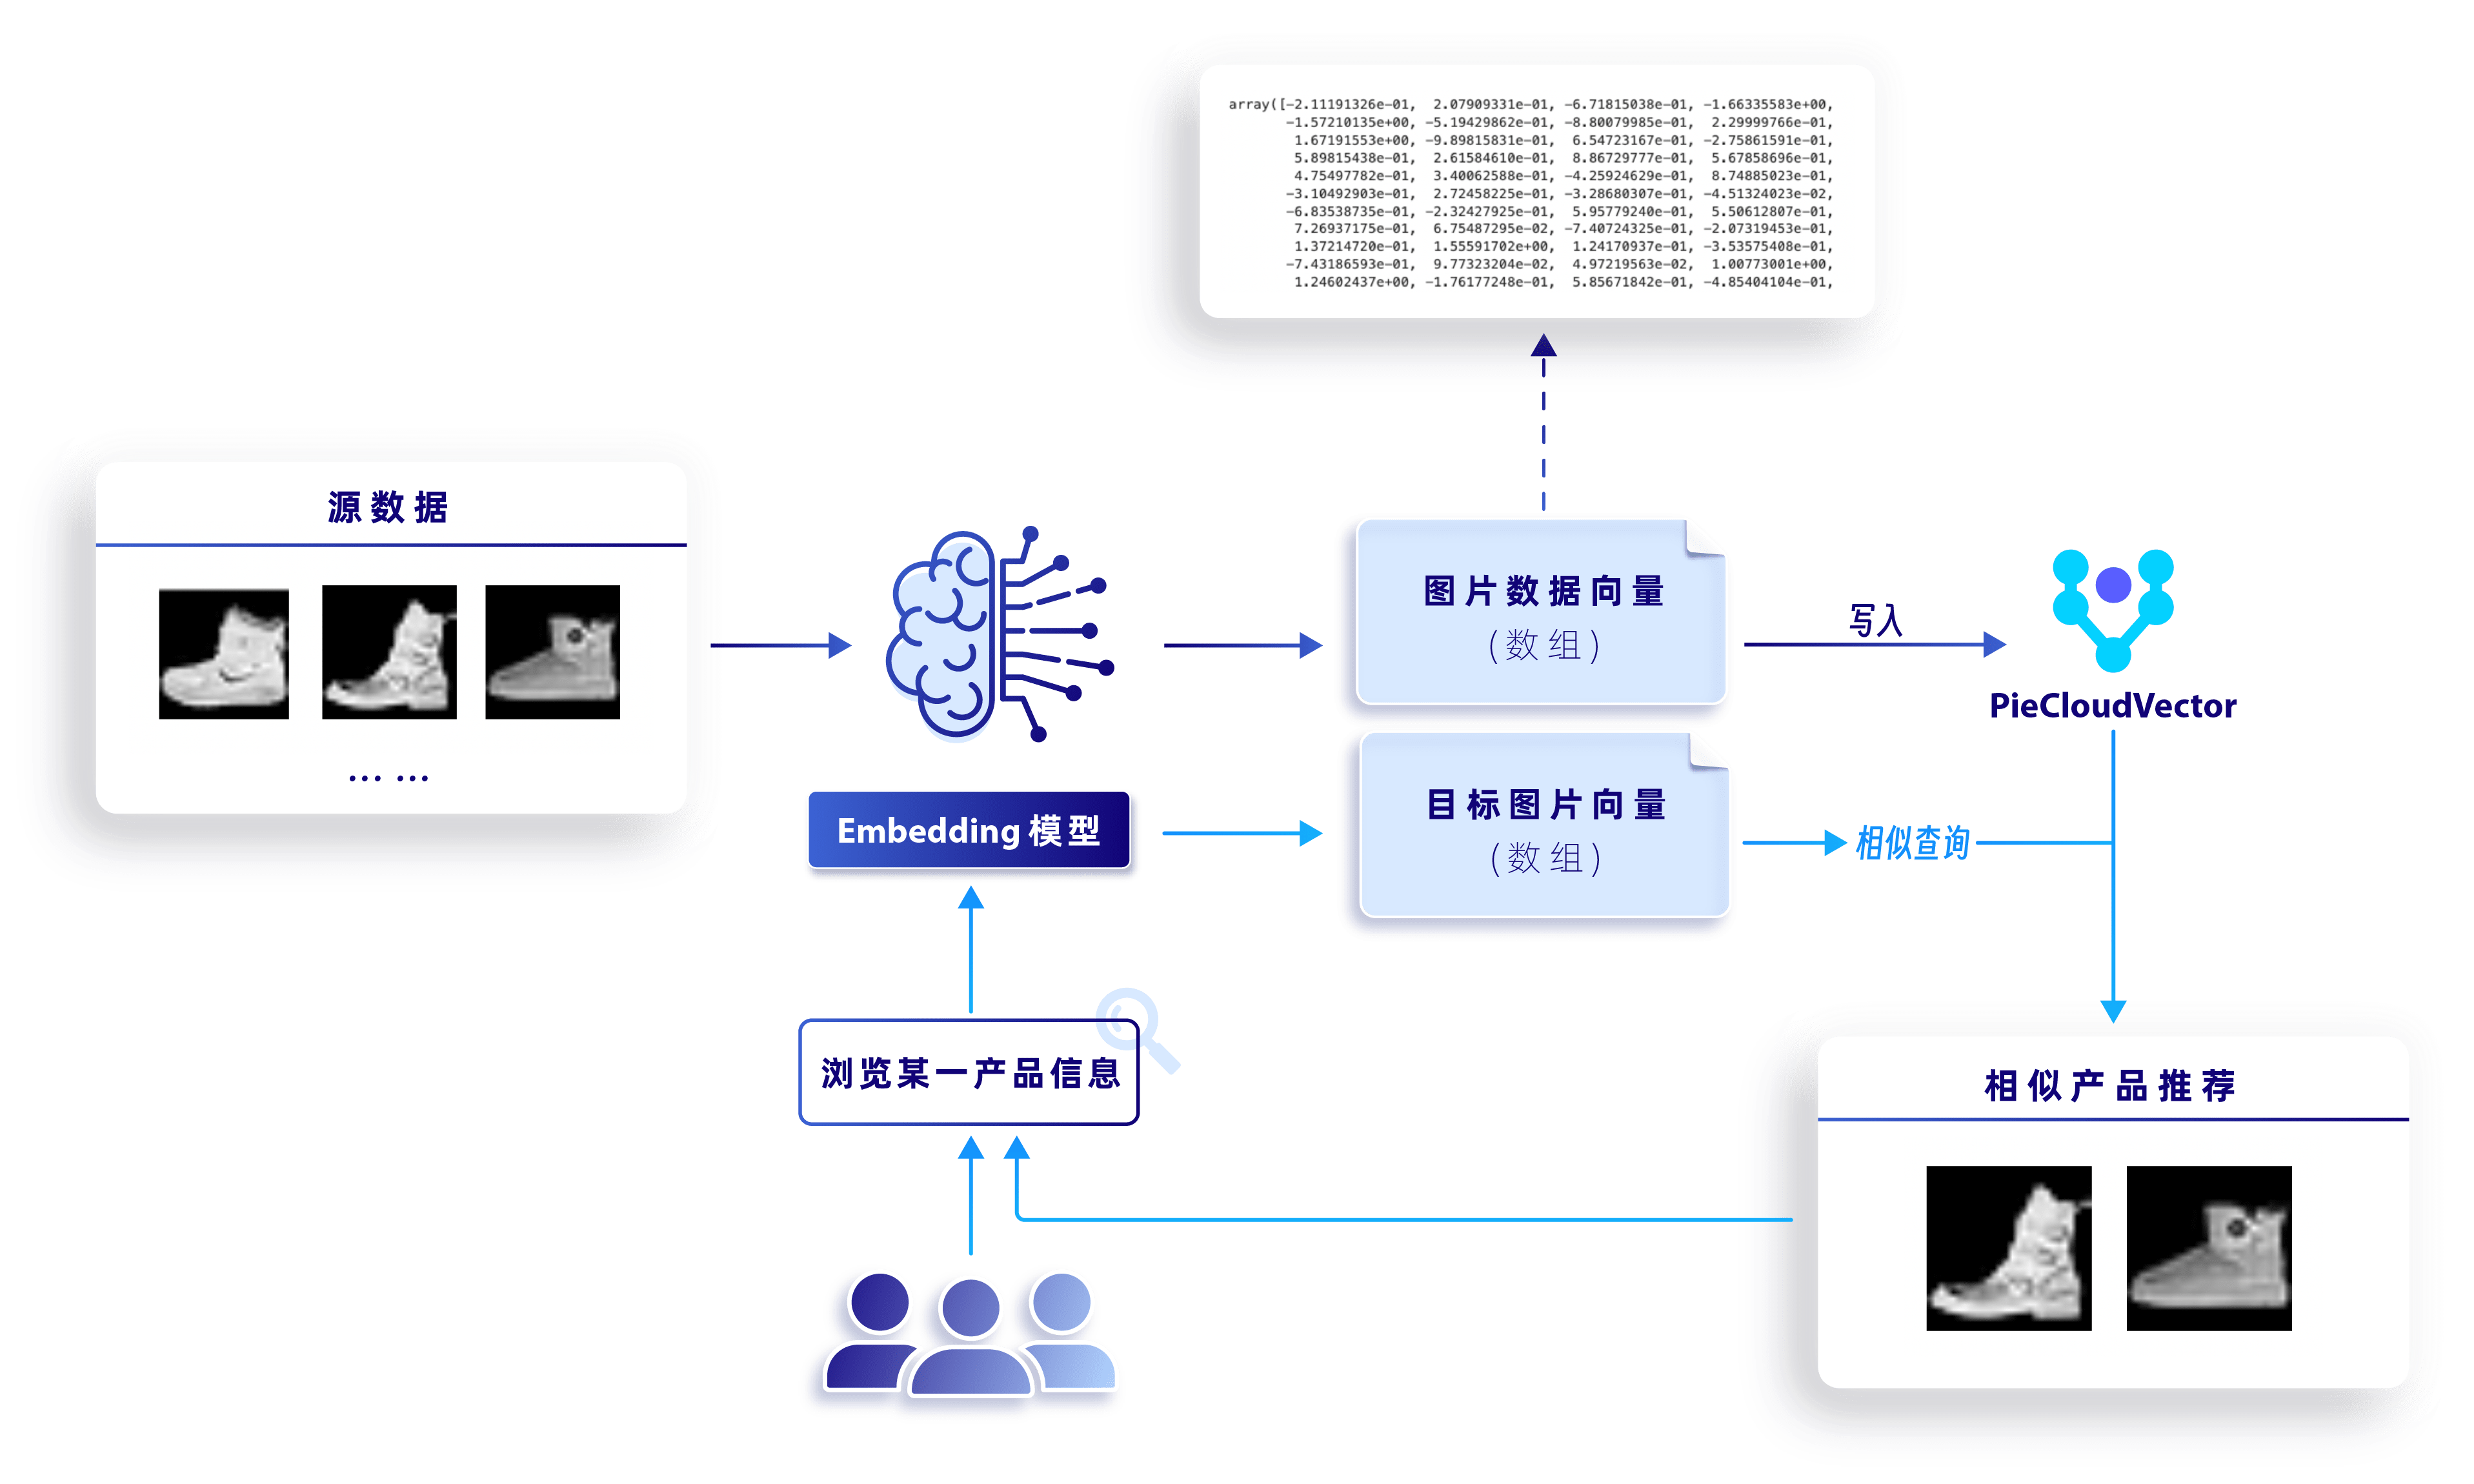
image.png

系统整体流程框架

接下来,本文将从「数据集准备」、「数据向量化处理」、「向量数据存储」以及「相似性搜索」四个关键环节,详细阐述利用 PieCloudVector 搭建商品推荐系统的整个流程。

1.数据集准备

首先,从 Hugging face 下载 fashion mnist 数据,该数据集包含了服装图片、类型等数据,详见 fashion_mnist[1]。

这里,我们选取训练集中前 1000 条数据作为演示数据。

from datasets import load_dataset

dataset = load_dataset("fashion_mnist", split="train[:1000]")

下载数据中包含以下信息:

print(dataset.features)
{'image': Image(decode=True, id=None),
 'label': CtassLabel(names=['T - shirt / top', 'Trouser', 'Pullover', 'Dress', 'Coat', 'Sandal', 'Shirt', 'Sneaker', 'Bag', 'Ankle boot'],
id=None)}

2.数据向量化处理

接下来,对数据进行向量化处理,运用合适的模型将其转换为数值数组,从而生成能够代表原始数据特征的嵌入向量。

以第一条数据为例,目的是找到前 10 个与其相似的服装作为推荐商品,其对应的图片如下图所示,类型为 Ankle boot(短靴)。

image.png

调用 imgbeddings[2] 库将图片数据转换为向量,该库采用了以 OpenAI 的 CLIP 模型为基础的模型,轻量且计算速度快(在 CPU 计算的情况下),非常适合 fashion mnist 这样只展示商品、图片内容并不复杂的数据集。

import numpy as np
from imgbeddings import imgbeddings

ibed = imgbeddings()

以第一条数据为例,基于图片生成向量。

embedding_0 = ibed.to_embeddings(dataset['image'][0])

imgbeddings 会生成一个长度为 768 的向量,如下所示。

In: embedding_0.shape

(1, 768) 

embedding [0]

array([-2.11191326e-01,  2.07909331e-01, -6.71815038e-01, -1.66335583e+00,
       -1.57210135e+00, -5.19429862e-01, -8.80079985e-01,  2.29999766e-01,
        1.67191553e+00, -9.89815831e-01,  6.54723167e-01, -2.75861591e-01,
        5.89815438e-01,  2.61584610e-01,  8.86729777e-01,  5.67858696e-01,
        4.75497782e-01,  3.40062588e-01, -4.25924629e-01,  8.74885023e-01,
       -3.10492903e-01,  2.72458225e-01, -3.28680307e-01, -4.51324023e-02,
       -6.83538735e-01, -2.32427925e-01,  5.95779240e-01,  5.50612807e-01,
        7.26937175e-01,  6.75487295e-02, -7.40724325e-01, -2.07319453e-01,
        1.37214720e-01,  1.55591702e+00,  1.24170937e-01, -3.53575408e-01,
       -7.43186593e-01,  9.77323204e-02,  4.97219563e-02,  1.00773001e+00,
        1.24602437e+00, -1.76177248e-01,  5.85671842e-01, -4.85404104e-01,
       -5.25022328e-01, -1.84076607e-01, -4.65092547e-02,  7.65870810e-01,
        1.27615702e+00,  7.38422930e-01,  2.59102374e-01,  5.86230934e-01,
       -1.34280175e-01, -4.21402991e-01,  1.31635904e-01,  6.08720705e-02,
        3.83820683e-01,  9.36180592e-01,  4.59356755e-02,  3.50226104e-01,
       -5.04337013e-01, -5.55240333e-01, -7.46359229e-02,  3.54337037e-01,
       -6.38039052e-01,  8.85763526e-01, -2.85562664e-01,  9.87186372e-01,
        1.74211636-01,  -4.21855748e-02,  2.725174430-01, -3.59927297e-01
...

然后,将除第一条数据以外的数据进行向量化处理。

embedding = ibed.to_embeddings(dataset['image'][1:])

3.向量数据存储

数据处理完毕后,下一步是将向量存储到数据库中。写入之前,我们需要先在数据库中为这些向量创建目标表。

需注意的是,在定义向量字段时,维度并不是必须的参数。如果给定了维度,那么后续写入的数据必须参照该维度,其他维度的向量则无法写入该表。若没有给定维度,一旦数据写入了表中,那么后续的向量维度必须与表中已存在的向量一致;但若将表中的数据清空,在没有给定维度的情况下,其他维度的向量也可写入该表,后续加入的数据须则参照新的维度,否则无法写入。无论哪种情况,表中若有向量字段,那么该字段中所有向量的维度都必须一致。

CREATE TABLE pictures (id bigserial PRIMARY KEY, embedding vector(768));

向量表创建完成后,将向量数据依次写入数据库中。

import psycopg2
conn = psycopg2.connect('postgresql://usr:pswd@192.138.***.***:5432/db')
cur = conn.cursor()
embedding_lst = embedding.tolist()
for i in range(len(embedding_lst)):
    cur.execute('INSERT INTO pictures (embedding) values (%s)', (embedding_lst[i],))
conn.commit()
conn.close()

4.相似性搜索

写入完成后,即可利用 PieCloudVector 通过 K-最近邻(K-Nearest Neighbour, KNN)算法检索与目标向量最为相似的数据。目前,有三种不同的距离度量方法可供选择:L2 距离、内积(Inner Product)和余弦相似度(Cosine Similarity),可根据具体的应用场景、数据的特性以及对搜索结果精确度的要求,灵活选择最合适的距离计算算法。

在先前的步骤中已将目标数据(原数据集中第一条数据,一双短靴)进行向量化处理,这里可以直接通过 Python 向数据库发送 query 来查询最相似(与目标数据向量距离最近)的 10 个单品,使用的距离算法为 L2 Distance。

from sqlalchemy import create_engine
import pandas as pd

engine = create_engine('postgresql://usr:pswd@192.138.***.***:5432/db', echo=False)
img_id = pd.read_sql('select id from pictures where id != 1 order by embedding <-> ' + "'" + str(embedding_0.tolist()[0]) + "'" + ' limit 10',
                     con=engine)

找到这些单品后,可以调取它们的图片来展示相似查询的结果。

id_lst = img_id['id'].to_list()
for i in id_lst[:5]:
    display(dataset['image'][i])

结果如下图:
image.png

此外,也可通过其他相似图片的服装类别来判断目标图片的类别,这样的信息也可作为辅助,对推荐结果进行优化。

def most_common(lst):
    return max(set(lst), key=lst.count)

label = most_common([dataset['label'][i] for i in id_lst])
print(dataset.features["label"].int2str(label))

可以看到,最终的推荐结果为短靴,系统可以将靴子这一类的产品作为推荐提供给消费者。

dataset.features["label"].int2str(label)

'Ankle boot'

这就是如何使用 PieCloudVector 来构建一个基于图片数据的商品推荐系统的全部过程。通过向量化处理和相似性搜索,系统能够高效地找到与目标商品相似的推荐项,既提高了推荐的准确性,也增强了用户体验。在下篇文章中,我们将继续探索如何使用 PieCloudVector 来处理音频数据,实现音频内容识别。 欢迎关注!

参考链接

  1. Hugging Face 数据集
  2. GitHub imgbeddings 库

关于 PieCloudVector

拓数派大模型数据计算系统(PieDataCS)第二款云原生向量计算引擎 PieCloudVector 是大模型时代的分析型数据库升维。PieCloudVector 助力多模态大模型 AI 应用,进一步实现海量向量数据存储、向量数据高效查询,支持和配合大模型的 Embeddings,帮助基础模型在场景 AI 的快速适配和二次开发,是大模型应用必备。目前,除 PieCloudVector 之外,PieDataCS 还支持云原生虚拟数仓 PieCloudDB Database 和 云原生机器学习 PieCloudML 两款计算引擎。

相关推荐

拓数派亮相进博会:与普华永道(PwC)签署战略协议,推动AI原生服务在专业服务场景落地

第九届中国国际进口博览会(简称“进博会”)于11月5日至10日在国家会展中心(上海)隆重举行。作为中国推动高水平对外开放的重要平台,进博会汇聚全球企业与产业资源,促进国际经贸交流和技术合作。作为普华永道(PwC)的合作伙伴,拓数派受邀参加本届进博会,并在普华永道展区的科创生态伙伴区设置展台。11月8日,双方在活动现场正式签署战略协议,共同探索多场景联合解决方案,推动AI原生服务在专业服务场景落地。

OpenPie的博客 182

拓数派携DOMA企业AI网关闪亮登场2026世界互联网大会“互联网之光”博览会:以DOMA全链路能力破解企业主权AI落地困境

11月2日至5日,2026年世界互联网大会“互联网之光”博览会在嘉兴桐乡乌镇隆重举行。作为峰会重要品牌活动,本届博览会以“智能互联、智见未来”为主题,吸引了来自54个国家和地区的671家企业参展。拓数派携DOMA企业AI网关这一轻量级本地算力底座重磅亮相“数字浙江· 智能经济”展区,呈现企业主权AI全新落地路径。

OpenPie的博客 138

拓数派联动萧山实体产业,深度研讨AI原生企业服务

10月23日,在杭州市萧山区数据局、萧山区OPC青年服务联盟的共同指导下,由拓数派主办、1024数字产业基金会支持的“可信Data+智能体AI:实现企业专属AI服务”行业研讨会(杭州站)在杭州湾信息港举行,来自萧山政府部门、实体制造企业和拓数派生态合作伙伴的众多嘉宾代表参会。拓数派和与会的萧山实体企业代表围绕一个核心问题展开讨论:企业如何将自身数据、经验和业务流程转化为安全可控、持续运行的AI原生服务。

OpenPie的博客 162

载誉前行|拓数派荣膺安永复旦“2026最具潜力种子企业”

9月18日,由安永联合复旦大学主办的“2026最具潜力企业”颁奖典礼暨高增长企业主题研讨会在上海举行。“最具潜力企业”评选自2011年启动以来,至2026年已举办十六届,累计有382家新兴企业参与,其中60余家已成功上市。评选主要从企业成长性、可持续性、发展范围及竞争优势等方面,对参评的非上市企业进行评估,覆盖高新技术、人工智能、商业航天、生物科技、新能源、集成电路等战略性新兴产业。拓数派凭借在AI大模型数据计算领域的持续创新、产品能力与产业实践,荣膺安永2026最具潜力种子企业。

OpenPie的博客 160

拓数派「零代码智能体系列」亮相上海平和学校RoboFest机器人科技节,携1024基金会OSC计划助力“超级学生个体”崛起

9月5日,上海平和学校30周年校庆启动仪式暨第三届RoboFest机器人科技节成功举办。本次活动以「聚合·智变」为主题,邀请科技企业、科研机构、专家学者等各界嘉宾齐聚一堂,开启一场集科技展示、学术交流与未来探索于一体的青少年科创教育盛会。拓数派「零代码智能体系列」亮相科技节,为现场师生带来沉浸式AI实践体验,携1024数字产业基金会OSC计划助力“超级学生个体”崛起。拓数派董事长冯雷现场发表主题演讲,并作为揭幕嘉宾参与平和学校校企共建AI实验室暨开发AI合作课程协议的签约仪式。

OpenPie的博客 284

拓数派入选杭州国际数据标注联盟副理事长单位,夯实πDataCS本体能力

8月19日,杭州国际数据标注联盟正式成立,并召开首次会员大会。该联盟由杭州市数据资源管理局指导组建,首批汇聚115家会员单位,涵盖数据标注服务商、AI技术平台、行业解决方案提供商、高校科研机构及行业协会等多元主体,标志着杭州数据标注产业正式迈入生态协同的新阶段。拓数派凭借在数据计算领域的深厚积累和突出实力,成功入选联盟副理事长单位。

OpenPie的博客 226

从零代码智能体到本体,拓数派携手上海理工大学开展2026《工业智能》研究生微专业专场

7月20日至24日,拓数派携手上海理工大学光电信息与计算机工程学院,在上海理工大学光电学院智能教育与信息研究院执行副院长高丽老师的带队下,围绕2026级《工业智能》研究生微专业,开展“零代码智能体”系列教学与实践活动。从开班仪式、校内专项实训,到走进拓数派杭州办公室开展校外实践,校企双方以真实平台、真实课题和产业现场为载体,共同探索工业智能复合型人才培养的新路径。

OpenPie的博客 237

Palantir 中国模式探索:拓数派面向平和教育集团开展培训,共研Ontology与零代码智能体赋能“超级学生”

7月2日至7月3日,拓数派面向平和教育集团中高层管理者开展两场“本体与零代码智能体赋能超级学生个体”研讨活动,共近70位教育管理者走进拓数派上海皋兰路空间,围绕超级学生个体崛起现象下的AI原生实践、教育AI Skills和零代码智能体等课题展开深度学习与现场体验。

OpenPie的博客 213

交大牛津北大等80余所世界知名高校共话AI原生时代组织变革,拓数派创始人冯雷分享Ontology驱动的零代码智能体实践

​6月27日,拓数派董事长冯雷受邀出席由上海交通大学安泰经济与管理学院、《Management and Organization Review》期刊、《南开管理评论》期刊联合主办的“人工智能时代的组织变革与商业模式创新”国际学术研讨会,并在大会实践对谈环节发表主题演讲,系统分享拓数派围绕本体驱动智能体、企业知识组织与业务智能化落地的最新思考与实践。

OpenPie的博客 220

耶鲁牛津剑桥等全球EMBA精英集聚复旦,拓数派董事长冯雷全英文授课“用Ontology实现零代码构建智能体”

6月15日,拓数派董事长冯雷受邀在复旦大学管理学院,面向GNAM(Global Network for Advanced Management)成员,以《0-code Agentic AI with Ontology》为主题开展分享,系统介绍了拓数派围绕"Dynamic Ontology(通常翻译为“本体”)实现零代码构建智能体的前沿理论,深入对比了Palantir 和 OpenPie在Ontoloy标准和技术的交集和差分,分享面向核心业务场景构建智能体的一线实战。

OpenPie的博客 233

解锁一人公司必备技能 | 【OPC w/ 零代码智能体】实践营招募中!

AI智能体的爆发式发展,赋予创业者前所未有的生产力杠杆,由少数人构成、依托多款AI智能体协作的OPC(One Person Company,一人公司)成为AI时代的创业新范式。拓数派于2024年提出“零代码智能体”方法论,以AI工具和技术赋能开发者,有效降低技术壁垒,加速创新落地。由1024基金会主办、拓数派协办的「OPC w/ 零代码智能体」实战营将在皋兰路18号的百年建筑中举行,打造一场兼具技术实操、场景落地与人文氛围的沉浸式体验。

OpenPie的博客 192

开年捷报!拓数派入选第九届世界浙商上海论坛“金种子”企业,政商学界大咖共奔未来

2026年开年之际,拓数派再添喜讯!在1月18日于上海国际会议中心盛大举行的第九届世界浙商上海论坛暨 2025 上海市浙江商会年会上,拓数派(OpenPie)凭借在数据计算核心技术领域的深耕实力与高成长潜力,成功入选 2026 年度 “金种子” 企业名单,以硬核创新开启新年新篇。拓数派创始人兼CEO冯雷受邀出席本次大会并参加“金种子”企业颁奖仪式。

OpenPie的博客 403

拓数派创始人兼CEO冯雷受邀参加《交大安泰校友会AI 应用(智能体)研讨会》,与智谱AI、商汤医疗等共同探讨智能体AI的无限可能

12月28日,“交大安泰校友会第三届 AI 应用(智能体)研讨会”在沪成功举办,拓数派创始人兼CEO冯雷(Ray Von)受邀出席。本次研讨会以“奔赴智能体新征程·锚定 AI 应用创业新蓝海”为主题,通过多维度深度分享与观点碰撞,全景呈现了AI智能体从基础模型进化到垂直行业落地的无限可能。作为AI领域的重要探索者与实践者,拓数派、智谱AI、商汤医疗等企业代表的参与,让本次研讨会成为展现行业前沿动态与实践成果的重要平台。

OpenPie的博客 376

拓数派创始人兼CEO冯雷履职嘉兴海联会常务理事,联动1024基金会捐助香港大埔火灾重建

11月26日,香港新界大埔宏福苑多栋住宅楼发生火灾,造成重大人员伤亡,灾情牵动人心。“一方有难,八方支援”。作为拓数派的姐妹机构,1024数字产业基金会迅速响应浙江省海外联合会倡议,向受灾居民进行捐款,用于紧急救助与灾后重建,传递来自内地的关怀与支持。

OpenPie的博客 202

拓数派元智能体“涵思”亮相「2025乌镇互联网大会」,深度推进智能体落地产业

11月6日-9日,在2025年世界互联网大会“互联网之光”博览会上,拓数派首次展出智能体工厂全新上架产品——“涵思”元智能体。涵思以大模型数据计算系统πDataCS为数据计算底座,采用先进的模块化架构,深度融合数据与智能体AI,能够快速适配用户多样场景,无门槛搭建专属智能体。

OpenPie的博客 437

萧山合伙人论坛第二期:杭州AI十八罗汉拓数派引领“Data+AI”全球赛道,共建智能体AI产业生态

本次论坛不仅展示了拓数派在“可信数据+智能体AI”领域的技术实力与生态影响力,也为政府、企业、资本与科研机构搭建了高效对接的平台。萧山电信、浪潮集团、萧山移动、追形科技等企业则分别从通信服务、算力基础设施、场景应用等关键环节切入,共同推动技术在交通、工业、社会治理等领域的规模化落地。,围绕“产学研创新与数据产业发展”、“AI+增材制造变革”、“垂类AI引擎应用”等主题展开分享,从技术突破、产业融合与实践案例等多维度,呈现。第二场圆桌聚焦《人工智能产业社区的规划与建设》,由拓数派战略市场总监陈罕翰主持,

OpenPie的博客 1070

数贸会多展区亮相!「杭州AI十八罗汉」拓数派用“可信数据+智能体AI”塑造百业未来

9月25日,第四届全球数字贸易博览会(以下简称“数贸会”)在杭州隆重开幕。作为国内唯一一个以数字贸易为主题的国家级、国际性、专业型展会,数字经济领域的国际性盛会,数贸会综合展示全球及中国数字贸易创新成果,吸引了全球目光。在这场数字科技的盛宴中,拓数派旗下的大模型数据计算系统 πDataCS(简称:DataCS)惊艳亮相,现身人工智能、数智出行等多个核心展区,向业界全面展示了以“可信数据+智能体AI”为核心,驱动百行百业数智化升级的创新成果与强大实力。

OpenPie的博客 319

探秘数字科技,共启智创未来:九三学社上城基层委第五支社、第六支社来访“杭州AI十八罗汉”拓数派

数字浪潮奔涌向前,智慧创新重塑时代脉络。9月13日,九三学社上城基层委员会第五支社、第六支社特携手杭州拓数派科技发展有限公司(简称:拓数派,英文名:OpenPie),在杭州办公室为社员搭建“亲身体验科技实践、深度对话行业先锋、精准链接创新资源”的平台,让专业视野与履职使命同频共振。

OpenPie的博客 439

千亿独角兽 Databricks 新赛道的中国答卷:拓数派 DataCS 引领 “可信数据+大模型AI” 新范式

拓数派作为浙江省准独角兽、未来独角兽企业,凭借“数据+模型”基础AI的核心技术优势与阿里云、DeepSeek等头部企业共同入选“杭州基础AI十八罗汉”。作为来自中国的全自主可控的准独角兽,拓数派是“可信数据+大模型AI”赛道的另外一个开拓者,在数据计算相关领域与Databricks在技术视野和商业价值上有很多不谋而合的行业趋势共识。

OpenPie的博客 297

专访|冯雷:走完“最后一公里”路,去无限接近“终极模型”

杭州拓数派科技发展有限公司创始人兼CEO冯雷以“平行空间”思维破题,对数据计算、垂类模型与智能体做出了全新的探索——将原本数据计算系统中杂糅的存储与计算模块分离,打造数据与算力两大彼此独立的“平行空间”。用户初始数据一次进入数据计算系统即实现“隐身”,保证数据安全,“可用不可见,可信计算。”

OpenPie的博客 936

杭州市委常委、萧山区委书记孙旭东带队调研拓数派

7月10日,杭州市委常委、萧山区委书记孙旭东带队调研拓数派,深入了解企业在数据计算领域的技术创新与应用的成果。拓数派创始人兼CEO冯雷(Ray Von)陪同参观,并详细汇报企业发展情况、产品动态及未来战略规划。

OpenPie的博客 341

从实验室到产业:AI Agent构建实体产业智能化的新范

6月14日,由CMU上海校友会、1024Foundarion、Dtalk、MIT上海校友会、北京大学上海TMT校友会、SHU MBA(上海大学MBA)联合主办的【智能新纪元AI Agent如何赋能实体产业】主题沙龙在上海「海舟-拓数派联合创新中心」圆满举办。本次沙龙邀请了多个行业专家作为本次会议的嘉宾,共同探讨:如何锻造产业智能化的核心引擎,聚焦于AI Agent技术如何突破虚拟能力向实体交互的转化瓶颈,构建产业垂类智能体的可持续发展范式。

OpenPie的博客 1051

从实验室到产业:AI Agent构建实体产业智能化的新范式

想象一下,券商给每位分析师配备专属的数字人助手,硅基生物的智能体不再是工具,而是你身边的同事,这已非遥不可及。但像「刷抖音」,没人会想按个按钮就刷完了,因为它本身就是个享受的过程,这就是内生价值。本次沙龙邀请了多个行业专家作为本次会议的嘉宾,共同探讨:如何锻造产业智能化的核心引擎,聚焦于AI Agent技术如何突破虚拟能力向实体交互的转化瓶颈,构建产业垂类智能体的可持续发展范式。AI能放大我们的能力,辅助我们进行有价值的思考,但企业的灵魂、长期愿景和价值观,必须由人,尤其是企业家来坚守和定义。

OpenPie的博客 865

“AI十八罗汉” 拓数派:赋能企业打造专属的智能体工场

拓数派旗下大模型数据计算系统 πDataCS(简称:DataCS)以独创的「简墨」主动元数据认知系统,实现”数据+模型“自主耦合,为企业在大模型时代连续训练与开发AI垂类模型和智能体提供了关键底座支撑。在智算时代浪潮中,DataCS 推动 AI 智能体的百花齐放,助力企业打造专属的智能体工场。拓数派作为 AI 大模型数据计算领域的开创者,建立了下一代可信数据空间和计算空间的前沿标准,并在信创硬件完成了软硬一体的系统构建。作为AI基础领域的“十八罗汉”,拓数派将持续深耕,DataCS 智能体工厂。

OpenPie的博客 365

“AI十八罗汉” 拓数派:赋能企业打造专属的智能体工场

6月6日,由中国投资发展促进会创投专委会、杭州市创投协会及上城区未来产业专班联合主办的中国独角兽俱乐部2025私享会“遇见杭州AI十八罗汉”暨“元聚上城 创享未来”创业沙龙在杭州圆满举行。在2025年万物生长大会上,杭州市创投协会与微链共同发布了杭州AI卧龙图,于业界引起了巨大反响。拓数派凭借在 AI 基础领域的深厚积累与卓越成就,作为卧龙图中基础AI领域的“AI十八罗汉”代表,受邀亮相本次活动。

OpenPie的博客 389

校企合作新篇章,「拓数派 x 哈工大」联手共探数据计算的无限可能

聚焦国家战略新兴产业和工程学科交叉专业人才需求,为深入贯彻中央人才工作会议精神,探索创新工程技术人才培养模式,杭州拓数派科技发展有限公司与哈尔滨工业大学计算学部正式达成合作,宣布成立"拓数派"专项班,以校企协同育人之力,为行业发展注入强劲动能,共同探索数据计算与AI智能体的无限可能,开启产教融合新篇章!

OpenPie的博客 487

校企合作新篇章,「拓数派 x 哈工大」联手共探数据计算的无限可能

而哈工大计算学部,作为国内顶尖的计算学科教育科研高地,整合了计算机科学与技术学院、国家示范性软件学院、网络空间安全学院等优质资源,全力打造世界一流的计算学科群,在人工智能、数据科学、生物信息、网络安全、软件工程、物联网等前沿领域,持续产出突破性成果。通过校企联合培养模式,学生将深入接触 AI 智能体、数据计算、数据库等前沿领域,零距离学习拓数派旗下大模型数据计算系统 πDataCS 的创新技术与应用实践,深入了解其在AI智能体领域的强大功能和创新价值。本次“拓数派”专项班的成立,

OpenPie的博客 490

中流奋楫 | 拓数派荣晋《中国未来独角兽TOP100》、《浙江省未来独角兽TOP100》等多项榜单

作为首次升格为浙江省科创品牌的年度盛会,本届大会汇聚全球创新创业创投领域的领军人物、顶尖学者、创新企业家及资深投资人,共探数智时代科技创新发展新路径,并首发了与独角兽相关的的省级榜单、《杭州AI卧龙图》等众多奖项。同时,DataCS 向下兼容大数据时代的数据应用,支持文本、向量、图、时序、时空等多模态数据的混合检索,广泛应用于语义检索、知识图谱、知识库、实时预警等多样化应用场景,加速多模态 AI 应用落地。同被列入“卧龙图”的,还有“杭州六小龙”、云器科技、Rokid、百应科技等多家优质企业。

OpenPie的博客 466

拓数派和中船海舟强强联合,全面推动国产「工业软件x大模型数据计算」生态

拓数派,作为全球大模型数据计算领域的开创者,以 “Data Computing for New Discoveries”「数据计算,只为新发现」为使命,颠覆式创造了平行的可信数据空间和计算空间,以旗下大模型数据计算系统 PieDataCS(又称πDataCS,简称DataCS)彻底消除了数据孤岛和算力烟囱,并引领了软硬一体的信创系统和国家标准构建。而中船海舟,作为工业领域的资深企业,在工业软件研发与应用方面积累了深厚的行业经验和技术沉淀,推动了行业的数字化转型进程。

OpenPie的博客 570

拓数派荣获“浙江省高新技术企业研究开发中心”认定

日前,浙江省经济和信息化厅公示了2024年度认定(备案)省级企业研发机构名单。根据多轮专家考察和评审,拓数派凭借在数据计算领域的突出成就和创新实力,成功获批 “浙江省高新技术企业研究开发中心”。

OpenPie的博客 378
上一篇: 「AI4AI」AI for All Initiative:推动人工智能的普及普惠
下一篇: 向量数据库 PieCloudVector 进阶系列丨打造音乐推荐系统
OpenPie|拓数派
OpenPie|拓数派 杭州拓数派科技发展有限公司官方账号 杭州拓数派科技发展有限公司官方账号
博客等级 码龄4年 667粉丝 185原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值