

高质量新闻数据集OpenNewsArchive:880万篇主流新闻报道,国产大模型开源数据又添猛料

中文新闻分类 数据集_NLP-新闻文本分类实战 一、赛题理解赛题名称:零基础入门NLP之新闻文本分类 赛题目标:通过这道赛题可以引导大家走入自然语言处理的世界,带大家接触NLP的预处理、模型构建和模型训练等知识点。 赛题任务:赛题以自然语言处理为背景,要求选手对新闻文本进行分类,这是一个典型的字符识别问题。赛题数据赛题以匿名处理后的新闻数据为赛题数据,数据集报名后可见并可下载。赛题数据为新闻文本,并按照字符级别进行匿名处理。整合划分出14个候选... 阅读详情
AI摘要

文章介绍了大模型语料数据联盟开源的OpenNewsArchive数据集,包含880万篇新闻文章,覆盖多主题和来源,旨在提升模型的文本生成和理解能力。数据集经过严格清洗,提供给研究者和数据科学家丰富的训练资源,强调其全面性、无毒性和时效性。

在构建国产大语言模型的道路上,高质量新闻是不可或缺的重要语料之一。这类语料集准确性、逻辑性、时效性于一体,同时包含丰富的事实知识,可以大幅提升模型的文本生成质量、词汇表达能力、事件理解分析能力以及时序内容的适应性和预测能力,使其在现实世界的应用中更加准确和可靠。

近日 ,为了更好地满足大模型研发的数据需求,大模型语料数据联盟开源了大规模、高质量新闻数据集——开放新闻库数据集(OpenNewsArchive),提供了多个主流媒体来源、多种主题类型、共计880万篇新闻文章信息,为研究人员和数据科学家提供了丰富的文本数据资源。一起来看看。

一、开放新闻库介绍(OpenNewsArchive)
开放新闻库(OpenNewsArchive)数据集是由OpenDataLab联合蜜度、商汤等多家联盟机构进行开源开发,其中包含了880万篇新闻文章的信息,涵盖了各种不同主题和来源的新闻内容。每篇新闻文章包括字段如标题、内容、发布日期、语言等,且数据集的内容经过数据清洗去重等处理,为研究人员和数据科学家提供了丰富的文本数据资源。

下载链接:https://opendatalab.com/OpenDataLab/OpenNewsArchive

数据集具有三大亮点:

● 内容全面覆盖多个板块:包含财经、健康、军事、体育、房产、社会、学术等多个板块分类的新闻内容,涵盖广泛。

● 无毒性内容和价值偏见:新闻内容不含有害信息或偏见观点,确保信息公正客观。

● 保持新闻内容更新:数据集中包含的新闻发布日期主要集中在2023年,相较于其他已知的开放新闻数据集,具有较高的时效性,有利于提高模型预测的准确性与应对能力。

二、数据处理方法

1. 处理HTML标签:针对文本中含有HTML标签的部分进行清洗,去除标签并保留文本内容的可读性。

2. 清洗无效文本:删除全文无标点的文本和文本长度过短的部分,确保数据集中的文本质量。

3. 清除特殊字符:删除文本中的特殊字符,包括emoj表情、特殊符号等,保持文本干净规范。

4. 处理重复内容:去除重复的段落,确保每个新闻内容唯一。

5. 清洗混入的不明文本:逐行检查处理文本中包含关键词的句子或内容,确保数据集的纯净性。

6. 删除非法语言部分:排除非汉语和英语以外的语言内容,确保数据集的语言合法性。

三、数据信息

1. 基本信息

● 数据模态:纯文本数据

● 主要语言:中文、英文;(中文占比超过99.9%)

● 数据量:27GB;880万篇文章

● 数据格式:以Jsonlines形式存储的语料文本与附加信息

2.  统计信息
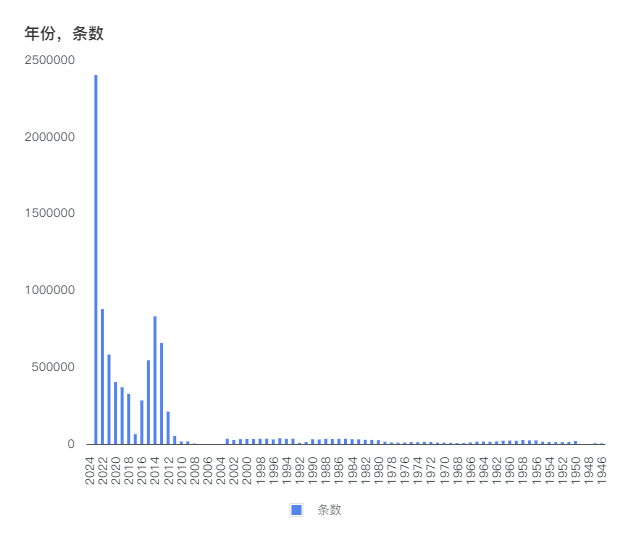
图片

(开放新闻库数据集中2023年发布的新闻最多)

3. 数据样例

{"id": "Bl4ERwIANjygAeAMbr6A","content": "如今的NBA,来到一个群雄争霸的时代,因为老一辈超级球星还没完全跌落神坛,像詹姆斯、杜兰特、库里、哈登、欧文等球员,仍能带领球队保持一定的竞争力,与此同时,各新生代年轻球星也冉冉升起,要逐渐成为联盟未来的门面了,最有潜力的当属锡安、亚历山大、福克斯、文班亚马这些球员。此外,联盟还不缺乏那种大器晚成的球星,像现役三大统治级别球员,约基奇、字母哥和恩比德,他们在职业生涯早期并没有大放异彩,如今都已成为联盟TOP5级别的超级球星。在这样的环境之下,新赛季豪门球队众多,竞争相当激烈,大多数球队都拥有两个或以上的明星级别球员。\n不过说实话,有些球队虽然阵容豪华,但球星之间适配性不够强,产生不了良好的化学反应,一个典型的例子就是独行侠。独行侠拥有东契奇和欧文两大球星,他们还是上赛季联盟唯一一支,拥有两个全明星首发球员的队伍。即便如此,独行侠最终位仅列西部第11,季后赛的门票都没拿到。东契奇和欧文个人属性太重叠,都需要持球发动进攻,且两人防守端偏弱,同时在场时外线必然要出现防守漏洞。此外,快船这样的球队也有些华而不实,主要原因在于“卡椒”组合,伤病隐患太大,一到季后赛就出岔子,威少爷也不在巅峰期了。\n还有一些球队,他们阵容好看,硬实力也强,比如说西部这边的太阳,东部这边的凯尔特人,雄鹿。太阳现在是杜兰特+比尔+布克的三巨头坐镇,而凯尔特人经过休赛期的阵容变动之后,目前拥有4名全明星球员,那就是塔图姆、布朗、波尔津吉斯和霍勒迪。然而实际上,绿军主要还是围绕着双探花,塔图姆和布朗两个球员打,他们也是这支球队的绝对核心。塔图姆和布朗这对双人组合,下限真的超级高,自他俩进入NBA加盟凯尔特人以来,还从来都没有缺席过季后赛,过去6个赛季甚至带领球队4次闯进东决,一次闯进总决赛。\n上赛季,塔图姆场均可以砍下30.1分8.8篮板4.6助攻,而布朗场均可以得到26.6分6.9篮板3.5助攻,双探花场均轰出57+15+8,力压湖人詹眉,76人登帝,快船卡椒,勇士库汤等组合,成为联盟场均得分最高的二人组。新赛季,两人也将继续向NBA最强二人组发起挑战,唯一能对他们造成威胁的,可能就是雄鹿的利拉德+字母哥“表字”组合了,不过从季前赛前几场比赛的表现来看,字母哥统治力还在,利拉德的状态却有些堪忧,连拉了两场,刚加盟雄鹿,他也需要一段时间和球队进行磨合,雄鹿能否取得更大突破,还要等常规赛来考证。\n狂轰57+15+8!你们才是NBA最强二人组!东部豪门崛起,新赛季冲冠。话题回到凯尔特人,双探花组合下限确实足够高,但他们还从未联手拿到过总冠军,最可惜的是21-22赛季,凯尔特人与金州勇士在总决赛舞台一决高下,当时那支勇士队,被认为是巅峰已落幕,所有人都在看好绿军夺冠,最终他们却没能达到这一目标。其实这几年,凯尔特人屡次止步于季后赛后几轮,双探花的一些短板也显露了出来。塔图姆的缺点就在于自己不太稳定,关键球总是处理不好,容易上头。而布朗控运球能力太差,毫无组织能力,球商也不高,只有做二当家的命了。\n尽管如此,双探花现在也算年轻,还有上升空间,而凯尔特人依然属于联盟第一梯队的球队,媒体《体育画报》邀请部分球探及专家,对各个赛区的球队新赛季排名进行了预测,凯尔特人就稳居东部第一,在GM调查中,绿军新赛季的夺冠支持率与丹佛掘金并列第一,为33%,他们仍是冲冠机会最大的球队之一。根据球队队记说法,首发五虎+普理查德+霍福德+豪瑟+科内特大概率作为新季绿军9人轮换,值得一提的是,普理查德这名平民球员也值得关注,季前赛他的表现非常出色,场均能得到接近20分。你们来预测一下,绿军新赛季可以走多远呢?","title": "轰57+15+8!你们才是NBA最强二人组!东部豪门崛起","language": "zh","date": "2023-10-19","num_words": 870,"max_word_length": 6,"frac_chars_non_alphanumeric": 0.10888443553774214,"frac_chars_dupe_5grams": 0,"frac_chars_dupe_9grams": 0}

(左右滑动查看全部)

4. 数据字段格式

以下表格记录了数据各字段的字段名,意义,数据类型和取值说明:
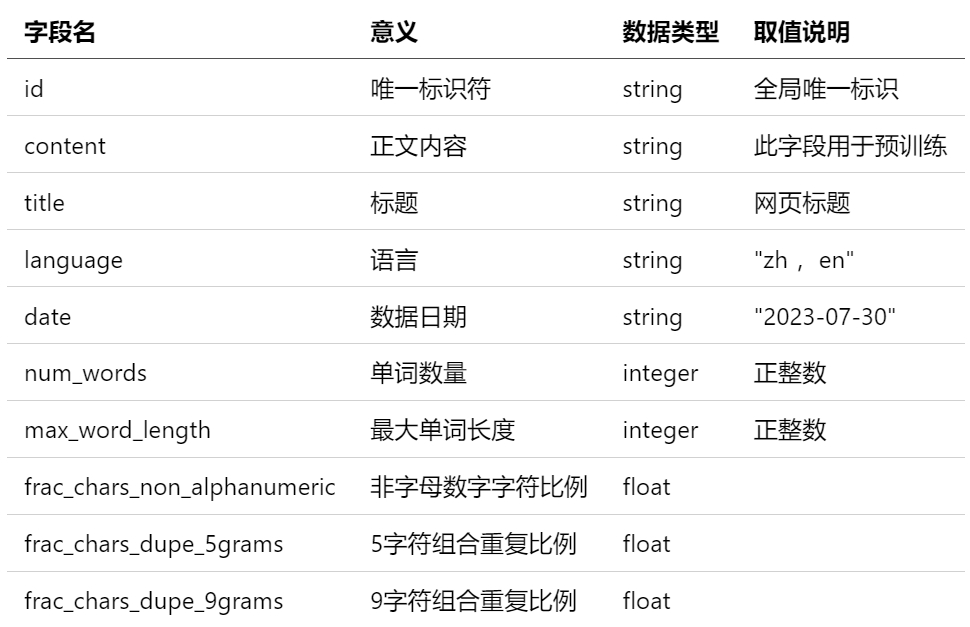
图片

四、许可

开放新闻库数据集整体采用CC BY 4.0许可协议。您可以自由共享、改编该数据集,唯需遵循以下条件:

● 署名:您必须适当地标明作者、提供指向本协议的链接,以及指明是否(对原始数据集)做了修改。您可以以任何合理的方式这样做,但不能以任何方式暗示许可人同意您或您的使用。

● 没有附加限制:您不得使用法律条款或技术措施来限制他人执行许可证允许的任何操作。完整协议内容,请访问CC BY 4.0协议全文。

特别注意事项

请注意,本数据集的某些子集可能受制于其他协议规定。在使用特定子集之前,请务必仔细阅读相关协议,确保合规使用。更为详细的协议信息,请在特定子集的相关文档或元数据中查看。

OpenDataLab作为非盈利机构,倡导和谐友好的开源交流环境,若在开源数据集内发现有侵犯您合法权益的内容,可发送邮件至(OpenDataLab@pjlab.org.cn),邮件中请写明侵权相关事实的详细描述并向我们提供相关的权属证明资料。我们将于3个工作日内启动调查处理机制,并采取必要的措施进行处置(如下架相关数据)。但您应确保您投诉的真实性,否则采取措施后所产生的不利后果应由您独立承担。


开放新闻库数据集已上架OpenDataLab官网,浏览器访问:https://opendatalab.com/OpenDataLab/OpenNewsArchive

pytorch--新闻标题数据集文本分类 2023.3.8 阅读详情

相关推荐

7万条体育新闻数据集:探索文本分类与机器学习

本文还有配套的精品资源,点击获取 简介:本数据集包含7万条体育新闻条目,适合研究和教学使用,尤其在文本分类和机器学习领域。用户应了解,使用此数据集可能涉及商业责任。数据预处理是必需步骤,包括清理文本和分词。可用于构建多种机器学习模型,包括朴素贝叶斯、SVM、决策树和深度学习方法。在模型训练后,可以自动分类体育新闻,有助于自动化信息筛选和管理。 1. 体育新闻数据集概述...

weixin_31641077的博客 1287

python-新闻文本分类详细案例-(数据集见文末链接)

文章目录主要任务所用数据集一、导入相关包二、数据分析1.读取数据2. jieba分词并去除停用词3. TF-IDF4. 网格搜索寻最优模型及最优参数5. 预测并评估预测效果总结 主要任务 新闻文本数据包含四类新闻,分别用1,2,3,4 表示。 (1)首先读取数据; (2)然后通过利用 jieba 对文本进行分词并去除停用词; (3)再运用 TF-IDF 将文本转换为机器学习分类算法能够识别的数字特征, (4)再通过网格搜索 在 LogisticRegression, MultinomialNB,Rand

weixin_47176703的博客 1万+

新闻分类检测数据集整理与模型应用指南

本文还有配套的精品资源,点击获取 简介:新闻分类检测是自然语言处理的重要任务,涉及文本挖掘、机器学习和深度学习等技术。数据集的整理对于构建和评估新闻分类模型至关重要,它包括数据集的重要性、结构、预处理、特征提取、模型选择、训练与验证、评估指标、模型调优以及模型部署等。本指南旨在提供一个全面的实践和比较不同算法的平台,促进AI在新闻领域的应用。 1. 新闻分类检测概...

weixin_42327217的博客 1193

BERT文本分类——基于toutiao今日头条新闻数据集

训练曲线和测试结果,并且得到了训练权重,喜欢的小伙伴可关注公众号回复“BERT美团”获取源代码和训练好的权重文件。_分割的个字段,从前往后分别是 新闻ID,分类code(见下文),分类名称(见下文),新闻字符串(仅含标题),新闻关键词。原始数据有382688条,需要训练时间很久,小编只选了1600条,需要的小伙伴自己用服务器去跑吧!经过10轮训练,训练结果如下,可以看到效果已经很不错了。然而当数据量骤增,分类目标较多的时候,上述模型就不再使用,这时就需要将数据放到。”,即可获取源代码和训练好的权重文件。

小嘤熊的博客 6269

新闻数据集(对应新闻文本分类案例)

该新闻数据集与 https://blog.youkuaiyun.com/weixin_47176703/article/details/124304692?spm=1001.2014.3001.5501此篇python项目-新闻文本分类详细对应,代码详尽,读者可自取实现。

新闻分类数据集.zip

这些数据是从 inshorts 新闻网页应用收集的。该数据集包含 3 列,分别命名为news_headline、news_article和news_category。它还包含来自 7 个不同类别的新闻,例如科技sports、politics、entertainment、world和。automobilescience

中文大数据训练的数据集

上述数据集涵盖了广泛的领域,包括新闻、社交媒体、评论、百科问答、机器翻译等。不同的数据集针对不同的NLP任务,可以根据需要选择适合的数据集进行模型训练。在选择适合的高质量数据集是训练中文大模型的关键。上述列举的资源涵盖了多个领域和应用场景,可以根据具体需求对数据进行二次处理和清洗,以提高训练效果。在获取和使用这些数据集时,也要注意遵守相关的数据使用政策和版权规定。

qq_34068440的博客 4968

THUCNews 新闻数据集.7z

THUCNews 数据集是根据新浪新闻 2005~2011 年间的历史数据筛选过滤生成,包含 74 万篇新闻文档,均为 UTF-8 纯文本格式。此数据集在原始新浪新闻分类体系的基础上,重新整合划分出 14 个候选分类类别:财经、彩票、房产、股票、家居、教育、科技、社会、时尚、时政、体育、星座、游戏、娱乐

ML之NB:基于20newsgroups数据集(20类新闻文本)利用NB朴素贝叶斯算法(CountVectorizer/TfidfVectorizer+去除停用词)进行分类预测、评估

​ ML之NB:基于20newsgroups数据集(20类新闻文本)利用NB朴素贝叶斯算法(CountVectorizer/TfidfVectorizer+去除停用词)进行分类预测、评估 目录 相关文章 基于20newsgroups数据集(20类新闻文本)利用NB朴素贝叶斯算法(CountVectorizer/TfidfVectorizer+去除停用词)进行分类预测、评估 相关文章 ML之NB:基于news新闻文本数据集利用纯统计法、kNN、朴素贝叶斯(高斯/多元伯努利/多项式)、

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 1万+

新闻分类数据集sample(thu)

新闻分类数据集.gz 新闻分类数据集sample(thu)

嵌入式学习之QT学习---14 QT跨平台运行之把QT程序交叉编译到ARM开发板

想要把qt工程放到开发板上运行,就需要用到交叉编译。由于qt是跨平台的,所以只需要换个编译器编译一下就可以。 以“定时器”的例子为例,在移植之前还需要进行一个准备工作,在windows下运行的时候,电脑屏幕很大,但是运行的窗口只有一点点大,开发板也有外接屏幕,如何让运行窗口自动适配开发板的外接屏幕呢?令其占满屏幕显示,而不是一小块。 第一步:需要设置一下,先给ui布局,如果不布局,控件就不会随着屏幕的大小的变化而变化。 第二步:利用代码来获取屏幕的大小,给widget.cpp文件下添加如下代码 #inclu

qq_42822743的博客 5457

【文本处理与分类】使用cnews新闻数据集进行文本分类(包含分词、词云、文本关键词提取等)

使用cnews新闻数据集进行文本分类(包含分词,数据清洗、词云、文本关键词提取等内容)

QHCV的博客 4313

深入解析AMBA5 AXI与ACE协议:从基础到高级应用

本文深入解析了AMBA5 AXI与ACE协议的核心机制与应用。AXI协议通过分离通道、突发传输和乱序完成实现高性能数据传输,而ACE协议在此基础上构建了硬件级缓存一致性解决方案,通过监听机制和状态模型确保多核系统数据统一。文章还探讨了在异构计算等复杂场景下的实战应用与AMBA5的新特性。

cc789的博客 961

NewsRecommendation

文章目录简介问题定义背景Problem Definition评价指标数据集已有的模型 简介 NewsRecommendation是Recommendation的一个子领域,但是新闻推荐系统不同于其他的推荐系统,还需要对新闻文本进行处理,之前NewsRecommendation这个领域没什么进展是因为缺乏相关的数据集,Microsoft最近刚刚开源了MIND数据集,可以使用MIND数据集来研究新闻推荐系统的相关模型算法** *关于MIND数据集的介绍可以参考这篇paper:MIND: A Large-scal

qq_43753721的博客 3534

J-SCOPE实战:除了看波形,如何用它和JLink-RTT模式高效调试你的STM32变量?

本文详细介绍了如何利用J-SCOPE和JLink-RTT模式高效调试STM32变量,实现实时数据可视化。通过对比HSS和RTT模式的优劣,提供固件端配置、J-SCOPE设置及实战应用案例,帮助开发者快速掌握这一高效调试技术,特别适用于电机控制、传感器融合等需要实时监控的场景。

weixin_29159613的博客 445

HALCON深度学习模型部署新选择:一份详细的OpenVINO 2021.4 LTS集成与配置避坑指南

本文详细介绍了如何将HALCON深度学习模型与OpenVINO 2021.4 LTS集成,提供环境配置、硬件加速优化及故障排除的实用指南。特别针对Intel独立显卡的AI加速器接口进行优化,帮助机器视觉工程师提升AI推理效率,适用于工业检测等高要求场景。

weixin_42531779的博客 238

文本分类(情感分析)——中文数据集汇总

会不定期发布相关设计内容包括但不限于如下内容:信号处理、通信仿真、算法设计、matlab appdesigner,gui设计、simulink仿真......希望能帮到你!

小嘤熊的博客 2万+

STM32驱动2.8寸TFTLCD屏幕实战:从看懂原理图到点亮第一个像素(基于ILI9341)

本文详细介绍了如何使用STM32驱动2.8寸TFTLCD屏幕(基于ILI9341驱动芯片),从硬件连接到软件配置,包括FSMC接口设置、ILI9341初始化序列、坐标设置及基础绘图函数实现。文章还提供了常见问题排查指南和性能优化技巧,帮助开发者快速解决屏幕不亮等问题,并提升显示性能。

weixin_42665255的博客 267

fetch_20newsgroups(20类新闻文本)数据集入门

fetch_20newsgroups数据集包含来自20个不同新闻组的文本数据。每个新闻组都包含多篇新闻文档,总共约有18,000篇文档。该数据集的文本数据涵盖了多个主题,包括科技、政治、体育、娱乐等。每个文档都被分配了一个特定的标签,表示其所属的新闻组类别。fetch_20newsgroups数据集是一个常用的用于文本分类任务和主题建模任务的基准数据集之一。本文介绍了fetch_20newsgroups(20类新闻文本)数据集的入门,以及如何使用Python的sklearn库加载和预处理该数据集。

牛肉胡辣汤 6032

华为OD机试 - 小扇和小船的数字游戏 - 二进制(Python/JS/C/C++ 2024 C卷 200分)

二进制表示:任何数 n 的二进制表示中,要找到下一个有相同数量的1的数,我们需要在最低位的0后面的最低位的1进行操作。右侧交换法则:找到右侧的第一个0,位于第一个1的左边,将这个0变成1(提升这个位),并将这个1变成0(下移这个位)。调整尾部1:为了得到最小的数,将所有低于已交换的1的位重置,使得所有1尽可能靠右。

学Java,找哪吒 1162

Arduino、ESP32驱动SFA40甲醛传感器(气体传感器篇)

SFA40甲醛传感器是一款基于盛思锐电化学原理的专业HCHO检测模块,具备卓越的抗酒精干扰能力(乙醇交叉敏感度<0.3%)、高达±20ppb的检测精度及0~1000ppb的宽量程。该传感器内置SHT4X温湿度传感器进行自动补偿,确保数据的长期稳定性;其小尺寸、低功耗的特性,可快速集成至智能家居、空气净化器、物联网环境监测等系统中,实现对甲醛浓度的精准、可靠监测。

不脱发的程序猿 302

新闻分类(文本分类)

新闻分类 主要使用贝叶斯进行分类 numpy pandas jieba sklearn 1.数据读取 首先读取数据,并对数据进行清洗 import numpy as np import pandas as pd newdata = pd.read_table("数据集路径",names=['label','theme','URL','content'],encoding='utf-8') newdata = df_news.dropna()#删除缺失值 #查看数据维度 newdata.shape #查

adasdfadsa的博客 3122

水声信号处理开源算法库最新进展

欢迎关注本专栏,一起探索新世界大家好,我是ZhuChunSHU。985院校硕士毕业,现担任算法研究员一职,热衷于深度学习算法研究与应用。曾获得阿里云天池比赛第三名,CCE比赛第五名,科大讯飞Q比赛第六名。拥有多项发明专利。对机器学习和深度学习拥有自己独到的见解。曾经辅导过若干个非计算机专业的学生进入到算法行业就业。希望和大家一起成长进步。今天继续我们的专栏分享!!!!!!!!!!!!!!!!!!!!水声信号处理是海洋科学与工程领域的核心组成部分,对于水下通信、目标探测、海洋环境监测以及生物声学研究至关重要。

u012133341的博客 1254

全网新闻数据(SogouCA)版本:2012可下载

官网下载地址:搜狗实验室(Sogou Labs)自己下载报404错误 最近在做分词,发现sogou数据集官网失效,下载不了,找了很久,为了方便大家下载 链接: https://pan.baidu.com/s/18KfG3aG2Jcxj6JKBbQFfKA 提取码: 3j16 ...

weixin_44358484的博客 4781

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

数据集下载渠道汇总

Hugging Face – The AI community building the future. Machine Learning Datasets | Papers With Code

sslfk的博客 3万+

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

上一篇: 有点意思!腾讯 ARC Lab 最新发布的MiraData数据集,用于长视频生成,从这些方面做了clip分层描述……
下一篇: 百万总奖池 | 浦源大模型挑战赛(夏季赛)·安全可信赛道正式启动!
OpenDataLab
博客等级 码龄4年 636粉丝 135原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值