

80TB!58.5亿!世界第一大规模公开图文数据集LAION-5B 解读

基于PySpark的10亿级数据集LAION-5B元数据快速处理实践(全文分享) 多模态大模型训练如火如荼展开,但以LAION-5B为代表的大规模多模态数据集获取却成了一个令人头疼的问题。OpenDataLab两位工程师在浦数 AI Talk做了非常实用的LAION-5B下载经验分享,我们整理了其,希望能对大家下载同类数据集提供帮助和参考。 阅读详情
AI摘要

LAION-5B是一个包含58.5亿个图像-文本对的超大规模数据集,比LAION-400M大14倍,是当前最大规模的多模态数据集。该数据集可用于多模态预训练、图文匹配、图像生成等多种任务,并提供了多种子集和模型以支持不同方向的研究。

继去年LAION-400M[1]这个史上最大规模多模态图文数据集发布之后,今年又又又有LAION-5B[2]这个超大规模图文数据集发布了。

其包含 58.5 亿个 CLIP [5]过滤的图像-文本对的数据集,比 LAION-400M 大 14 倍,是世界第一大规模、多模态的文本图像数据集,共80T数据,并提供了色情图片过滤、水印图片过滤、高分辨率图片、美学图片等子集和模型,供不同方向研究。

一起来看看。


今年大火的DALL·E 2 再次掀起了多模态图文匹配研究热潮。

在图文匹配领域,CLIP[5]模型使得在ImageNet上的zero-shot分类精度从11.5%提升到76.2%,受此启发,ALIGN[3]、BASIC[4]等大型图文多模态模型进一步改进,除了本身的模型优化之外,目前的进展其实都比较依赖底层的上亿图文对数据,但这些数据集及模型仅有少数公开,所以LAION提出了LAION-5B及在该数据集上训练的模型,并提供web界面提供预先计算的向量和搜索功能。
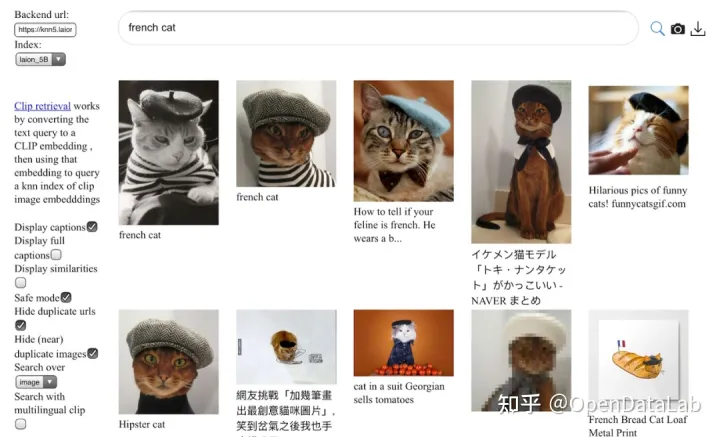
图1: LAION-5B检索样例。数据来源:https://laion.ai/blog/laion-5b/

LAION-5B通过CommonCrawl获取文本和图片,OpenAI的CLIP计算后获取图像和文本的相似性,并删除相似度低于设定阈值的图文对(英文阈值0.28,其余阈值0.26),500亿图片保留了不到60亿,最后形成58.5亿个图文对,包括23.2亿的英语,22.6亿的100+语言及12.7亿的未知语言。

官网:

https://laion.ai/blog/laion-5b/

数据集信息:

https://opendatalab.org.cn/LAION-5B

论文:

https://openreview.net/pdf?id=M3Y74vmsMcY

LAION-400M介绍:

https://mp.weixin.qq.com/s/vzyOF4esJCkBZDMiNScE5A

今天介绍围绕以下几个点展开:

一、数据集背景信息

二、LAION-5B有什么

三、LAION可以做什么任务

四、如何使用LAION


一、数据集背景信息

CLIP[5]、DALLE[6]这些模型证明了大规模多模态数据的重要性,即使不需要手动标注,也能超越很多优秀的有监督模型,经典如CLIP使用400M对网络图文对进行训练,不仅在ImageNet上zero-shot超越在ImageNet 1.2M有监督数据上训练的resnet50性能1.9%,并且能够识别普通视觉模型无法识别的素描图、油画图、艺术图等(图2)。


紧接着发布的ALIGN[3]、GLIDE[12]等证实了这一点,但是这些大型数据集都没有开源,因此这一领域的研究,只集中在少数几个机构中,2021年公布的LAION-400M[1]是当时最大的公开图文数据集,本次发布的LAION-5B[2]是LAION-400M的14倍,足够规模的公开数据使得该领域的研究更多元化,能够让更多的研究者参与到这一领域的研究中。

图2: CLIP能够识别素描图、油画图和艺术图,但ResNet对这些识别较差。数据来源:https://openai.com/blog/clip/

各个机构陆续发布过多模态数据集及图像数据集,但是由于数量不多或并未公开,并不能在多模态预训练模型上取得较好的效果,这里将LAION和以前的部分数据集进行了简单对比。

1.1 图文对数据集

最开始,数据集均通过人工注释生成,如COCO[7]和Visual Genome[8],COCO Captions在COCO图片数据基础上,由人工标注图片描述得到。Visual Genome是李飞飞2016年发布的大规模图片语义理解数据集,含图像和问答数据,标注密集,语义多样。这两个数据集主要用于图像生成描述(Visual Genome也可以用于图像问答),然而由于图片数量较少,仅有330k和5M对,模型发展受到限制。

后来逐渐出现了非人工注释的多模态数据集,如Conceptual Captions 3M[9]和Conceptual Captions 12M[16],对应描述从网站的alt-text属性过滤而来。随着CLIP模型的出现,大规模预训练模型逐渐成为多模态领域趋势,类似的还有ALT200M[10]和ALIGN1.8B[3],数据集规模逐渐扩大到数十亿,虽然没有经过人工注释,但由于数据量大,在NLP、零样本视觉推理、多模态检索等多种下游任务中仍能取得良好甚至SOTA的效果。但可惜的是,CLIP所使用的4亿图文对以及ALIGN等数据集均没有公开。

去年公开的LAION-400M拥有4亿图文对,是当时最大的公开图文数据集,一经公开获取了很好的反响,也有多个模型基于该数据进行训练取得了较好效果,但相较官方CLIP仍有轻微差距,并且LAION-400M中含有大量令人不适的图片,对于模型,尤其是生成模型影响较大。比如stable diffusion模型,很多人会用来生成色情图片,产生了不好的影响,更大更干净的数据集成为需求。

这次公开的LAION-5B除了扩大规模之外,还提供了一些模型进行过滤,LAION训练了色情内容识别模型NSFW过滤绝大部分不适图片,水印检测模型可以过滤水印图片,由于部分隐私或不适内容若删除会影响研究丰富性,所以在总体数据内不会删除,会提供不同的子集用于不同用途。

1.2 图像数据集

大型如Instagram-1B、JFT300M、JFT3B均为私有数据集,暂未公开。
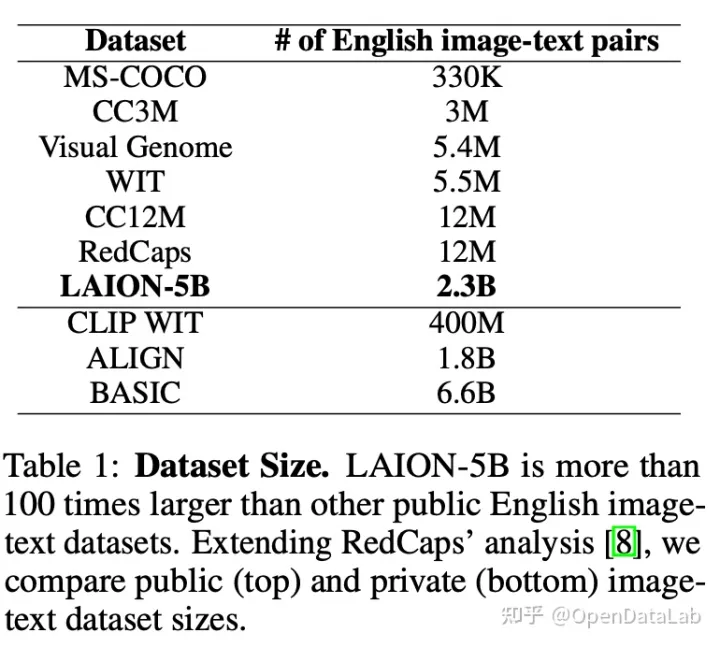
图3: 数据集大小比较,公开数据集(top)和私有数据集(bottom)。LAION-5B比其他公开数据集大100倍,数据来源:[2]

LAION-5B的数据规模目前最大,可以对许多未公开的多模态模型进行训练并获得较好效果,并公开了第一个开源的CLIP模型。并且数据多样,包含各种领域图片,对于后续研究提供了更多的方向,比如数据重叠、图片噪声、不适图片筛选、低资源语言、自然语言对于多模态的作用、模型偏差等等。

但如果将LAION-5B直接应用于工业,需要注意清洗图片,因为LAION-5B中含水印图片及不适图片,模型会因此产生偏差。

二、LAION-5B有什么

在LAION400M发布之后,在接连的研究中发现了未过滤引起的问题,受这些启发,除了50亿图文对之外,LAION还提供了多种子集。之前的研究中,为了限制生成模型不生成种族主义图片,尝试在训练集中删除了与暴力相关的物体、人和面部的图像,然而,这显然限制了模型的通用能力—比如人脸生成。因此,为了研究的多样性,在整体数据集中并没有删除此类内容,而是提供了多种子集。

除此之外,LAION还提供了复现的CLIP等模型,展示了基于LAION训练的模型拥有不输于原模型的能力。和KNN索引、Web界面方便检索合适的图片。

当然,为了大规模数据集方便下载,LAION也提供了img2dataset分布式下载,可以指定图像和文本大小,可以20个小时内单个节点下载1亿张图像(1Gbps速度,32G内存和16个内核的i7 CPU)

2.1 子集

LAION-5B中包括23.2亿的英语,22.6亿的100+语言及12.7亿的未知语言,我们将子集分别标记为:

● laion2B-en

● laion2B-multi

● laion1B-nolang

LAION训练了一个基于CLIP嵌入的色情内容识别模型NSFW,可以过滤3%的不适图片,NSFW准确率约96%,过滤后有子集:

● laion2B-en-safety

● laion2B-multi-safety

● laion1B-nolang-safety

LAION训练了一个水印识别模型,过滤后有子集:

● laion2B-en-watermark

● laion2B-multi-watermark

● laion1B-nolang-watermark

一个170M的超分辨率子集:

● laion-high-resolution

一个120M的美学图片子集,可以用来做图片生成:

● laion-aesthetic

更多可以参考:

https://huggingface.co/laion

2.2 开源模型

对现有未开源的多模态模型,LAION在子集上重新训练或微调,取得了较好的效果。

CLIP:通过openCLIP开源了CLIP模型,分别在LAION-400M和LAION-5B上训练,前者效果略低于OpenAI,后者zero-shot效果高于OpenAI。

BLIP:重新在LAION-400M中115M子集上训练,再使用CLIP对候选描述排序,评测后优于其他模型,用于描述生成和图文匹配。

Glide:在LAION-2B对Glide模型进行微调,获得了不错的效果。

除此之外,还提供了水印识别模型和色情内容识别模型NSFW。

2.3 KNN index/web界面

LAION使用autofaiss工具构建了KNN索引,共800GB。

为了方便使用,将索引集成到网站中。web界面基于查询图像/文本来搜索图像/文本。通过CLIP的embedding来检索语义相似性较高的图像文本,鉴于高分辨率图片的丰富性,可以生成图像子集来训练自定义模型,也可以选择特定训练目的的图像分辨率。

检索网站左侧添加了safe mode,可以筛选不适图片。

检索网站:

Clip front​rom1504.github.io/clip-retrieval/?back=https%3A%2F%2Fknn5.laion.ai&index=laion5B&useMclip=false

图4: web检索demo

三、LAION可以做什么任务

LAION提供了大规模的图文数据,可以用来做大部分多模态及CV工作,多模态方面包括大规模预训练、图文匹配、图像生成(图像生成、图像修复/编辑等)和文本生成(图像生成文本、VQA等)等下游任务,CV方面包含分类等,LAION也提供了使用数据集训练的模型作为参考。

3.1 图文匹配及多模态预训练

包括但不限于任务:多模态预训练、图文匹配、图文检索。

CLIP模型使用对比学习将图像和文本嵌入到相同空间,标志着图像-文本的多模态的进展,用于图文匹配/检索、zero-shot分类等领域。但CLIP并未公开训练数据,因此LAION分别使用LAION-400M和LAION-2B重新训练了CLIP模型,准确率和OpenAI版本不相上下。

3.2 生成任务

● 图像生成

包括但不限于任务:高分辨率图像生成、图像修复/编辑、文本生成图片、条件图像生成。

LAION提供了子集来过滤不适图片和水印图片,为图像生成进一步提供了条件。目前有不少模型可以基于LAION子集来生成,DALLE[6]这种自回归模型或者GLIDE[12]这种扩散模型,以下给出几个例子:

- Stable Diffusion[13]使用LAION-5B的子集,在压缩的空间对图像进行重建,可生成百万像素的高分辨率图片,用于图像修复、图像生成等。

- VQ-Diffusion[14]模型使用矢量量化变异自动编码器,在LAION-400M训练文本生成图像的模型,获得更高的图像质量。

- Imagen[15]在LAION-400M的子集上训练,使用强大的语言模型抽取特征,并指导生成对应文本的高质量图像,击败DALLE-2[20]实现SOTA。

- 也可以挑选其中领域图片进行生成,如人脸生成FARL[17]。

● 文本生成

包括但不限于任务:图像生成文本、VQA、Visual Entailment

- BLIP[18]重新在LAION-400M中115M子集上训练,再使用CLIP对候选描述排序,评测后优于其他模型,用于描述生成和图文匹配。

- MAGMA[19]在LAION子集上训练,基于适配器的微调来增强语言模型的生成,为视觉问题生成答案,仅使用simVLM的0.2%的数据量但生成了较好的结果。

3.3 分类任务

可以做zero-shot、finetune和训练。

通过web搜索子集或官方提供的子集,可以做构建分类识别,水印识别、色情内容识别、面部特征学习等等。也可以通过提供的大规模预训练模型,在下游任务做zero-shot和finetune。
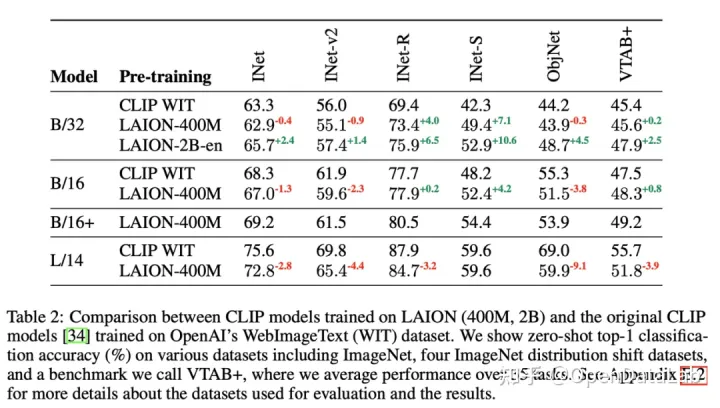
图5: 对比了WIT(官方)、在LAION-400M和LAION-2B-en上训练的CLIP模型在下游数据集的zero-shot性能对比,可以看到LAION训练的模型性能优越。数据来源:[2]

3.4 其他任务

LAION数据丰富,可以筛选需要的数据做其他任务,比如可以在LAION-2B-multi中筛选指定语言数据做低资源语言任务,可以做数据重叠对模型的影响、模型偏见等等。

四、如何使用LAION

对于有丰富GPU资源的同学,在训练任务时,可以使用全集/子集数据进行大规模训练。对于资源相对有限的同学,无法进行大规模训练,依然可以使用LAION预训练模型进行zero-shot、finetune等研究,也可以将其作为图像资源池自行检索所需图像。

4.1 大规模训练

可以使用全集/子集来训练,完成多模态、视觉领域相关任务,往往对资源需求较大。

● 全集为58.5亿图文对,通过CLIP过滤,含有少量噪声和不适数据。

● 子集参考2.1中提供的多种子集,包括但不限于无不适图片子集、无水印子集、超分辨率子集、美学子集等等。

● 如果没有合适的子集,也可以通过web检索页面,到合适的数据下载,可以生成图像子集进行训练,也可以选择适合训练的图像分辨率,该方法的好处是可以根据自定义场景选择图片。

4.2 少量训练

对于资源有限的工程师,可以选择LAION-5B中所需数据和LAION-5B提供的预训练模型,进行训练。

● 数据方面

可以选取LAION-5B的部分数据进行训练,比如通过web检索界面检索自定义场景图片,或者使用有/无水印图片、高分辨率图片、美学分数较高图片等等,进行小规模训练。

● 模型方面

可以使用LAION提供的预训练模型对下游进行zero-shot、few-shot或finetune。

- zero-shot/few-shot:官方提供了大规模预训练的开源模型,CLIP、BLIP等,效果显著,基于LAION训练的CLIP性能与原模型不相上下。基于LAION-400M训练的CLIP性能可以参考图6。

- finetune:官方提供了微调方式供参考:https://github.com/mlfoundations/wise-ft,也可以采取常规的finetune方式进行训练。
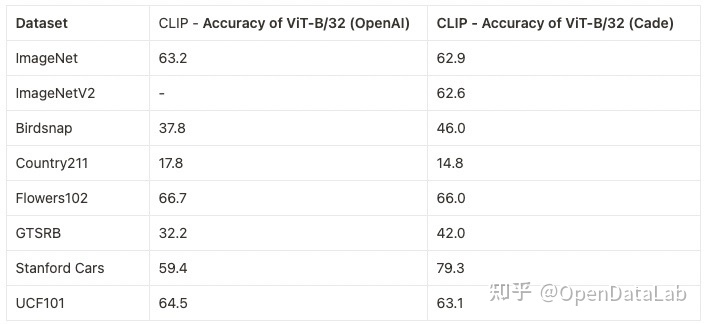
图6: CLIP基于LAION-400M对ImageNet、ImageNetV2、Birdsnap、Country211、Flowers102、GTSRB、Standford Cars、UCR101等数据集进行测试,和OpenAI的CLIP性能不相上下。数据来源:https://github.com/mlfoundations/open_clip

五、总结

LAION-5B,这个包含超过50亿图像文本对的数据集,进一步扩展了语言视觉模型的开放数据集规模,使得更多研究者能够参与到多模态领域中。并且为了推动研究,提供了多个子集用于训练各种规模的模型,也可以通过web界面检索构建子集训练。已有多个模型和论文证明了基于LAION子集训练的模型能够取得良好甚至SOTA的效果。

参考文献

[1] Christoph Schuhmann, Richard Vencu, Romain Beaumont, Robert Kaczmarczyk, Clayton Mullis, Aarush Katta, Theo Coombes, Jenia Jitsev, and Aran Komatsuzaki. Laion-400m: Open dataset of clip-filtered 400 million image-text pairs. arXiv preprint arXiv:2111.02114, 2021.

[2]Christoph Schuhmann, Romain Beaumont, Cade W Gordon, Ross Wightman, mehdi cherti, Theo Coombes, Aarush Katta, Clayton Mullis, Patrick Schramowski, Srivatsa R Kundurthy, Katherine Crowson, Richard Vencu, Ludwig Schmidt, Robert Kaczmarczyk, Jenia Jitsev. LAION-5B: An open large-scale dataset for training next generation image-text models,2022.URL https://openreview.net/pdf?id=M3Y74vmsMcY

[3]Chao Jia, Yinfei Yang, Ye Xia, Yi-Ting Chen, Zarana Parekh, Hieu Pham, Quoc V. Le, Yun- Hsuan Sung, Zhen Li, and Tom Duerig. Scaling up visual and vision-language representation learning with noisy text supervision. CoRR, abs/2102.05918, 2021. URL https://arxiv. org/abs/2102.05918.

[4]Hieu Pham, Zihang Dai, Golnaz Ghiasi, Hanxiao Liu, Adams Wei Yu, Minh-Thang Luong, Mingxing Tan, and Quoc V Le. Combined scaling for zero-shot transfer learning. arXiv preprint arXiv:2111.10050, 2021.

[5]Alec Radford, Jong Wook Kim, Chris Hallacy, Aditya Ramesh, Gabriel Goh, Sandhini Agarwal, Girish Sastry, Amanda Askell, Pamela Mishkin, Jack Clark, et al. Learning transferable visual models from natural language supervision. In International Conference on Machine Learning, pages 8748–8763. PMLR, 2021.

[6]Aditya Ramesh, Mikhail Pavlov, Gabriel Goh, Scott Gray, Chelsea Voss, Alec Radford, Mark Chen, and Ilya Sutskever. Zero-shot text-to-image generation. CoRR, abs/2102.12092, 2021. URL https://arxiv.org/abs/2102.12092.

[7]Tsung-YiLin,MichaelMaire,SergeBelongie,JamesHays,PietroPerona,DevaRamanan,Piotr Dollár, and C Lawrence Zitnick. Microsoft coco: Common objects in context. In European conference on computer vision, pages 740–755. Springer, 2014.

[8]Ranjay Krishna, Yuke Zhu, Oliver Groth, Justin Johnson, Kenji Hata, Joshua Kravitz, Stephanie Chen, Yannis Kalantidis, Li-Jia Li, David A Shamma, et al. Visual genome: Connecting language and vision using crowdsourced dense image annotations. International journal of computer vision, 123(1):32–73, 2017.

[9]Piyush Sharma, Nan Ding, Sebastian Goodman, and Radu Soricut. Conceptual captions: A cleaned, hypernymed, image alt-text dataset for automatic image captioning. In Proceedings of the 56th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), pages 2556–2565, Melbourne, Australia, July 2018. Association for Computational Linguistics. doi: 10.18653/v1/P18-1238. URL https://aclanthology.org/P18-1238.

[10]Xiaowei Hu, Zhe Gan, Jianfeng Wang, Zhengyuan Yang, Zicheng Liu, Yumao Lu, and Li- juan Wang. Scaling up vision-language pre-training for image captioning. arXiv preprint arXiv:2111.12233, 2021.

[11]Olga Russakovsky, Jia Deng, Hao Su, Jonathan Krause, Sanjeev Satheesh, Sean Ma, Zhiheng Huang, Andrej Karpathy, Aditya Khosla, Michael Bernstein, Alexander C. Berg, and Li Fei-Fei. ImageNet Large Scale Visual Recognition Challenge. International Journal of Computer Vision (IJCV), 115(3):211–252, 2015. doi: 10.1007/s11263-015-0816-y.

[12]Alex Nichol, Prafulla Dhariwal, Aditya Ramesh, Pranav Shyam, Pamela Mishkin, Bob McGrew, Ilya Sutskever, and Mark Chen. Glide: Towards photorealistic image generation and editing with text-guided diffusion models, 2021. URL https://arxiv.org/abs/2112.10741.

[13]Robin Rombach, Andreas Blattmann, Dominik Lorenz, Patrick Esser, and Björn Ommer. High- resolution image synthesis with latent diffusion models. CoRR, abs/2112.10752, 2021. URL https://arxiv.org/abs/2112.10752.

[14]Shuyang Gu, Dong Chen, Jianmin Bao, Fang Wen, Bo Zhang, Dongdong Chen, Lu Yuan, and Baining Guo. Vector quantized diffusion model for text-to-image synthesis. CoRR, abs/2111.14822, 2021. URL https://arxiv.org/abs/2111.14822.

[15]Chitwan Saharia, William Chan, Saurabh Saxena, Lala Li, Jay Whang, Emily Denton, Seyed Kamyar Seyed Ghasemipour, Burcu Karagol Ayan, S. Sara Mahdavi, Rapha Gontijo Lopes, Tim Salimans, Jonathan Ho, David J Fleet, and Mohammad Norouzi. Photorealistic text-to-image diffusion models with deep language understanding, 2022. URL https://arxiv.org/abs/ 2205.11487.

[16]Soravit Changpinyo, Piyush Sharma, Nan Ding, and Radu Soricut. Conceptual 12m: Pushing web-scale image-text pre-training to recognize long-tail visual concepts. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, pages 3558–3568, 2021.

[17]YinglinZheng,HaoYang,TingZhang,JianminBao,DongdongChen,YangyuHuang,LuYuan, Dong Chen, Ming Zeng, and Fang Wen. General facial representation learning in a visual- linguistic manner. CoRR, abs/2112.03109, 2021. URL https://arxiv.org/abs/2112. 03109.

[18]Junnan Li, Dongxu Li, Caiming Xiong, and Steven Hoi. Blip: Bootstrapping language- image pre-training for unified vision-language understanding and generation, 2022. URL https://arxiv.org/abs/2201.12086.

[19]Constantin Eichenberg, Sidney Black, Samuel Weinbach, Letitia Parcalabescu, and Anette Frank. MAGMA - multimodal augmentation of generative models through adapter-based finetuning. CoRR, abs/2112.05253, 2021. URL https://arxiv.org/abs/2112.05253.

[20]Aditya Ramesh, Prafulla Dhariwal, Alex Nichol, Casey Chu, and Mark Chen. Hierarchical text-conditional image generation with clip latents, 2022. URL https://arxiv.org/abs/ 2204.06125.

作者丨Jorie 希望世界和平无bug

- End -

以上就是本次分享,更多精彩的数据集干货,不容错过。还有哪些想看的内容,快来告诉小助手吧。更多数据集上架动态、更全面的数据集内容解读、最牛大佬在线答疑、最活跃的同行圈子……欢迎添加微信opendatalab_yunying加入OpenDataLab官方交流群。

AIGC系列之:CLIP和OpenCLIP CLIP(sd v1版本)、OpenCLIP(sd v2版本)等模型将人类语言(文字)编码为计算机语言(语义向量)。训练CLIP(OpenCLIP)则需要一个图文配对的数据集。数据集来自LAION-5B,由50亿个图片以及图片对应的标签组成。包含23.2亿的英文描述, 阅读详情

相关推荐

图文多模态公开数据集归纳(图文情感分类、图文检索)|有中英文文本、含下载地址

图文多模态的公开数据集下载地址汇总~包括图文情感分类、图文分类、图文检索等

weixin_43092343的博客 9333

laion数据集介绍及下载

laion是一个大型的文生图数据集,官方网址为,它有很多的子集,比如laion-400M,laion-coco等等。

weixin_45440780的博客 1万+

Stable Diffusion 数据集构建与前处理实战:LAION、COCO 与自有图文数据全流程解析

在训练或微调 Stable Diffusion 等扩散模型时,构建高质量图文配对数据集是模型生成能力的基础保障。本文结合当前主流开源数据集(如 LAION-400M、COCO Caption)与企业/个人自有图文资源,系统剖析数据筛选、图像处理、Prompt 清洗、Token 化、增强与格式标准化的完整流程,并提供针对扩散模型训练的工程实践路径,助力开发者构建适用于大规模生成的高质量语义数据集。

努力分享一些人工智能、计算机视觉、影像等相关的知识干货! 1659

首个大规模图文多模态数据集LAION-400M介绍

openAI的图文多模态模型CLIP证明了图文多模态在多个领域都具有着巨大潜力,随之而来掀起了一股图文对比学习的风潮。就在前几天(2022年12月),连Kaiming都入手这一领域,将MAE的思路与CLIP的思路结合,推出了FLIP,有兴趣可戳(https://arxiv.org/abs/2212.00794)。对于迷茫的CV研究生,如果你找不到研究方向,just follow Kaiming绝对不会出错。今天要介绍的是一个优秀的图文多模态数据集LAION,跟CLIP原始训练数据集就有相当体量,即400个m

木盏 1万+

Laion5B数据集下载,laion2B-en数据集下载,百度云盘,阿里云盘

存在此文件》看大小》不大就断点续传。不存在此文件》断点续传。

q742971636的博客 2622

数据集-(图像-文本):LAION【史上最大规模多模态图文数据集,包含58.5亿个图像-文本对】

之前的研究中,为了限制生成模型不生成种族主义图片,尝试在训练集中删除了与暴力相关的物体、人和面部的图像,然而,这显然限制了模型的通用能力—比如人脸生成。紧接着发布的ALIGN[3]、GLIDE[12]等证实了这一点,但是这些大型数据集都没有开源,因此这一领域的研究,只集中在少数几个机构中,2021年公布的LAION-400M[1]是当时最大的公开图文数据集,本次发布的LAION-5B[2]是LAION-400M的14倍,足够规模的公开数据使得该领域的研究更多元化,能够让更多的研究者参与到这一领域的研究中。

u013250861的博客 5672

2022年AI顶级论文 —生成模型之年(上)

过去十年来,人工智能技术在持续提高和飞速发展,并不断冲击着人类的认知。2012年,在ImageNet图像识别挑战赛中,一种神经网络模型(AlexNet)首次展现了明显超越传统方法的能力。2016年,AlphaGo在围棋这一当时人们认为其复杂性很难被人工智能系统模拟的围棋挑战赛中战胜了世界冠军。2017年,Google的Ashish Vaswani等人提出了 Transformer 深度学习新模型架构,奠定了当前大模型领域主流的算法架构基础。

与君共勉,一起学习 3647

stable diffusion模型训练时数据量

laion2B-en数据集,是laion5B的一个子集,更具体的说它是laion-5B中的英文数据集,laion-5B是从网页数据common crawel中筛选出来的图像文本对,包含5.85B的图像文本对,其中文本为英文的数据量为2.32B,这就是laion-2B-en数据集。在laion-2B-en数据集上评分为5以上训练的,先用256x256,再用512x512,用了32台8卡A100 40G,bs=32x8x2x2=2048。在laion-2B-en数据集上评分为4.5以上训练的,

liguandong 3773

【亲测免费】 LAION 数据集使用教程

LAION 数据集使用教程 项目介绍 LAION(Large-scale Artificial Intelligence Open Network)是一个非营利组织,致力于推动机器学习研究领域的开放与免费资源共享。该组织提供了包括 LAION-400M 和 LAION-5B 在内的大规模图像文本对数据集,共计超过数十亿的数据点,旨在促进公开教育和资源的环保利用,鼓励通过复用现有数据集和模型来减少重...

gitblog_00155的博客 1719

多模态-图文生成-数据集:COCO、LAION

多模态-图文生成-数据集:COCO、LAION。

u013250861的博客 1136

数学分析五领域全景:实分析、复分析、泛函分析、傅里叶分析、凸分析

五种分析,五种视角,同一个目标。理解一个系统,首先要找到它的不变量。

li880862的博客 192

LAION-SG:一个大规模、高质量的场景图结构注释数据集,为图像-文本模型训练带来了革命性的进步。

2024-12-03,由浙江大学、江南大学、北京大学、阿里巴巴集团和蚂蚁集团联合创建的LAION-SG数据集,通过提供高质量的场景图(SG)结构注释,显著提升了复杂场景图像生成的性能,为图像-文本模型训练带来了革命性的进步。

u011559552的博客 1885

深度强化学习系列(13): 策略梯度(Policy Gradient)

对于DQN来说使用一个网络直接逼近了值函数,最后取得了非常不错的效果, 但是对于一些连续性控制或者动作空间特别大的环境来说,很难全部计算所有的值函数来得到最好的策略,那么直接计算策略的方法就别提出来了。 回顾一下前面几篇,所谓的策略,其实就是状态到动作的映射数学表达为 π:s→aπ:s→a\pi : s \to a, 我们用ττ\tau 表示状态s到最后一个状态的一个序列,表示为: τ:st...

深度强化学习(DeepRL)探索博客 4642

Stable Diffusion模型训练数据LAION-5B深度分析

LAION-5B(Large-scale Artificial Intelligence Open Network)是当前最大的公开多模态图像-文本数据集,包含58.5亿个经过CLIP筛选的图像-文本对。这个数据集为Stable Diffusion等生成式AI模型的训练提供了关键的数据基础,彻底改变了多模态AI研究的格局。 ## 数据集规模与组成 LAION-5B由三个主要子集构成,每个子集都...

gitblog_00694的博客 727

2026年全国青少年信息素养大赛算法应用主题赛(C++赛项初赛模拟卷1及答案解析)

2026年全国青少年信息素养大赛算法应用主题赛(C++赛项初赛模拟卷1及答案解析)

王老师青少年编程 2023

YOLOv11改进 | Conv改进篇 | 含2种改进,引入DynamicConv替换普通Conv卷积下采样和C3k2_DynamicConv替换C3k2(来自CVPR2024)

本文提出了一种基于DynamicConv动态卷积优化的YOLOv11轻量化模型改进方案。通过引入多专家机制的动态卷积模块,在增加模型参数量的同时保持较低的计算复杂度(FLOPs),有效解决了低FLOPs模型在大规模预训练中的性能瓶颈问题。文章详细介绍了动态卷积的工作原理、核心代码实现,并提供了在YOLOv11中集成DynamicConv和C3k2_GhostModule_DynamicConv模块的完整教程,包括模块添加、配置文件修改和模型训练验证过程。实验结果表明,该方案在保持高效推理速度的同时显著提升了

Ai缝合怪、助力小伙伴高效发论文 537

德国法院允许非营利组织LAION抓取受版权保护的图像用于AI训练

法院虽然承认LAION的行为涉及版权相关的复制,但根据德国版权法第60d条的规定,将其认定为非商业科学研究允许的文本和数据挖掘行为。这可能涉及到版权法的修订、新的许可机制的建立,或者是AI公司与内容创作者之间新型合作模式的探索。特别是像OpenAI这样的公司,它们在没有获得许可的情况下使用网上的版权数据进行训练的做法,可能面临更多法律挑战。这起德国法院的裁决为AI与版权之间的关系提供了新的思考角度。在人工智能快速发展的今天,一场发生在德国汉堡的法庭裁决为AI训练数据的收集和使用带来了新的讨论。

weixin_41446370的博客 698

【Windows Server 2019】活动目录 (Active Directory) ——将计算机加入域和脱离域

博文介绍了如何将计算机加入AD域和脱离AD域,包括加入域,验证客户机加入到域后的信息,使用域账户用户在客户机上登录,使用本地账户用户在计算机上登录,脱离域。

VMware, Windows, Linux, Cisco, Container, Kubernetes, Kali 6169

数据集创建相关论文

4亿对图像URL和相应的元数据4亿对CLIP图像嵌入和相应的文本在数据集中实现快速搜索的几组kNN索引img2dataset库,可以从URL列表中高效地爬取和处理数以亿计的图像及其元数据LAION - 400M图像-文本搜索的Web演示以CNVid - 3.5 M数据集中的视频-文本对为例。样本中呈现了三种类型的文本信息:1 )主题(人工编写),2 )标题(用户上传),3 ) ASR文本。

handsome_lionet的博客 2585

深入C++学习还必须掌握的一基础知识精讲

施磊C++语言基础提高课程笔记,包括了new/delete;malloc/free;引用和指针;const,指计和引用的结合;函数重载,inline的数,参数带默认值的函数;函数模板等知识点

GeniusAng的博客 1477

深度解读华为Limera:从舱内激光视觉融合看前融合技术的发展与演进

华为Limera激光雷达摄像头融合技术推动自动驾驶感知升级 华为推出的Limera创新性地将激光雷达与摄像头深度集成,采用共光路设计实现数据天然对齐,在小型障碍物识别等关键场景展现卓越性能。该产品代表了传感器前融合技术从分立走向共生的演进趋势,通过硬件级集成解决了多源异构数据融合难题。随着索尼堆叠式传感器等技术的出现,未来智能汽车感知系统将向高度集成的"超级传感器"方向发展,实现更精准的环境感知。Limera的发布标志着前融合技术从"可用"迈向"极致&quo

致力于lidar应用开发 397

Stable Diffusion图像生成质量优化:LAION数据集训练指南

Stable Diffusion图像生成质量优化:LAION数据集训练指南 【免费下载链接】stable-diffusion 项目地址: https://ai.gitcode.com/mirrors/CompVis/stable...

gitblog_00633的博客 989

时间序列分析(Time Series Analysis) 原理与代码实例讲解

时间序列分析(Time Series Analysis) - 原理与代码实例讲解 作者:禅与计算机程序设计艺术 / Zen and the Art of Computer Programming 关键词:时间序列预测,ARIMA模型,状态空间模型,SARIMA模型,机器学习

AI天才研究院 1247

中国团队开源大规模高质量图文数据集ShareGPT4V

这一举措在多模态领域取得了显著的进展,超越了同级别的模型。这一研究为未来的多模态研究和应用提供了有力支持,也促使多模态开源社区关注高质量图像描述的开发,预示着更强大、智能的多模态模型的出现。通过对GPT4-Vision模型产生的10万条图像-文本描述数据进行深入研究,他们成功构建了这一高质量的数据集,涉及的内容丰富多样,包括世界知识、艺术评价等。最终,通过在预训练和有监督微调阶段同时使用ShareGPT4V数据集,他们得到了ShareGPT4V-7B模型,在多模态基准测试中取得了优异的成绩。

睡前人工智能共享实验室 1100

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

Stable Diffusion数据预处理:LAION-5B数据集处理流程

你是否好奇Stable Diffusion如何将文本转化为逼真图像?作为目前最流行的开源文本到图像生成模型之一,Stable Diffusion的能力很大程度上源于其训练数据的质量。本文将深入探讨Stable Diffusion训练过程中关键的数据预处理步骤,特别是针对LAION-5B这一超大规模图像文本数据集的处理流程。通过阅读本文,你将了解到: - LAION-5B数据集的基本情况及其对St...

gitblog_00184的博客 1476

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

史上最大多模态图文数据集发布!

文 | 付瑶编 | 小轶最近多模态研究圈中出现了一个扬言 “史上最大规模”的多模态图文数据集:LAION-400。该数据集在今年8月完全公开,共计公开了 4亿图文对,可以依据不同的用途提供...

夕小瑶科技说 4074

深度学习工具包 DeepLearningToolbox

深度学习工具包Deprecation notice.-----This toolbox is outdated and no longer maintained.There are much better tools available for deep learning than this toolbox, e.g. [Theano](http://deeplearning.net/software/theano/), [torch](http://torch.ch/) or [tensorflow](http://www.tensorflow.org/)I would suggest you use one of the tools mentioned above rather than use this toolbox.Best, Rasmus.DeepLearnToolbox================A Matlab toolbox for Deep Learning.Deep Learning is a new subfield of machine learning that focuses on learning deep hierarchical models of data.It is inspired by the human brain's apparent deep (layered, hierarchical) architecture.A good overview of the theory of Deep Learning theory is[Learning Deep Architectures for AI](http://www.iro.umontreal.ca/~bengioy/papers/ftml_book.pdf)For a more informal introduction, see the following videos by Geoffrey Hinton and Andrew Ng.* [The Next Generation of Neural Networks](http://www.youtube.com/watch?v=AyzOUbkUf3M) (Hinton, 2007)* [Recent Developments in Deep Learning](http://www.youtube.com/watch?v=VdIURAu1-aU) (Hinton, 2010)* [Unsupervised Feature Learning and Deep Learning](http://www.youtube.com/watch?v=ZmNOAtZIgIk) (Ng, 2011)If you use this toolbox in your research please cite [Prediction as a candidate for learning deep hierarchical models of data](http://www2.imm.dtu.dk/pubdb/views/publication_details.php?id=6284)```@MASTERSTHESIS\{IMM2012-06284, author = "R. B. Palm", title = "Prediction as a candidate for learning deep hierarchical models of data", year = "2012",}```Contact: rasmusbergpalm at gmail dot comDirectories included in the toolbox-----------------------------------`NN/` - A library for Feedforward Backpropagation Neural Networks`CNN/` - A library for Convolutional Neural Networks`DBN/` - A library for Deep Belief Networks`SAE/` - A library for Stacked Auto-Encoders`CAE/` - A library for Convolutional Auto-Encoders`util/` - Utility functions used by the libraries`data/` - Data used by the examples`tests/` - unit tests to verify toolbox is workingFor references on each library check REFS.mdSetup-----1. Download.2. addpath(genpath('DeepLearnToolbox'));Example: Deep Belief Network---------------------```matlabfunction test_example_DBNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit RBM and visualize its weightsrand('state',0)dbn.sizes = [100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);figure; visualize(dbn.rbm{1}.W'); % Visualize the RBM weights%% ex2 train a 100-100 hidden unit DBN and use its weights to initialize a NNrand('state',0)%train dbndbn.sizes = [100 100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);%unfold dbn to nnnn = dbnunfoldtonn(dbn, 10);nn.activation_function = 'sigm';%train nnopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.10, 'Too big error');```Example: Stacked Auto-Encoders---------------------```matlabfunction test_example_SAEload mnist_uint8;train_x = double(train_x)/255;test_x = double(test_x)/255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit SDAE and use it to initialize a FFNN% Setup and train a stacked denoising autoencoder (SDAE)rand('state',0)sae = saesetup([784 100]);sae.ae{1}.activation_function = 'sigm';sae.ae{1}.learningRate = 1;sae.ae{1}.inputZeroMaskedFraction = 0.5;opts.numepochs = 1;opts.batchsize = 100;sae = saetrain(sae, train_x, opts);visualize(sae.ae{1}.W{1}(:,2:end)')% Use the SDAE to initialize a FFNNnn = nnsetup([784 100 10]);nn.activation_function = 'sigm';nn.learningRate = 1;nn.W{1} = sae.ae{1}.W{1};% Train the FFNNopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.16, 'Too big error');```Example: Convolutional Neural Nets---------------------```matlabfunction test_example_CNNload mnist_uint8;train_x = double(reshape(train_x',28,28,60000))/255;test_x = double(reshape(test_x',28,28,10000))/255;train_y = double(train_y');test_y = double(test_y');%% ex1 Train a 6c-2s-12c-2s Convolutional neural network %will run 1 epoch in about 200 second and get around 11% error. %With 100 epochs you'll get around 1.2% errorrand('state',0)cnn.layers = { struct('type', 'i') %input layer struct('type', 'c', 'outputmaps', 6, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %sub sampling layer struct('type', 'c', 'outputmaps', 12, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %subsampling layer};cnn = cnnsetup(cnn, train_x, train_y);opts.alpha = 1;opts.batchsize = 50;opts.numepochs = 1;cnn = cnntrain(cnn, train_x, train_y, opts);[er, bad] = cnntest(cnn, test_x, test_y);%plot mean squared errorfigure; plot(cnn.rL);assert(er<0.12, 'Too big error');```Example: Neural Networks---------------------```matlabfunction test_example_NNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);% normalize[train_x, mu, sigma] = zscore(train_x);test_x = normalize(test_x, mu, sigma);%% ex1 vanilla neural netrand('state',0)nn = nnsetup([784 100 10]);opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samples[nn, L] = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.08, 'Too big error');%% ex2 neural net with L2 weight decayrand('state',0)nn = nnsetup([784 100 10]);nn.weightPenaltyL2 = 1e-4; % L2 weight decayopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex3 neural net with dropoutrand('state',0)nn = nnsetup([784 100 10]);nn.dropoutFraction = 0.5; % Dropout fraction opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex4 neural net with sigmoid activation functionrand('state',0)nn = nnsetup([784 100 10]);nn.activation_function = 'sigm'; % Sigmoid activation functionnn.learningRate = 1; % Sigm require a lower learning rateopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex5 plotting functionalityrand('state',0)nn = nnsetup([784 20 10]);opts.numepochs = 5; % Number of full sweeps through datann.output = 'softmax'; % use softmax outputopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex6 neural net with sigmoid activation and plotting of validation and training error% split training data into training and validation datavx = train_x(1:10000,:);tx = train_x(10001:end,:);vy = train_y(1:10000,:);ty = train_y(10001:end,:);rand('state',0)nn = nnsetup([784 20 10]); nn.output = 'softmax'; % use softmax outputopts.numepochs = 5; % Number of full sweeps through dataopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, tx, ty, opts, vx, vy); % nntrain takes validation set as last two arguments (optionally)[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');```[![Bitdeli Badge](https://d2weczhvl823v0.cloudfront.net/rasmusbergpalm/deeplearntoolbox/trend.png)](https://bitdeli.com/free "Bitdeli Badge")

上一篇: 错误标注太多,不想人工检查?试试置信学习来自动找错
下一篇: AI Talk 直播丨自动驾驶系统怎么解决多视角信息融合、数据多模态融合、时空异步问题?
OpenDataLab
博客等级 码龄4年 636粉丝 135原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值