


进入 2026 年,全球大模型技术持续加速演进,新一轮模型发布不断刷新能力边界。行业关注重点从基础能力指标,转向模型在真实复杂场景中的综合表现。各类模型持续强化智能体相关能力,在编程、推理、工具调用与信息检索等关键方向不断提升,全面增强解决实际问题的能力。与此同时,中国大模型在全球舞台上持续受到关注,越来越多模型在海外社区引发热议,展现出中国在大模型日益增强的技术实力与创新活力。
司南持续关注大模型的发展动态,近期针对国内外主流大语言模型进行了全面评测,现公布司南最新(即1月)大语言模型评测榜单!本次榜单囊括了国内外共26个大语言模型,包含国内外主流闭源模型和社区开源模型。
最新榜单解读
-
Gemini-3-Pro-Preview登顶榜单首位
在本次榜单评测中,来自OpenAI、Google、深度求索、字节豆包、通义千问、月之暗面、腾讯混元、讯飞星火等多个厂商发布的模型在各个评测维度展开激烈的竞争。最终由Google发布的Gemini-3-Pro-Preview以其在多个维度上表现出的强大能力,成功登顶榜首,综合得分位列第一。
-
国产模型能力进步显著,跻身榜单前列
在本次榜单评测中,DeepSeek-V3.2、GLM-4.7、Kimi-K2.5、Qwen3-Max-2026-01-23等国内厂商近期最新发布的旗舰模型均以较为优秀的多维度综合能力跻身榜单得分前十;iFlytek-Spark-X1.5-0106、Tencent HY 2.0 Think等国产模型同样紧随其后,体现出国内厂商愈加快速的模型能力迭代速度。总体上看,国产模型呈现出开闭源齐头并进、能力高速进步发展的态势。
-
大模型正式迈入Agent元年
榜单呈现出鲜明的格局重塑特征,国产头部模型如GLM-4.7、Kimi-K2及Qwen3-Max-2026-01-23在工具调用精准度上已完成全球并跑,并在多个执行维度上对传统巨头GPT-5.2-2025-12-11(high)实现了反超。这种全线模型工具调用能力的高位对齐,预示着大模型底层基座已完成向执行侧的架构转型,未来商业化博弈的关键将取决于模型对复杂业务逻辑和物理世界接口的深度渗透力。
榜单更新说明
相较于2025年10月榜单,本次榜单的主要更新包括:
-
新增模型:GPT-5.2-2025-12-11 (high)、Gemini-3-Pro-Preview、Claude Opus 4.5 (Thinking)、Grok-4.1、Doubao-Seed-1-8-251228、Qwen3-Max-2026-01-23、iFlytek-Spark-X1.5-0106、ERNIE 5.0、Tencent HY 2.0 Think、Tencent HY 2.0 Instruct等闭源模型,以及DeepSeek-V3.2、MiniMax-M2.1、GLM-4.7、Kimi-K2.5、Kimi-K2-Thinking、Ring-1T等开源模型。
-
评测内容迭代:持续更新闭源评测数据集,纳入来自CompassArena大模型竞技场的真实用户提问 、最新编程比赛题目、最新高难度学科推理问题等,确保题目有足够的新颖性和一定的难度,能够反映模型的真实差距。另一方面,为提升评测结果稳定性和可信度,本次评测中全量数据集均重复评测四次,以平均分数作为最终结果。
月度榜单评测基准
司南大语言模型官方自建评测榜单,综合评估商业API模型和开源模型在 语言、推理、知识、代码、数学、工具调用六大能力维度,这些维度进一步细化为包括自然语言处理、理工科知识、学科推理、数学竞赛、多轮工具调用等十余项细分任务,以实现对行业开源模型和商业API模型进行全面评测分析。
*不同能力维度会根据任务形式选用主观或客观评测方案。总分基于各能力维度加权获得: 语言(1/8)、推理(1/8)、知识(1/8)、代码(1/8)、数学(2/8)、工具调用(2/8)。
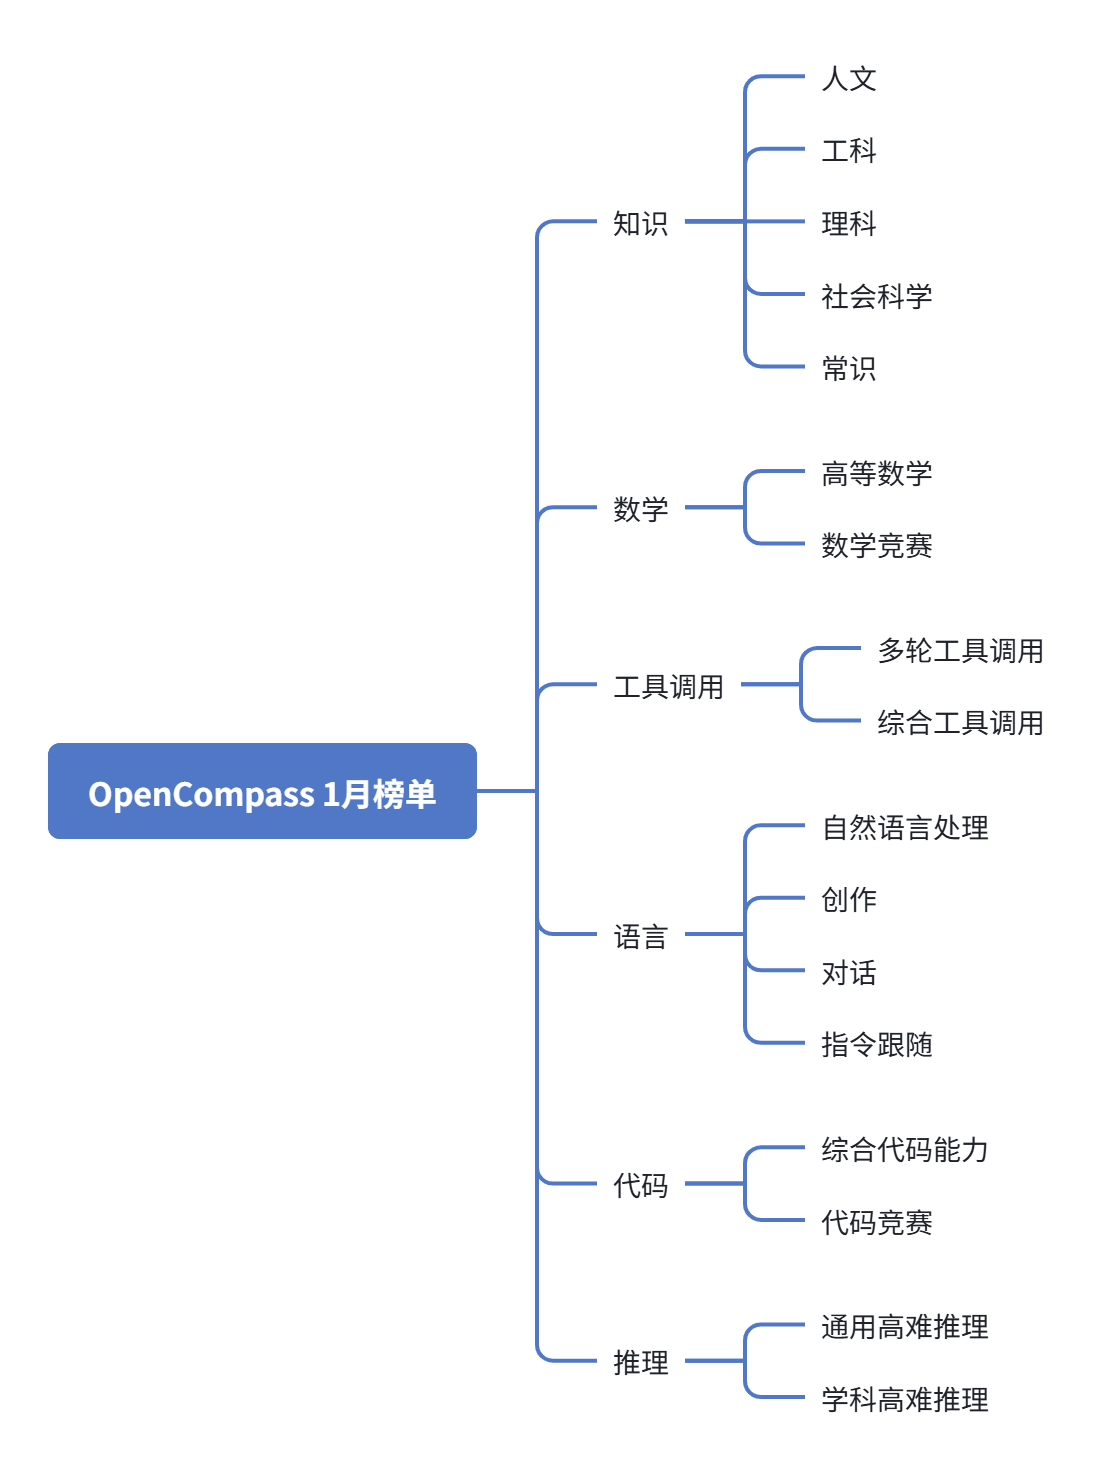
最新榜单概览
综合榜单
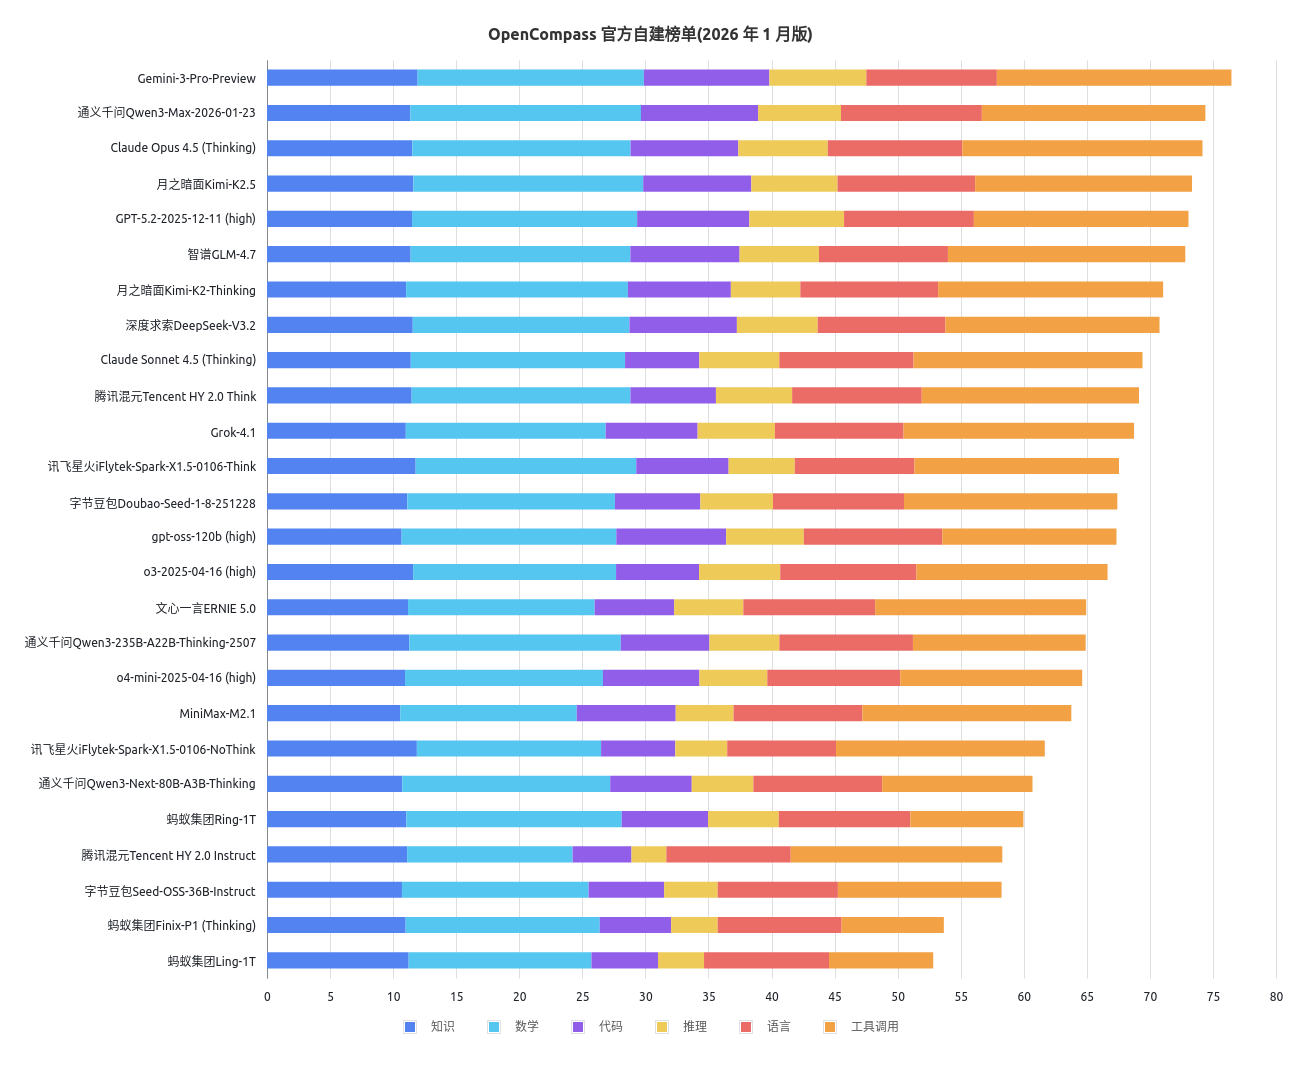
子维度榜单
-
语言
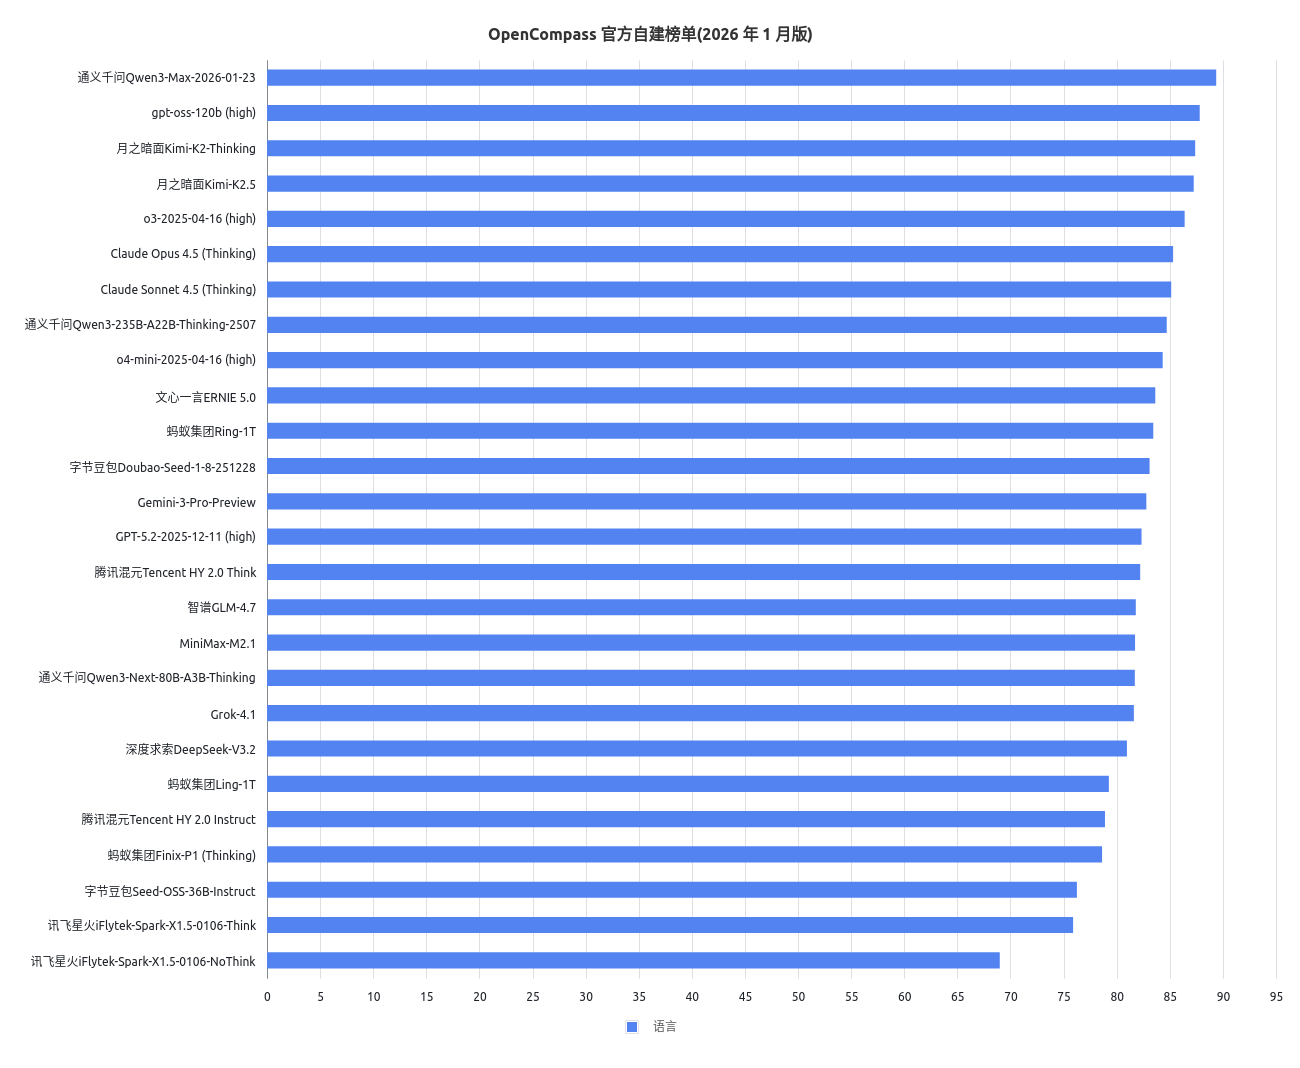
-
推理
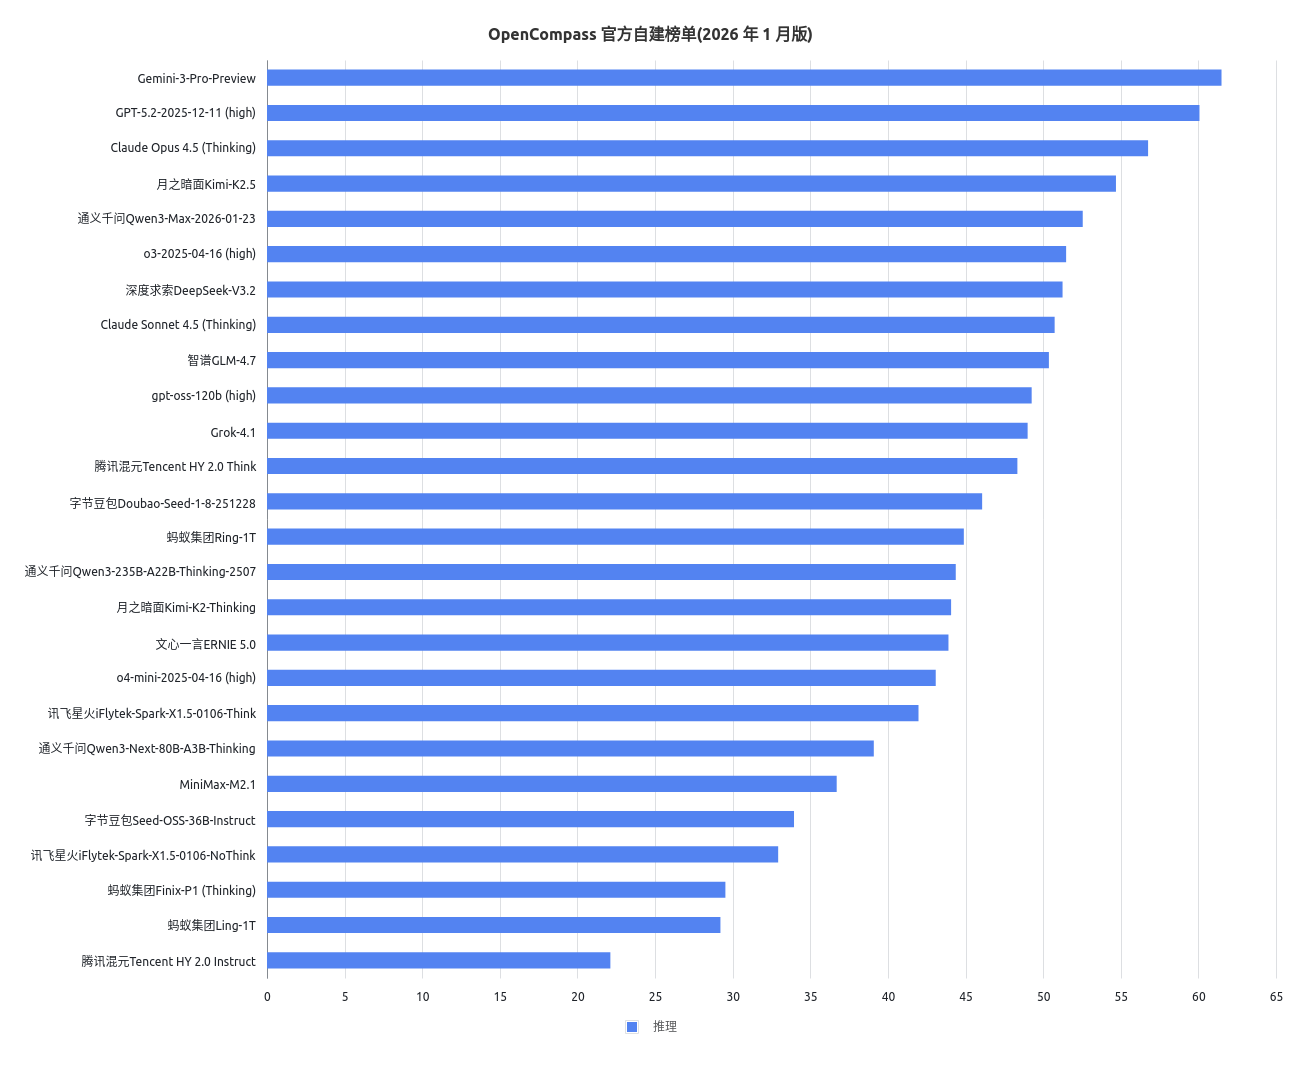
-
知识
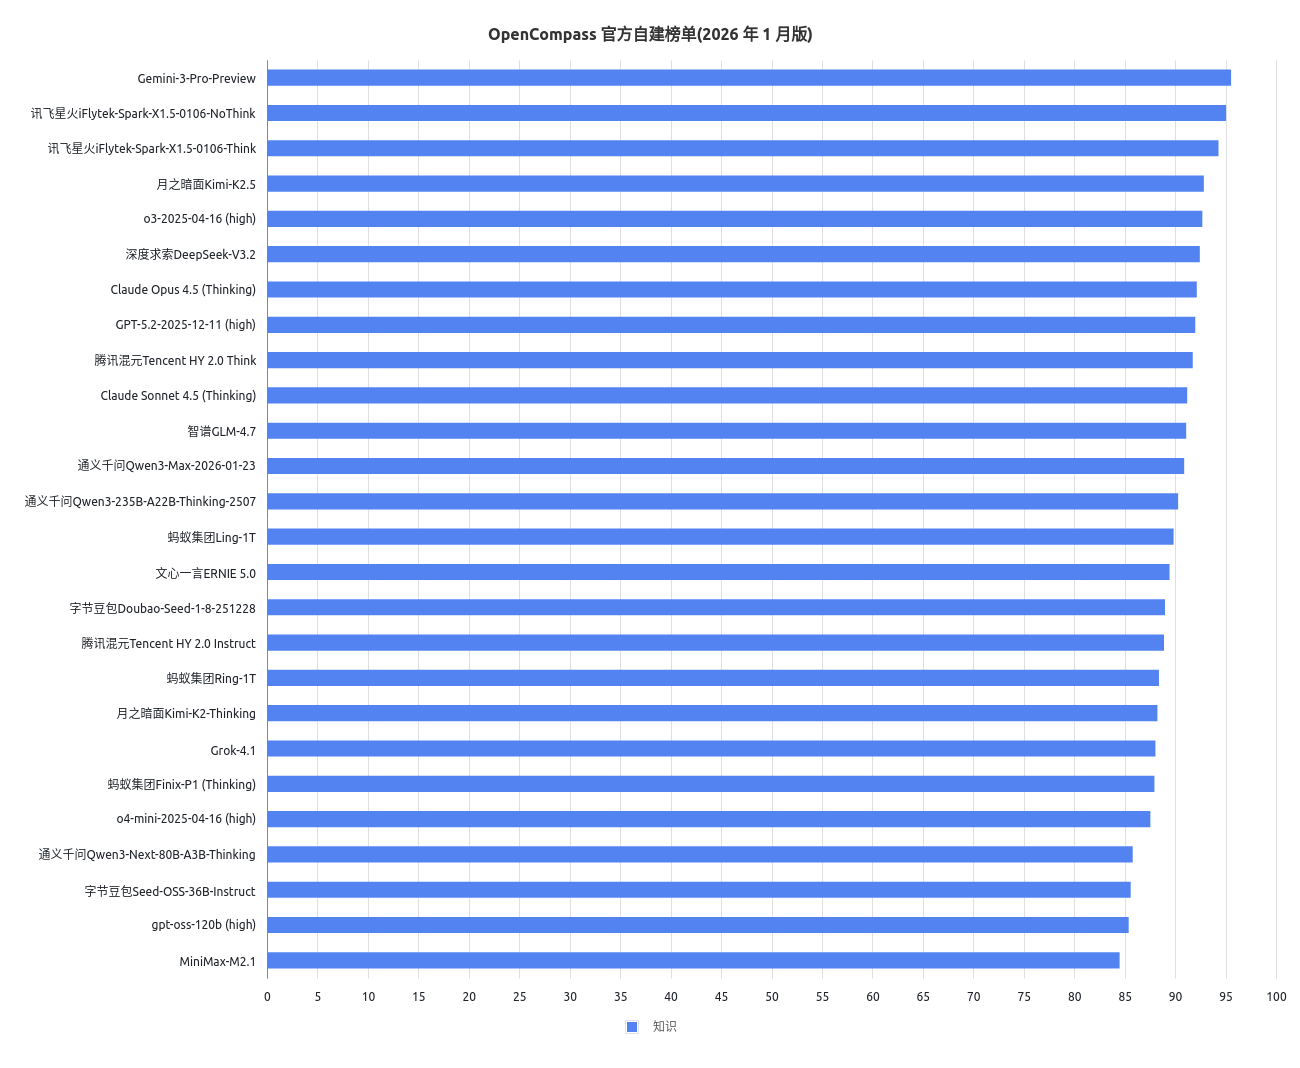
-
代码
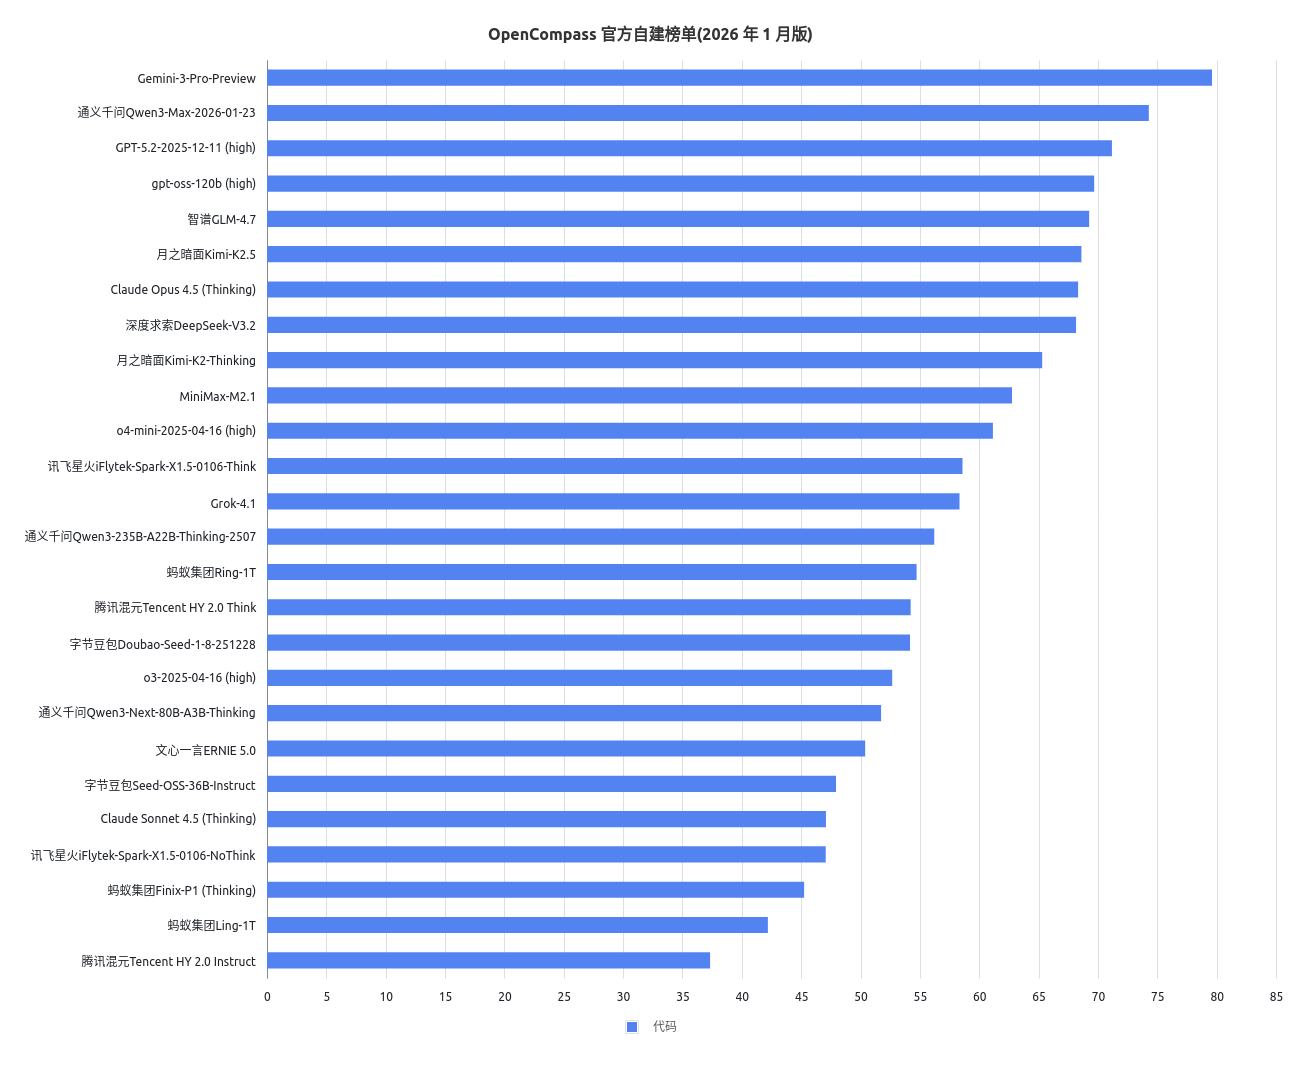
-
数学
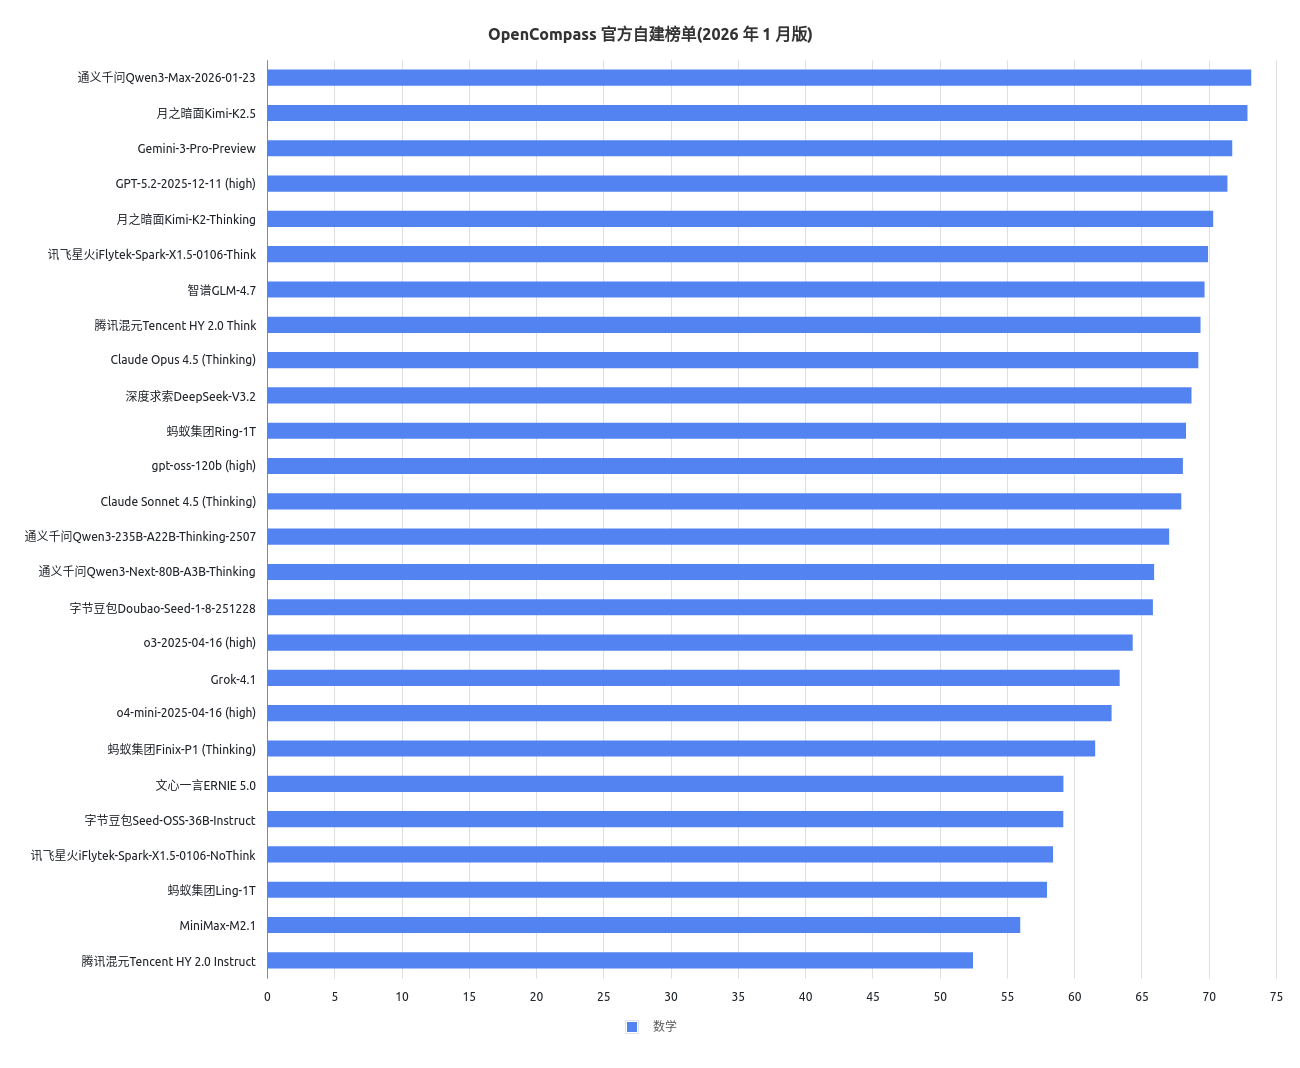
-
工具调用
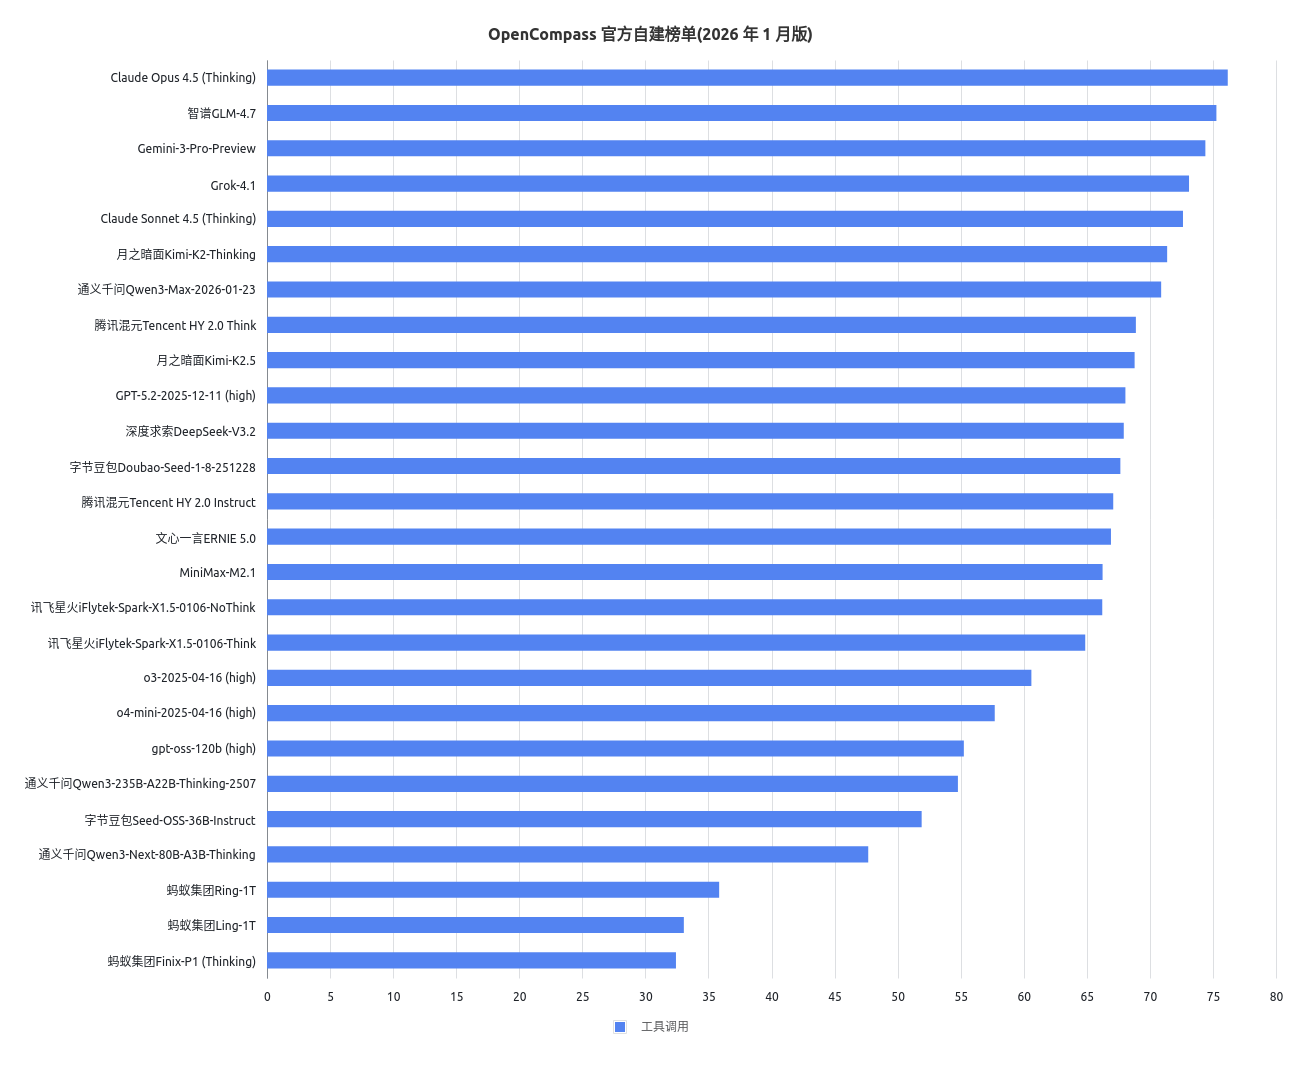
评测题目示例
数学计算
问题:
从一副不含大、小王的扑克牌中抽取5张牌,计算抽出的牌的不同的花色的数目大于不同的点数的数目的概率.

标准答案:$\\frac{223}{8330}$
Gemini-3-Pro-Preview回复之一:
从一副52张的扑克牌(不含大小王)中抽取5张牌,总的组合数为:
$$ N = \binom{52}{5} = 2,598,960 $$
设抽出的牌中不同花色的数目为 $n_s$,不同点数的数目为 $n_r$。我们需要计算 $n_s > n_r$ 的概率。
由于花色最多有4种,即 $1 \le n_s \le 4$,且5张牌至少有2种点数(因为同一点数最多4张牌),即 $2 \le n_r \le 5$。
满足 $n_s > n_r$ 的情况有以下几种组合:
1.  $n_s = 3, n_r = 2$
2.  $n_s = 4, n_r = 2$
3.  $n_s = 4, n_r = 3$

我们分别计算每种情况下的组合数:

**情况 1:$n_s = 3, n_r = 2$**
点数分布只能是 $3+2$(即三张一种点数,两张另一种点数)。$4+1$ 分布会导致 $n_s=4$。
*   **点数分布 3+2**:
    *   选点数:$P(13, 2) = 13 \times 12 = 156$ 种。
    *   选花色:设三张牌的点数为 $x$,两张牌的点数为 $y$。$x$ 的花色集合记为 $S_x$(3种),$y$ 的花色集合记为 $S_y$(2种)。需满足 $|S_x \cup S_y| = 3$。由于 $|S_x|=3$,这必然意味着 $S_y \subset S_x$。
        *   选 $S_x$:$\binom{4}{3} = 4$ 种。
        *   从 $S_x$ 中选 $S_y$:$\binom{3}{2} = 3$ 种。
        *   花色组合数:$4 \times 3 = 12$。
    *   总数:$156 \times 12 = 1,872$。

**情况 2:$n_s = 4, n_r = 2$**
点数分布可以是 $4+1$ 或 $3+2$。
*   **点数分布 4+1**:
    *   选点数:$13 \times 12 = 156$。
    *   选花色:$x$(4张)必然包含所有4种花色。$y$(1张)可以是任意花色。
        *   花色组合数:$1 \times 4 = 4$。
    *   总数:$156 \times 4 = 624$。
*   **点数分布 3+2**:
    *   选点数:$156$。
    *   选花色:需 $|S_x \cup S_y| = 4$。$|S_x|=3, |S_y|=2 \implies |S_x \cap S_y|=1$。
        *   选 $S_x$:$\binom{4}{3} = 4$ 种。剩余一种花色必然在 $S_y$ 中。
        *   选 $S_y$:必须包含 $S_x$ 之外的那个花色,且从 $S_x$ 中选1个。$\binom{1}{1} \times \binom{3}{1} = 3$ 种。
        *   花色组合数:$4 \times 3 = 12$。
    *   总数:$156 \times 12 = 1,872$。
    *   此情况小计:$624 + 1872 = 2,496$。

**情况 3:$n_s = 4, n_r = 3$**
点数分布可以是 $3+1+1$ 或 $2+2+1$。
*   **点数分布 3+1+1**:
    *   选点数:$\binom{13}{1} \times \binom{12}{2} = 13 \times 66 = 858$。
    *   选花色:$|S_x|=3, |S_y|=1, |S_z|=1$,并集大小为4。
        *   选 $S_x$:4种。缺失的花色记为 $w$。
        *   $S_y, S_z$ 的花色 $u, v$ 必须至少有一个是 $w$。
        *   所有可能的 $(u, v)$ 对有 $4 \times 4 = 16$ 种。都不含 $w$(即都在 $S_x$ 中)的有 $3 \times 3 = 9$ 种。
        *   符合条件的有 $16 - 9 = 7$ 种。
        *   花色组合数:$4 \times 7 = 28$。
    *   总数:$858 \times 28 = 24,024$。
*   **点数分布 2+2+1**:
    *   选点数:$\binom{13}{2} \times \binom{11}{1} = 78 \times 11 = 858$。
    *   选花色:$|S_x|=2, |S_y|=2, |S_z|=1$,并集大小为4。
        *   总的花色分配方式为 $\binom{4}{2} \times \binom{4}{2} \times 4 = 144$。
        *   排除 $n_s=2$ 的情况:$S_x=S_y \supset S_z$。选2种花色有 $\binom{4}{2}=6$ 种,分配方式 $1 \times 1 \times 2 = 2$。共 $6 \times 2 = 12$。
        *   排除 $n_s=3$ 的情况:选3种花色有 $\binom{4}{3}=4$ 种。在3种花色内分配且用到3种的方式有 $27 - (3 \times 2) = 21$。共 $4 \times 21 = 84$。
        *   符合 $n_s=4$ 的方式:$144 - 12 - 84 = 48$。
    *   总数:$858 \times 48 = 41,184$。
    *   此情况小计:$24024 + 41184 = 65,208$。

**总计符合条件的组合数:**
$$ 1,872 + 2,496 + 65,208 = 69,576 $$

**计算概率:**
$$ P = \frac{69,576}{2,598,960} $$
分子分母同时除以 312:
$$ \frac{69576 \div 312}{2598960 \div 312} = \frac{223}{8330} $$

**答案:**
\boxed{\frac{223}{8330}}
Ring-1T回复之一:
(思考过程略)

### 问题解析
我们需要计算从一副不含大小王的扑克牌(共52张)中抽取5张牌时,**不同花色的数目 $ H $ 大于不同点数的数目 $ P $** 的概率。
---
### 关键定义与约束
- **花色**:4种(黑桃、红桃、梅花、方块)
- **点数**:13种(A, 2, ..., K)
- **每张牌唯一**:每个点数在每种花色中仅有一张
- **抽取5张牌**,总情况数为:
  $$
  \binom{52}{5} = 2598960
  $$
我们关注的是满足条件 $ H > P $ 的情况。
其中:
- $ H $:不同花色的数目(1 ≤ $ H $ ≤ 4)
- $ P $:不同点数的数目(1 ≤ $ P $ ≤ 5)
由于同一花色内点数互不相同,因此:
- 若 $ H = 1 $,则 $ P = 5 $
- 若 $ H = 2 $,则 $ P \geq 3 $
- 若 $ H = 3 $,则 $ P \geq 2 $
- 若 $ H = 4 $,则 $ P \geq 2 $
所以只有以下两种情形满足 $ H > P $:
1. **$ H = 3 $ 且 $ P = 2 $**
2. **$ H = 4 $ 且 $ P = 2 $ 或 $ P = 3 $**
---
### 情况一:$ H = 3 $ 且 $ P = 2 $
#### 分析
- 5张牌来自3种花色。
- 点数分布为:一个点数出现3次(3种花色各1张),另一个点数出现2次(2种花色各1张)。
- 满足 $ H = 3 > P = 2 $
#### 计算
- 选择3种花色:$ \binom{4}{3} = 4 $
- 选择3次点数:13种
- 选择2次点数:12种
- 选择2次点数所在花色:从3种花色中选2种 → $ \binom{3}{2} = 3 $
$$
\text{数量} = 4 \times 13 \times 12 \times 3 = 1872
$$
---
### 情况二:$ H = 4 $ 且 $ P = 2 $ 或 $ P = 3 $
#### 分析
- 5张牌来自4种花色,花色分布为 $ (2,1,1,1) $
- $ H = 4 $,需满足 $ P < 4 $,即 $ P = 2 $ 或 $ P = 3 $
##### 子情况 A:$ P = 2 $
- 分布形式:
  - (4,1):一个点数出现4次(4种花色各1张),另一个点数出现1次
  - (3,2):一个点数出现3次(3种花色),另一个点数出现2次(2种花色)
###### (4,1) 分布
- 选择4次点数:13
- 选择1次点数:12
- 选择1次点数的花色:4种
$$
\text{数量} = 13 \times 12 \times 4 = 624
$$
对称地,(1,4) 也有 624 种,合计:
$$
624 \times 2 = 1248
$$
###### (3,2) 分布
- 选择3次点数:13
- 选择2次点数:12
- 选择3次点数的花色:$ \binom{4}{3} = 4 $
- 选择2次点数的花色:从3种花色中选1种重叠,1种非重叠 → $ \binom{3}{1} = 3 $
$$
\text{数量} = 13 \times 12 \times 4 \times 3 = 1872
$$
对称地,(2,3) 也有 1872 种,合计:
$$
1872 \times 2 = 3744
$$
###### 总计 $ P = 2 $ 的数量:
$$
1248 + 3744 = 4992
$$
##### 子情况 B:$ P = 3 $
- 通过总数减去其他情况得出:
  - $ H = 4 $ 总数:$ 685464 $
  - $ P = 5 $ 数量:$ 308880 $
  - $ P = 4 $ 数量:$ 205920 $
  - $ P = 2 $ 数量:$ 4992 $
$$
P = 3 \text{ 的数量} = 685464 - 308880 - 205920 - 4992 = 165672
$$
---
### 满足条件的总情况数
$$
\text{满足 } H > P \text{ 的数量} = 1872 + 4992 + 165672 = 172536
$$
---
### 概率计算
$$
\text{概率} = \frac{172536}{2598960}
$$
化简分数:
- 最大公约数 $ \gcd(172536, 2598960) = 2184 $
- 化简后:
$$
\frac{172536}{2598960} = \frac{79}{1190}
$$
---
### 最终答案
$$
\boxed{\dfrac{79}{1190}}
$$-
在该问题的解答过程中,Gemini-3-Pro-Preview基于严密的推理正确地回答了问题;而Ring-1T在思考时产生了一些重复计数和数值计算错误等问题,最终得到了错误的答案。
学科推理
问题:
In an adjustment problem, there are 18 observations of equal precision, and the number of necessary observations is 9. The degrees of freedom for this adjustment problem is ____. Using the method of condition adjustment, ____ condition equations can be formed. Now, 9 parameters are chosen, and there are two constraint conditions among them. If the adjustment is performed using the method of condition adjustment with constraints, ____ general condition equations and ____ constraint condition equations should be listed.

标准答案:9,9,16,2
Qwen3-Max-2026-01-23回复之一:
We need to parse the problem carefully. The problem statement:

"In an adjustment problem, there are 18 observations of equal precision, and the number of necessary observations is 9. The degrees of freedom for this adjustment problem is ____. Using the method of condition adjustment, ____ condition equations can be formed. Now, 9 parameters are chosen, and there are two constraint conditions among them. If the adjustment is performed using the method of condition adjustment with constraints, ____ general condition equations and ____ constraint condition equations should be listed."

We need to fill in the blanks. There are four blanks: degrees of freedom, number of condition equations (using method of condition adjustment), number of general condition equations, and number of constraint condition equations (for condition adjustment with constraints).

Let's recall concepts from geodetic adjustment / least squares adjustment.

...
(中间思考过程略)
...

But wait, the third blank is "____ general condition equations" and fourth is "____ constraint condition equations". So third answer is 16, fourth is 2.

However, I've also seen a formula where general condition equations = n - t + u, and constraint equations = c. That would give 18 general and 2 constraints. But that would total 20 equations. In the consistent case where u-c=t, that would give general = n - t + u = n + c, which is more than n. For the leveling example with n=3, t=2, u=3, c=1, this formula gives general = 3-2+3=4, constraints=1, total=5. But we know that with 3 observations and 1 constraint, the parametric adjustment has 3 observation equations and 1 constraint, total 4 equations. So 4 general equations is too many. Therefore, the formula r = n - t + u is for the model without constraints (condition adjustment with parameters), where parameters are independent (c=0). When constraints are present, we subtract c from the number of general condition equations. Hence, the correct formula for the model with constraints is r_general = n - t + u - c.

Thus, I'm leaning towards 16 and 2.

Let me check another source: In the Wikipedia page for "Least squares adjustment", under "Combined adjustment model", it says: "The number of condition equations is r = n + u - d, where d is the number of datum conditions." But datum conditions are constraints. If we have c datum constraints, then d = c, and r = n + u - c. But this r is the total number of condition equations (including those that might be considered constraints?). Not clear.

Wait, in the combined model, if we include the constraints as part of the condition equations, then total condition equations = n + u - t. If we separate them into general and constraints, then general = n + u - t - c, constraints = c, provided that the constraints are independent and reduce the effective parameters to t. But n + u - t - c = n - t + u - c. Yes, same as before.

Given that t is the number of independent quantities (necessary observations), and if the constraints are such that u - c = t, then general = n. So it matches parametric adjustment with constraints.

Therefore, the formula is consistent.

Thus, for the given numbers:
n=18, t=9, u=9, c=2
General condition equations = 18 - 9 + 9 - 2 = 16
Constraint condition equations = 2

So the four answers: 9, 9, 16, 2.

But let's double-check the second blank: "Using the method of condition adjustment, ____ condition equations can be formed." This is pure condition adjustment (no parameters). Number of condition equations = redundancy = n - t = 9. Correct.

First blank: degrees of freedom = redundancy = 9. Correct.

Therefore, final answers: ["9", "9", "16", "2"]

However, I should ensure that "degrees of freedom" is indeed n - necessary observations. Yes, in adjustment, degrees of freedom (redundancy) = number of observations - number of necessary observations.

One more sanity check: If there are 18 observations and 9 necessary observations, redundancy is 9. In condition adjustment, we form 9 condition equations. That is standard.

Now, when we introduce 9 parameters and 2 constraints, in the method of condition adjustment with constraints, we list general condition equations and constraint equations. The total number of equations listed should be such that the adjustment can be performed. The formula from standard Chinese textbook "误差理论与测量平差基础" (Chapter on various adjustment models) states:

- For 附有限制条件的条件平差 (condition adjustment with constraints):
   Number of general condition equations: c = n - t + u - s
   Number of constraint equations: s
   where s is the number of constraint conditions.

Yes, I think that's it. I recall a specific example problem: n=12, t=8, u=5, s=2, then general condition equations = 12-8+5-2=7, constraint equations=2. So the formula is used.

Therefore, answers are 9, 9, 16, 2.

I'll go with that.</think>
```json
{
  "answers": [
    "9",
    "9",
    "16",
    "2"
  ]
}
Grok-4.1回复之一:
```json
{
  "answers": [
    "9",
    "9",
    "7",
    "2"
  ]
}
```

## Explanation

The reasoning follows standard formulas in least squares adjustment theory, particularly for condition adjustment problems.

- Degrees of freedom is calculated as the total number of observations minus the number of necessary observations: 18 - 9 = 9.

- In the method of condition adjustment, the number of condition equations equals the number of necessary observations, which is 9, as this represents the independent conditions derived from the observations.

- When 9 parameters are chosen with 2 constraint conditions among them, the method of condition adjustment with constraints requires general condition equations equal to the number of parameters minus the number of constraints: 9 - 2 = 7. This ensures the total effective conditions align with the original degrees of freedom.

- The constraint condition equations directly correspond to the given number of constraints: 2.

This maintains consistency with the redundancy (degrees of freedom = 9), where the general and constraint equations together account for the system without altering the overall statistical degrees of freedom.-
可以看到,在本问题的回答中,Qwen3-Max-2026-01-23准确区分了题目的相关概念,采用了正确的计数关系,虽然存在较多反思内容,但仍计算得到正确答案;而Grok-4.1由于混淆了条件方程与参数自由度的关系,导致得到了错误的答案。
注意事项
-
大语言模型官方自建榜评测榜单每三月更新一次;
-
新模型厂商若想参与该月榜单评测,可在当月25日前发送邮件至opencompass@pjlab.org.cn申请评测申请加入司南OpenCompass月度评测榜单;
-
加入司南OpenCompass评测的结果默认公开;
-
仅支持开源或对外提供API服务商业化模型(内部迭代研发模型暂不支持评测);
-
为了确保公平性,司南通过公开采购的方式获取了商业API服务,其中包括使用硅基流动等服务商API。然而,由于部分API的稳定性问题或敏感词过滤机制,可能会导致某些问题无法获得答案,特此进行说明。
了解更多
最新大语言模型评测榜单已同步上线至司南官网,欢迎大家访问查看更详细的评测数据!
https://rank.opencompass.org.cn/
同时,司南评测体系中大模型评测过程中所用到的工具链均在GitHub开源,诚挚邀请您在学术研究或产品研发过程中使用我们的工具~

 800


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


