以高质量数据为基石:OpenCSG 助力 MiniCPM4 实现端侧大模型的性能与效率双突破

MiniCPM-V-4.5:重新定义边缘设备多模态AI的下一代视觉语言模型 MiniCPM-V-4.5:突破性边缘多模态AI模型 摘要:MiniCPM-V-4.5是一款革命性的80亿参数视觉语言模型,专为边缘计算设备设计。它采用创新的双塔架构,结合Qwen3-8B语言模型和优化版SigLIP2-400M视觉编码器,通过3D-Resampler技术实现96倍令牌压缩率,显著提升处理效率。该模型在多项基准测试中超越更大规模的竞争对手,甚至在某些任务上表现优于GPT-4o和Gemini-2.0 Pro等商业模型。其核心创新包括统一的图像/视频处理能力、高效的注意力机制和优化的视觉编码器, 阅读详情

以高质量数据为基石:OpenCSG 助力 MiniCPM4 实现端侧大模型的性能与效率双突破
顶尖的开源AI研究团队 OpenBMB 在其最新的技术报告中发布了备受瞩目的端侧大模型 MiniCPM4。该模型旨在以极高的计算效率在手机、个人电脑等终端设备上运行。为了在仅使用业界主流模型约22%训练数据量的情况下达到甚至超越其性能,这其中最大的瓶颈在于高质量、大规模、多样化的开源中文训练数据的极度稀缺。MiniCPM 团队实施了一套名为 UltraClean 的高效数据过滤与生成策略。

在此过程中,OpenCSG 提供的中文语料库成为了构建其高质量中文训练数据集(UltraFineWeb-zh)的关键组成部分,该语料库包含 Fineweb-edu-chinese、Cosmopedia-chinese 和 Smoltalk-chinese 等一系列高质量、目标明确的数据集,为 MiniCPM4 卓越的中文能力和整体效率奠定了坚实的数据基础。

面临的挑战

大语言模型正从追求“更大”转向追求“更优”和“更高效”,如何构建一套从数据验证到数据精炼的闭环系统,产出能够同时赋能模型高认知能力与高推理效率的终极训练集?MiniCPM 团队的核心挑战是:

  1. 突破资源瓶颈:
    如何在不依赖海量(如36T tokens)训练数据的情况下,训练出一个性能卓越的8B级别模型?

  2. 提升数据密度:
    互联网语料库虽浩如烟海,但充斥着大量噪音和低价值信息。团队需要一种方法,从大规模数据中高效地“淘金”,构建一个知识密度高、逻辑性强的训练集。

  3. 保证中文能力:
    作为一款同时支持中英双语的模型,如何确保其在中文核心能力评测(如 C-Eval, CMMLU)上达到顶尖水平至关重要。

解决方案

MiniCPM 团队的破局之道,是其精心设计的 UltraClean 数据工程系统。该系统不仅是一套过滤流程,更是一套包含高效验证、分类器迭代、数据合成在内的完整方法论。面对挑战,MiniCPM 团队认识到“数据质量远比数据数量更重要”。他们创新的 UltraClean 数据管线,其成功离不开高质量的数据源。
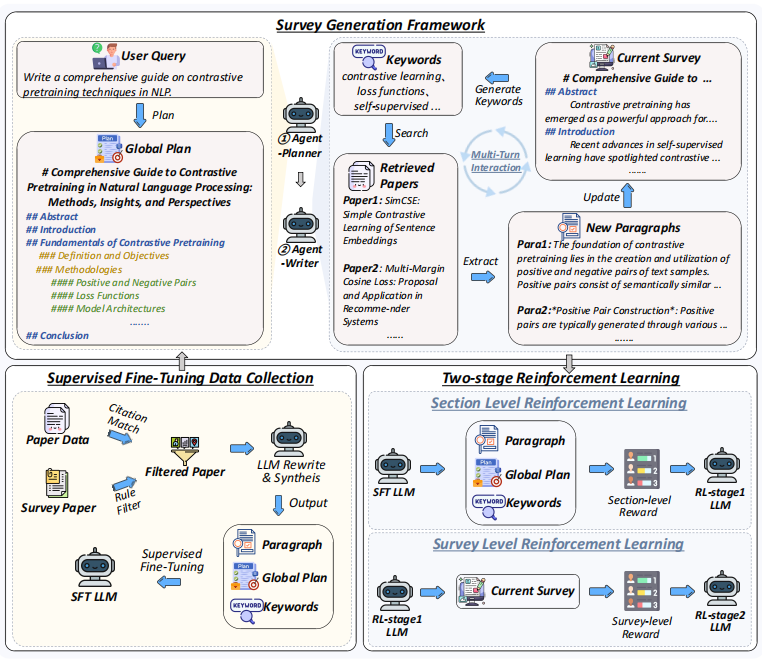
MiniCPM4-Survey 的结构框架

MiniCPM 团队的成功源于其在模型架构、训练数据、训练算法、推理系统四大维度上的系统性创新。其中,以 UltraClean 为核心的数据工程,是贯穿始终的基石。

1. 创新数据工程:UltraClean 与高效验证闭环

为了从源头上保证数据质量,MiniCPM团队没有盲目地“投喂”数据,而是构建了一套科学、高效的数据验证与筛选闭环系统。
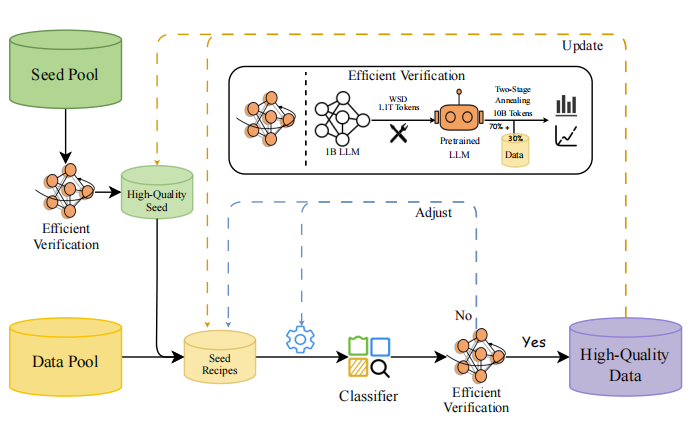
高质量数据集驱动的种子池

高效验证策略:

实现细节
团队摒弃了传统昂贵的“从零训练”验证法,创新地提出了一种**“两阶段退火微调”**策略。该策略利用一个已预训练好的1B参数基座模型,仅在训练的最后阶段(退火期)融入候选数据集进行微调。通过观察模型在 ScalingBench(一个专门设计的、与下游任务性能高度相关的评估集)上的损失变化,来快速判断数据质量。

技术优势
此方法将验证周期从1200 GPU小时缩短至110 GPU小时,效率提升超过10倍,实现了对数据质量的快速、低成本迭代验证。

OpenCSG的角色
在此环节,OpenCSG 的 Fineweb-edu-chinese 作为高质量数据源的代表,通过了这套严格的验证流程,被证实能显著提升模型性能。这不仅验证了 OpenCSG 数据的价值,也使其成为后续筛选更大规模语料的分类器的“黄金种子”。

UltraClean 数据精炼管线:

实现细节
基于验证过的高质量种子数据(包含 OpenCSG 数据),团队训练了一个轻量级的 fastText 文本质量分类器。与依赖大模型的分类器相比,fastText 能在非GPU服务器上高效处理万亿级 token。更关键的是,团队设计了迭代式训练机制:用当前分类器筛选出的正负样本,反哺下一代分类器的训练,形成自增强循环,持续提升分类器的精度和鲁棒性。
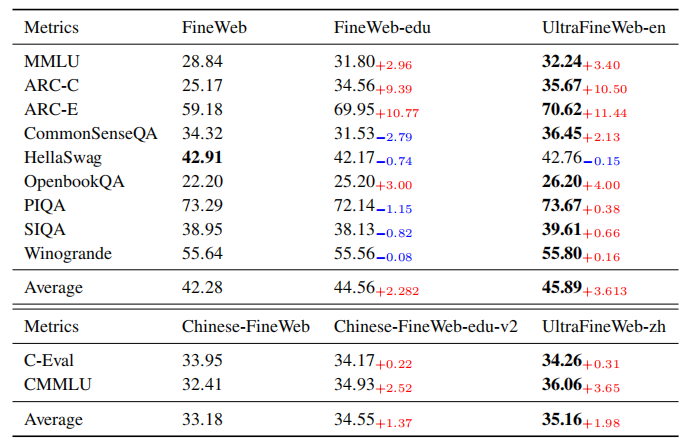
使用 UltraFineWeb(由 UltraClean 流程产出)后,模型在 MMLU、ARC 等基准上相比原始 FineWeb 的显著性能提升

Fineweb-edu-chinese:

技术细节

  • 系统化的数据源聚合:
    Fineweb-edu-chinese 并非单一来源,而是系统性地整合了包括 Wudao、CCI2、Skypile 等多个主流中文开放语料,确保了源数据的多样性和覆盖面。

  • 基于先进模型的自动化打分:
    技术核心
    OpenCSG 创新性地使用了一个基于 Qwen2-7b-instruct 微调的打分模型,对每一份文本的“教育价值”(educational value)进行0-5分的量化评估。

严谨的打分标准:
其评估 Prompt 极为详尽,从内容的教育价值、连贯性、深度、结构化程度等多个维度进行考量,确保了打分体系的科学性和一致性。

结果导向的过滤:
只有得分高于3分的高价值样本才被保留。OpenCSG 的实验表明,原始语料中仅有约17.5%(16.0%+1.5%)的样本能达到此标准,这体现了其筛选的严格性。
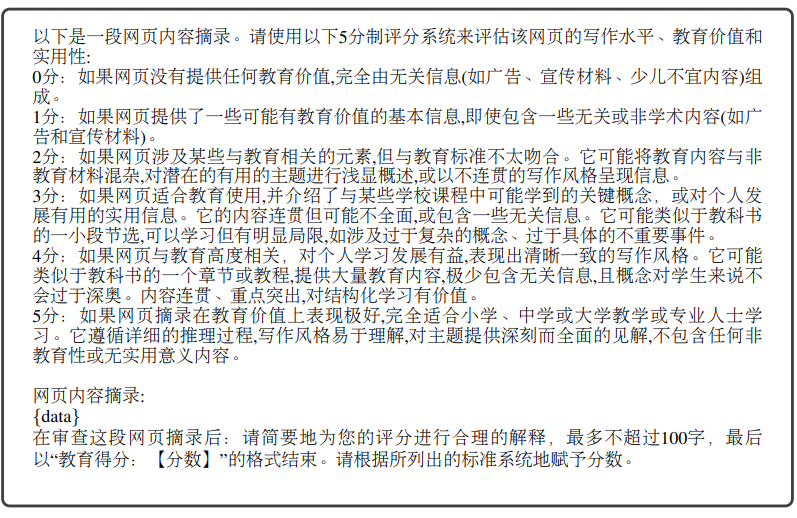
Ranking prompt
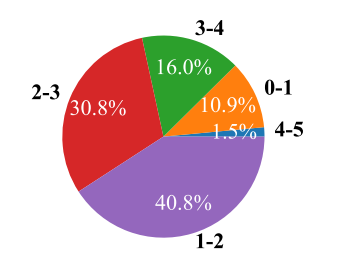
未过滤的源数据进行的评分分布

  • 高效的去重技术:
    采用Min-Hash算法,以0.7的重叠阈值进行去重,在保证数据多样性的同时,极大地提升了计算效率。

解决的挑战:
为 MiniCPM 的 8T token 预训练提供了干净、知识密集、大规模的基础语料。这使得模型在训练初期就能高效地吸收高质量知识,避免了在“垃圾数据”上浪费宝贵的计算资源,完美契合了 MiniCPM 对训练效率和模型能力密度的极致追求。

通过 UltraClean 流程,MiniCPM 团队最终从包括 OpenCSG 在内的源数据中,提炼出了更高质量的 UltraFineWeb-zh 中文数据集。

2. 革命性模型架构:可训练稀疏注意力 InfLLM v2

为了解决端侧设备处理长文本的性能瓶颈,MiniCPM团队研发了 InfLLM v2,一个专为高效推理设计的可训练稀疏注意力机制。
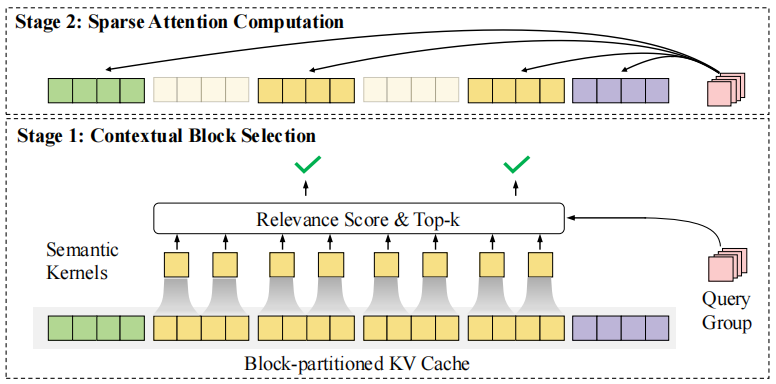
InfLLM v2 的核心架构图

实现细节:
  • 动态上下文块选择:
    InfLLM v2 将长文本的 Key-Value Cache 划分为多个块。对于每个新生成的 token(Query),模型不再需要与所有历史 token 进行注意力计算,而是通过一个高效的**“语义核心(Semantic Kernels)”**机制,动态地选择出最相关的几个 KV 块进行计算。

  • 训练与推理协同:
    与许多训练后才应用的稀疏方法不同,InfLLM v2 在预训练阶段就已引入。这意味着模型在学习语言知识的同时,也在学习如何进行“稀疏思考”。

高质量数据的赋能:

InfLLM v2 的效率依赖于模型对文本“核心语义”的精准捕捉。OpenCSG 提供的经过精炼的、结构清晰的教育和技术文本,为模型学习这种能力提供了理想的训练材料。模型在阅读了大量逻辑连贯的文本后,其注意力机制能更准确地判断哪些上下文是关键信息,从而在推理时做出最优的稀疏选择。
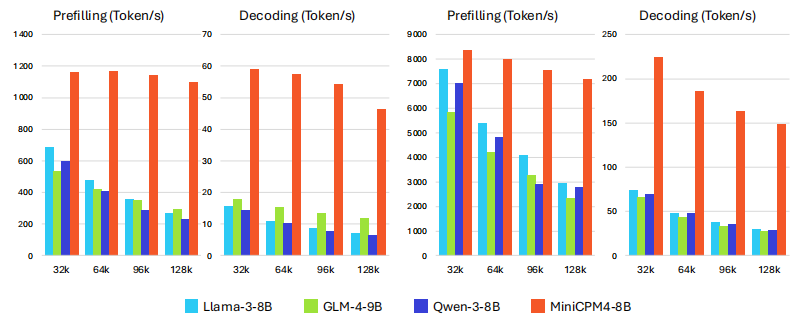
最终的性能展示(在 Jetson 和 RTX 4090 上,随着上下文长度增加,MiniCPM4 的性能优势愈发明显)

3. 推理系统级优化:CPM.cu与FR-Spec

软件和硬件的协同优化是释放模型潜力的最后一公里。MiniCPM团队为此构建了定制化的推理引擎。

实现细节:
  • CPM.cu:
    一个轻量级的 CUDA 推理框架,集成了静态内存管理、核函数融合等技术。

  • FR-Spec (Frequency-Ranked Speculative Sampling):
    针对推测解码中草稿模型(draft model)的词表计算瓶颈,团队创新地提出 FR-Spec。该方法通过统计发现,语言中大部分 token 由一小部分高频词构成。因此,草稿模型在生成时仅需在一个大幅缩减的高频词表上进行计算,而验证模型(target model)仍保留全词表,从而在不损失精度的前提下,将草稿生成速度提升高达4倍。

数据驱动的优化:

FR-Spec 的有效性,依赖于对训练语料的精确词频统计。OpenCSG 提供的庞大且经过清洗的中文语料库,为构建这个精准的高频词表提供了坚实的数据基础,确保了 FR-Spec 在真实中文场景下的高效运作。

成果与影响力

  1. 中文性能显著提升:
    使用包含 OpenCSG 数据提炼而成的 UltraFineWeb-zh 数据集训练的模型,在中文权威评测 C-Eval 和 CMMLU 上的表现,均优于仅使用其他中文网络数据集训练的模型。平均分提升了 1.98 个百分点,这在竞争激烈的模型评测中是巨大的优势。

  2. 实现极致的训练效率:
    正是基于 UltraFineWeb 这样的高质量数据集,MiniCPM4-8B 最终仅用 8T tokens 的训练量,就达到了与使用 36T tokens 训练的 Qwen3-8B 相当的性能。这充分证明,高质量的数据源(如 OpenCSG)是实现“降本增效”训练策略的核心。

  3. 卓越的基准测试表现:
    OpenCSG 在其研究的实验中,通过在一个2B模型上使用 Fineweb-edu-chinese 进行训练,在 C-Eval 和 CMMLU 等权威中文评测上,相较于使用原始混合数据训练的基线模型,实现了显著的性能提升(如下图所示,准确率在训练后期出现跃升并大幅超越基线)。这一实验结果直接预示并验证了 MiniCPM 在使用该数据后能够取得的成功。
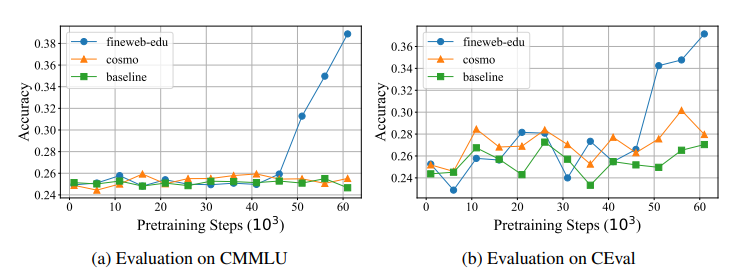
Fineweb-edu 训练的模型在 CMMLU 和 C-Eval 上后期超越 baseline 的曲线

  1. 强大的综合能力:
    MiniCPM4 不仅在知识问答上表现出色,其在数学、代码等推理密集型任务上的强大能力,也离不开 Cosmopedia-chinese 和 Smoltalk-chinese 提供的深度知识和复杂指令数据。同时,由 Smoltalk-chinese 微调后,模型在 Alignbench 这类多维度对齐评测中表现优异。

MiniCPM 与 OpenCSG 的成功合作为中文 AI 开源社区树立了典范。随着 OpenCSG 语料库的不断迭代,以及 MiniCPM 系列模型的持续演进,双方将形成一个良性循环:更高质量的数据将催生更强大的模型,而更强大模型的成功应用,又将验证并推动数据构建方法的进步。这种开放、协作的模式,将持续降低 AI 技术门槛,催生更多像 MiniCPM 一样高效、创新的 AI 应用。

从社区到产业:OpenCSG 打造 AI 模型新基础设施

在这场以稀疏架构与高效数据为核心的技术革命背后,国产开源生态的力量不容忽视。以OpenCSG 社区为代表的开源力量,正在成为国产大模型时代的关键基础设施提供者与技术创新策源地。

OpenCSG(https://opencsg.com)是全球领先的开源大模型社区,致力于打造开放、协同、可持续的 AI 开发者生态。其核心平台 CSGHub 提供模型、数据集、代码与 AI 应用的一站式托管、协作与共享服务,具备强大的模型资产管理能力。

  • 已汇聚 10 万+ 高质量 AI 模型,覆盖 NLP、CV、语音、多模态等多个核心方向;
  • 服务科研机构、企业用户与开发者,提供算力支持与数据基础设施;
  • 在本次 MiniCPM 训练中,OpenCSG 提供的高质量 Chinese FineWeb Edu 系列数据集 加速完成预训练阶段;
  • 展示了国产开源平台在 AI 训练范式中的关键地位。

OpenCSG 作为全球第二大开源社区平台,正在以“开源生态 + 企业级落地”的双轮驱动,重新定义 AI 社区的价值。
OpenCSG 正在推动构建具有中国特色的
开源大模型生态闭环
。这种开放协作的模式,不仅赋能科研与产业创新,也让中国 AI 开发者在全球模型生态中拥有更多自主权与话语权。

minicpm模型架构 【代码】minicpm模型架构。 阅读详情

相关推荐

【HAL库-STM】智能温控按键小风扇【胎教级教学】

硬件设备:DHT11,0.96寸oled屏,二/三/四线风扇(不挑),面包板 、f10的精英板等等。当人在的风扇面前时可以自行控制风扇,不在面前时又想开风扇就让他温控自行开启,(在这里有一个想法就是加上蓝牙和wifi控制的功能能够远程遥控,这个如果做的再全一点就要自主研发是一个多功能app,这里没有做。针对这个dht11,我一开始是卡在了这个check函数里面,一直是我给完dht11低电平和高电平后,dht11不回复我低电平和高电平,这个不是我的问题,当时代码是没毛病的,这个点一直卡着我。吐血五天实现小成品

weixin_52451652的博客 1738

面壁科技震撼发布!全球最强端侧模型MiniCPM 4.0,实现220倍速度惊人飞跃

面壁智能发布新一代端侧模型MiniCPM4.0,包括8B和0.5B两种参数版本,实现了长文本推理速度5倍提升、存储空间缩减至1/4等突破。该模型采用InfLLMv2稀疏注意力层和双频换挡机制,结合自研推理框架,在端侧部署表现优异。同时,文章指出大模型人才缺口达47万,并提供了从提示工程到商业落地的四阶段学习路径,包含实战案例和技术资料,助力开发者掌握AI前沿技术。

2401_84494441的博客 1487

用MATLAB从零实现六足机器人步态仿真:交替三角与波动步态保姆级教程

本文详细介绍了如何使用MATLAB从零实现六足机器人的两种经典步态仿真:交替三角支撑步态和波动步态。通过参数定义、相位设置、运动轨迹生成和三维可视化等步骤,帮助读者掌握六足机器人步态规划的核心技术。教程包含完整代码和详细解析,适合机器人爱好者和相关专业学生学习实践。

weixin_26765363的博客 226

端侧推理新标杆——MiniCPM 4本地部署教程:5%稀疏度实现128K长文本7倍加速,低成本训练开销匹敌Qwen3-8B

MiniCPM 4 是一个极致高效的端侧大模型,从模型架构、学习算法、训练数据与推理系统四个层面进行了高效优化,实现了极致的效率提升。高效模型架构:InfLLM v2 -- 可训练的稀疏注意力机制:采用可训练的稀疏注意力机制架构,在 128K 长文本处理中,每个词元仅需与不足 5% 的词元进行相关性计算,显著降低长文本的计算开销高效学习算法:模型风洞 2.0 -- 高效 Predictable Scaling:引入下游任务的 Scaling 预测方法,实现更精准的模型训练配置搜索。

SJJS_1的博客 1976

大模型蒸馏实战:让小模型获得大模型的知识

本文为初学者提供了一份大模型蒸馏实战指南,通过情感分析任务演示如何将 BERT 的知识迁移到轻量级 TextCNN。文章结合原理图解与 PyTorch 代码,详解软标签生成、温度调节和双损失设计等核心概念,并对比蒸馏前后的性能差异(准确率提升 4.6%,推理速度达 1200 句 / 秒)。内含可直接运行的代码片段、训练技巧及常见问题解答,助力开发者快速掌握模型压缩核心技术,实现工业级部署效率。适合 NLP 入门者学习实践。

1368

别再死记硬背了!用Multisim仿真5分钟搞懂运放电压跟随器到底要不要加反馈电阻

本文通过Multisim仿真实验,深入解析运放电压跟随器中反馈电阻的必要性。实验对比不同阻值对电路性能的影响,揭示反馈电阻在提供偏置电流通路、提升高频稳定性和ESD保护中的关键作用,并给出工程实践中的优化建议,帮助工程师快速掌握运放电路设计要点。

weixin_42641998的博客 371

面壁智能开源多模态大模型——MiniCPM-V 4.5本地部署教程:8B参数开启多模态“高刷”时代!

MiniCPM-V 4.5 是 OpenBMB 最新 8B 多模态大模型,基于 Qwen3-8B + SigLIP2-400M,在 OpenCompass 平均 77.0 分,超越 GPT-4o-latest 与 Qwen2.5-VL 72B;独创 3D 重采样器实现 96× 视频令牌压缩,10 FPS 长视频理解不增成本;可控混合快速/深度思维一键切换;180 万像素 OCR 与 PDF 解析领先 GPT-4o,30+ 语言可信输出;

SJJS_1的博客 2707

第186篇 前馈控制——提升跟踪精度的补充手段

文章摘要: 本文介绍了前馈控制的原理及其在工程中的应用。与反馈控制不同,前馈控制通过提前预测目标值或扰动信息来生成控制量,避免误差出现后再纠正的延迟问题,适用于机器人、机械臂等高速运动场景。前馈控制通常与PID反馈配合使用,前者提供粗调,后者进行微调。文章详细讲解了前馈增益的调节方法(模型法、实验法、自适应法)及两种前馈类型(指令前馈和扰动前馈),并提供了代码示例和面试实战建议,强调前馈与反馈的协同设计是提升控制精度的关键。最后预告了下一篇将讨论串级PID控制架构。

郑伟强dev的专栏 397

MiniCPM4: Ultra-Efficient LLMs on End Devices——端侧设备上的高效大型语言模型

MiniCPM4: Ultra-Efficient LLMs on End Devices——端侧设备上的高效大型语言模型

Together_CZ的博客 1848

Ceph入门到精通-更换osd、扩容osd

【代码】Ceph入门到精通-更换osd、扩容osd。

隔壁老瓦的专栏 1547

A*寻路算法的最简单通俗讲解

为什么我的眼里常含泪水?因为我有一个算法不会。为了节约点眼泪,今天我们就来介绍著名的A*寻路算法(或简称A*算法)。 Peter Hart, Nils Nilsson 和 Bertram Raphael 在1968年首次提出了著名的A*算法。A*算法其实是Dijkstra最短路径算法的一种扩展。不一样的是,在A*算法中我们需要使用Heuristics 来导引搜索过程,以期达到更好的表现。 ...

白马负金羁 2万+

OpenCSG月度更新2025.8

8月的OpenCSG取得了一些亮眼的成绩🚀在2025年8月,OpenCSG在产品创新、社区拓展与商业落地方面取得全面突破。在社区与生态层面,OpenCSG联合DeepFlow、Milvus等社区成功举办的核心训练数据来源,为突破中文数据处理瓶颈提供关键支持。市场拓展方面:OpenCSG作为重要联合发起方,携手共同推动数据开放共享与AI普惠发展,依托其超过10万模型的开源社区及国际化技术协作网络,为构建全球共享、可信可持续的数字未来注入核心驱动力。

OpenCSG的博客 860

甲基化生物信息学分析及批次效应校正全流程

本文系统阐述了DNA甲基化数据分析中的批次效应问题及解决方案。甲基化数据(β值和M值)对实验批次差异高度敏感,可能导致假阳性结果。文章详细介绍了批次效应检测方法(PCA可视化、BEclear定量评分)和校正流程,包括数据预处理、参数化(ComBat-met)与非参数化(BEclear)校正方法,并提供了完整的R代码实现。重点解决了β值有界分布与统计模型假设冲突的问题,为甲基化研究的可靠性提供技术保障。

huanghm88的专栏 106

MiniCPM-V:革命性的端侧多模态视觉语言模型

MiniCPM-V:革命性的端侧多模态视觉语言模型 【免费下载链接】MiniCPM-V 项目地址: https://ai.gitcode.com/hf_mirrors/openbmb/MiniCPM-V ...

gitblog_00678的博客 606

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

0day同步!昇思MindSpore框架成功适配面壁MiniCPM4.0模型并上线魔乐社区

6 月 6 号,面壁智能正式发布并开源了端侧「小钢炮」系列最新力作——MiniCPM 4.0 模型,实现了最快震撼的 220 倍极限加速!昇思MindSpore框架对齐主流生态接口,不断提升HuggingFace Transformers类模型接入vllm-mindspore框架效率,同时基于vLLM推理框架与MindSpore One套件,0day支持MiniCPM4.0双尺寸模型快速适配。欢迎广大开发者下载体验!MindSpore-vLLM代码仓:🔗魔乐社区体验指导链接:

2401_87243659的博客 987

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

利用OpenVINO高效推理MiniCPM4系列模型

本文将介绍如何利用OpenVINOTM的Python API在本地部署MiniCPM 4.0系列模型。

英特尔开发人员专区 2176

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

端侧模型卷王诞生!MiniCPM4长文本推理提速5倍,0.5B模型屠榜同级

2025 智源大会,新一代「面壁小钢炮」 MiniCPM4.0 端侧模型发布。一款 8B 稀疏闪电版,带来端侧性能创新式大跃升;一款 0.5B 实力演绎以小博大,适配广泛终端场景。

m0_59164520的博客 1244

MiniCPM3-4B | 笔记本电脑运行端侧大模型OpenBMB/MiniCPM3-4B-GPTQ-Int4量化版 | PyCharm环境

2024年9月5日,面壁智能发布了MiniCPM3-4B,面壁的测试结果声称MiniCPM3-4B表现超越 Phi-3.5-mini-instruct 和 GPT-3.5-Turbo-0125,并且能够比肩 Llama3.1-8B-Instruct、Qwen2-7B-Instruct、GLM-4-9B-Chat 等多个 7B-9B 参数量的模型。实践出真知,博主觉得用自己的老手提笔记本试试,看能不能也跑个大模型装一下逼。

神奇代码在哪里 2372

MiniCPM4端侧AI模型

通过算法创新(稀疏注意力)、数据精炼(UltraClean)、硬件协同(ArkInfer)三位一体,实现端侧AI的“超性价比”突破。:建筑工程师用3D建模模拟大楼承重,避免真实建造中的浪费。:图书馆管理员用索引目录快速定位章节,而非逐页翻阅全书。:用高质量数据弥补模型规模劣势,实现“小而精”。:为不同硬件定制“驱动程序”,榨干终端算力。硬件资源与计算需求严重不匹配。MiniCPM4的本质是。

frostmelody 全网同名,大家多多关注呀~ 持续分享优质内容! 1282

国产“小钢炮”MiniCPM3-4B:小参数,大能量!

在工具调用能力的评测中,MiniCPM3-4B 在 BFCL(Berkeley Function Calling Leaderboard)上的得分高达 76.0%,领先于 Qwen2-7B-Instruct(71.6%) 和 GLM-4-9B-Chat(70.1%) 等多个更大参数模型,表现出超强的工具调用能力。与部分 7B、9B 参数的大模型相比,MiniCPM3-4B 的性能表现显著更好,尤其是在中文能力、数学能力等任务中优势明显。随着版本迭代,模型层数逐步增加,提升了模型的复杂性与推理能力。

OpenCSG的博客 3927

【VLMs篇】05: MiniCPM-V 4.5 技术架构详解与代码深度解读

MiniCPM-V 4.5 是一个高效的端侧多模态大语言模型,支持图像、视频和文本输入。该模型通过创新的token压缩技术,实现了在8B参数规模下超越GPT-4o等主流模型的性能。

u013010473的博客 3775

单卡10分钟部署MiniCPM4-0.5B:轻量级大模型本地运行指南

MiniCPM 4 是一个极其高效的边缘侧大型模型,经过了模型架构、学习算法、训练数据和推理系统四个维度的高效优化,实现了极致的效率提升。

SJJS_1的博客 1737

5个高效解决方案:Umi-OCR从零开始实战指南

还在为图片中的文字无法复制而烦恼吗?还在手动敲打PDF扫描件的内容吗?今天我要向你介绍一款能彻底改变你工作方式的OCR神器——Umi-OCR。这款开源免费的离线OCR软件,支持截屏识别、批量图片处理、PDF文档转换和二维码扫描生成,无需网络即可高效工作。无论你是学生、办公人士还是开发者,只需30分钟,就能掌握这款强大工具的核心用法。Umi-OCR文字识别工具凭借其免费、开源、可批量处理的特性,成为

gitblog_00797的博客 835

90%成本削减下的GPT-4V级性能:MiniCPM-V多模态模型深度解析与部署指南

你是否还在为部署GPT-4V级别的多模态模型而苦恼?面对动辄数十亿参数的模型规模、高昂的计算资源成本以及复杂的部署流程,许多开发者和企业只能望而却步。然而,开源社区的创新正在改变这一局面。MiniCPM-V作为一款革命性的高效多模态模型,以仅30亿参数的体量,在保持GPT-4V级别性能的同时,实现了高达90%的成本削减,彻底颠覆了人们对多模态模型部署门槛的认知。 读完本文,你将获得: - 深入理...

gitblog_02247的博客 523

MiniCPM-V-4_5:重新定义边缘设备多模态AI的下一代视觉语言模型

MiniCPM-V-4_5:边缘设备上的多模态AI革命 本文介绍了突破性的MiniCPM-V-4_5视觉语言模型,它通过创新的3D重采样器实现96倍视频压缩,结合LLaVA-UHD架构处理180万像素图像,在8B参数下超越GPT-4o等商业大模型。核心技术包括:1)时空联合压缩的3D注意力机制,高效处理高帧率视频;2)自适应分块策略动态分配计算资源;3)统一OCR与文档知识的学习框架。该模型支持设备端部署,在多项基准测试中表现优异,为移动端多模态AI应用开辟了新可能,实现了"小而精"的技

Liudef06的博客 1164
上一篇: 从 LLM 到自主 Agent:OpenCSG 打造开源 AgenticOps 生态
下一篇: AgenticOps Engineering:AI 智能体时代的下一个关键工程学科
OpenCSG
博客等级 码龄3年 1679粉丝 575原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值