突破视觉理解极限,Qwen2-VL重磅登场

多模态理解-Qwen-VL系列:Qwen-VL, Qwen2-VL, Qwen2.5-VL Qwen-VL基于预训练好的Qwen-7B,支持等功能。 阅读详情

前沿科技速递🚀

经过近一年的持续努力,Qwen团队宣布推出最新一代的视觉语言模型:Qwen2-VL。基于Qwen2的基础,Qwen2-VL在多个方面实现了显著提升,相较于前代模型Qwen-VL,它具备以下核心优势:

1. 适应不同分辨率与长宽比的图片:Qwen2-VL在MathVista、DocVQA、RealWorldQA、MTVQA等多个视觉理解基准测试中展现了全球领先的表现。无论是高分辨率还是非标准长宽比的图片,Qwen2-VL都能轻松读懂。

2. 支持长达20分钟以上的视频理解:Qwen2-VL不仅可以理解长视频,还能应用于基于视频的问答、对话和内容创作等多种场景,使其在处理复杂多媒体内容时表现卓越。

3. 操作智能设备:Qwen2-VL的复杂推理与决策能力使其能够作为手机或机器人等设备的视觉智能体,根据视觉环境和文字指令进行自动化操作。

4. 多语言支持:为了更好地服务全球用户,Qwen2-VL不仅支持英语和中文,还新增了对大多数欧洲语言、日语、韩语、阿拉伯语、越南语等多语言文本的理解能力。

来源:传神社区

01 模型开源与性能表现

Qwen团队以Apache 2.0协议开源了Qwen2-VL-2B和Qwen2-VL-7B,同时发布了Qwen2-VL-72B的API。开源代码已集成到Hugging Face Transformers、vLLM和其他第三方框架中,为开发者提供了便捷的使用体验。

在六个关键指标上,Qwen2-VL展现了卓越的视觉能力,包括综合的大学题目、数学能力、文档表格多语言文字图像的理解、通用场景下的问答、视频理解及智能代理功能。尤其是在文档理解方面,Qwen2-VL-72B表现尤为出色,超过了GPT-4o和Claude3.5-Sonnet等闭源模型。尽管在综合大学题目方面还有一定差距,Qwen2-VL-72B依然刷新了开源多模态模型的最佳记录。

图片

在 7B 规模上,同样支持图像、多图、视频的输入,在更经济的规模上也实现了有竞争力的性能表现,特别是像 DocVQA 之类的文档理解能力和 MTVQA 考察的图片中多语言文字理解能力都处于 SOTA 水平。

图片

除此之外,Qwen团队还提供了一个更小的 2B 规模的模型,以此支持移动端的丰富应用。它具备完整图像视频多语言的理解能力,性能强劲,特别在视频文档和通用场景问答相较同规模模型优势明显。

图片

02 模型架构的创新

Qwen2-VL延续了Qwen-VL中的ViT加Qwen2的串联结构,并在架构上进行了重要升级:

1. 原生动态分辨率支持Qwen2-VL能够处理任意分辨率的图像输入,并将不同大小的图片转换为动态数量的tokens。这种设计确保了输入与图像原始信息之间的高度一致性,模拟了人类视觉感知的自然方式。

图片

2. 多模态旋转位置嵌入(M-ROPE)Qwen2-VL通过多模态旋转位置嵌入,将原始旋转嵌入分解为时间、高度和宽度三个部分,使其能够同时捕捉和整合一维文本序列、二维视觉图像及三维视频的位置信息,从而更好地处理和推理复杂的多模态数据。

图片

03 典型示例

1. 更细致的识别与理解Qwen2-VL不仅能识别植物和地标,还能理解场景中多个对象之间的关系。特别是在手写文字及多语言图像识别方面,Qwen2-VL在全球范围内更为易用。

Example: Plant identification

图片

2. 视觉推理与现实问题解决Qwen2-VL的数学与编程能力得到了显著增强。通过分析图片,Qwen2-VL能够解读复杂的数学问题,进行图表分析,甚至极端长宽比的图片也能正确解析。它还可以从真实世界的图像和图表中提取信息,使其成为日常生活中的智能助手。

Example: Math

图片

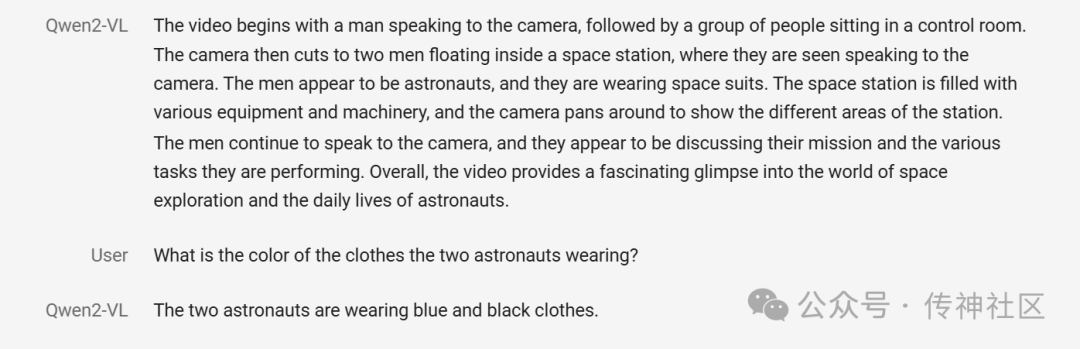
3. 视频理解与实时聊天Qwen2-VL扩展了视频内容分析的能力,能够总结视频要点、即时回答相关问题,并维持连贯的对话,仿佛一位随时待命的个人助手,为用户提供更加直观且即时的帮助。

Example: Video Understanding

图片

space_woaudio

图片

4. Visual Agent 能力Qwen2-VL展示了作为视觉代理的潜力,初步具备了利用视觉能力进行工具调用与交互的功能。通过函数调用,Qwen2-VL能够实时检索数据,如航班状态、天气预报和包裹追踪等,将视觉解读与功能执行有机结合,成为信息管理和决策的有力工具。

  • Function Calling:模型支持函数调用,使其能够利用外部工具进行实时数据检索——无论是航班状态、天气预报还是包裹追踪——通过解读视觉线索。视觉解读与功能执行的整合提升了模型的实用性,使其成为信息管理和决策的有力工具。

  • Visual Interactions: 视觉交互对多模态大模型是更高的感知能力要求。我们初步做了一些简单的探索,让模型能够更像人一样和环境交互。使得 Qwen2-VL 不仅作为观察者,而是能有代替人做更多的执行者的可能。

Operate a Mobile Phone

04 模型下载

传神社区:

Qwen2-VL-2B-Instruct:

https://opencsg.com/models/Qwen/Qwen2-VL-2B-Instruct

Qwen2-VL-7B-Instruct:

https://opencsg.com/models/Qwen/Qwen2-VL-7B-Instruct

欢迎加入传神社区

•贡献代码,与我们一同共建更好的OpenCSG

•Github主页

欢迎🌟:https://github.com/OpenCSGs

•Huggingface主页

欢迎下载:https://huggingface.co/opencsg

•加入我们的用户交流群,分享经验

实战千问2大模型第三天——Qwen2-VL-7B(多模态)视频检测和批处理代码测试 阿里通义千问开源新一代视觉语言模型Qwen2-VL。其中,Qwen2-VL-72B在大部分指标上都达到了最优,刷新了开源多模态模型的最好表现,甚至超过了GPT-4o和Claude 3.5 Sonnet等闭源模型。1、能读懂不同分辨率和不同长宽比的图片:Qwen2-VL在多个视觉理解基准测试中取得了全球领先的表现,其中包括但不限于考察数学推理能力的MathVista、考察文档图像理解能力的DocVQA、考察真实世界空间理解能力的RealWorldQA、考察多语言理解能力的MTVQA。 阅读详情

相关推荐

实战千问2大模型第四天——Qwen2-VL-7B(多模态)lora微调训练和测试

微调使得模型可以根据不同用户的需求进行定制,例如在特定领域内理解特殊的视觉内容或者专业术语。

qq_34717531的博客 4380

Qwen2-VL环境搭建&推理测试

与上一代模型 Qwen-VL 不同,Qwen2-VL 可以处理任意分辨率的图像,而无需将其分割成块,从而确保模型输入与图像固有信息之间的一致性。这种方法更接近地模仿人类的视觉感知,使模型能够处理任何清晰度或大小的图像。通过将 original rotary embedding 分解为代表时间和空间(高度和宽度)信息的三个部分,M-ROPE 使 LLM 能够同时捕获和集成 1D 文本、2D 视觉和 3D 视频位置信息。),这么小的模型,显然我的机器是跑的起来的,OK,那就让我们开始吧。

zzq1989_的专栏 4181

不用FFmpeg!纯前端实现RTSP直播的3种现代方案对比(WebSocket/Wasm/WebCodecs)

本文深入探讨了纯前端实现RTSP直播的三种现代技术方案:WebSocket代理转发、Wasm解码和WebCodecs硬解。通过详细的架构设计、性能实测数据和兼容性分析,帮助开发者在安防监控、智慧城市等场景中选择最佳方案,实现低延迟、高效率的视频流处理。

lilh34434的博客 231

Vllm进行Qwen2-vl部署(包含单卡多卡部署及爬虫请求)

使用vLLM部署Qwen2-VL,包含单卡部署、多卡部署、爬虫requests发送请求

sherlockMa的博客 2万+

别再调参了!用Simulink手把手教你搞定FOC电机速度环PI控制器(附模型下载)

本文详细介绍了如何使用Simulink搭建FOC电机速度环PI控制器,通过模最优准则和系统化调试方法,避免传统手动调参的繁琐过程。文章包含从传递函数推导到参数自动整定的完整流程,并提供了实战调试技巧与异常处理指南,帮助工程师快速实现电机控制系统的稳定运行。

weixin_42519985的博客 413

手把手教你搭建Howland电流源:从原理图到实测避坑指南(附Python数据分析)

本文详细介绍了Howland电流源的设计与实现,从原理图到实测避坑指南,涵盖电阻匹配、运放选择和PCB布局等关键环节。通过Python数据分析,展示了如何优化电路性能并解决常见问题,适合电子工程师和爱好者参考。

weixin_29291069的博客 632

Qwen3-VL震撼登场!工业智能质检系统Dify实战案例让你3分钟上手最强视觉AI

摘要: 阿里云最新推出的Qwen3-VL-235B-A22B-Instruct视觉语言模型,被誉为Qwen系列最强版本,支持多模态处理、超强OCR、长文档分析等八大核心功能,可快速应用于工业质检等场景。通过Dify平台增强插件,用户可轻松接入该模型,实现微米级缺陷检测、自动化流水线集成等功能,提升检测速度10倍、降低成本60%,显著优化生产效率。目前插件已开源并提交GitHub,用户可关注公众号获取安装包,抢先体验工业智能质检等解决方案。

weixin_41246802的博客 2051

手把手教你用89C52单片机驱动0.96寸OLED(IIC接口,附完整代码)

本文详细介绍了如何使用89C52单片机通过I2C接口驱动0.96寸OLED显示屏,包括硬件连接、I2C通信原理、SSD1306驱动芯片的初始化及显存管理技巧,并提供了完整的代码示例和常见问题排查方法,帮助电子爱好者快速掌握OLED显示技术。

weixin_30781433的博客 369

Qwen3-VL王炸来袭!工业智能质检Dify实战保姆级教程,3分钟上手最强视觉AI,收藏这篇就够了!

还在为复杂的视觉AI部署发愁?还在羡慕别人家的智能应用系统?今天给大家带来一个重磅消息——**Qwen3-VL-235B-A22B-Instruct** 正式登场!这款被誉为"迄今为止Qwen系列中最强大的视觉语言模型",不仅在魔搭社区免费开放,更能轻松接入Dify平台,让你10分钟就能搭建出专业级的AI应用。

Python_cocola的博客 1507

最新版 Akamai 逆向 风控破解

经过测试,捷星 jetstar.com,德州仪器 ti.com,w6 wizzair.com,还有一些航空公司的都是可以实现一个并发的有需要的可以。

m0_72605044的博客 6618

深入解析数据通信中的码元速率与比特率:从基础到实战应用

本文深入解析了数据通信中的核心概念码元速率与比特率,通过生动的比喻和公式(比特率=波特率×log₂(M))揭示其本质关系。文章结合BPSK、QPSK、16QAM等调制技术,剖析了从4G/5G到LoRa等实战场景中如何权衡速率、距离与可靠性,并提供了软考真题解析与系统设计建议,帮助读者从理论到应用全面掌握数据速率优化。

weixin_29324877的博客 213

【珍藏必备】Qwen3-VL大模型实战:10分钟搭建工业级AI质检系统,小白程序员必学指南

文章介绍Qwen3-VL视觉语言模型,在魔搭社区免费开放且可接入Dify平台。模型具备视觉代理、OCR等八大功能,可实现微米级缺陷检测等工业应用。文章详解Dify平台配置方法,提供工业智能质检系统实战案例,展示10倍检测速度提升、60%成本降低等商业价值,是小白和程序员学习大模型应用的实用指南。

datian1234的博客 2055

WOFOST作物模型(7):6.0.6版本的PCSE使用(多层水分平衡和SNOMIN碳氮模型的集成)

wofost81文件结构如上,其中所需的参数可从github上获取然后input下有两个需要调用的功能函数py文件,需要拖到自己的运行py文件同级目录下在使用土壤模块SNOMIN进行作物生长模型模拟时,需要为土壤剖面的不同层次提供多种输入变量。这些变量通常不随年份变化,因此会统一在土壤文件中定义。本节将说明如何将这些输入变量整合到一个字典中,进而生成SNOMIN能够读取的土壤文件。

所有专家都曾始于新手 637

通义千问Qwen-VL-Chat大模型本地部署(一)

qwen-vl-chat本地运行和api接口调用

liukangjie520的博客 8166

fasterlio原理及代码框架梳理

Faster-LIO 的优势是在保持同等高精度的前提下,显著提升计算效率,以支持更极端的应用场景(如高速无人机)和更廉价的硬件平台。可以把 Faster-LIO 理解为用一把更快的“空间哈希筛子”(iVox)替换了原来精细的“动态平衡树”(ikd-Tree),从而在精度损失极小的情况下,实现了效率的显著提升。:只在实际有地图点的空间区域动态创建和保留体素单元,形成一个稀疏的体素地图。是关键:将去畸变点云中的每个点,在 iVox 维护的局部地图中搜索近邻(如5个最近点),构建点到面的距离残差。

Studying…… 246

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

国产开源最强?Qwen2-VL强势发布,效果实测!

大家好,趁着周末赶紧看下本周最新发布的多模态大语言模型Qwen2-VL。因为Qwen2比Qwen提升很大,而且Qwen2-VL还将开源大参数量的模型Qwen2比Qwen强在哪里:https://www.zhihu.com/question/658307301Qwen2系列模型大幅提升了代码、数学、推理、指令遵循、多语言理解等能力,性能不仅超过美国最强的开源模型 Llama3-70B,也超过文心 4...

zero的博客 3180

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

最强开源大模型炸场!全网独一份AI大模型学习实践资源...(待会删)

最强开源大模型炸场!全网独一份AI大模型学习实践资源...(待会删)

Y525698136的博客 1658

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

MLLM(二)| 阿里开源视频理解大模型:Qwen2-VL

从六个关键维度评估模型的视觉能力:复杂的大学水平问题解决、数学能力、文档和表格理解、多语言文本图像理解、一般场景问答、视频理解和基于代理的交互。此功能为更直观和身临其境的交互铺平了道路,Qwen2-VL 不仅充当观察者,而且是我们视觉体验的积极参与者。此外,更小的 2B 模型针对潜在的移动部署进行了优化。Qwen2-VL 现在拥有改进的对象识别功能,超越了植物和地标,可以理解场景中多个对象之间的复杂关系。在 7B 模型上,保留了对图像、多图像和视频输入的支持,以更具成本效益的模型大小提供有竞争力的性能。

wshzd的博客 6281

【多模态大模型】Qwen2-VL基本原理和推理部署实战

具体实现代码地址:https://github.com/huggingface/transformers/blob/main/src/transformers/models/qwen2_vl/modeling_qwen2_vl.py。具体实现代码地址:https://github.com/QwenLM/Qwen2-VL/blob/main/qwen-vl-utils/src/qwen_vl_utils/vision_process.py。Qwen2 VL的一个关键架构改进是引入了原生动态分辨率支持。

weixin_43799388的博客 1万+

代码角度,深度解析 Qwen2-VL 模型结构

快速开始,接下来我会简单说说 Qwen2-VL 整体结构当中的几个关键的细节。帮助大家快速理解Qwen2-VL结构和其他网络结构的不同。

Python_cocola的博客 8672

【机器学习】阿里Qwen-VL:基于FastAPI私有化部署你的第一个AI多模态大模型

本文首先在引言中强调了一下OpenAI兼容API的重要性,希望引起读者重视,其次介绍了Qwen-VL的原理与模型结构,最后简要讲了下FastAPI以及搭配组件,并基于FastAPI封装了OpenAI兼容API的Qwen-VL大模型服务端接口,并给出了客户端实现。本文内容在工作中非常实用,希望大家能有所收获并与我交流。期待您的关注+三连

人工智能领域博客 1万+

MLM之Qwen:Qwen2-VL的简介、安装和使用方法、案例应用之详细攻略

​ MLM之Qwen:Qwen2-VL的简介、安装和使用方法、案例应用之详细攻略 目录 Qwen2-VL的简介 Qwen2-VL的安装和使用方法 Qwen2-VL的案例应用 Qwen2-VL的简介 2024年8越30日,阿里云重磅发布Qwen2-VL!Qwen2-VL是Qwen模型系列中最新版本的视觉语言模型。Qwen2-VL是由阿里云qwen2团队开发的多模态大型语言模型系列。 GitHub地址:https://

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 1万+

Qwen2-VL多模态大模型微调实战教程

Qwen2-VL是通义千问团队最近开源的大语言模型,由阿里云通义实验室研发。以Qwen2-VL作为基座多模态大模型,通过的方式实现特定场景下的OCR,是学习的入门任务。本文我们将简要介绍基于 transformers、peft 等框架,使用 Qwen2-VL-2B-Instruct 模型在上进行Lora微调训练,同时使用监控训练过程与评估模型效果。

SoulmateY的博客 1万+

1张图片+3090显卡微调Qwen-VL视觉语言大模型(仅做演示、效果还需加大数据量)

一张图微调qwen-vl

进一寸有一寸的欢喜 6694

国内经典多模态大模型工作1——Qwen-VL系列(Qwen-VL、Qwen2-VL解读)

Qwen-VL家族论文解读

Mugi_jiang的博客 4382

【多模态】qwen2-vl模型代码技术学习

qwen2-vl的学习记录

威化饼的一隅 4234
上一篇: StarShip v0.5版本更新
下一篇: 传神论文中心|第24期人工智能领域论文推荐
OpenCSG
博客等级 码龄3年 1679粉丝 575原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值