ELK入门(八)——Logstash多beat配置(以Filebeat、Metricbeat为例)

logtash + filebeat 采集多日志的区分使用 在filebeat配置文件中加入以下内容,然后重启filebeat vim filebeat.yml #由于需要收集多个日志文件以便在Elasticsearch中生成索引,因此我们需要给不同的日志文件先打一个标记,以便在logstash中使用 tags: ["zgzg"] #开启该配置,表示从日志文件的尾部开始获取日志,不必完全加载所有日志,以防数据太大 tail_files... 阅读详情

之前的文章中我们用Filebeat连接Logstash实现了到es的传输,但如果我们有多种采集器(beat)时,该如何配置呢。我尝试了几种方法

一、多端口(不推荐)

在之前文章中,我们的Filebeat和Logstash之间通过5044端口进行传输,如果想要不同的beat,可以开设不同的端口号,例如Filebeat为5044,Metricbeat为5043。

1.配置logstash

vim /etc/logstash/conf.d/logstash-sample.conf
input {
  beats {
    add_field => {"beatType" => "filebeat"}
    port => 5044
  }
  beats {
    add_field => {"beatType" => "metricbeat"}
    port => "5043"
  }
}

# 日志添加  remote_ip字段=>IP地址  来作为不同被监控服务器的标识
filter{
  mutate{
    add_field => {"remote_ip" => "%{[@metadata][ip_address]}"}
  }
}


output {
  if [beatType] == "filebeat" {
    elasticsearch {
      hosts => ["localhost:9200"]
      index => "filebeat-logstash-test"
    }
  }
  if [beatType] == "metricbeat" {
    elasticsearch {
      hosts => ["localhost:9200"]
      index => "metricbeat-logstash-test"
    }
  }
}

2.配置filebeat

vim /etc/filebeat/filebeat.yml

这个没有什么需要改变的,直接按原本的就好,如果没有配置过则回顾ELK入门(六)——Filebeat安装与启动(rpm包)+logstash(rpm包) 

3.配置metricbeat

在上一节中我们只尝试了metricbeat直接传到elasticsearch,所以这里要重新配置一下。

vim /etc/metricbeat/metricbeat.yml 

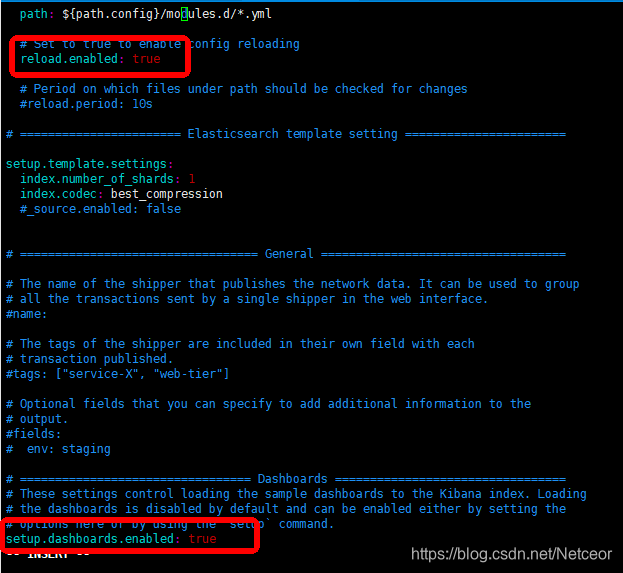
以下只列出调整过的内容

①

reload.enabled: true
setup.dashboards.enabled: true
 ②output中注释elasticsearch,启用logstash
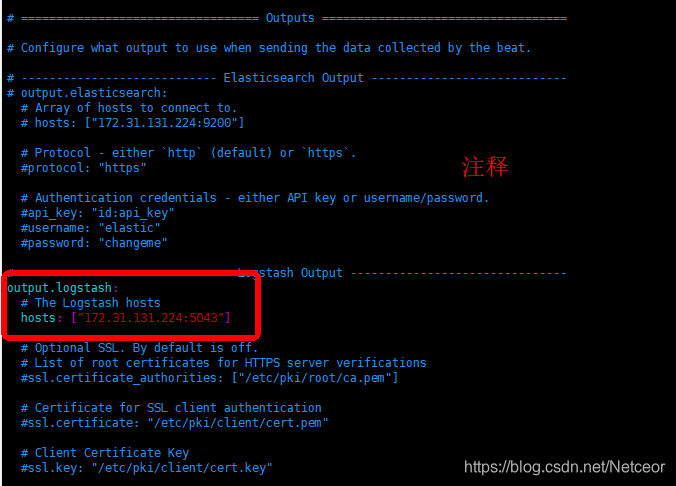
4.重启

重启logstash和beats

systemctl restart logstash
systemctl restart filebeat
systemctl restart metricbeat

发现在head上已经显示出这两个索引了
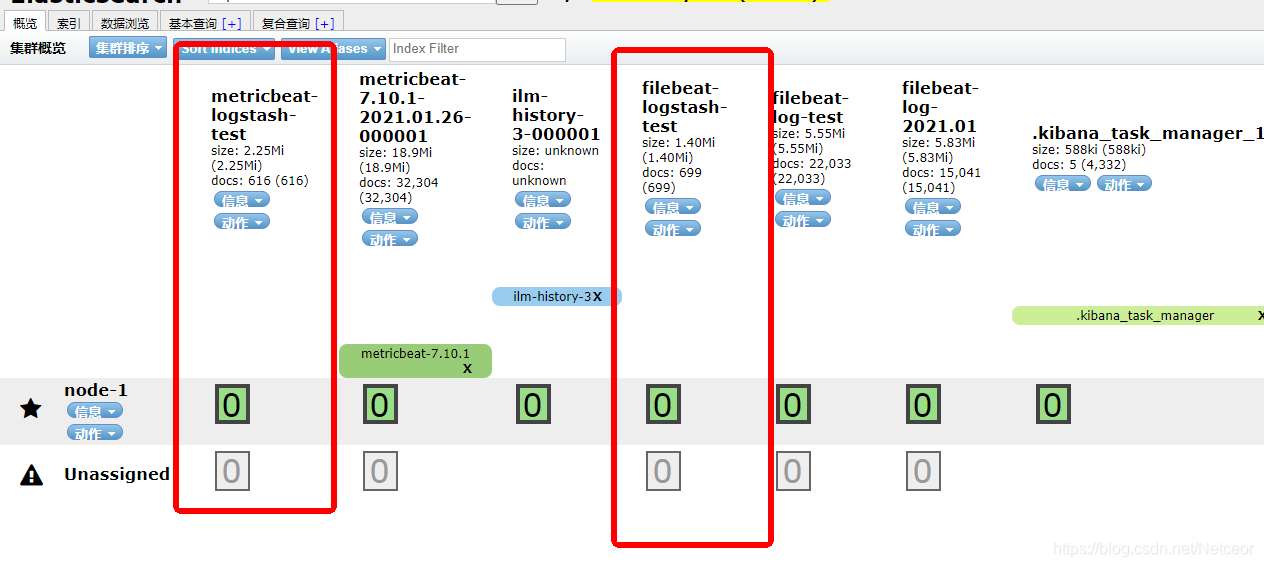
这里filebeat读取的内容很少,是因为已经有了采集过的记录,想要从头开始导入可参见博客ELK入门——解决:删除索引,重运行logstach后messages数据量变少

二、加入tag,输出判断(少量时推荐)

多端口配置这是一种方法,不过当采用多种采集器的时候,难道要给每个采集器都分配一个端口么,这显然是不太合理的,配置过程也非常麻烦,可移植性低。因此还有另外一种方法,就是给每种beat在配置文件中分配好tag,用if [tag]=="" 来区分不同的采集器。

我们先删除方法一中生成的索引,然后同样的,需要对logstash和beat进行相关配置。

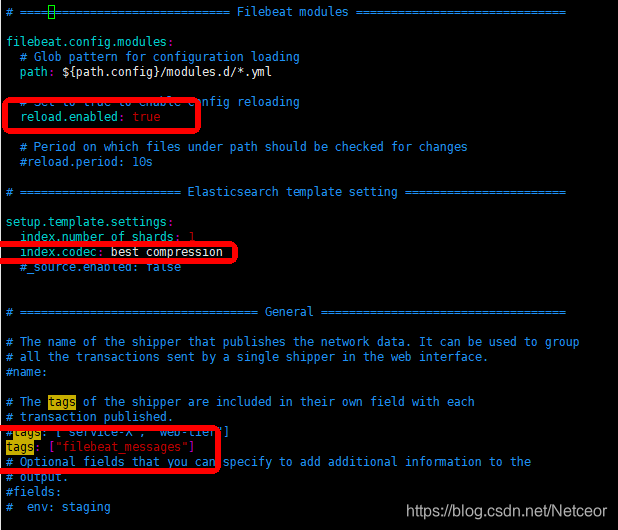
1.配置filebeat

vim /etc/filebeat/filebeat.yml
reload.enabled: true

setup.template.settings:
  index.number_of_shards: 1
  index.codec: best_compression


tags: ["filebeat_messages"]

output.logstash:
  # The Logstash hosts
  hosts: ["localhost:5044"]
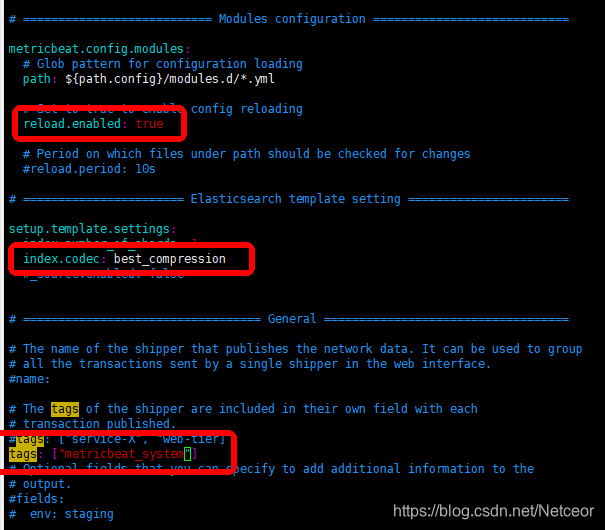
2.配置metricbeat

vim /etc/metricbeat/metricbeat.yml
reload.enabled: true

setup.template.settings:
  index.number_of_shards: 1
  index.codec: best_compression


tags:["metricbeat_system"]

output.logstash:
  # The Logstash hosts
  hosts: ["localhost:5044"]
3.配置logstash

vim /etc/logstash/conf.d/logstash-sample.conf
nput {
  beats {
    port => 5044
  }
}

output {
  if "filebeat_messages" in [tags] {
     elasticsearch {
        hosts => ["http://local:9200"]
        index => "filebeat_logstash_test"
     }
  }
  if "metricbeat_system" in [tags] {
       elasticsearch {
          hosts => ["http://localhost:9200"]
          index => "metricbeat_logstash_test"
       }
    }
  # elasticsearch {
  #   hosts => ["http://localhost:9200"]
  #   index => "%{[@metadata][beat]}-%{[@metadata][version]}-%{+YYYY.MM.dd}"
  # }
}

4.启动

systemctl restart logstash
systemctl restart filebeat
systemctl restart metricbeat

查看head,有索引成功生成
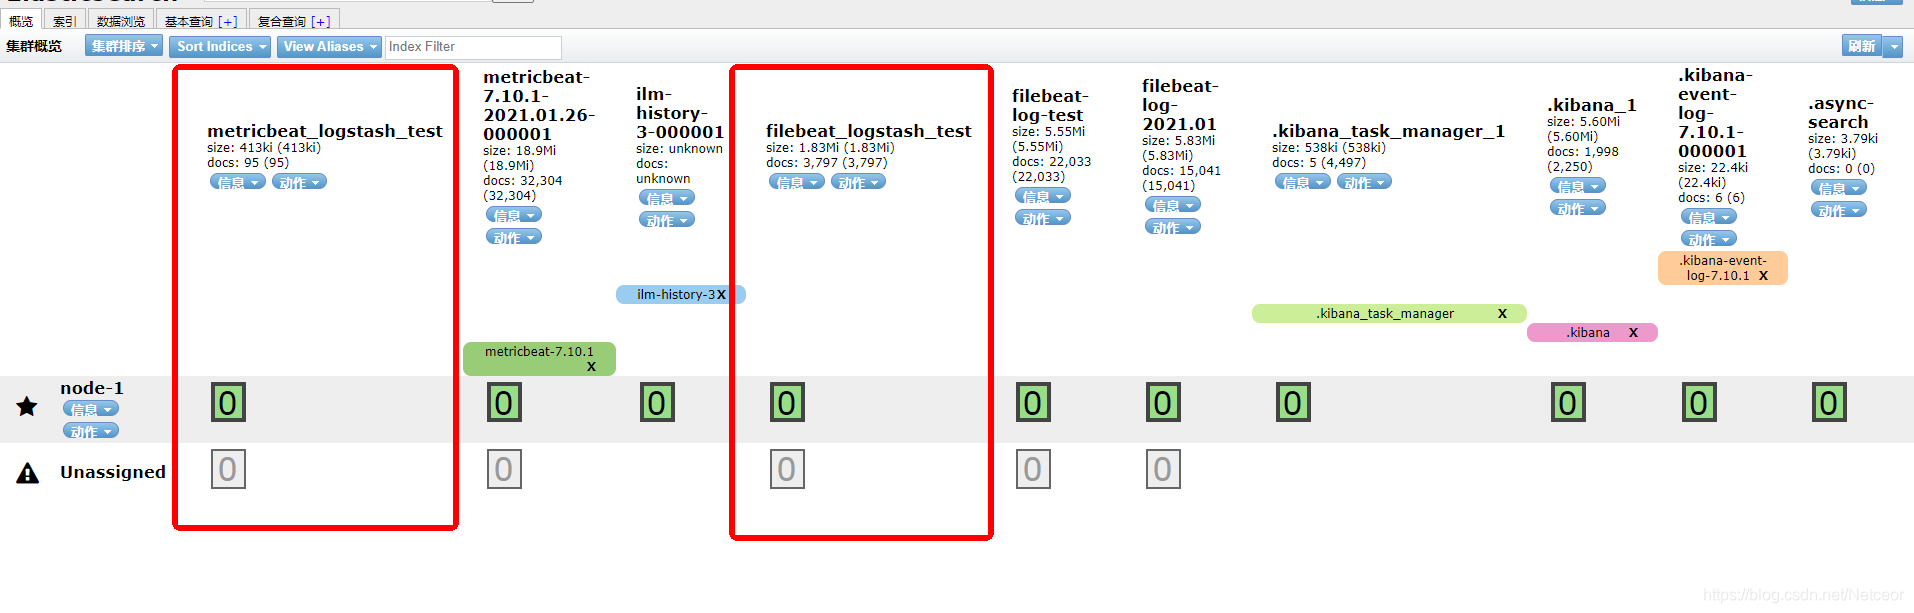
这两种方法掌握后更多的beat其实也是相类似的配置方法

三、logstash.yml表达式区分(推荐)

还有一种方法及其简单,我在后面的博客进行了应用,可以参见ELK入门(十)——Beats的多服务器/系统部署(以Metricbeat为例)并Kibana查看

只修改logstash.yml即可

input {
  beats {
    port => 5044
  }
}

output {
  elasticsearch  {
    hosts => ["172.31.131.224:9200"]
    index => "%{[@metadata][beat]}-%{[@metadata][version]}-test"
  }
}

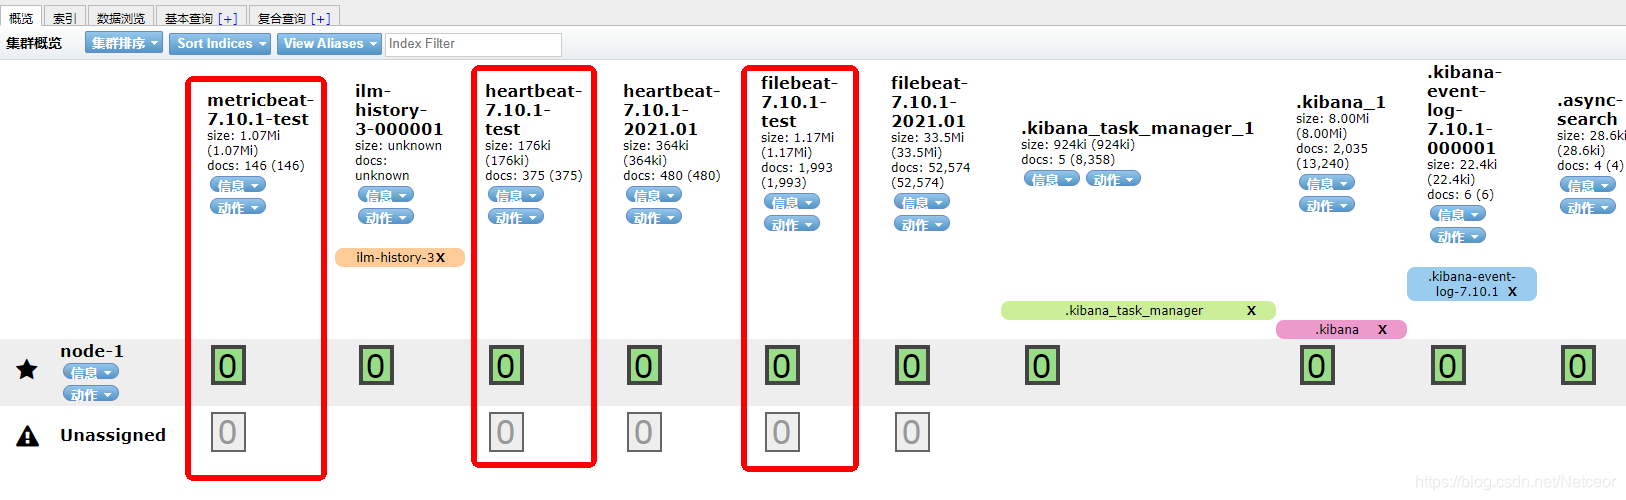
通过这段语句,可以区分开不同beat的不同版本 

重运行logstash后会发现head生成索引了,因为此时我有三种采集器在采集,所以也生成了三个采集器的索引。
 

参考博客

安装部署ELK教程 (Elasticsearch+Kibana+Logstash+Filebeat+Metricbeat) 基于7.9.3版本

Logstash多beat数据源配置

filebeat同时采集多个日志时,logstash和filebeat的文件配置 阅读详情

相关推荐

logstash 和 filebeat多行日志 合并

filebeat logstash 配置多行日志 合并

cagezxy的博客 2452

ELK beat篇

启动Filebeat时,它会启动一个或多个查找器,查看你为日志文件指定的本地路径。每个harvester都会为新内容读取单个日志文件,并将新日志数据发送到libbeat,后者将聚合事件并将聚合数据发送到你为Filebeat配置的输出。beat介绍: 负责采集数据的一款软件,实时洞查日志(filebeat),分析网络数据包(packetbeat),指标采集(metricbeat),等等,将采集的数据发送给elasticsearch,redis,等等。Heartbeat:运行时间监控(收集系统运行时的数据)

qq_41616955的博客 462

机器学习之性能度量

废话不说,本文分为两个部分: 第一部分,我对周志华教授《机器学习》这本书中性能度量知识点中疑难点的学习感悟;第二部分,我感觉该书2.3节 性能度量 中最后部分的代价曲线表述有误,苦于没找到联系教授的正确方式,故希望与广大网友一起探讨。

hustqb的博客 4628

logstash 和 beats的关系

logstash和beats的关系 好多人都觉得beats出来是用来替代logstash的。实际上并不是,beats只是用来优化logstash的,因为logstash消耗的性能比较多。如果只是单纯的为了收集日志,使用logstash就有点大材小用了,另外有点浪费资源。而beats是轻量级的用来收集日志的。 而logstash更加专注一件事,那就是数据转换,格式化,等处理工作。比方说,日志数据是一行一行的非格式化的数据,想要存在elasticsearch就要有一定的结构。logstash就可以...

Angus 5372

【机器人】机械臂控制入门技术栈分享

机械臂控制入门技术栈分享1.前言2.机器人控制入门技术栈2.1.空间描述和变化2.2.运动学分析2.3.动力学建模2.4.控制入门学习3.进阶部分3.1.机器人参数辨识3.2.非线性控制3.3.现代机器人描述方法:指数坐标4.总结 1.前言 今天看到优快云上有个分享个人技术栈的活动,虽然我不是一个正规的程序员,也不搞前端、后端这些,但我一直在优快云上通过写博客对我的学习进行总结,于是我突发奇想,不如我也写一下我的个人技术栈,针对机械臂控制入门的,因为我水平也不高,所以本文内容也许不够饱满,也不够准确,但

要恰饭得嘛 5858

人工智能情感分析实战:文本情绪识别

人工智能情感分析,特别是文本情绪识别,已成为理解和处理人类情感信息的重要工具。通过数据预处理、特征提取、模型训练与评估等步骤,我们可以有效地从文本数据中提取情感信息,为各种应用场景提供有价值的洞察。随着技术的不断进步和创新,情感分析的应用前景将更加广阔,为我们的生活和工作带来更多便利和机遇。

shejizuopin的博客 1095

ELK结合Beats工具的搭建使用(Metricbeat、Filebeat、Topbeat)

ELK之间的合作机制: L(Logstash)作为信息收集者,主要是用来对日志的搜集、分析、过滤,支持大量的数据获取方式,一般工作方式为c/s架构,client端安装在需要收集日志的主机上,server端负责将收到的各节点日志进行过滤、修改等操作在一并发往elasticsearch上去。 E(Elasticsearch)作为数据的保存者,保存来自L(Logstash)收集的系统日志数据。 K(Ki...

qq_40907977的博客 1196

五段式S型算法笔记

又因为有 v-v0= 0.5jt通式: 所以有 vm-v0= 0.5jtm 所以有4vm-4v0= 2jtm。算法1: v=2vm-v0-0.5*jt+2jt*tm-2jtm*tm。加加速度j 自己设置 已知,vmax自己设置已知;所以有4vm-4v0= 2jtm带入算法1。

qq_36658033的博客 681

ELK系列-(四)轻量级的日志收集助手-Beat家族

Beats是 Elastic Stack 提供的一组轻量级数据采集器,负责从各种来源采集数据,然后将数据发送到或Logstash。这些小工具非常轻巧,占用系统资源少,适用于海量的分布式环境。Beats官方文档地址。

LIUCHUAN01的博客 1342

SAP 银企直连实战:从零构建 DMEEX 格式树的配置与调试指南

本文详细介绍了SAP银企直连中DMEEX格式树的配置与调试方法,涵盖从基础认知到实战技巧的全流程。通过具体案例解析,帮助财务顾问快速掌握建设银行付款报文的格式树搭建、字段映射及调试优化,提升企业支付效率与准确性。

weixin_42526015的博客 567

中孚保密检查系统彻底卸载指南:绕过口令与清除内核残留

中孚保密检查系统是深度集成于Windows内核的合规管控软件,其卸载涉及用户态口令校验、内核态服务引擎与Ring 0级驱动自保三重机制。理解其基于SHA-256哈希的本地口令验证原理和zfsysflt.sys过滤驱动的加载逻辑,是实现无残留清理的技术前提。该系统具备高权限驻留特性,常规卸载工具无法触达驱动与服务层,易引发蓝屏、启动缓慢及新安全软件冲突等工程问题。典型应用场景包括涉密终端批量清退、安全研究环境重建及误装后紧急退出。本文聚焦‘口令绕过+手动清理’双轨方案,覆盖注册表、服务、驱动、文件与计划任务五

weixin_33508411的博客 1045

如何实现对ELK各组件的监控?试试Metricbeat

一、前言 开发排查系统问题用得最多的手段就是查看系统日志,ELK 是 Elastic 公司开源的实时日志处理与分析解决方案,已经为日志处理方案的主流选择。 而在生产环境中,如何针对 ELK 进行监控,保证各个组件正常运行?如何知道目前的资源是否能承受线上的压力呢?本文主要是以 Elastic Stack 7.x 版本为例,介绍如何监控 ELK 自身的各个组件。   二、总体架构 常见的 Elastic Stack 日志系统架构如下 其中可使用 Metricbeat 组件作为轻量级监视代理,通过.

zlt2000的博客 962

2026实测可用!4个专业AI Agent Skills垂直搜索平台对比

📊本文以表格形式整理4个实测可用的专业AI Agent Skills垂直搜索平台,涵盖资源规模、适配生态等关键维度🤖,适合开发者按需选择技能获取渠道,解决平台筛选与访问难题✨

XiaoqiangClub的博客 525

ES系列之Beats及Filebeat实战入门

Beats概述,成员,第三方Beats;ELK引入Beats后的两种架构;安装;原理;配置文件;实战:输出到Logstash、ES、采集Nginx日志;进阶:libbeat、Metricbeat、Winlogbeat、Packetbeat

lonelymanontheway的博客 2252

设备接入与APP(应用程序)接入华为云iotDA平台的详细操作步骤及获取方式

设备及APP(应用程序) 登录 IoTDA 平台所需的 入场与操作清单内容,提供逐项详细操作步骤和获取方式,并穿插贴士便于理解与实际操作落地。内容基于 华为云 IoTDA 控制台 和 IAM 控制台 的实际使用路径整理。

hy行者勇哥的博客 3059

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

ELK+filebeat+metricbeat+heartbeat+auditbeat安装配置及汉化

一、基础环境介绍 Centos 7.5 x64 ElasticSearch 6.5.1 Logstash 6.5.1 Kibana 6.5.1 filebeat 6.5.1 metricbeat 6.5.1 heartbeat 6.5.1 auditbeat 6.5.1 Kibana_Hanization 6.5.1 二、ElasticSearch安装 安装JDK,配置J...

江南T雨 4334

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

Linux学习14-logstash插件,日志采集及可视化,ES数据备份与集群监控

从本地文件系统中读取日志内容,类似于 tail -f 命令,持续监控文件新增内容并采集编辑之前的conf.d文件指定读取本机系统日志文件,指定从头开始读取,创建syslog启动 Logstash 进程,将服务器上的 /var/log/messages 历史日志全部抓取出来,在屏幕上显示的同时发送到远程的 Elasticsearch 集群中存储浏览器访问elastic search-head192.168.154.170:9100,出现syslogsincedb文件一共6个字段。

ljxnb666050705的博客 238

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

ELK入门

26.1 ELK入门 在日常运维工作中,对于系统和业务日志的处理尤为重要。作为运维工程师,假如管理的服务器数量并不是很多,那么不需要借助任何工具也能管理过来。但如果服务器数量非常多,而因为业务的关系,运维和开发人员常常需要通过查看日志来定位问题,很明显不借助任何工具来帮助我们管理日志是不现实的,不仅让人感觉繁琐,效率也会低下。 ELK介绍 需求背景: 1. 业务发展越来越庞大,服务器越来越多; ...

变成习惯 2797

Beats:Elastic Beats 介绍 及和 Logstash 的比较

ElasticStack传统上由三个主要组件(Elasticsearch,Logstash和Kibana)组成,早已脱离了这种组合,现在也可以与名为“ Beats”的第四个元素结合使用--一个针对不同用例的日志运送者系列。 现在网上有一种说法叫做ELKB,这里的B就是指的beats. 本教程为刚刚熟悉堆栈的用户提供了指南,并提供了开始使用不同节奏的信息-Filebeat,Packetbeat,M...

Elastic 中国社区官方博客 6784

【全文检索_09】Logstash 基本介绍

ELK 是 Logstash(收集)、Elasticsearch(存储 + 搜索)、Kibana(展示),这三者的简称,以前称为 ELK Stack,现在称为 Elastic Stack,后来还加入了 Beats 来优化 Logstash。我们之前介绍了 Elasticsearch 和 Kibana 的简单使用,现在重点介绍一下 Logstash。

Demo_Null 735

Centos7.5搭建ELK+Beats

基于centos7.5搭建elk+beats用以收集java应用日志,以及监控服务器使用情况。

E=mc² 1538

在ELK架构中的Filebeat作用

在ELK中架构中的Filebeat作用: 隶属于Beats,轻量级数据收集引擎。基于原先 Logstash-fowarder 的源码改造出来。换句话说:Filebeat就是新版的 Logstash-fowarder,也会是 ELK Stack 在 Agent 的第一选择,目前Beats包含四种工具: 1.Packetbeat(搜集网络流量数据) 2.Metricbeat(搜集系统、进程和文件系统级别的 CPU 和内存使用情况等数据。) 3.Filebeat(搜集文件数据) 4.Winlogbeat(搜集

weixin_46468085的博客 1113

ELK-转载备份

学习思路 名词解释 资料连接 目前生产上使用ELK已经很成熟,本文只是搜索部分资料,了解其原理即可 一、名词解释 ELK分别为: Elasticsearch: 核心中的核心组件,基于著名的全文检索引擎lucence的一个分布式版本。由于扩展成分布式,容量和性能得到极大的提升,使得Elasticsearch得以成为目前许多大数据产品和大数据架构的核心组件。 Logstash: 一个灵活的...

重点在于记录 226

filebeat概述

本文使用的filebeat是7.7.0的版本 本文从如下几个方面说明: filebeat是什么,可以用来干嘛 filebeat的原理是怎样的,怎么构成的 filebeat应该怎么玩 回到顶部 一、filebeat是什么 1.1、filebeat和beats的关系   首先filebeat是Beats中的一员。   Beats在是一个轻量级日志采集器,其实Beats家族有6个成员,早期的ELK架构中使用Logstash收集、解析日志,但是Logstash对内存、cpu、io等资源消耗比较高。相

zhaisharap的专栏 1455
上一篇: ELK入门——解决:logstash运行失败[LogStash::Runner] Logstash - java.lang.IllegalStateException
下一篇: ELK入门——解决:Failed to start heartbeat.service: Unit not found
Netceor
博客等级 码龄9年 1047粉丝 306原创
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值