爬虫re&urllib

Python尖括号 - 解析Python中的符号 Python尖括号是Python编程语言中的一个特殊符号,它在Python中具有多种功能和用途。本文将从多个方面介绍Python尖括号的用法和使用方法。 阅读详情

参考:

python爬虫系列(一)_Huterox的博客-优快云博客

python爬虫系列(二)_Huterox的博客-优快云博客

一、准备

pip install urllib3

urllib的模块

request:基本的HTTP请求模块用于模拟发送请求
error:异常处理模块
parse:用于处理URL比如拆分,解析,合并,data参数等
robotparser:用于识别网站的robot.txt文件,判断网站是否可以爬取

urllib.request

urllib.request的方法有:
urlretrieve() 下载文件
urlcleanup() 释放缓存
urlopen() 发送请求get

import urllib.request as u
r=u.urlopen('https://123.sogou.com/')
u.urlcleanup()
print(r.read().decode('utf-8'))
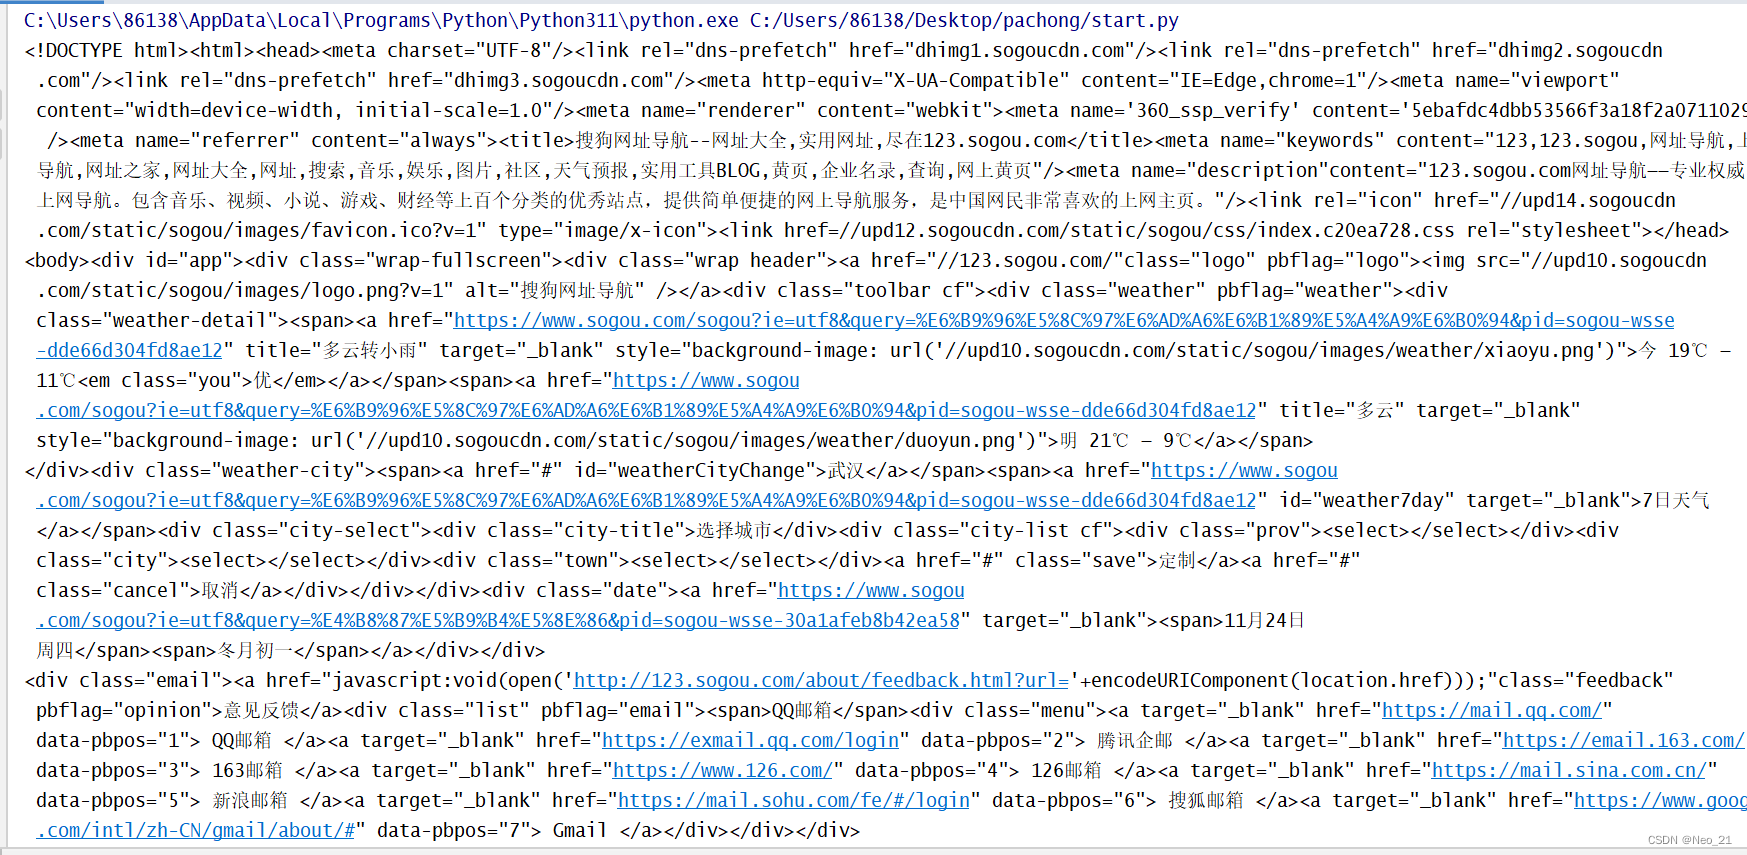
urlopen 方法

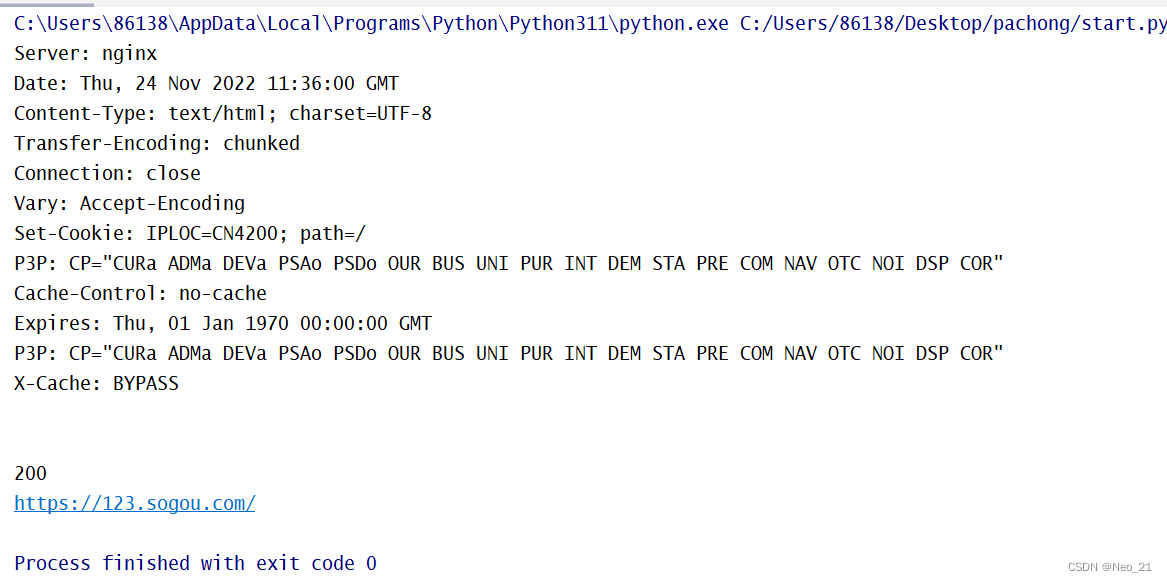
info 获取当前内容状态
getcode 输出状态码
geturl 获取当前网址

import urllib.request as u
r= u.urlopen('https://123.sogou.com/')
u.urlcleanup()
# print(r.read().decode('utf-8'))

print(r.info())  #内容状态

print(r.getcode()) #状态码

print(r.geturl()) #当前网址
 二、实例

正则表达式

作用:提取出对我们有用的内容。

说到提取也许你们会先想到使用解析库比如BeautifulSoup 但是对于处理一些简单问题的话正则表达式无疑会更加高效!

Python 正则表达式:


        正则表达式是一个特殊的字符序列,它能帮助你方便的检查一个字符串是否与某种模式匹配。Python 自1.5版本起增加了re 模块,它提供 Perl 风格的正则表达式模式。

re 模块

也提供了与这些方法功能完全一致的函数,这些函数使用一个模式字符串做为它们的第一个参数。

re.match函数:
示例:

re.match(pattern, string, flags=0)

pattern 匹配的正则表达式
string 要匹配的字符串。
flags 标志位,用于控制正则表达式的匹配方式,如:是否区分大小写,多行匹配等等。匹配成功re.match方法返回一个匹配的对象,否则返回None。


re.search函数:

re.search(pattern, string, flags=0)

re.search 扫描整个字符串并返回第一个成功的匹配。

区别
re.match与re.search的区别
re.match只匹配字符串的开始,如果字符串开始不符合正则表达式,则匹配失败,函数返回None;而re.search匹配整个字符串,直到找到一个匹配。

检索和替换:

Python 的 re 模块提供了re.sub用于替换字符串中的匹配项

re.sub(pattern, repl, string, count=0, flags=0)

参数:
pattern : 正则中的模式字符串。
repl : 替换的字符串,也可为一个函数。
string : 要被查找替换的原始字符串。
count : 模式匹配后替换的最大次数,默认 0 表示替换所有的匹配。

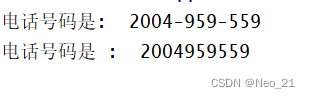
import re
phone = "2004-959-559 # 这是一个国外电话号码"
num = re.sub(r'#.*$',"",phone) # 删除字符串中的 Python注释
print( "电话号码是: ", num)
num = re.sub(r'\D', "", phone)# 删除非数字(-)的字符串
print( "电话号码是 : ", num)
 re.compile 函数

根据一个模式字符串和可选的标志参数生成一个正则表达式对象。该对象拥有一系列方法用于正则表达式匹配和替换。

re.compile(pattern[], flags)
// 模式字符串,标志参数


path = re.compile('p[y-z]*thon,re.I)
//path 就是正则表达式对象

pattern : 一个字符串形式的正则表达式
flags : 可选,表示匹配模式,比如忽略大小写,多行模式等,具体参数为:


re.I 忽略大小写
re.L 表示特殊字符集 \w, \W, \b, \B, \s, \S 依赖于当前环境
re.M 多行模式
re.S 即为 . 并且包括换行符在内的任意字符(. 不包括换行符)
re.U 表示特殊字符集 \w, \W, \b, \B, \d, \D, \s, \S 依赖于 Unicode 字符属性数据库
re.X 为了增加可读性,忽略空格和 # 后面的注释


findall函数

在字符串中找到正则表达式所匹配的所有子串,并返回一个列表,如果没有找到匹配的,则返回空列表。
注意: match 和 search 是匹配一次 findall 匹配所有。
语法格式为:

findall(string, pos, endpos)

re.findall(path,string)

string : 待匹配的字符串。
pos : 可选参数,指定字符串的起始位置,默认为 0。
endpos : 可选参数,指定字符串的结束位置,默认为字符串的长

import re
 
pattern = re.compile(r'\d+')   # 查找数字
result1 = pattern.findall('root 123 google 456')
result2 = pattern.findall('run88oob123gofuteroxe456', 0, 10)
 
print(result1)
print(result2)
输出结果:
['123', '456']
['88', '12']

正则表达式模式

前面我们介绍了re模块那么我们来介绍一下表达式模式,

比如pattern = re.compile(r’\d+’) 中'\d+'就是一种模式:

正则表达式模式
^ 匹配字符串的开头
$匹配字符串的末尾
.匹配任意字符,除了换行符,当re.DOTALL标记被指定时,则可以匹配包括换行符的任意字符
[…] 用来表示一组字符,单独列出:[amk] 匹配 ‘a’,‘m’或’k’
[^…]不在[]中的字符:[^abc] 匹配除了a,b,c之外的字符
re* 匹配0个或多个的表达式
re+ 匹配1个或多个的表达式
re?匹配0个或1个由前面的正则表达式定义的片段,非贪婪方式
re{n} 精确匹配 n 个前面表达式。例如, o{2} 不能匹配 “Bob” 中的 “o”,但是能匹配 “food” 中的两个 o。
re{n,}匹配 n 个前面表达式。例如, o{2,} 不能匹配"Bob"中的"o",但能匹配 “foooood"中的所有 o。“o{1,}” 等价于 “o+”。“o{0,}” 则等价于 “o*”。
re{n,m} 匹配 n 到 m 次由前面的正则表达式定义的片段,贪婪方式
a| b匹配a或b
(re)匹配括号内的表达式,也表示一个组
(?imx)正则表达式包含三种可选标志:i, m, 或 x 。只影响括号中的区域
(?-imx)正则表达式关闭 i, m, 或 x 可选标志。只影响括号中的区域
(?: re)类似 (…), 但是不表示一个组
(?imx:re)在括号中使用i, m, 或 x 可选标志
(?-imx: re) 在括号中不使用i, m, 或 x 可选标志
(?#…) 注释.
(?= re) 前向肯定界定符。如果所含正则表达式,以 … 表示,在当前位置成功匹配时成功,否则失败。但一旦所含表达式已经尝试,匹配引擎根本没有提高;模式的剩余部分还要尝试界定符的右边。
(?! re) 前向否定界定符。与肯定界定符相反;当所含表达式不能在字符串当前位置匹配时成功
(?> re) 匹配的独立模式,省去回溯。
常用的表达式
\w匹配字母数字及下划线
\W匹配非字母数字及下划线
\s 匹配任意空白字符,等价于 [\t\n\r\f]
\S匹配任意非空字符
\d匹配任意数字,等价于 [0-9
\D匹配任意非数字
\A匹配字符串开始
\Z 匹配字符串结束,如果是存在换行,只匹配到换行前的结束字符串
\z 匹配字符串结束
\G 匹配最后匹配完成的位置
\b  匹配一个单词边界,也就是指单词和空格间的位置。例如, ‘er\b’ 可以匹配"never” 中的 ‘er’,但不能匹配 “verb” 中的 ‘er’
\B 匹配非单词边界。‘er\B’ 能匹配 “verb” 中的 ‘er’,但不能匹配 “never” 中的 ‘er’。
\n, \t, 等. 匹配一个换行符。匹配一个制表符。等
\n, \t,匹配一个换行符。匹配一个制表符
\10匹配第n个分组的内容,如果它经匹配。否则指的是八进制字符码的表达式
\1…\9  匹配第n个分组的内容

内容有点多不要紧你只需要把常用的记住即可 \s \S \w \W \d \D 以及re.I re.M re.S 的含义即可

示例
[Pp]ython 匹配 “Python” 或 “python”
rub[ye] 匹配 “ruby” 或 “rube”
[aeiou] 匹配中括号内的任意一个字母
[0-9] 匹配任何数字。类似于 [0123456789]
[a-z] 匹配任何小写字母
[A-Z] 匹配任何大写字母
[a-zA-Z0-9] 匹配任何字母及数字
[^aeiou] 除了aeiou字母以外的所有字符
[^0-9] 匹配除了数字外的字符


4、高光图像滤镜显著改善文本图像的光学字符识别 本文介绍了高光图像滤镜在光学字符识别(OCR)中的应用,详细探讨了其技术原理、实现步骤和在多种场景下的效果。通过增强文本图像的边缘和对比度,高光滤镜显著提升了OCR的识别率,尤其适用于扫描文档、手写笔记和低质量图像。实验结果表明,该方法在不同类型的文本图像中均表现出色,并提出了未来优化方向,如深度学习集成和多模态融合,为OCR技术的发展提供了新的可能性。 阅读详情

相关推荐

RenderDoc实战:5分钟搞定安卓Vulkan应用抓帧(含常见连接失败排查)

本文详细介绍了如何使用RenderDoc工具对安卓Vulkan应用进行抓帧分析,包括环境配置、完整抓帧流程及常见连接问题的解决方案。通过实战案例和高级技巧,帮助开发者快速定位渲染问题和性能瓶颈,提升移动图形开发效率。

weixin_28318011的博客 287

Python必备知识点:从零带你学习正则表达式

文章目录1、正则简介2、方法2.1、match()2.2、search()2.3、检索和替换2.4、compile()2.5、findall()2.6、split()2.7、正则表达式修饰符 - 可选标志 1、正则简介 正则表达式是一个特殊的字符序列,它能帮助你方便的检查一个字符串是否与某种模式匹配。 Python 自1.5版本起增加了re 模块,它提供 Perl 风格的正则表达式模式,可使用import re导入re模块。 2、方法 正则表达式常见模式 特殊字符 正则表达式修饰符 - 可选标志

Code皮皮虾的博客 1329

易灵思Trion FPGA实战:5分钟搞定MIPI硬核配置(附Interface Designer避坑指南)

本文详细介绍了易灵思Trion FPGA中MIPI硬核的快速配置方法,通过Interface Designer工具实现从时钟配置到数据收发的全流程实战。特别针对初次接触Trion系列的设计师,提供了六个关键配置陷阱及解决方案,帮助开发者高效完成嵌入式视觉和高速数据传输项目。

eee77的博客 795

正则表达式(一)_宿雪家的小镇_新浪博客

目录 跳过目录 本文目标 如何使用本教程 正则表达式到底是什么东西? 入门 测试正则表达式 元字符 字符转义 重复 字符类 分枝条件 反义 分组 后向引用 零宽断言 负向零宽断言 注释 贪婪与懒惰 处理选项 平衡组/递归匹配 还有些什么东西没提到 联系作者 网上的资源及本文参考文献 更新纪录 本文目标 30分钟内让你明白正则表达式是什么,并对它有一些基本的了解,让你可以在自己的...

suxue1994的博客 239

利用SPSS实现逻辑回归,树模型,以及广义线性模型

本案例是IBM SPSS数据分析与挖掘实战案例精粹----第九章的学习记录 案例背景:分析出导致急救后迟发性颅脑损伤的主要影响因素,共有201项案例: 分析思路:先使用logistic回归模型进行影响因素筛选,然后利用分类树探索自变量中是否存在交互作用,最后利用广义线性模型过程拟合带交互项的Logistic回归模型 字段:性别,年龄,收缩压,舒张压,血小板,脑挫伤,中线位移,脑肿胀,入院意识,是否手术急救,其余急救措施,是否出现迟发性脑损伤; ...

hepan_defeng的博客 1万+

STM32F407单一定时器输出4路不同频率及占空比的PWM波

STM32F407单一定时器输出4路不同频率及占空比的PWM波

qq_43868701的博客 4920

python | 正则表达式匹配字符串中的符号

有的时候需要匹配字符串里的一些特定符号,比如匹配字符串中有没有感叹号、问好来评价原文的情感倾向 整理了以下各个标点符号的表达式: 符号 表达式 。 \u3002 ; \uff1b , \uff0c : \uff1a “ \u201c ” \u201d ( \uff08 ) \uff09 、 \u3001 ? \uff1f ! \uff01 《 \u300a 》 \u300b 其余的符号匹配表达式可见:这里 import re # 匹配字符串

weixin_46304228的博客 3621

YOLOv8环境搭建+训练自己的数据详细项目

直接按照路径会有问题,找到自己 requirements.txt 文件路径,我这里是pip install -r D:\ultralytics-main\ultralytics-main\requirements.txt。首先去自己的anaconda的安装的envs(虚拟环境),在导航栏输入cmd,进入命令窗口。到官方网站下载yolo模型 ,下载好后解压,里面有个文件requirements.txt。然后安装ultralytics ,这是必须的。

m0_63172128的博客 2万+

【Python】正则

以下字符都需要用反斜线(\)来进行特殊字符的转义。\n - 换行符\t - 制表符\ - 反斜线本身. - 点号(任意单个字符)星号(0次或多次重复前面的元素)加号(1次或多次重复前面的元素)?- 问号(零次或一次重复前面的元素)[] - 方括号内的任何字符集合() - 分组操作符{} - 花括号内指定数量的重复次数起因,python正则匹配,从'你好aaa+'匹配‘aaa+’,我就想完整的匹配aaa+,但是实际效果是'你好a'这种的也能匹配上。

littlemichelle 955

告别单一帧:在CFD-POST中完整加载Fluent瞬态计算结果的实战指南

本文详细介绍了在CFD-POST中完整加载Fluent瞬态计算结果的实战指南,解决工程师常见的只能看到最后一帧数据的问题。通过Fluent端的正确设置和CFD-POST端的完整加载技巧,帮助用户高效处理瞬态数据,提升后处理效率。文章还提供了常见问题排查、性能优化和高级后处理技巧,适用于Workbench环境下的流体流动分析。

weixin_29284657的博客 541

基于YOLOv5的隧道衬砌缺陷智能检测系统

计算机视觉在工程检测领域正发挥越来越重要的作用,特别是目标检测技术通过深度学习算法实现了对复杂场景的智能分析。YOLOv5作为当前主流的目标检测框架,通过改进网络结构和训练策略,可以显著提升检测精度和效率。在隧道工程领域,结合通道注意力机制和多尺度特征融合技术,能够有效解决衬砌缺陷识别中的小目标检测难题。这种AI检测系统相比传统人工判读地质雷达图像,不仅将效率提升20倍,还能将识别准确率提高到92.3%,特别适用于3cm以上结构缺陷的自动化检测。系统通过深度可分离卷积等优化,实现了模型轻量化,便于在边缘计算

weixin_29064103的博客 328

【python学习笔记】re模块(正则表达式)

目录 前言: re模块的主要方法 特殊符号与字符 re.compile方法 re.findall方法 re.sub方法 前言: 正则表达式(regex)是一个特殊的字符序列,它能帮助你方便的检查一个字符串是否与某种模式匹配。 re模块的主要方法 Python自带的re模块主要包含如下6种方法: re.compile: 编译一个正则表达式模式(pattern); re.match: 从头开始匹配, 使用group()方法可以获取第一个匹配值; re.search: 用包含方.

是安澜啊 1889

QT使用libssh2库通过密匙实现sftp协议上传文件

qt下使用libssh2通过密匙连接sftp服务器端

小米的修行之路 950

正则表达式(一):位置匹配及重复匹配

无论是编程语言,比如Python,还是SQL,比如Hive和MySQL都提供了正则表达式用于数据及文本字符串的过滤和匹配。正则表达式不是一种完备的程序设计语言。但在绝大多数的软件产品、编程语言、实用工具和开发环境中,正则表达式都已经被实现。正则表达式的使用方法和具体功能在不同的应用程序和语言中各不相同。具体在使用时,还需要具体去查手册。 1.原理 正则表达式的底层原理是两类自动机:确定型有穷自...

读万卷书 行万里路 4175

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

python 学习之 re库的基本使用(正则匹配)下

前面曾经提到^表示字符串的开头,但它还有另外一个含义,当在一组方括号里使用 ^ 时,它表示"非"或"排除"的意思,常常用来剔除某个字符。re.U 表示特殊字符集 \w, \W, \b, \B, \d, \D, \s, \S 依赖于 Unicode 字符属性数据库。%s 是一种字符串格式化的方式,用于将字符串中的占位符替换为相应的值,替代的变量是通过 % 操作符的右侧提供的。re.L 表示特殊字符集 \w, \W, \b, \B, \s, \S 依赖于当前环境。

Welcome To My6n Blog 1440

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

Python 正则表达式使用详解

在Python中需要通过正则表达式对字符串进行匹配的时候,可以使用re模块re.match(正则表达式, 要匹配的字符串) 有返回值说明匹配成功;否则匹配失败。

lIujunXHU的博客 2424

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

第11.8节 Python正则表达式的重复匹配模式及元字符“?”、 “*”、 “+”功能介绍

符号“?”、“”、“+”这三个元字符修饰符在Python中都表示重复匹配的模式,即要求匹配的字符串满足重复次数的要求,但具体重复次数要求不同,其中: “?”:表示重复0-1次,即匹配字符串可以不出现或最多出现一次,如ab? 会匹配 ‘a’ 或者 ‘ab’; “”:表示重复0-n次,即匹配字符串可以不出现或出现多次,最多次数不受限,ab* 会匹配 ‘a’, ‘ab’, 或者 'a’后面跟随任意个’b...

老猿Python 3159

常见的正则表达式是如何写的

一、校验数字的表达式 数字:^[0-9]*$ n位的数字:^\d{n}$ 至少n位的数字:^\d{n,}$ m-n位的数字:^\d{m,n}$ 零和非零开头的数字:^(0|[1-9][0-9]*)$ 非零开头的最多带两位小数的数字:^([1-9][0-9]*)+(\.[0-9]{1,2})?$ 带1-2位小数的正数或负数:^(\-)?\d+(\.\d{1,2})$ 正数、负数、和小数:^(\-|\+)?\d+(\.\d+)?$ 有两位小数的正实数:^[0-9]+(\.[0-9]{2})?$

TELOBE的博客 770

正则表达式从0开始学习

本文章从0基础学习正则表达式的角度进行整理,如有错误,欢迎大家指正。

2301_77972274的博客 985

【Javascript】 从零学习正则表达式

正则表达式是一种描述文本模式的对象。JavaScript的RegExp类表示正则表达式,String和RegExp都定义了使用正则表达式对文本执行强大模式匹配和搜索替换功能的方法。但是,为了高效地使用RegExp API,必须学习如何通过正则表达式语法来描述文本模式。正则表达式语法是正则表达式自己的“迷你”编程语言。好在JavaScript的正则表达式语法与很多其他语言的非常相似,因此很多读者可能已经有所了解了(如果并没有,那通过学习JavaScript正则表达式掌握的知识,同样也适用于其他语言编程)

xptxhx的博客 273

正则表达式学习笔记(一)-----全部对照表+re中的函数用法

学习笔记一、对照查表re中的函数常用的处理选项表常用元字符表常用限定字符表常用的反义代码表常用分组语法表懒惰限定符表二、re中的函数实例search(pattern,string,[flags])match(pattern,string,[flags])findall(pattern,string,[flags])split(pattern,string,[maxsplit=0])sub(pat,...

xiao_xiao_lan的博客 950

Python中re模块常用函数

re.match    re.match 尝试从字符串的开始匹配一个模式,如:下面的例子匹配第一个单词。  import re      text = "JGood is a handsome boy, he is cool, clever, and so on..."   m = re.match(r"(\w+)\s", text)   if m:       print

真理部 9035

python正则表达式

基本概念 正则表达式(Regular Expression),常简写为regex或者 RE,又称为规则表达式。它不是某个编程语言所特有的,而是计算机科学的一个概念,通常被用来检索和替换符合某些规则的文本 在python中需要导入re模块使用 # 导入re模块 import re # 使用match方法进行匹配操作 result = re.match(正则表达式,要匹配的字符串) # 如果上一步匹配到数据的话,可以使用group方法来提取数据 result.group() re.match(..

Abner0101的博客 419

python re 匹配 字符 出现的次数

# python3 import re str_1 = "abca" matches = re.finditer(r'a',str_1) # 打印 a 字符出现的次数 print (matches)

v791106444的博客 8072

Python中的正则

正则表达式的基本语法和在python中的使用

qq_48943782的博客 2811

python字符串减去子串_6种操作方法,你曾遇到的字符串难题,解法都在这里!...

Python能够称为流行的数据处理语言,部分原因是其简单易用的字符串和文本处理功能。Pandas对此进行了加强,它使你能够对数组数据应用字符串表达式和正则表达式,而且能处理烦人的缺失数据。拆分字符串:split()In [5]: val='a,b,guido'In [6]: val.split(',')Out[6]: ['a', 'b', 'guido']修剪空白符:strip()split常常结...

weixin_33960567的博客 1806
上一篇: 786.快速选择排序
下一篇: python基础语句
Neo_21
博客等级 码龄6年 4粉丝 83原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值