


GPU 加速可以加速计算密集型机器人工作负载,但仅凭快速的 CUDA 内核并不能保证快速的 ROS 2 图形。当消息在节点之间移动时,它们可能会继续通过 CPU 内存序列化或复制,从而削弱在 GPU 上保留感知和 AI 工作负载的优势 (图 1) 。
借助 NVIDIA 最近为 ROS Lyrical 贡献的上游 rosidl::Buffer 抽象和 CUDA 缓冲区后端,ROS 2 节点可以在运行时条件允许时通过零拷贝传输交换 GPU 驻留负载,同时保留标准 ROS 2 消息和节点边界。NVIDIA Isaac ROS 5.0 中的所有节点都已更新,以使用 CUDA 缓冲区后端,并受益于 rosidl::Buffer 实现的更高效的数据移动。
现有的 ROS 2 节点可以采用 rosidl::Buffer,且更改最少。更具挑战性的任务是确定要更新的正确边界。这需要仔细审核分配、序列化、流所有权和回退行为。
本教程将带您了解如何将审核转变为智能体驱动的工作流。AI 编码智能体使用专门构建的 migrate-node-to-rosidl-buffer 技能来检查现有的 CUDA 加速节点、追踪数据移动、规划保持接口的最小重构,并验证 CUDA 传输路径是否已实际启用。您将学习如何使用智能体技能更新节点以采用 CUDA 缓冲区后端。然后,由此产生的加速工作负载可以部署在NVIDIA Jetson AGX Thor上。
隆重推出 rosidl::Buffer 和 CUDA 缓冲区后端
在 ROS 2 Lyrical 中,rosidl::Buffer<uint8_t> 在生成的 C++ 代码中表示可变长度的原始数组字段 (例如 uint8[]) 。默认的 CPU 支持的 rosidl::Buffer 的行为与现有 ROS 2 代码所期望的 std::vector<uint8_t> 接口一样,保持了源兼容性。可插拔抽象还允许平台供应商支持外部管理存储,而无需定义单独的 ROS 消息类型。
NVIDIA 为 ROS 2 Lyrical 贡献了 CUDA 缓冲区后端。它通过 CUDA 虚拟内存管理 (VMM) 实现 rosidl::Buffer<uint8_t> 存储。当发行商和订阅者满足后端运行时要求时,有效负载可以在托管节点之间移动,而无需序列化或主机副本。否则,ROS 2 会自动回退到与任何现有 ROS 2 节点兼容的 CPU 路径。优化路径需要相同的主机、CUDA 设备、Linux 用户和受支持的 RMW 实现 (例如 rmw_fastrtps_cpp 和 rmw_zenoh_cpp) 。
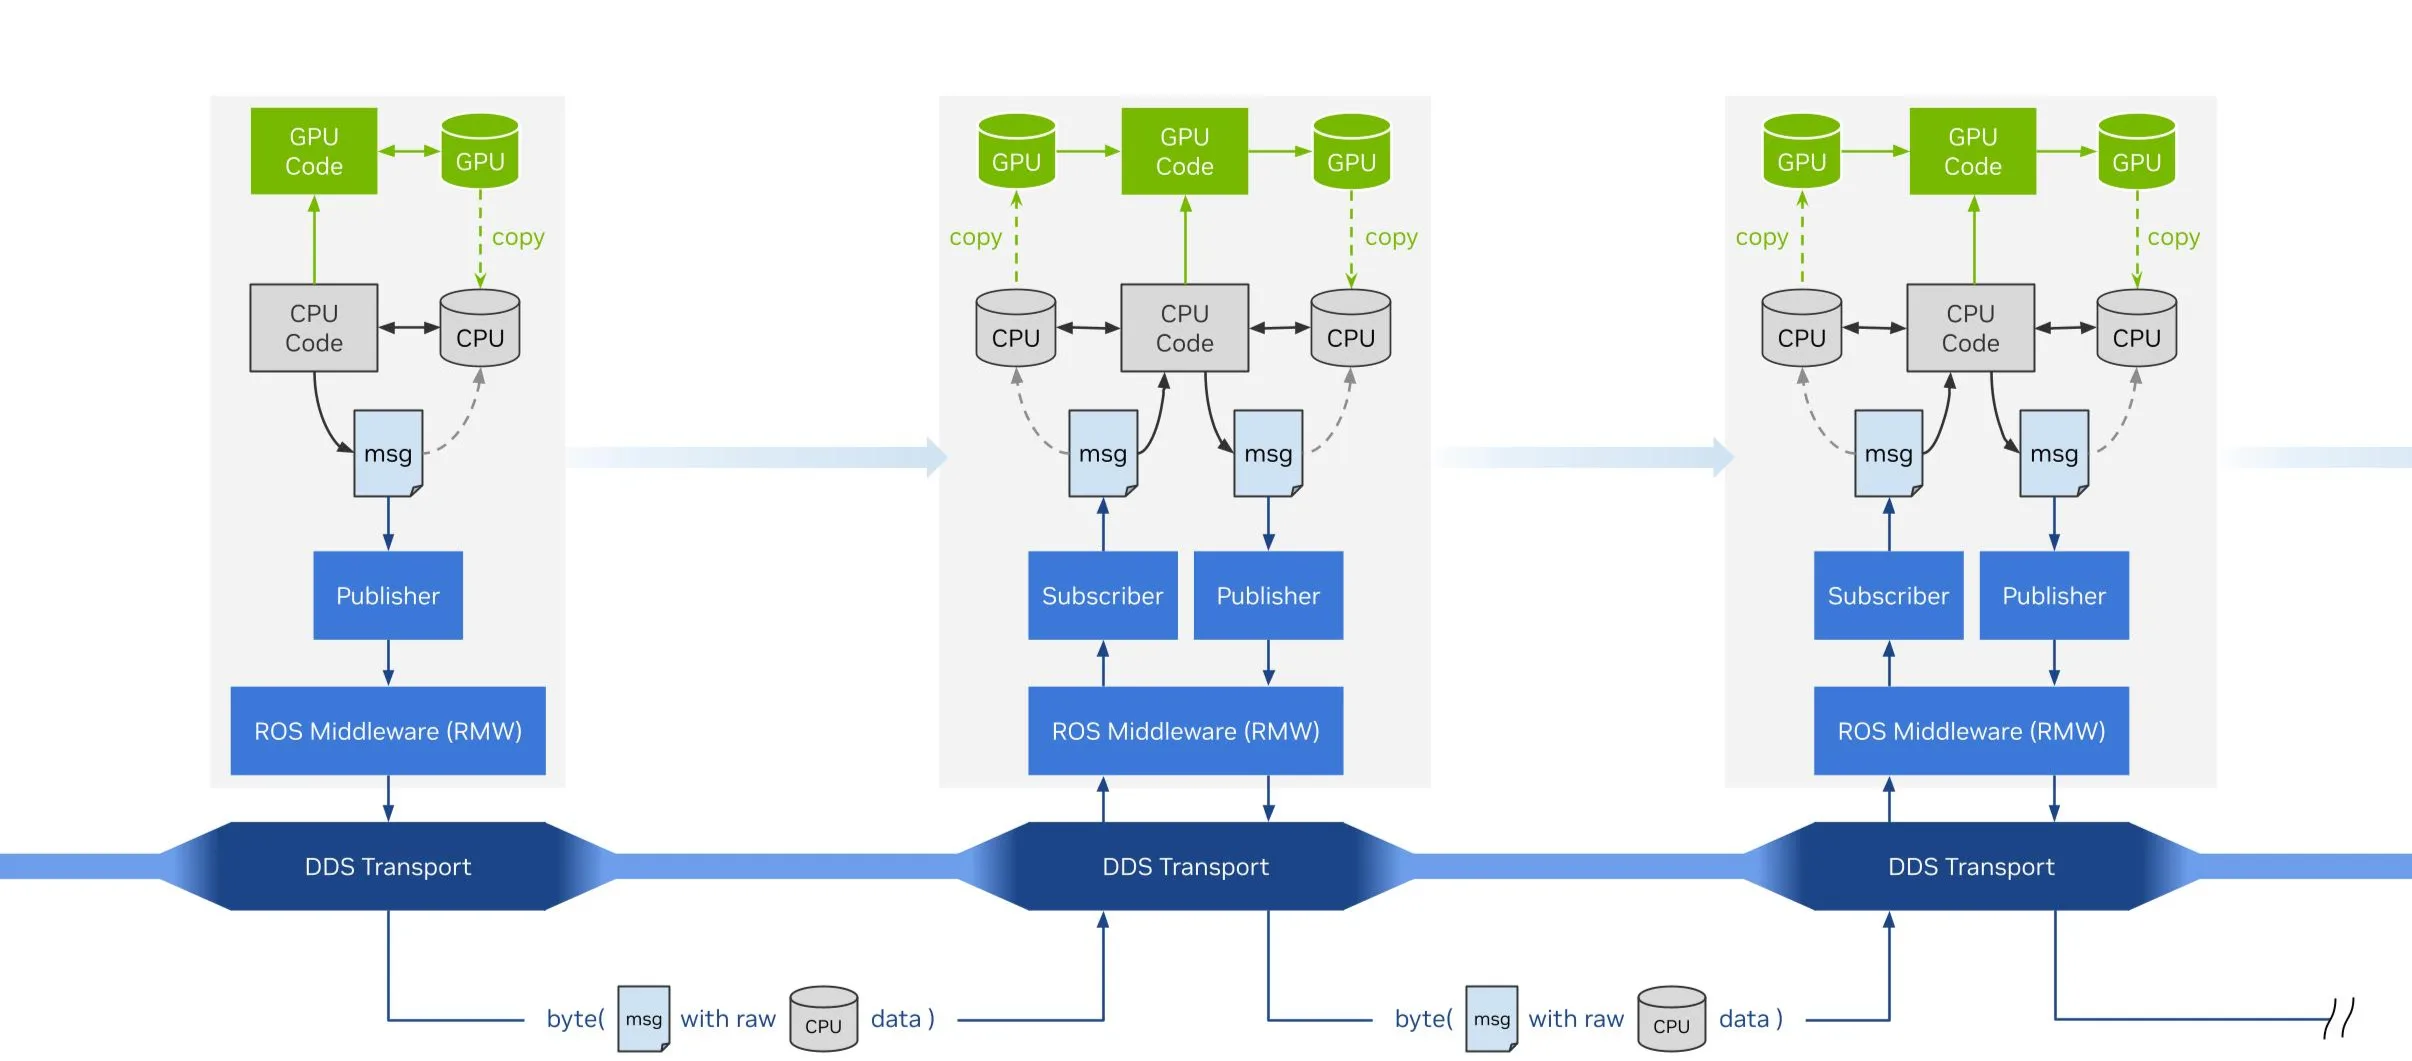
图 1. 由非 CUDA 缓冲区后端加速的 ROS 2 图形中的典型消息路径
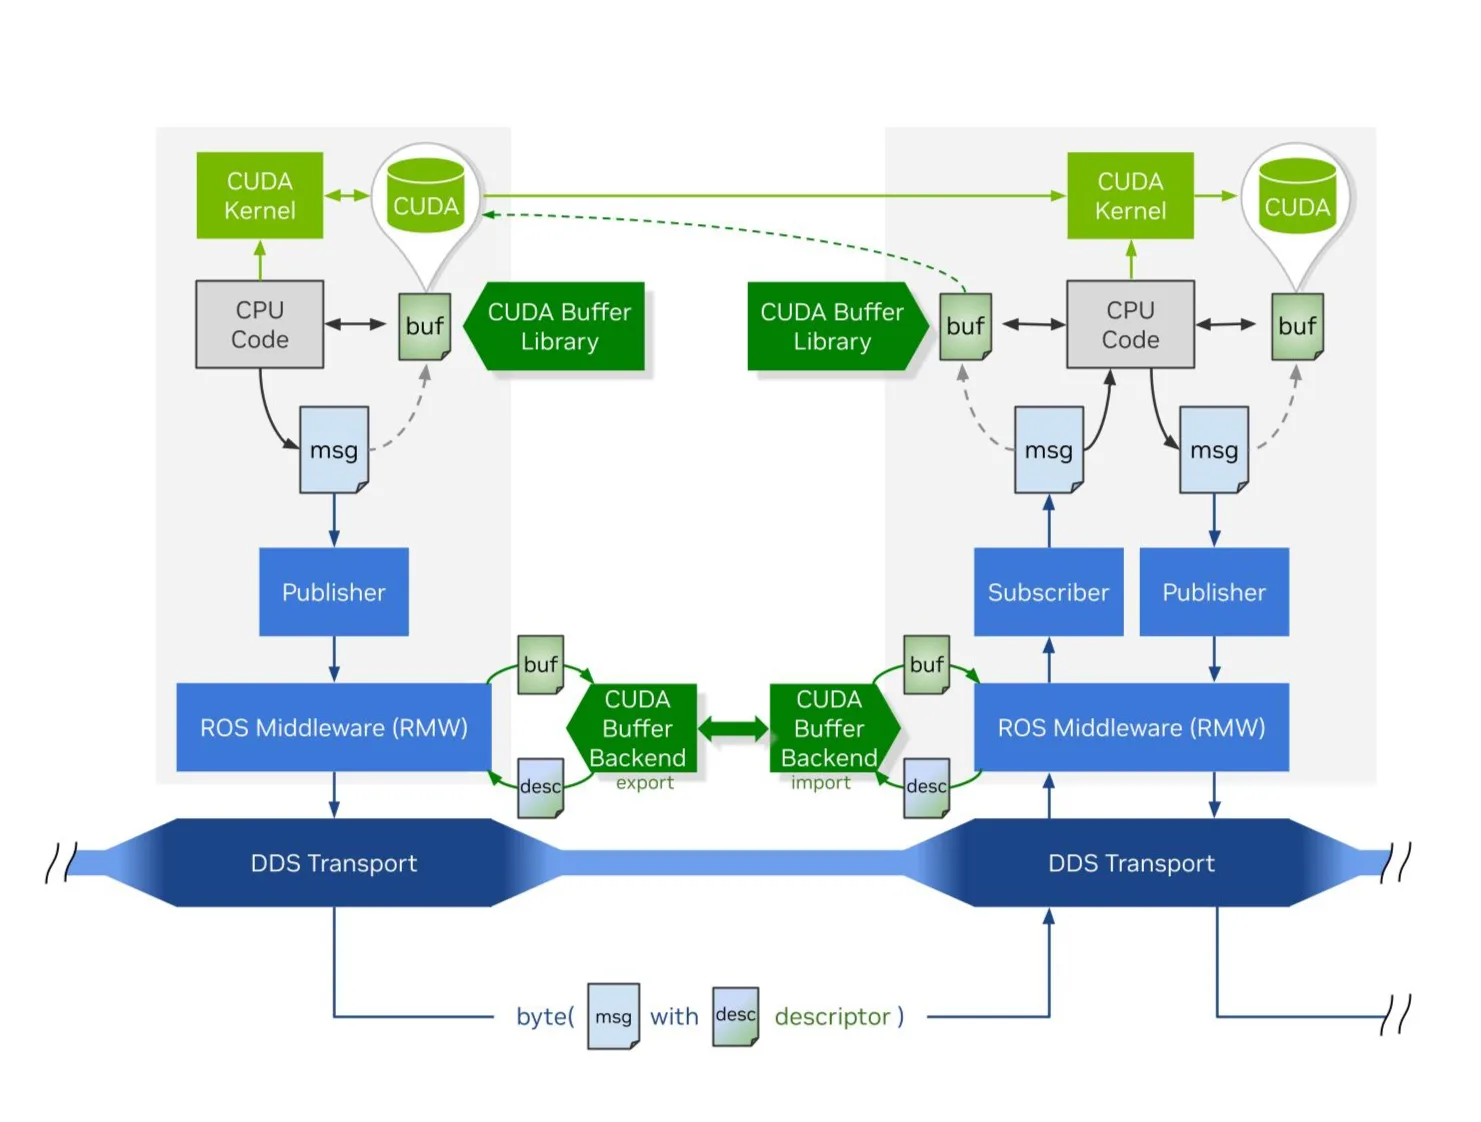
图 2. 新的 CUDA 缓冲区后端可为 ROS 开发者简化整个流程中的 CUDA 加速
rosidl::Buffer 和 CUDA 缓冲区后端结合使用,可在标准 ROS 2 字段后面移动内存共享和数据生命周期管理。这意味着上游功能在 GPU 加速的机器人应用中更容易采用,因此您可以专注于节点逻辑,同时保留 CPU 回退,以避免不兼容的节点。
从 ROS 2 节点开始
本教程以深度 Anything 3 (DA3) TensorRT ROS 2 节点为例。DA3 模型通过任意数量的视觉输入预测空间一致的几何图形,无论是否采用已知的摄像头姿态。
我们的目标是更新此节点,以采用引入的 CUDA 缓冲区后端,从而利用 rosidl::Buffer 功能带来的性能提升。该节点作为迁移示例特别有用,因为其算法已经过 GPU 加速。
此节点的回调函数可将传入的 ROS 图像转换为 OpenCV 视图,使用 NVIDIA TensorRT 运行单目指标深度推理,将生成的 cv::Mat 转换回 ROS 图像,并将其发布为浮点深度图像。
视频 1. DA3 可将传入图像转换为浮点深度图像。视频来源:ByteDance Seed
代码很简单,但 CPU 支持的 ROS 边界围绕着 GPU 原生算法。这种 CPU 边界适合 CPU 生产商或消费者,但当两侧的节点已经可以生成和使用 CUDA 显存时,就没有必要这样做。在这种情况下,两种有效载荷大小的主机传输、主机分配和序列化工作成为接口的优化机会。
因此,目标不是重新设计模型或替换其标准消息;而是保留现有的 ROS 合约,同时允许输出 Image.data 字段携带适当后端的存储。
使用智能体技能规划迁移
AI 编码智能体非常适合开展调查工作:通过回调和辅助库跟踪有效载荷、查找主机设备边界、保留节点合约,以及协调源、依赖项、启动和测试更改。
migrate-node-to-rosidl-buffer 技能可将此分析转化为可重复的工作流程。与其自动将节点替换为模板或重写代码,不如将智能体引导至:
- 记录起始修订版本、目标 ROS 环境和现有的本地更改
- 确认生成的消息字段类型的兼容性,并添加 CUDA 缓冲区后端软件包作为依赖项
- 追踪从接收到发布的每个消息字段,包括传递 CUDA 调用、进度、流、可选输出和所有权
- 运行只读复制边界审核,并在上下文中检查每个结果
- 制定每个字段迁移计划,识别已删除的副本、所需的晋升或具体化,以及应保持不变的路径
- 实现最小的接口保留补丁
- 独立验证语义、后端协商、分离进程传输、缓冲区生命周期和实际内存复制行为
使用 rosidl::Buffer 重构节点
通过使用 rosidl::Buffer 迁移技能,智能体更新节点的依赖项和接口,以采用 CUDA 缓冲区后端。大多数更改都会调整 TensorRT 包装器,使其接受输入和输出数据的 CUDA 缓冲区句柄,同时保留其现有 API。ROS 传输更改仍然很小:一个订阅选项、一个 CUDA 分配、两个流感知句柄提取和一个发布。无需自定义消息、重复 CUDA 主题或 CPU/ CUDA 发布者分支。
以下各节将解释节点迁移技能可为您带来的关键变化。
添加 CUDA 缓冲区后端依赖项
首先,该技能有助于添加 CUDA 缓冲区后端软件包 ( cuda_buffer 和 cuda_buffer_backend) 作为额外的依赖项。消息定义保持不变,节点将继续使用 sensor_msgs/msg/Image。
更新镜像订阅以接受 CUDA 消息
然后,订阅者会更新为接受具有 CUDA 支持缓冲区的消息。默认情况下,CPU 仍是可接受的后备函数,因此节点级回调不需要单独的 CPU 和 CUDA 实现。
rclcpp::SubscriptionOptions options;
options.acceptable_buffer_backends = "cuda";

sub_image_.subscribe(
  this, image_base_topic, image_transport,
  rclcpp::SensorDataQoS().get_rmw_qos_profile(), options);
现有的 image_transport 和 message_filters 拓扑结构仍保留到位。订阅选项直接通过它转发。
直接写入由 CUDA 支持的消息存储
订阅者回调仍接受 bgr8,保留标头、维度、编码和字节步长,并且仅在不同的输入编码需要时使用 cv_bridge 进行转换。更新后,TensorRT 推理现在可直接将结果写入输出消息中分配的 CUDA 缓冲区,并可在 GPU 工作完成后立即发布。
以下摘录包含利用 CUDA 缓冲区 API 的基本更改:
auto depth_msg = std::make_unique<sensor_msgs::msg::Image>();
depth_msg->header = bgr_image_msg->header;
depth_msg->height = bgr_image_msg->height;
depth_msg->width = bgr_image_msg->width;
depth_msg->encoding = sensor_msgs::image_encodings::TYPE_32FC1;
depth_msg->is_bigendian = false;
depth_msg->step = depth_msg->width * sizeof(float);

depth_msg->data = cuda_buffer_backend::allocate_buffer(
  static_cast<size_t>(depth_msg->step) * depth_msg->height);

const cudaStream_t stream = tensorrt_depth_anything_->getCudaStream();
{
  auto input = cuda_buffer_backend::from_input_buffer(
    bgr_image_msg->data, stream);
  auto output = cuda_buffer_backend::from_output_buffer(
    depth_msg->data, stream);

  tensorrt_depth_anything_->doInferenceCuda(
    input.get_ptr(), bgr_image_msg->width, bgr_image_msg->height,
    bgr_image_msg->step, *camera_info_msg,
    reinterpret_cast<float *>(output.get_ptr()),
    node_param_.point_cloud_downsample_factor,
    node_param_.colorize_point_cloud,
    node_param_.publish_point_cloud,
    node_param_.enable_debug);
}  // Release the CUDA event-tracked handles before publishing.

pub_depth_image_->publish(std::move(depth_msg));
每行都有一个狭的目的:
allocate_buffer()提供标准Image.data字段 CUDA 缓冲区支持的存储。from_input_buffer()提供 CUDA 缓冲区句柄,可在 TensorRT 流上安全使用,以进行只读操作。直接使用 CUDA 输入。必要时,CPU 输入会升级为 CUDA。from_output_buffer()提供可安全执行写入操作的 CUDA 缓冲区句柄。现有的 CUDA 后处理通过写入句柄将其最终32FC1结果直接写入分配给传出消息的缓冲区,从而避免设备到主机的复制和中间设备到设备的输出。- 在相关流上对工作进行排队后,内部作用域会释放写入句柄,以便在消息发布之前记录写入 CUDA 事件,从而确保 CUDA 操作的顺序。
- 该节点调用
publish(),就像它通常调用相同的消息类型一样,而底层数据字段现在由 CUDA 缓冲区后端提供支持。ROS 2 中间件和后端自动处理 CUDA 显存共享及其与其下游用户的兼容性。
将可选的主机工作分开
该技能可保持非 CUDA 路由不变。点云构建和调试可视化是原始节点中的本地 CPU 使用者。启用后,它们可能仍然需要设备到主机的复制和同步。它们不会确定在深度主题上提供的表征,因此迁移会将它们保留为显式可选边界,而不会使优化的出版路径变得复杂。
构建并运行 GPU 加速的 ROS 2 工作流
rosidl::Buffer 功能是在 ROS 2 Lyric 中引入的,因此迁移的节点预计将与 Lyric 及更高版本的节点配合使用,并支持 RMW 实现 ( rmw_fastrtps_cpp 和 rmw_zenoh_cpp) 。
在迁移期间,核心函数和边界消息类型保持不变,并将 cuda_buffer 和 cuda_buffer_backend 添加为软件包的额外依赖项,以启用 CUDA 缓冲区后端。因此,整个构建过程和设置仍与原始节点相似。
要启用 CUDA 缓冲区后端,请从源代码构建软件包。首先,克隆rosidl_buffer_backends存储库中的源,其中托管了当前所有受支持的后端和配套包:
git clone https://github.com/ros2/rosidl_buffer_backends.git
请注意,rosidl::Buffer 的核心功能已在 ROS 2 Lyrical 中构建,因此无需重建 ROS 2 核心包。
rosidl::Buffer 后端设计为 ROS 2 插件。在同一工作空间中构建和采购 CUDA 缓冲区后端软件包足以让后端在运行时可供节点使用。
colcon build --symlink-install --packages-up-to cuda_buffer_backend
source install/setup.bash

colcon build --symlink-install --packages-up-to depth_anything_v3
source install/setup.bash
export RMW_IMPLEMENTATION=rmw_fastrtps_cpp
然后,您可以按照原始存储库中的指示,遵循相同的模型准备流程,并使用更新的 TensorRT 节点运行相同的启动文件。
验证 CUDA 缓冲区后端
迁移会使 TensorRT 计算保持不变,并以其周围的传输为目标。要检查 GPU 活动和内存传输,请使用 NVIDIA Nsight Systems。在符合条件的 CUDA 路径上,迁移的节点不应显示 ROS 边界处有效载荷大小的主机到设备或设备到主机传输。记录更改前后的可比延迟测量值。
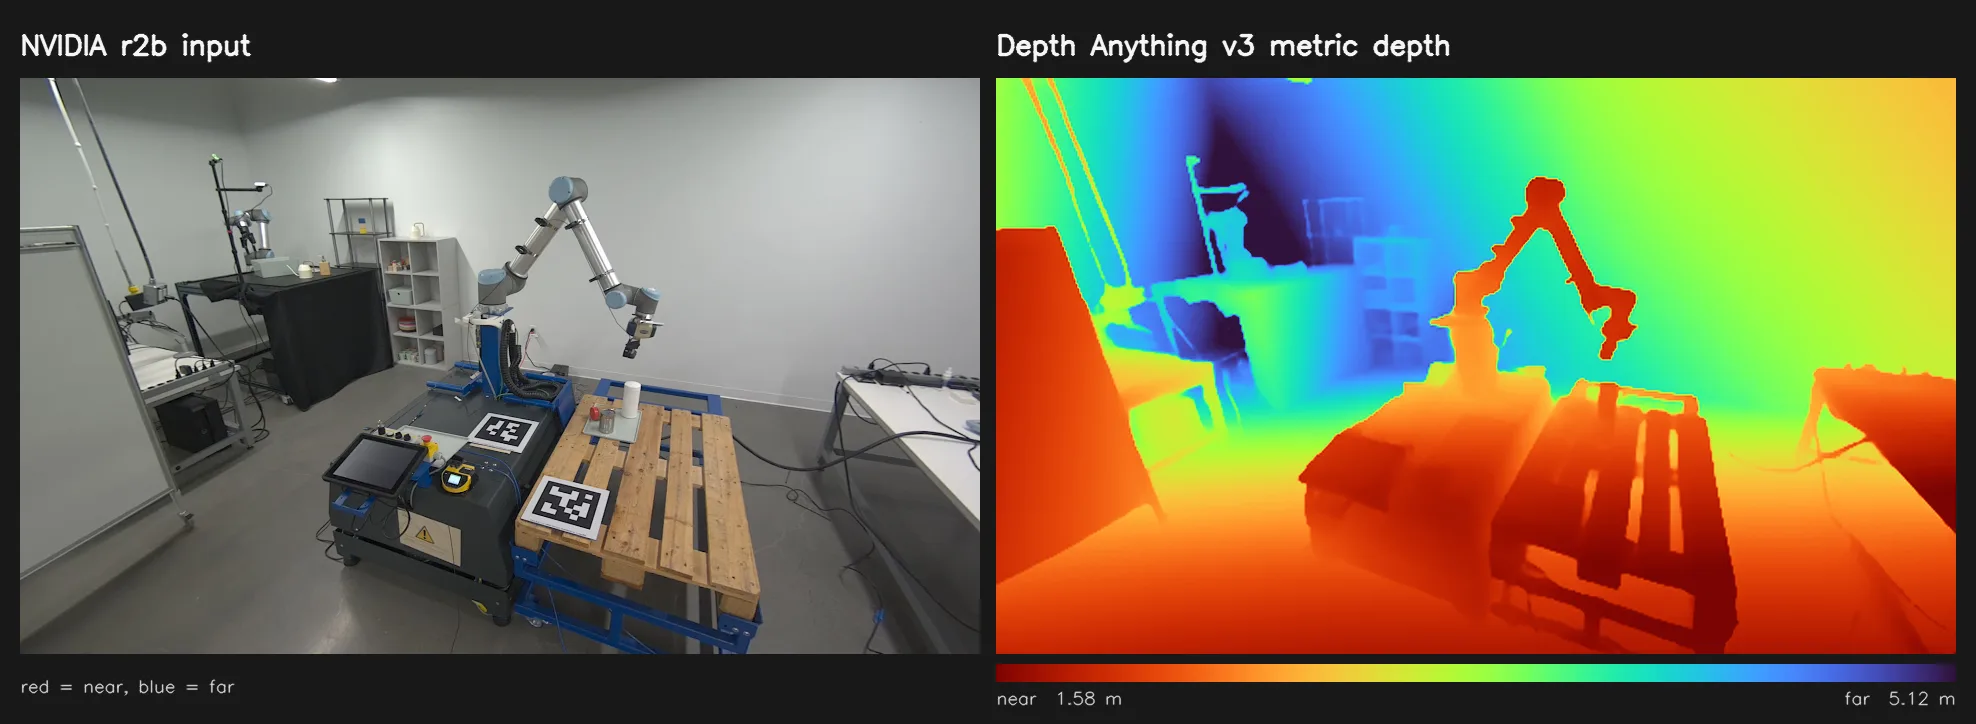
图 3. 迁移的 DA3 节点在使用 CUDA 支持的 ROS 2 消息存储时保留 RGB 到深度的结果
您还可以验证订阅者的后端协商。当两个端点都满足 CUDA 后端要求时,msg->data.get_backend_type() 应报告 "cuda"。这对于确认 CUDA 传输路径处于活动状态的测试非常有用。
rclcpp::SubscriptionOptions options;
options.acceptable_buffer_backends = "cuda";

subscription_ = create_subscription<sensor_msgs::msg::Image>(
  "/depth_anything_v3/output/depth_image", rclcpp::QoS(1),
  [this](sensor_msgs::msg::Image::ConstSharedPtr msg) {
    const std::string backend = msg->data.get_backend_type();
    RCLCPP_INFO(get_logger(), "received backend=%s", backend.c_str());

    if (backend != "cuda") {
      throw std::runtime_error("CUDA transport was not negotiated");
    }
    auto input = cuda_buffer_backend::from_input_buffer(msg->data, stream_);
    consume_on_cuda(input.get_ptr(), stream_);
  },
  options);
请注意,产品级代码通常会尝试接受 CPU 回退,而不会引发错误。
借助提供的 CUDA buffer API,from_input_buffer() 可自动在内部处理 CPU 回退。用户无需在传入消息的回调中区分 CPU 路径和 GPU 路径。如有需要,所有 CUDA 显存共享和 CPU 到 GPU 转换均由 CUDA 缓冲区后端处理。
该技能还包含一个验证步骤,可帮助生成用于测试和验证的自定义源节点和接收节点。这是通过根据生成的源节点和接收节点创建两个工作流来完成的,以测试在 CPU 和 GPU 设置下同时运行的相同迁移节点,而无需更改代码。
在 CPU 控制设置中,使用源节点发布消息,其中包含基于 CPU 的数据。消息到达 TensorRT 节点,其缓冲区由普通 CPU 存储提供支持。订阅者回调中使用的 CUDA 缓冲区 API 会自动检测缓冲区后端类型,并在需要时进行转换 (本例中为 CPU 到 CUDA) ,因此预期的相同代码函数将接受基于 CPU 的消息。
在另一种设置中,使用的源节点会发布基于 CUDA 缓冲区的消息。借助迁移的 TensorRT 节点,CUDA 缓冲区感知订阅者可以使用 CUDA 缓冲区 API 接收消息并获取 CUDA 句柄,而无需额外的 CPU-GPU 副本。
在 NVIDIA Jetson AGX Thor 上部署智能体驱动的 ROS 2 工作流
相同的工作流可应用于其他 CUDA 加速的 ROS 2 节点,这些节点具有可变长度的原始消息字段。关键在于将优化视为一项端到端系统任务。AI 智能体可追踪数据移动,识别哪些字段受益于 GPU 支持的存储,保留标准 ROS 2 接口,并验证优化路径和 CPU 回退。这使得迁移是可重复的,而不是一次性的重构。
NVIDIA Isaac ROS 5.0 将此工作流引入加速机器人软件堆栈,而 NVIDIA Jetson AGX Thor 则提供边缘计算平台,用于在机器人上运行要求严苛的 ROS 2 感知、推理和自主工作负载。
开始使用 ROS 2 节点加速
加速 ROS 2 节点需要优化 GPU 计算和数据移动。借助 rosidl::Buffer、NVIDIA CUDA 缓冲区后端和 Isaac ROS 5.0 AI 引导迁移技能,现有启用 CUDA 的节点可以在更改最少代码的情况下交换 GPU 驻留数据。这可避免不必要的序列化和 CPU 复制,同时保留标准 ROS 2 消息接口。
要开始使用,请按照以下步骤操作:
- 下载 NVIDIA Isaac ROS 5.0
- 查看 ROS 2 Lyrical rosidl::Buffer 和 CUDA buffer 后端文档
- 安装本文中使用的 migrate-node-to-rosidl-buffer 智能体技能
- 在现有的 CUDA 加速 ROS 2 节点上运行智能体引导的工作流
- 在 NVIDIA Jetson AGX Thor 上部署和分析生成的图形
原文来源:NVIDIA 技术博客原文

 355


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


