借助 NVIDIA Dynamo-Triton 中的 NVIDIA TensorRT 多设备集成,简化跨多个 GPU 的模型服务

生成式 AI 对计算和内存的需求日益超出单个 GPU 的能力。NVIDIA TensorRT 多设备推理是一项新功能,使单个 TensorRT 网络能够使用由NCCL支持的分布式集合在多个 GPU 上执行,同时保留 TensorRT 推理优化。从 TensorRT 11.0 开始,完全受支持。

NVIDIA Dynamo-Triton (以前称为 NVIDIA Triton 推理服务器) 版本 26.07 支持 TensorRT 后端的多设备推理功能。一个 Triton KIND_MODEL 实例可以拥有多个 GPU,创建每秩 TensorRT 执行上下文、CUDA 流和 NCCL 通信器,并为每个请求一起启动 rank。应用通过 gRPC 端点调用一个已命名的模型,而非自行协调 GPU 秩。

对于部署生成式 AI 的组织而言,这缩小了多 GPU 加速与可消耗推理服务之间的差距。团队可以使用额外的 GPU 资源来缩短请求延迟,保持应用程序界面和周围工作流程的稳定性,将引擎打包为版本化的 Triton 模型,并在客户端之外保留 rank 和 communicator 生命周期代码。对于延迟敏感型生成式媒体工作流而言,缩短生成结果的时间可以减少用户的等待时间,并加速审查和优化周期。

本文将介绍如何使用 NVIDIA Cosmos 3 Nano 视频生成技术进行集成,上一篇文章介绍了如何使用 NVIDIA TensorRT 和多设备推理支持 在多个 GPU 上扩展 AI 推理。扩散器继续编排提示、隐性、无分类器引导 (CFG) 、调度、VAE 解码和帧后处理。Dynamo-Triton 提供 36 层降噪转换器,TensorRT 多设备推理使用 Ulysses 上下文并行,在多达 8 个 NVIDIA GPU 上分配其 44160 个视频 token。

Dynamo-Triton 如何为 TensorRT 多设备模型提供服务?

在部署之前,将分布式 Ulysses 图形编译到每个 TensorRT 计划中。Dynamo-Triton TensorRT 后端加载版本化计划,创建多秩执行状态,并公开一个 gRPC 模型端点。客户端向该端点发送 Transformer 请求;它不协调参与的 GPU 秩。

Cosmos 3 Nano 模型提供了这一边界的实际示例。Transformer 占单 GPU 生成时间的 93.4%,是影响最大的加速阶段。在 35 个降噪步骤中,每个步骤都需要一个负或无条件预测以及一个基于提示条件的 CFG 预测。因此,Diffusers 代理每步进行两次连续的 Triton 调用,每代 70 个 Transformer RPC。每个请求都会携带准备好的张量,并将 noise_patches 返回至应用程序工作流程。

Workflow showing three stages: diffusers video pipeline, Triton Inference Server, and TensorRT Multi-Device.

图 1. Dynamo-Triton (以前称为 Triton 推理服务器) 现在只需一次模型端点调用,即可在后台运行 TensorRT 多设备推理

Dynamo-Triton 如何激活上下文并行的分布式 TensorRT 计划?

分布式图形被编译成每个上下文并行的 TensorRT 计划。Dynamo-Triton 配置会激活该计划;它不会将单个设备引擎转换为分布式引擎。单设备基准使用 GPU 0 上的标准 GPU 模型实例。2、4 和 8 GPU 变体使用 KIND_MODEL,启用 TensorRT 后端多设备路径,并识别参与的 rank。

# Excerpt from the generated CP8 config.pbtxt
name: "cosmos3_cp8"
backend: "tensorrt"
max_batch_size: 0

instance_group [
  { kind: KIND_MODEL count: 1 }
]
parameters [
  { key: "enable_multi_device" value: { string_value: "true" } },
  { key: "multi_device_gpus" value: { string_value: "0,1,2,3,4,5,6,7" } }
]

使用 Ulysses 上下文并行性分发 Cosmos 3

此示例中固定的 Cosmos 3 Nano 配置文件会生成 44160 个视频token。在上下文并行大小为 8 (CP8) 时,每个秩会处理 5520 个注意力外视频token。较短的 2992-token 文本路径仍会被复制。在 36 个 Transformer 层中的每一层中,Ulysses 都会围绕注意力改变分割轴,以便每个秩处理不重叠的头部子集的完整视频序列。

 A graphic explaining Ulysses context parallelism in one transformer layer.

图 2. Ulysses 通过围绕标准注意力的 TensorRT 分布式集合层实现。它不使用单独的多设备注意力运算符

该引擎从 PyTorch 导出,并使用 Torch-TensorRT 进行编译。三个本地转换器将导出载波运算降低到 TensorRT 公共分布式集合层:reduce-scatter、all-to-all 和 all-gather。每个可接受的上下文并行计划都包含两个初始归约散射函数、36 个 Transformer 层中每个层中的三个 all-to-all 函数,以及一个最终的 all-gather 函数。得到的拓扑是两个 reduce-scatter,加上 108 个 all-to-all,加上一个 all-gather。

端到端生成延迟基准测试

这四种版本都在同一运行良好的 8 GPU NVIDIA 系统上运行。单设备基准测试使用 1 个 GPU;CP2、CP4 和 CP8 使用 2 个 rank、4 个 rank 和 8 个 rank。每次运行都使用 1280 × 720 输出,在 24 FPS 下使用 189 帧,降噪步长为 35。

每个结果都包括一次预热,然后是五次测量的完整代。计时涵盖提示作业、70 次 Dynamo-Triton 调用、CFG 和调度程序更新、VAE 解码和帧后处理。请注意,模型加载和 mp4 编码排除在外。

表 1 比较了 SD、CP2、CP4 和 CP8 Cosmos 3 的运行情况。端到端延迟从一个 GPU 上的 156.595 秒下降到 8 个 GPU 上的 34.183 秒,而 Transformer RPC 加速增加到 6.09 倍。

变体GPUE2E 均值端到端加速RPC 均值RPC 加速RPC 共享
SD1156.5951.00 倍146.1921.00 倍93.4%
CP2287.9991.78 倍77.5481.89 倍88.1%
CP4453.0932.95 倍42.6613.43 倍80.4%
CP8834.1834.58 倍23.9936.09 x70.2%

表 1. SD、CP2、CP4 和 CP8 Cosmos 3 运行对比

ALT-TEXT: The eight-GPU configuration reduces end-to-end latency by 78.17% and transformer RPC time by 83.59% versus one GPU.

图 3. 跨 GPU 配置的端到端和 Triton Transformer RPC 延迟

Line graph showing strong single-generation latency scaling, but not perfect linear scaling: communication and fixed application work become more visible as transformer time falls.

图 4. 加速与理想线性扩展

在一个 GPU 上,Transformer RPC 占生成时间的 93.4%。在 CP8 中,这一比例降至 70.2%。在测量的 RPC 路径之外的时间在不同配置下仍保持在 10.2 到 10.5 秒之间,因此提示工作、调度程序更新、VAE 解码、后处理和其他客户端用度在总用度中所占比例更大。

The eight-GPU configuration reduces end-to-end latency by 78.17% and client-observed transformer RPC time by 83.59% relative to the single-device baseline.

图 5. 跨 GPU 配置的端到端延迟解析

在声明性能之前验证生成的输出

每个变体都使用相同的种子和生成配置文件。验证采样帧 0、47、94、141 和 188,检查格式和时间变化,并将每个上下文并行输出与单设备结果进行比较。CP2、CP4 和 CP8 通过了平均绝对误差 (MAE) = 25 和峰值信噪比 (PSNR) = 18 dB 的配置值测试。

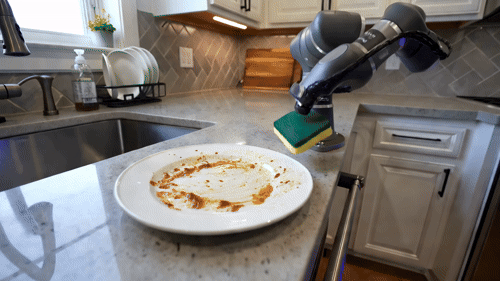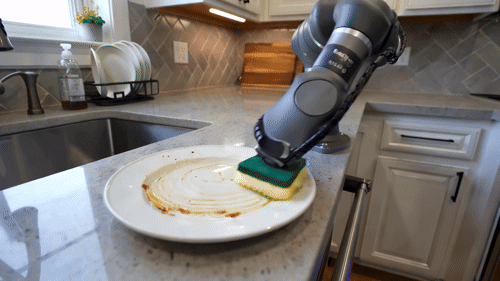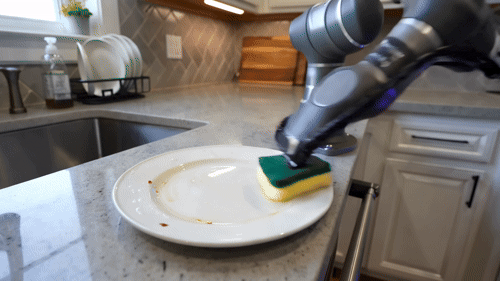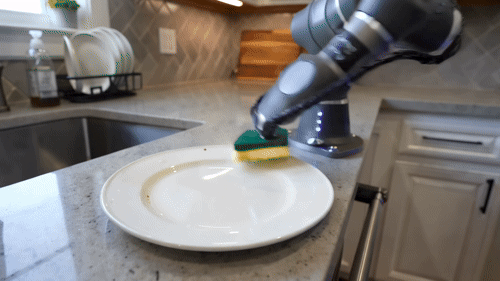
我们并未声明像素相同的输出。CP2 和 CP4 分别测量了 MAE 12.759 和 PSNR 21.111 dB。CP8 测量了 MAE 16.316 和 PSNR 19.400 dB。接触表还显示了整个夹子上相同的连贯动作:机械臂在清洁盘子。

Twenty-frame contact sheet validating output consistency across SD, CP2, CP4, and CP8 runs. Rows show each GPU configuration, and columns show frames 0, 47, 94, 141, and 188 of a robotic arm cleaning a plate.

图 6. 跨 SD、CP2、CP4 和 CP8 的相同种子视觉验证

Gif showing eight-GPU Cosmos 3 video output showing a robotic arm cleaning a plate with a sponge over a 7.875-second, 189-frame clip at 1280 by 720 resolution and 24 frames per second.

查看原始动态演示

图 7. 8 GPU Cosmos 3 输出

开始简化多 GPU 模型服务

对于产品团队而言,当响应时间比最小化分配给一个请求的 GPU 更具有商业价值时,这些结果证明了一个切实可行的选择。之前需要超过 2.5 分钟才能完成的完整一代 Cosmos 3 大约需要 34 秒完成,而应用程序继续使用传统的模型服务接口。

团队仍然必须根据资源 – 延迟权衡来决定最佳方法。此基准测试不会衡量并发请求吞吐量、每个生成视频的成本或总拥有成本 (TCO) 。团队应根据自己的 SLO 和部署经济性来评估这些指标。

要在您自己的环境中重现本文中介绍的结果,请从 NGC 下载 NVIDIA Dynamo-Triton 26.07。然后使用链接的 TensorRT、Torch-TensorRT、Diffusers 和 Cosmos 资源。

如需了解详情,请查看以下相关资源:

原文来源:NVIDIA 技术博客原文

相关推荐

使用 NVIDIA RTX Spark 在一台机器上进行编码、测试和部署

NVIDIA RTX Spark 将本地编码智能体、模型微调、编译、测试与部署整合到一台机器。本文介绍 GB10、128GB 统一内存与 Grace/Blackwell 架构的开发性能,Windows on Arm、PyTorch-CUDA 和 CUDA-X 软件生态,以及 Pi、Junie Local、Nemotron 模型、媒体 AI SDK 和现有 Windows 应用迁移路径,帮助开发者在本地构建并部署 AI 应用。

NVIDIA_Community的博客 355

深入了解 NVIDIA Sentry:运行时安全 AI 智能体

本文介绍 NVIDIA Sentry 如何在 BlueField-4 DPU 的独立信任域中为 AI 智能体提供运行时保护。通过 DOCA Tower 检查通信与执行访问策略,结合 DOCA Argus 实时内存内审、身份验证、专用模型行为检测和防篡改遥测,将 OpenShell 的软件安全边界扩展到硬件隔离防护,并与企业 XDR、SIEM 平台集成。

NVIDIA_Community的博客 413

NVIDIA OpenShell 参考架构如何大规模保护和治理 AI 智能体工作负载

本文介绍 NVIDIA OpenShell 参考架构如何在智能体之外实施确定性治理,并结合 NVIDIA Vera CPU、BlueField-4 DPU 和 NVIDIA Sentry,构建兼顾性能、隔离与运行时安全的可扩展智能体基础设施。涵盖网关、Supervisor、沙盒、策略验证器,以及 CoreWeave 的沙盒启动和智能体任务性能测试。

NVIDIA_Community的博客 227

China AI Infra Day 从物理到虚拟:网络基础设施驱动 AI 工厂 重磅来袭!

存储架构,解析如何减少重复计算、加速推理响应,提升规模化。3. 填写报名信息并提交,即可完成注册。网络创新与重要动态,聚焦五大网络架构与。或复制并打开以下链接,进入报名页;从物理到虚拟:网络基础设施驱动。本次在线研讨会将探索。技术专家带你打破技术壁垒,解锁。更有价值:网络与存储的协同之道。加入本次研讨会微信直播交流群。构建超大规模网络:适用于百万。工厂性能优化与部署验证。打破数据瓶颈:面向代理式。数字孪生,探索超大规模。:围绕网络与存储协同、高性能组网实现十亿瓦级。:聚焦五大网络架构、

NVIDIA_Community的博客 126

NVIDIA AI 培训班 | 10 月 29 日《为大语言模型添加新知识》开课,转化开源 LLM 为领域 AI 资产

课程以 Meridian Response 为基础,这是一个虚拟的人道主义物流组织,需要对传入的防洪响应现场报告进行分类并将其分配到正确的团队。您将首先构建一个评测,定义该任务“更好”意味着什么,然后度量一个库存 8B 开放权重模型,测试提示词的上限,生成针对性的合成训练数据,使用监督微调训练 LoRA 适配器,并在任务行为基本到位后,使用直接偏好优化 (DPO) 来提高响应质量。,访问 NVIDIA 认证中文官网,点击每一门认证科目介绍页面,查看详细的考试大纲、考前学习指南、推荐培训和更多资源。

NVIDIA_Community的博客 229

密集与 MoE 模型:活动参数、吞吐量以及选择每个模型的时间

本文比较密集模型与 MoE 模型的活动参数、吞吐和路由机制,说明在质量、延迟、显存与部署约束下如何选择模型架构。

NVIDIA_Community的博客 169

如何使用 AI 智能体准备用于仿真的 3D 场景

本文展示 AI 智能体如何把 Blender 场景准备成用于仿真的 OpenUSD 资产,包含语义、材质、传感器、物理属性、渲染预检和 SimReady 验证。

NVIDIA_Community的博客 366

借助 NVIDIA Earth-2,将您的最新观测结果转化为及时的天气决策

本文介绍如何用 NVIDIA Earth-2 和 Earth2Studio 将最新气象观测纳入预测,演示区域与全球数据同化工作流,以及 CorrDiff-SDA、StormCast-SDA 和 HealDA。

NVIDIA_Community的博客 265

TensorRT Edge-LLM 在 Jetson AGX Thor 上实现 MLPerf Edge Agentic Benchmark 6.4 倍加速

本文分析 TensorRT Edge-LLM 在 Jetson AGX Thor 上完成 MLPerf Edge Agentic 基准测试的优化方法,包括 NVFP4 量化、KV 缓存复用和多 token 预测。

NVIDIA_Community的博客 104

如何评估从工具调用到任务完成的 AI 智能体

本文介绍从工具调用到任务完成的 AI 智能体评估方法,涵盖任务成功率、执行时间、成本、可复现基准和端到端验证。

NVIDIA_Community的博客 87

使用 AI 智能体和 NVIDIA Isaac ROS 加速 ROS 2 节点

本文展示如何用 AI 智能体与 NVIDIA Isaac ROS 加速 ROS 2 节点,通过识别数据传输瓶颈、采用 CUDA 缓冲区后端并验证机器人工作流的性能。

NVIDIA_Community的博客 67

面向游戏开发者的新功能:DLSS 5 (支持 3D 引导神经渲染) 、NVIDIA ACE 更新和全新 RTX Kit 功能

本文汇总面向游戏开发者的 DLSS 5、NVIDIA ACE 与 RTX Kit 新功能,介绍 3D 引导神经渲染、开发者控制和角色交互等技术。

NVIDIA_Community的博客 285

NVIDIA NVLink 6 如何为 AI 工厂提供多层弹性

本文说明 NVIDIA NVLink 6 为 AI 工厂提供的多层弹性机制,包括链路、交换与系统级故障恢复,及其对训练和推理服务连续性的作用。

NVIDIA_Community的博客 67

借助 NVIDIA Topograph 实现拓扑感知型工作负载调度

本文介绍 NVIDIA Topograph 如何识别 GPU 集群拓扑,并在 Kubernetes、Slurm 等环境中为 AI 工作负载提供拓扑感知调度,减少跨域通信和资源浪费。

NVIDIA_Community的博客 92

借助 NVIDIA 机密计算实现私有高性能生产级 AI 推理

本文介绍 NVIDIA 机密计算如何在私有生产级 AI 推理中保护敏感数据,并比较机密计算开启与关闭时的吞吐和延迟,分析数据传输、内核调优及多 GPU 通信的性能开销。

NVIDIA_Community的博客 52

介绍 CUDA Rust:用于编写 GPU 内核的两条轨道

CUDA Rust 提供 cuda-oxide 与 cutile-rs 两条原生 GPU 内核开发路径。前者保留 SIMT 线程控制,后者使用 Tile 抽象和 CUDA Tile IR。本文比较编译链、内存安全与当前成熟度。

NVIDIA_Community的博客 151

CUDA 工具包 13.4 在 Arm 上添加了 Windows 支持,并增强了对共享 GPU 的控制

CUDA 13.4 扩展 Windows on Arm 支持,预览 Rubin 架构,并更新 MPS V3、跨 GPU 传输、CUDA Python、CCCL 与 Nsight 工具。本文梳理对应用迁移和共享 GPU 管理最关键的变化。

NVIDIA_Community的博客 134

何时使用“编码-预填充-解码”解耦技术来加速多模态模型服务

NVIDIA Dynamo 的 EPD 解耦将视觉编码与 LLM 预填充、解码分开调度。文章分析图像负载、输出长度、模型规模、精度和混合流量如何决定 TTFT 与吞吐收益。

NVIDIA_Community的博客 145

GR-Inference:面向生成式推荐的推理系统设计与性能评估

生成式推荐具有长上下文、极短解码和数百条动态 Beam。GR-Inference 通过请求级状态管理、分离 KV、专用 Attention 与 GPU SID Trie 优化这一负载,并在给定 SLA 下提升吞吐。

NVIDIA_Community的博客 327

使用预测解码共同设计 AI 模型,加快 LLM 推理速度

预测解码通过草稿 token 与目标模型并行验证减少自回归迭代。本文梳理草稿长度、接受长度、验证成本与草稿成本的关系,以及在不同延迟和吞吐目标下选择草稿机制的方法。

NVIDIA_Community的博客 293

现代 CUDA 工具箱的实际应用:分步优化演练

以 RGB 图像转灰度并计算 32×32 图块中值为例,串联 Compute Sanitizer、Nsight Systems、CUB、CCCL 内存容器和 CUDA 流,说明如何先定位错误与瓶颈,再逐步优化 GPU 程序。

NVIDIA_Community的博客 298

使用 NVIDIA Nemotron 构建自适应代理式网络安全系统

NVIDIA 与 CrowdStrike 在隔离环境中评估红蓝智能体闭环:攻击生成遥测,防御智能体编写并验证检测,再以新攻击复测。文章介绍 Nemotron 分工、检测验证机制、实验结果及其适用边界。

NVIDIA_Community的博客 83

前沿推理触手可及:如何在 NVIDIA Jetson 上部署和优化模型

紧凑型开放推理模型已能在 NVIDIA Jetson 本地运行。本文比较 Nemotron 3.5 Lightning 与 Qwen3.8-27B 的架构取舍,解释 NVFP4 与预测解码的作用,并给出部署和工作负载验证思路。

NVIDIA_Community的博客 282

构建面向大规模 VLA 的端云协同后训练闭环:使用 verl-vla 统一数据采集、微调与强化学习

大规模 VLA 的推理、仿真、数据采集和人工干预往往分散在云端 GPU、仿真节点与真实机器人上。verl-vla 通过 TrainCluster、Web 遥操作和可组合 Workflow,把示范采集、监督微调、评测与强化学习接入同一端云闭环,并提供 Isaac GR00T、Isaac Lab Arena、RECAP 与 DSRL 的可复现配方。

NVIDIA_Community的博客 305

使用 NVIDIA NemoClaw 构建内存驱动型智能体

本文介绍基于NVIDIA NeMo Claw构建的内存驱动型智能体——办公室主任,通过结构化自我模型(人员、项目、优先级等)实现企业工作流的持续上下文维护与决策优化。该设计强调证据、知识与行动分离,支持选择性检索、用户校正与审计追踪,提升任务准确性与可信度。实测显示,其在事实跟踪、实体消歧、多源合成等任务上显著优于传统RAG。结合NVIDIA OpenShell实现安全沙盒运行,保障权限与边界控制。文章提供可复用的开源配方,涵盖内存架构、分类帐与离线演练,助力开发者构建高效、可信的企业级智能体。

NVIDIA_Community的博客 388

使用 NVIDIA Isaac GR00T 开发端到端人形机器人策略

随着越来越多的团队从人形机器人启动转向特定任务的技能开发,对可重复开发工作流的需求也与日俱增。构建人形机器人仍然十分复杂,而且当今的开发流程仍然高度分散。因此,开发者在专注于构建机器人功能之前,会花费大量时间来配置机器人基础设施。虽然机器人社区已经开发出跨流程各个阶段的工具,但由于软件生态系统孤立、数据格式不兼容以及工具之间的手动集成,将它们连接到无缝工作流仍然是一项挑战。为解决这一问题,我们推出了:这是一个开源人形机器人平台,可统一流程的每个阶段,以加快开发速度。

NVIDIA_Community的博客 4084

让长时间运行的 NVIDIA TensorRT 引擎在 Python 或 C++ 中构建可观察和可取消

构建 TensorRT 引擎可能需要几秒钟到几分钟的时间。大型强类型模型、深度策略搜索和全新 GPU SKU 上的冷定时缓存可能会让开发者、最终用户或 AI 智能体盯着冻结的终端,而不知道是否要等待、重试或终止该进程。大多数 NVIDIA TensorRT 集成在构建过程中不会报告任何内容,或者无法提前终止。在长时间运行的智能体工作流中,这会浪费 GPU 小时并导致会话卡顿。图 1. 用于 TensorRT 引擎构建的实时嵌套进度条,由 IProgressMonitor 子类渲染TensorRT 提供。

NVIDIA_Community的博客 3724

如何借助 RL 智能体技能和 NVIDIA NeMo 运行自动研究工作流

编码正成为长期运行的机器学习 (ML) 工作流程的实用运算符。他们可以检查资源库、设置运行时、解决构建问题、启动实验、监控执行、分析指标并汇总结果。对于研究而言,这一点很重要,因为有意义的指标通常只有在基本实验基础设施就绪后才会出现。是 Andrej Karpathy 的一个开源 Python 项目,用于自动化 AI 和 ML 模型训练。通过这种方法,将高层次的目标转化为假设,编辑和测试真实的代码库,保留改进指标的想法,并将结果交还给人类研究人员。这使得团队能够从高性能开放模型 (例如。

NVIDIA_Community的博客 3595

在 NVIDIA GB200 NVL72 上使用 GPU 加速的 Presto 运行低延迟分析工作负载

是一个开源分布式 SQL 引擎,可对超大型数据集快速运行交互式查询。在 NVIDIA GPU 上,Presto 可为分析查询工作负载提供峰值性能,并为用户和智能体提供低延迟。GPU 加速的 Presto 可降低分析工作负载的延迟,让您和智能体畅通无阻并尽可能快地进行迭代。本文将介绍如何使用单节点和多节点在扩展分析基准测试中高效执行多 GPU Presto。我们还强调了在与数据源搭配使用时对 NVIDIA GB200 NVL72 上的高 I/ O 吞吐量的重要性。

NVIDIA_Community的博客 3687

案例分享 | 基于 NVIDIA DGX Spark 的智能安防与工业智能方案开发应用

NVIDIA DGX Spark以GB10超级芯片与128GB高速统一内存为核心算力底座,凭借轻量化、全流程、高性能的特性,系统性解决智能安防与工业智能方案研发过程中数据处理慢、模型迭代难、推理延迟高、落地验证繁琐等痛点。通过构建视频智能分析、设备预测性维护两大AI能力体系,全方位赋能安防智能化管控与工业数字化运维,为智慧城市、智能制造领域的轻量化AI研发与场景落地提供高性能、高可靠的标杆方案。后续可依托平台拓展更多细分场景AI模型,持续拓宽行业智能化应用边界。

NVIDIA_Community的博客 2909
上一篇: 借助 NVIDIA Topograph 实现拓扑感知型工作负载调度
下一篇: NVIDIA NVLink 6 如何为 AI 工厂提供多层弹性
NVIDIA AI 技术专区
NVIDIA AI 技术专区 NVIDIA 官方账号 NVIDIA 官方账号
博客等级 码龄2年 632粉丝 213原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值