


全球数据的爆炸性增长预计到2025年将达到181 zettabytes,其中80%为非结构化数据,这对于无法有效处理非结构化文本数据的传统数据库构成了挑战。全文搜索通过实现对非结构化文本数据的直观高效访问,使用户能够基于主题或关键思想进行搜索。
MyScaleDB是ClickHouse的一个开源分支,专为向量搜索进行了优化,并通过集成全文搜索引擎库Tantivy增强了其文本搜索功能。
这次升级对于那些使用ClickHouse进行日志记录的用户尤为有益,他们通常将其作为Elasticsearch或Loki的替代品。对于利用MyScaleDB和大型语言模型(LLM)进行检索增强生成(RAG)的用户来说,这也有助于结合向量和文本搜索以提高准确性。
在本文中,我们将探讨集成过程的技术细节以及它如何提升MyScaleDB的性能。
ClickHouse本地文本搜索的局限性
ClickHouse提供了基本的文本搜索功能,如hasToken、startsWith和multiSearchAny,适用于简单的词项查询场景。然而,对于更复杂的需求,如短语查询、模糊文本匹配和BM25相关性排序,这些功能就显得不够了。因此,在MyScaleDB中,我们引入了Tantivy作为全文索引的底层实现,为MyScaleDB赋予了全文搜索功能。Tantivy的全文索引支持模糊文本查询、BM25相关性排序,并加速了现有的hasToken和multiSearchAny词项匹配功能。
为什么选择Tantivy
Tantivy是一个用Rust编写的开源全文搜索引擎库,专为处理大量文本数据而设计,具有出色的速度和效率。
理解Tantivy的核心原理
-
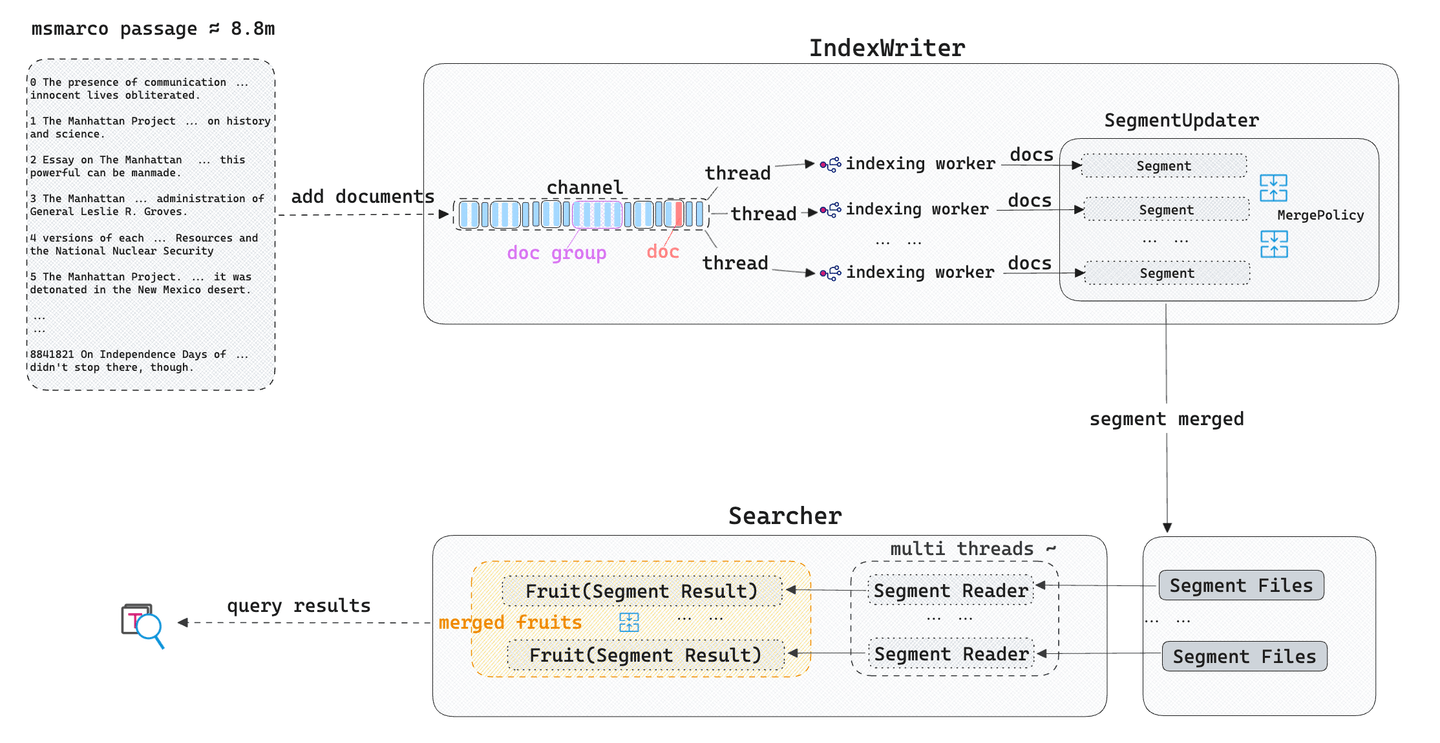
构建索引:Tantivy对输入文本进行分词,将其分割为独立的词项。然后,它创建一个倒排索引(倒排列表)并将其写入索引文件(段)。与此同时,Tantivy的后台线程利用合并策略合并和更新这些段索引文件。
-
执行文本搜索:当用户发起文本搜索查询时,Tantivy解析查询语句,提取词项,并在每个段上根据查询条件和BM25相关性算法对文档进行排序和评分。最后,根据相关性得分合并这些段的查询结果,并返回给用户。
Tantivy的关键特性
- BM25相关性评分:Elasticsearch、Lucene和Solr都使用BM25作为默认的相关性排序算法。BM25评分评估文本搜索的准确性和相关性,提升用户的搜索体验。
- 可配置的分词器:支持各种语言的分词器,满足用户多样化的分词需求。
- 自然语言查询:用户可以使用AND、OR、IN等关键词灵活组合文本查询,减少SQL语句编写的复杂性。
更多功能,请参考Tantivy文档。
与MyScaleDB的无缝集成
MyScaleDB是用C++编写的,基于ClickHouse开发的强大搜索引擎,适用于AI原生应用。为了丰富MyScaleDB的全文搜索功能,我们需要一个可以直接嵌入到MyScaleDB中的库。
Tantivy是一个受Apache Lucene启发的全文搜索库。与Elasticsearch、Apache Solr和其他类似引擎不同,Tantivy可以集成到各种数据库中,如MyScaleDB。Tantivy使用Rust编程语言编写,可以使用Corrosion轻松地与C++程序集成。
集成过程
为Tantivy构建C++包装器
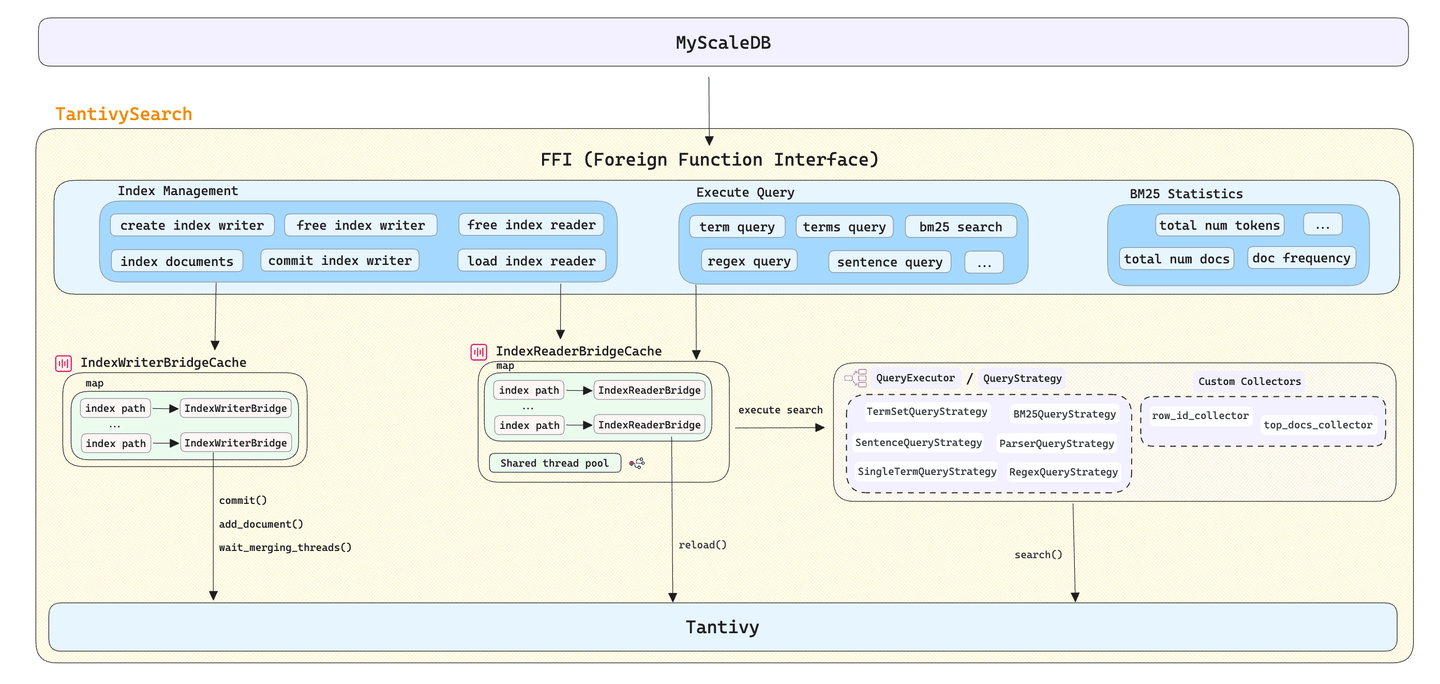
我们无法直接在MyScaleDB中使用原始的Tantivy库。为了解决跨语言开发(C++和Rust)的挑战,我们开发了tantivy-search,这是一个用于Tantivy的C++包装器。它为MyScaleDB提供了一组FFI接口,可以直接管理索引的创建、销毁、加载,并能够灵活处理各种场景下的文本搜索需求。
将Tantivy实现为ClickHouse的跳跃索引
ClickHouse的跳跃索引主要用于加速带有WHERE子句的查询。我们实现了一种名为FTS(全文搜索)的新跳跃索引类型,以Tantivy作为底层实现。因此,对于ClickHouse中具有FTS索引的每个数据部分,我们为其构建一个Tantivy索引。如前所述,Tantivy为每个索引生成了多个段文件。为了减少需要存储在数据部分中的文件数量,MyScaleDB将这些段文件序列化为两个文件,并将它们存储在数据部分中。skp_idx_[index_name].meta文件记录了每个段文件的名称和偏移量,而skp_idx_[index_name].data文件存储了每个段文件的原始数据。
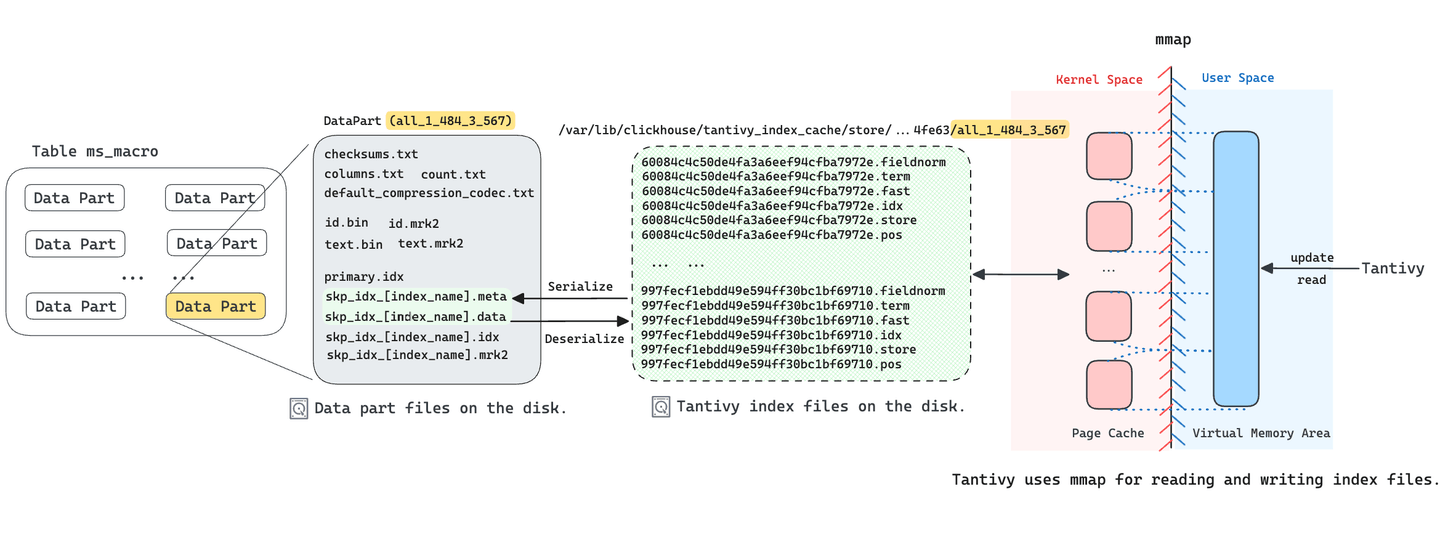
Tantivy利用内存映射(mmap)来访问段文件。这种方法不仅提高了并发搜索速度,还增强了索引构建效率。由于Tantivy无法直接将skp_idx_[index_name].data文件映射到内存中,当用户发起需要FTS索引的查询时,MyScaleDB将索引文件(.meta和.data)反序列化为Tantivy段文件,并加载Tantivy索引到临时目录中。Tantivy通过内存映射加载这些反序列化的段文件,以执行各种类型的文本搜索。因此,用户的初始查询请求可能需要几秒钟才能完成。
在托管的MyScaleDB服务中,我们将Tantivy的段索引文件存储在NVMe SSD上。这减少了I/O等待时间,并提高了在需要随机访问和处理页面错误异常的场景中的内存映射性能。
增强ClickHouse的本地文本搜索功能
当在包含FTS索引的列上发起带有过滤条件的请求时,MyScaleDB首先访问FTS索引。它检索满足SQL过滤条件的列的所有行ID,并将这些行ID存储在一个高级位图数据结构中,称为Roaring Bitmap。在遍历粒度时,我们确定粒度的行ID范围是否与位图相交,从而判断是否可以丢弃该粒度。最终,MyScaleDB只访问那些未被丢弃的粒度,从而实现查询加速。
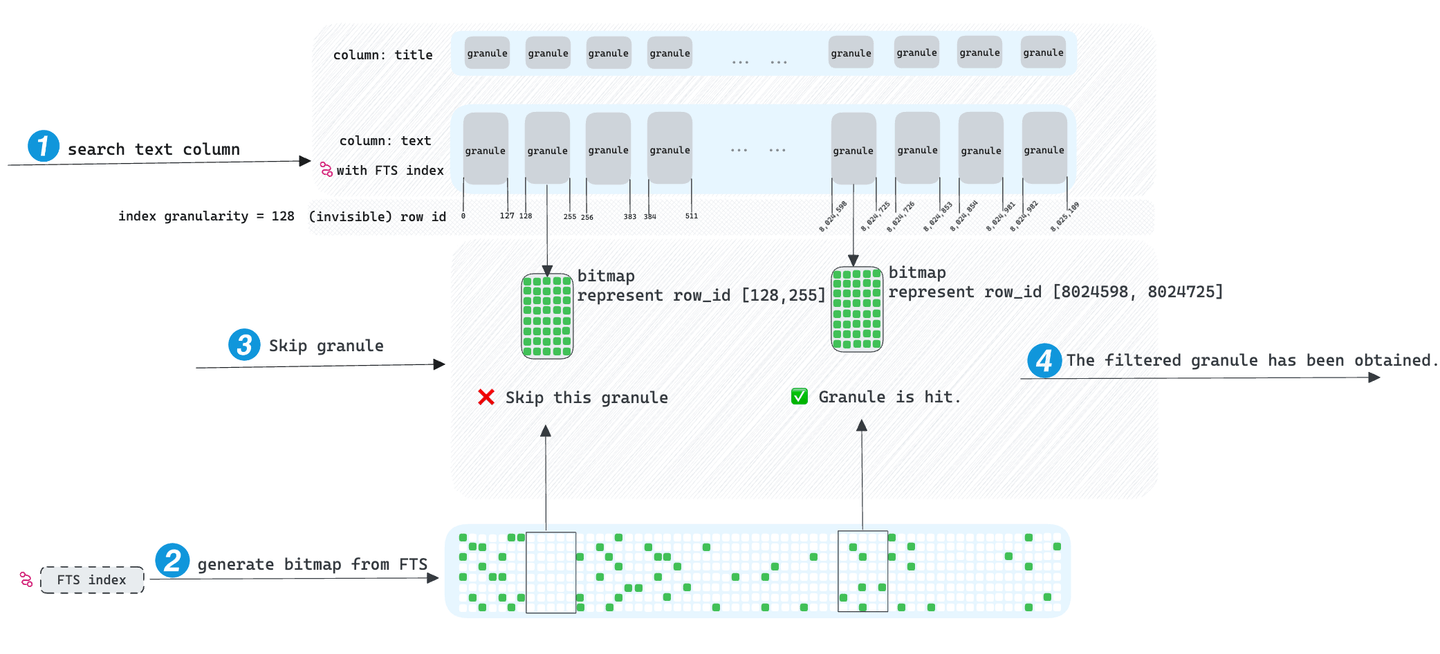
理想情况下,跳跃索引确实可以加速查询,但我们发现其效果有限。如果搜索的词项几乎出现在所有粒度中,MyScaleDB只能跳过少量的粒度,需要访问大量的粒度进行查询,使得跳跃索引在这种情况下失效。令人兴奋的是,MyScaleDB引入了TextSearch函数,不仅解决了跳跃索引的低效问题,还带来了其他实用功能。
引入TextSearch函数
为了充分利用Tantivy的全文搜索功能,我们将TextSearch函数纳入到MyScaleDB中。这允许用户执行模糊文本检索请求,并获得按BM25得分相关性排序的一组文档。此外,用户可以在TextSearch函数中使用自然语言查询,大大降低了SQL编写的复杂性。
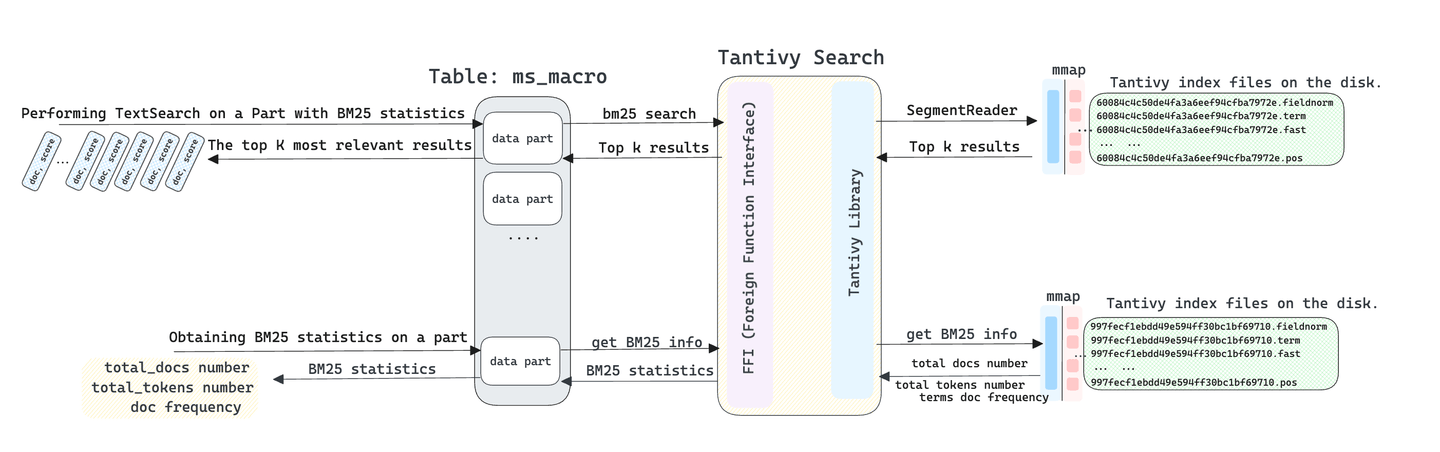
TextSearch函数在搜索文本时从表中检索前K个最相关的结果。在执行方面,MyScaleDB同时对所有数据部分执行TextSearch文本检索。因此,每个部分都收集按BM25得分排序的前K个最相关的结果。然后,MyScaleDB根据BM25得分从数据部分获取的这些结果进行聚合。最后,根据用户SQL查询中指定的ORDER BY和LIMIT子句,MyScaleDB保留前K个结果。TextSearch函数不直接从数据部分中读取数据,而是通过Tantivy直接检索索引搜索结果,因此非常快速。
需要注意的是,MyScaleDB使用多个数据部分来存储数据,每个数据部分负责存储整个表数据的一部分。我们不能简单地对每个部分对应的相同答案文本的BM25得分进行平均并排序。这是因为每个部分在计算BM25得分时,只考虑当前部分内的“总文档数”、“总词项数”和“文档频率”,而不考虑其他部分内与BM25算法相关的其他参数。因此,这会导致最终合并结果的准确性降低。
为了解决这个问题,我们在启动TextSearch查询之前,首先计算每个部分内的BM25统计信息,然后将它们合并为整个表的逻辑对应的BM25统计信息。此外,我们修改了Tantivy库,以支持共享的BM25信息的使用。这确保了在多个部分之间的TextSearch搜索结果的正确性。
下面是在ms_macro数据集上使用TextSearch函数执行基本文本搜索的简单示例。有关如何使用TextSearch函数的更多信息,请参考我们的TextSearch文档。
SELECT
    id,
    text,
    TextSearch(text, 'who is Obama') AS score
FROM ms_macro
ORDER BY score DESC
LIMIT 5
输出:
| id | text | score |
|---|---|---|
| 2717481 | Sasha Obama Biography. Name at birth: Natasha Obama. Sasha Obama is the younger daughter of former U.S. president Barack Obama. Her formal name is Natasha, but she is most often called by her nickname, Sasha. Sasha Obama was born in 2001 to Barack Obama and his wife, Michelle Obama, who were married in 1992. Sasha Obama has one older sister, Malia, who was born in 1998. | 15.448088 |
| 5016433 | Sasha Obama Biography. Sasha Obama is the younger daughter of former U.S. president Barack Obama. Her formal name is Natasha, but she is most often called by her nickname, Sasha. Sasha Obama was born in 2001 to Barack Obama and his wife, Michelle Obama, who were married in 1992. Sasha Obama has one older sister, Malia, who was born in 1998. | 15.407547 |
| 564474 | Michelle Obama net worth: $11.8 Million. Michelle Obama Net Worth: Michelle Obama is an American lawyer, writer and First Lady of the United States who has a net worth of $11.8 million.Michelle Obama was born January 17, 1964 in Chicago, Illinois.ichelle Obama net worth: $11.8 Million. Michelle Obama Net Worth: Michelle Obama is an American lawyer, writer and First Lady of the United States who has a net worth of $11.8 million. | 14.88242 |
| 5016431 | Name at birth: Natasha Obama. Sasha Obama is the younger daughter of former U.S. president Barack Obama. Her formal name is Natasha, but she is most often called by her nickname, Sasha. Sasha Obama was born in 2001 to Barack Obama and his wife, Michelle Obama, who were married in 1992. | 14.63069 |
| 1939756 | Michelle Obama Net Worth: Michelle Obama is an American lawyer, writer and First Lady of the United States who has a net worth of Michelle Obama Net Worth: Michelle Obama is an American lawyer, writer and First Lady of the United States who has a net worth of $40 million. Michelle Obama was born January 17, 1964 in Chicago, Illinois. She is best known for being the wife of the 44th President of the United States, Barack Obama. She attended Princeton University, graduating cum laude in 1985, and went on to earn a law degree from Harvard Law School in 1988. | 14.230849 |
性能评估
我们使用clickhouse-benchmark对MyScaleDB在不同索引下的搜索性能进行了比较,包括MyScaleDB实现的FTS索引、ClickHouse内置的倒排索引以及没有任何索引的情况。
基准测试设置
数据集详情
为了测试TextSearch性能,我们使用了Microsoft提供的ms_macro数据集。ms_macro数据集包含8841823条文本记录,我们将其转换为parquet格式,以便轻松导入到MyScaleDB中。此外,我们创建了一组用于测试搜索性能的SQL文件,这些文件基于不同的词频。读者可以通过S3访问本测试中使用的数据集:
- ms_macro_text.parquet: 1.6GB
- ms_macro_query_files.tar.gz: 5.8MB
ms_macro_query_files.tar.gz文件包含了本测试中使用的所有SQL文件。例如,每个SQL文件的名称指示了在数据集中搜索词项的频率以及SQL文件中包含的查询数量。例如,ms_macro_count_hastoken_100_100k.sql文件包含10万个查询,每个查询中的词在数据集中出现100次。
以下是hasToken和TextSearch查询的示例:
SELECT count(*) FROM ms_macro WHERE hasToken(text, 'Crimp');
SELECT count(*) FROM (
    SELECT TextSearch(text, 'Crimp') AS score
    FROM ms_macro ORDER BY score DESC LIMIT 10000000
) as subquery;
测试环境
尽管我们的测试环境具有64GB的内存,但在测试过程中,MyScaleDB的内存消耗保持在2.5GB左右。
| 项目 | 值 |
|---|---|
| 系统版本 | Ubuntu 22.04.3 LTS |
| CPU | 16核 (AMD Ryzen 9 6900HX) |
| 内存速度 | 64GB |
| 磁盘 | 512GB NVMe SSD |
| MyScaleDB | v1.5 |
数据导入过程
为ms_macro数据集创建表:
CREATE TABLE default.ms_macro
(
    `id` UInt64,
    `text` String
)
ENGINE = MergeTree
ORDER BY id
SETTINGS index_granularity = 128;
将数据直接从S3导入到MyScaleDB:
INSERT INTO default.ms_macro
SELECT * FROM
s3('https://myscale-datasets.s3.ap-southeast-1.amazonaws.com/ms_macro_text.parquet','Parquet');
合并ms_macro的数据部分以提高搜索速度。请注意,此操作是可选的。
OPTIMIZE TABLE default.ms_macro final;
SELECT count(*) FROM system.parts WHERE table = 'ms_macro';
输出:
| count() |
|---|
| 1 |
验证ms_macro包含8841823条记录:
SELECT count(*) FROM default.ms_macro;
输出:
| count() |
|---|
| 8841823 |
索引创建
我们将评估三种类型的索引的性能:FTS、倒排和无索引(没有任何索引的情况)。
- 创建FTS索引
-- 确保在创建FTS索引时,ms_macro表的text列上不存在其他索引。
ALTER TABLE default.ms_macro DROP INDEX IF EXISTS fts_idx;
ALTER TABLE default.ms_macro ADD INDEX fts_idx text TYPE fts;
ALTER TABLE default.ms_macro MATERIALIZE INDEX fts_idx;
- 创建倒排索引
-- 确保在创建倒排索引时,ms_macro表的text列上不存在其他索引。
ALTER TABLE default.ms_macro DROP INDEX IF EXISTS inverted_idx;
ALTER TABLE default.ms_macro ADD INDEX inverted_idx text TYPE inverted;
ALTER TABLE default.ms_macro MATERIALIZE INDEX inverted_idx;
- 无索引:确保ms_macro表的text列不包含任何索引。
运行基准测试
使用clickhouse-benchmark进行压力测试。有关更多使用说明,请参考ClickHouse文档。
clickhouse-benchmark -c 8 --timelimit=60 --randomize --log_queries=0 --delay=0 < ms_macro_count_hastoken_100_100k.sql -h 127.0.0.1 --port 9000
评估结果
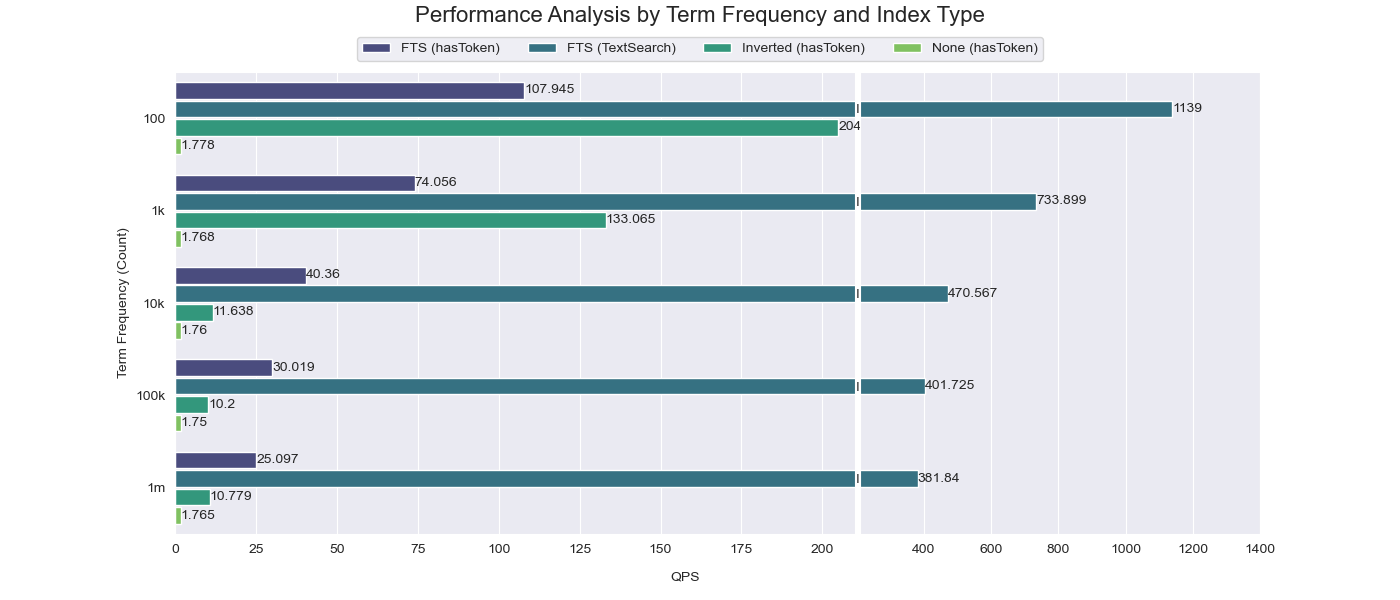
从比较结果可以看出,当搜索词的频率较高(100K1M)时,跳跃索引的加速效果非常有限(与没有建立任何索引的性能相比,仅提高了十倍)。然而,当搜索词的频率较低(1001K)时,跳跃索引可以实现显著的加速效果(与没有建立任何索引的性能相比,提高了多达一百倍)。
另一方面,TextSearch函数在所有场景下始终优于跳跃索引和倒排索引。这是因为TextSearch直接利用了Tantivy的全文搜索功能,无需扫描粒度,而是直接从索引中检索结果。这导致搜索过程更快、更高效。
结论
将Tantivy集成到MyScaleDB中显著增强了其文本搜索功能,使其成为文本数据分析和基于大型语言模型(LLM)的检索增强生成(RAG)的强大工具。通过解决ClickHouse本地文本搜索功能的局限性,并引入BM25相关性评分、可配置的分词器和自然语言查询等高级功能,MyScaleDB现在为复杂的文本搜索需求提供了强大而高效的解决方案。
为Tantivy构建C++包装器、创建新的跳跃索引以及引入TextSearch函数都对此改进做出了贡献。这些增强不仅提升了MyScaleDB的性能,还扩展了其用例,使其成为各种应用中高效准确的文本搜索的首选。
有关如何使用TextSearch函数和其他功能的更多信息,请参考我们的文本搜索和混合搜索文档。
希望本文为您提供了有关集成过程和其对MyScaleDB带来的好处的有价值的见解。敬请期待更多更新和改进,我们将继续增强MyScaleDB的功能。
 2097


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


