


前言:作为存储数据的容器,HashMap的重要性不言而喻。本文将会围绕其数据结构、构造方法、put、get、resize等方法进行展开,来解析HashMap的源码。以最简单的方式,来读懂最难的代码。
一:HashMap的数据结构
1.1:HashMap底层的数据结构
在jdk1.7中,HashMap是基于数组和链表来实现的,但是随着数据存储量的提高带来两大问题,其一是hash碰撞概率越来越大,导致链表越来越长。其二是随着链表长度的增长,导致数据查询变慢。所以jdk1.8在jdk1.7的基础上增加了红黑树,在一定条件下底层的数据存储会由单链表转换成红黑树,以此来提高查询效率。HashMap在JDK8中基本结构示意图如下所示:
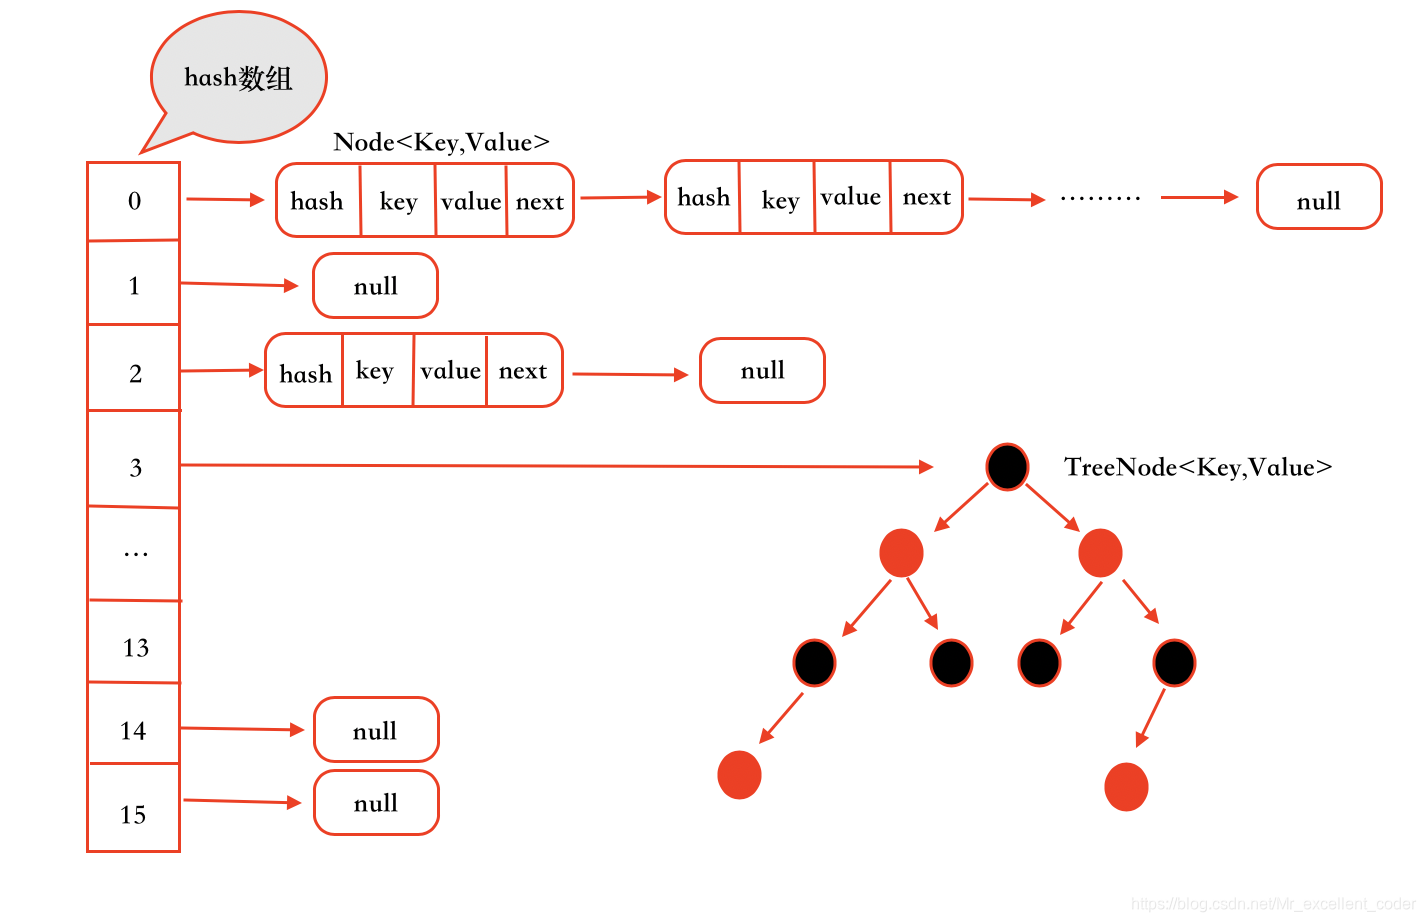
从上图我们可以看到,HashMap由一个数组外加单向链表和红黑树结构组成的。图中0-15的部分是哈希数组,数组里面的元素就是一个单项链表,图中是一个长度为16位的数组,每个数组储存的元素代表的是每一个链表的头结点。HashMap的数据存储过程是:首先会通过key的hashCode来计算hash值,然后会在数组中找到位置存储该元素,如果不同的key获取到的hash值是一样的,那么就出现了hash碰撞,此时数据就会存储到同一个链表中。那么当数据量很大的时候,hash碰撞的次数也会随之增多,导致链表太长查询很慢的结果,因此在jdk1.8中就引进了红黑树的结构,但是使用红黑树结构也是有一定的前提条件的,我们可以带着这个问题往下去研究,后面我会做总结。
通过上面我们可以知道大概的存储流程,内部的具体实现也先简单说一下,后续在源码中也会详细的讲解。通过key计算完hashCode后,就去链表中存储元素,而链表中的元素类型为Node<K, V> 。HashMap里有个静态内部类:
static class Node<K,V> implements Map.Entry<K,V> {
  	//hash值
    final int hash;
    final K key;
    V value;
  	//指向下一个元素
    Node<K,V> next;
}
其实在HashMap中也是一个数组来实现的,但是它在存储数据时是通过Node<K,V>来存储到哈希表中,而存储的位置是通过
int index = HashCode(key) % Array.length
这个公式来决定的。
二:HashMap的具体实现
2.1:HashMap中成员属性的详细介绍
 		//默认初始容量为16,且规定该数组的容量必须为2的n次幂
    static final int DEFAULT_INITIAL_CAPACITY = 1 << 4; // aka 16

		//规定数组最大的容量 为2的30次幂
    static final int MAXIMUM_CAPACITY = 1 << 30;

  	//加载因子
    static final float DEFAULT_LOAD_FACTOR = 0.75f;

  	//链表可能转换为红黑树的基本阈值(链表长度>=8)
    static final int TREEIFY_THRESHOLD = 8;

  	//哈希表扩容后,如果发现红黑树节点数小于6,则退化为链表
    static final int UNTREEIFY_THRESHOLD = 6;

    //链表转换为红黑树的另一个条件,哈希表长度必须大于等于64才会转换,否则会扩容
    static final int MIN_TREEIFY_CAPACITY = 64;

    //以Node<K,V>为元素的数组,也就是上图HashMap的纵向的长链数组,起长度必须为2的n次幂
    transient Node<K,V>[] table;

    // Node<K, V>的Set集合,HashMap将数据转换成set的另一种存储形式,这个变量主要用于迭代功能
    transient Set<Map.Entry<K,V>> entrySet;

    //已经储存的Node<key,value>的数量,包括数组中的和链表中的
    transient int size;

    //map内部元素修改的次数
    transient int modCount;

    //扩容的临界值,或者所能容纳的key-value对的极限。当size>=threshold的时候就会扩容resize()
    int threshold;

    // 自定义加载因子
    final float loadFactor;
-
DEFAULT_LOAD_FACTOR = 0.75f 这个属性时默认的加载因子,他是哈希表扩容的基础,当HashMap中存储的元素大于等于哈希表中现有的容量乘以这个加载因子时,就会触发扩容机制,并且扩容为原来的两倍。例如:我们创建HashMap时未指定哈希表容量,使用默认的16,当调用HashMap对象的put方法存储数据的时候,当存储的数量达到16*0.75f=12的时候,将触发扩容机制,此时哈希表容量将扩充为32,
-
TREEIFY_THRESHOLD = 8 和 MIN_TREEIFY_CAPACITY = 64 这两个属性组成链表转换为红黑树的条件,当哈希表长度大于等于 64 且链表长度达到 8 就会转换为红黑树,否则就会使用扩容机制。
-
UNTREEIFY_THRESHOLD = 6 红黑树退化成链表的阈值,当红黑树节点小于等于
6的时候,红黑树会转换成普通的链表。 -
modCount 该属性是记录了map新增/删除K-V对,或者内部结构做了调整的次数。其主要作用,是对Map的遍历操作做一致性校验,如果在iterator操作的过程中,map的数值有修改,直接抛出ConcurrentModificationException异常。
2.2:HashMap的链表节点Node< K , V >
   static class Node<K,V> implements Map.Entry<K,V> {
        final int hash;
        final K key;
        V value;
        Node<K,V> next;

        Node(int hash, K key, V value, Node<K,V> next) {
            this.hash = hash;
            this.key = key;
            this.value = value;
            this.next = next;
        }

        public final K getKey()        { return key; }
        public final V getValue()      { return value; }
        public final String toString() { return key + "=" + value; }
				 /**
         * 每一个节点的hash值,是将key的hashCode和value的hashCode异或得到的
         * ^:异或,两个操作数的位中,相同则结果为0,不同则结果为1
         */
        public final int hashCode() {
            return Objects.hashCode(key) ^ Objects.hashCode(value);
        }

        public final V setValue(V newValue) {
            V oldValue = value;
            value = newValue;
            return oldValue;
        }

        public final boolean equals(Object o) {
            if (o == this)
                return true;
            if (o instanceof Map.Entry) {
                Map.Entry<?,?> e = (Map.Entry<?,?>)o;
                if (Objects.equals(key, e.getKey()) &&
                    Objects.equals(value, e.getValue()))
                    return true;
            }
            return false;
        }
    }
2.3:HashMap的构造方法
jdk1.8中HashMap有四种构造方法:
//方法一:
//初始化容量和加载因子
public HashMap(int initialCapacity, float loadFactor) {
        if (initialCapacity < 0)
            throw new IllegalArgumentException("Illegal initial capacity: " +
                                               initialCapacity);
  			//如果初始化容量大于规定的最大容量 那么把最大容量给初始化容量
        if (initialCapacity > MAXIMUM_CAPACITY)
            initialCapacity = MAXIMUM_CAPACITY;
        if (loadFactor <= 0 || Float.isNaN(loadFactor))
            throw new IllegalArgumentException("Illegal load factor: " +
                                               loadFactor);
        this.loadFactor = loadFactor;

      //tableSizeFor()方法,为了计算出了最接近initialCapacity且大于initialCapacity的2的N次幂的值
  		//假如初始化传入20,因为20在2的4次幂到2的5次幂之间,那么最接近20且大于20的2的N次幂是32
        this.threshold = tableSizeFor(initialCapacity);
    }

//方法二:
 public HashMap(int initialCapacity) {
        this(initialCapacity, DEFAULT_LOAD_FACTOR);
    }

//方法三:
public HashMap() {
        this.loadFactor = DEFAULT_LOAD_FACTOR; // all other fields defaulted
    }


//方法四:传入Map类型参数,将参数map中元素加到HashMap表中
public HashMap(Map<? extends K, ? extends V> m) {
        this.loadFactor = DEFAULT_LOAD_FACTOR;
        putMapEntries(m, false);
    }

final void putMapEntries(Map<? extends K, ? extends V> m, boolean evict) {
  			//获取map的size、
        int s = m.size();
        if (s > 0) {
          	//当前hash表为空
            if (table == null) { // pre-size
              //根据map的元素数量和当前表的加载因子,计算出最优的扩容阈值
              //这个地方给我们的启示就是:当我们自己规定初始容量时,就可以使用这个公式
                float ft = ((float)s / loadFactor) + 1.0F;
              	//让规定的阀值不超过最大值
                int t = ((ft < (float)MAXIMUM_CAPACITY) ?
                         (int)ft : MAXIMUM_CAPACITY);
             		//如果新的阀值大于旧的阀值,那么启用返回最近的2的次幂的阀值
                if (t > threshold)
                    threshold = tableSizeFor(t);
            }
            //如果元素表不为空,并且新加入的map的size大于旧的阀值,那么启动扩容机制
            else if (s > threshold)
                resize();
            //遍历map将元素加入到当前表中
            for (Map.Entry<? extends K, ? extends V> e : m.entrySet()) {
                K key = e.getKey();
                V value = e.getValue();
                putVal(hash(key), key, value, false, evict);
            }
        }
    }

//扩容机制
 final Node<K,V>[] resize() {
   			//表示当前hash表(桶)
        Node<K,V>[] oldTab = table;
   			//当前hash表的长度
        int oldCap = (oldTab == null) ? 0 : oldTab.length;
   			//当前扩容的阀值
        int oldThr = threshold;
   			//定义新的hash表的长度和扩容阀值
        int newCap, newThr = 0;
   			//如果当前hash表的长度大于0
        if (oldCap > 0) {
          	//如果当前的hash表的长度大于等于最大的容量,那么扩容阀值取到Integer的最大值
            if (oldCap >= MAXIMUM_CAPACITY) {
                threshold = Integer.MAX_VALUE;
                return oldTab;
            }
            //如果当前hash表的长度不是最大、当前hash表的长度的两倍小于最大容量并且大于等于默认的初始长度
          	//那么新的hash的长度为原来的两倍
            else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY &&
                     oldCap >= DEFAULT_INITIAL_CAPACITY)
                newThr = oldThr << 1; // double threshold
        }
        //如果当前的hash表为空,并且有初始化阀值,那么新表的长度等于旧表的阀值
        else if (oldThr > 0) // initial capacity was placed in threshold
            newCap = oldThr;
        else {               // zero initial threshold signifies using defaults
          //如果当前的hash表为空,那么使用默认参数
            newCap = DEFAULT_INITIAL_CAPACITY;
            newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY);
        }
   			//如果新的hash表没有阀值,因为上面条件中没有设置扩容阀值、
        if (newThr == 0) {
          	//根据新表容量和自定义的加载因子得到阀值
            float ft = (float)newCap * loadFactor;
          	//保证阀值在规定范围内
            newThr = (newCap < MAXIMUM_CAPACITY && ft < (float)MAXIMUM_CAPACITY ?
                      (int)ft : Integer.MAX_VALUE);
        }
   			//更新扩容阀值
        threshold = newThr;
        @SuppressWarnings({"rawtypes","unchecked"})
   					//根据得到的新的长度来创建新的hash表
            Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap];
   			//赋值操作
        table = newTab;
   			//如果旧的哈希表中有元素,那么就把旧的哈希表中的元素转移到新的哈希表中
        if (oldTab != null) {
          	//遍历旧的哈希表
            for (int j = 0; j < oldCap; ++j) {
              	//获取当前节点
                Node<K,V> e;
              	//如果当前节点有元素,则将当前链表赋值给e
                if ((e = oldTab[j]) != null) {
                  	//将旧的哈希节点置为null
                    oldTab[j] = null;
                  	//如果当前哈希节点下的链表只有一个元素,那么直接计算索引放入新数组
                    if (e.next == null)
                        newTab[e.hash & (newCap - 1)] = e;
                   //如果发生过哈希碰撞 ,而且是节点数超过8个,转化成了红黑树
                  //如果该节点是红黑树,执行split方法来处理红黑树节点,包括升级、降级、回退到链表等操作
                    else if (e instanceof TreeNode)
                        ((TreeNode<K,V>)e).split(this, newTab, j, oldCap);
                    else { // preserve order
                      /**
                      * 接下来说明是链表操作,发生哈希碰撞且节点数小于8,就会根据链表上每个节点的hash值,依次
                      * 放入新的哈希表的对应的下标中。因为新的哈希表进行了扩容,那么转换时可能位置就会改变。
                      * "lo"前缀代表的是存储原bucket的节点,"hi"前缀代表的是存储在新bucket的节点
                      * Head是头节点,Tail是尾节点
                      */
                      	//原链表的头节点和尾节点
                        Node<K,V> loHead = null, loTail = null;
                      	//新链表的头节点和尾节点
                        Node<K,V> hiHead = null, hiTail = null;
                      	//指向e的下一个节点
                        Node<K,V> next;
                        do {
                            next = e.next;
                           	// 从if-else可以看出,对一条链表进行遍历,将链表中的元素通过
                            // 条件(e.hash & oldCap) == 0来进行分类,满足条件的存放在loHead链上
                            // 不满足条件的存放在hiHead链上,且都是尾部插入方式,这和JDK7的头部插入有区别
                          	//下面有详细解析
                            if ((e.hash & oldCap) == 0) {
                                if (loTail == null)
                                    loHead = e;
                                else
                                    loTail.next = e;
                                loTail = e;
                            }
                            else {
                                if (hiTail == null)
                                    hiHead = e;
                                else
                                    hiTail.next = e;
                                hiTail = e;
                            }
                        } while ((e = next) != null);
                      // 将loHead链放在数组的原位置
                        if (loTail != null) {
                            loTail.next = null;
                            newTab[j] = loHead;
                        }
                      // 将hiHead链放在数组的(j + oldCap)位置
                        if (hiTail != null) {
                            hiTail.next = null;
                            newTab[j + oldCap] = hiHead;
                        }
                    }
                }
            }
        }
        return newTab;
    }
-
这里把上面感到困惑的点拉出来单独分析一下:上面是通过计算 (e.hash&oldCap)==0 分成两条链表,再将两条链表放 到新数组的不同位置上。
-
这个表达式的具体含义就是:根据key的hash值的二进制和旧数组的长度进行 & 运算(两个二进制位有一个为1就为1,否者为0),计算完后根据最高位的是0还是1来判断位置。
-
举个例子:
键值对 键哈希值(二进制) 扩容前 & 扩容前下标 扩容后 & 扩容后下标 { 5 : A } 0000 0000 0000 0000 0000 0000 0000 0101 0101 5 0 0101 5 { 21 : B } 0000 0000 0000 0000 0000 0000 0001 0101 0101 5 1 0101 21 { 37 : C } 0000 0000 0000 0000 0000 0000 0010 0101 0101 5 0 0101 5 { 53 : D } 0000 0000 0000 0000 0000 0000 0011 0101 0101 5 1 0101 21 看上面表格,健的哈希值与旧的数组长度进行 & 运算,旧的数组的默认长度为15,15的二进制为 0000 0000 0000 0000 0000 0000 0000 1111,与健5,21,37,53进行 & 运算后都会得到到 0101 此时就放在一个链表下。当进行扩容后,长度就会增加一个二进制位,数组长度由之前的 (2的4次幂 -1) = 15变成(2的5次幂-1)=31,31的二进制为 0000 0000 0000 0000 0000 0000 0001 1111,同样的进行 & 运算后得到 0 0101 和 1 0101 两种情况,0 0101和之前并没有区别下标还是 5 而 1 0101 其实等于 00101 + 10000 = 5 + 16 = j + oldCap = 21。下标就会变成21,那么数组扩容后数据就会添加到下标为21 的位置。这个地方多说一句,扩容后的二进制位数由4位数变成5位数是因为数组扩容的机制是增加2的次幂的个数导致的。
-
总结:数组的大小一直是2的倍数,所以当你扩容一次,数组长度和下标的 & 运算就会增加一位,最后截取的高位也就是左边第一位将会决定元素的下标。如果高位为0,那么不需要进行位置调整,如果高位为1,那么元素会调整到 j + oldCap位置。
2.4:HashMap中的一些主要方法
2.4.1:HashMap中的Put()方法
 public V put(K key, V value) {
        return putVal(hash(key), key, value, false, true);
    }


	/**
	* onlyIfAbsent为true时,相同key的元素,只有原来元素的value不为null时,新put的元素才会对value进行覆盖
	* onlyIfAbsent 默认是 false
  * evict为false,那么HashMap为创建模式 默认是true 该参数用于LinkedHashMap,这里没有其他作用(空实现)
	*/
   final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
                   boolean evict) {
     		//变量tab作为接下来操作数组的引用、p作为需要操作的节点、n为tab的长度、i为tab的下标
        Node<K,V>[] tab; Node<K,V> p; int n, i;
     		//如果tab没有初始化、通过resize()方法进行扩容和初始化
        if ((tab = table) == null || (n = tab.length) == 0)
            n = (tab = resize()).length;
     		//通过tab的长度进行 & 运算来获取tab的下标,p=tab[i],并判断p是否为null。
        if ((p = tab[i = (n - 1) & hash]) == null)
          	//如果为null,说明该位置之前没有元素,无hash碰撞、新建一节点放进去
            tab[i] = newNode(hash, key, value, null);
        else {
          //当p不等于null 时
            Node<K,V> e; K k;
          	//如果p的hash值和key的hash值想等或者p节点的key和传入的key一致
            if (p.hash == hash &&
                ((k = p.key) == key || (key != null && key.equals(k))))
             //如果相等,则将p的引用赋给e
                e = p;
            //如果p节点是个红黑树节点
            else if (p instanceof TreeNode)
                //强转后put进去、返回应用给到e
                e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);
            else {
              	//接下来会判断插入后链表是维持链表结构还是转变为红黑树
              	//binCount计算链表元素的个数
                for (int binCount = 0; ; ++binCount) {
                    if ((e = p.next) == null) {
                      	//当链表中p的下一个元素为null时,那么把该元素插入到p的后面、
                        //并且把新节点的引用给到p.next
                      	//最后一个参数传 null 保证此节点还是最后一个
                        p.next = newNode(hash, key, value, null);
                      	//插入成功后,判断是否要转化成红黑树结构
                      	//插入元素后,此时链表元素已经增加一个,但是binCount还没有++,所以阀值减小一个
                        if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st

														//如果链表节点已经达到8个并且数组的长度达到64,那么转化成红黑树存储
                          	//否则,扩容
                            treeifyBin(tab, hash);
                        break;
                    }
                  	//遍历时如果发现有相同的节点,将这个节点引用赋值给e,最后统一处理
                    if (e.hash == hash &&
                        ((k = e.key) == key || (key != null && key.equals(k))))
                        break;
                    p = e;
                }
            }
          //对已经存在key的情况做处理
            if (e != null) { // existing mapping for key
                V oldValue = e.value;
              //前面提到,onlyIfAbsent表示存在key相同时不做覆盖处理,
              //这里作为判断条件,可以看出当onlyIfAbsent为false或者oldValue为null时,进行覆盖操作。
                if (!onlyIfAbsent || oldValue == null)
                    e.value = value;
              //linkedHashMap的尾部操作,HashMap中并无实际意义
                afterNodeAccess(e);
              	//在这里如果插入的是key之前存在,返回oldValue,如果是新添加数据,那么就是返回null
                return oldValue;
            }
        }
        ++modCount;
        if (++size > threshold)
            resize();
     		//linkedHashMap的尾部操作,HashMap中并无实际意义
        afterNodeInsertion(evict);
        return null;
    }
2.4.2:HashMap中的get()方法
 public V get(Object key) {
        Node<K,V> e;
        return (e = getNode(hash(key), key)) == null ? null : e.value;
    }

//根据key的hash值去获取value
 final Node<K,V> getNode(int hash, Object key) {
    // tab:内部数组  first: 索引位首节点 n: 数组长度 k: 索引位首节点的key
        Node<K,V>[] tab; Node<K,V> first, e; int n; K k;
   // 数组不为null 数组长度大于0 索引位首节点不为null
    //根据key的hash值,计算出下标(n - 1)& hash,如果有这个下标,那么直接得到元素
        if ((tab = table) != null && (n = tab.length) > 0 &&
            (first = tab[(n - 1) & hash]) != null) {
            if (first.hash == hash && // always check first node
                ((k = first.key) == key || (key != null && key.equals(k))))
                return first;
          //接下来就是遍历链表和红黑树结构,直到下一个元素为null
            if ((e = first.next) != null) {
                if (first instanceof TreeNode)
                    return ((TreeNode<K,V>)first).getTreeNode(hash, key);
                do {
                    if (e.hash == hash &&
                        ((k = e.key) == key || (key != null && key.equals(k))))
                        return e;
                  //如果key不同,一直遍历下去直到链表尽头,e.next == null
                } while ((e = e.next) != null);
            }
        }
   			//没找到就返回null
        return null;
    }


- 判断key的想等条件:hash值相同 并且 符合equals方法。
- 查哈希表数组是否为null和索引位首节点(bucket的第一个节点)是否为null。
- 不是首节点,也不是红黑树,那么就开始遍历链表,获取与key相同键的节点
三:HsahMap中常见的问题
3.1:HashMap的扩容机制是什么,什么时候会发生扩容?
-
哈希表为null或者长度为0。
-
哈希表中存储的K-V对数超过了threshold。
-
链表中长度超过了8,并且哈希表长度到达64,此时也会发生扩容。
3.2:HashMap不是线程安全的,为什么?如何保证线程安全?
解析:在put()方法中有这样的代码
 if ((p = tab[i = (n - 1) & hash]) == null) // 如果没有hash碰撞则直接插入元素
  tab[i] = newNode(hash, key, value, null);
假如我们通过多线程来往HashMap中插入元素,线程A和线程B都进行put操作,且线程A和线程B插入元素下标的哈希值是一致的,当线程A走到 if 条件里面时暂时挂起,线程B走进来也插入元素,并且成功插入了元素,此时线程B挂起,线程A此时被放开,由于之前做过hash碰撞的判断,进来后直接进行插入操作,此时就会导致线程B插入的数据被线程A插入的数据覆盖了,导致数据前后不一致的情况。所以线程是不安全的。
对于线程不安全的情况,可以使用
Collections.SynchronizedMap()
来实现。
3.3:HashMap中为什么会选择8作为链表转红黑树的阈值?
解析:根据泊松分布,在负载因子默认为0.75的时候,单个hash槽内元素个数为8的概率小于百万分之一,所以将7作为一个分水岭,等于7的时候不转换,大于等于8的时候才进行转换,小于等于6的时候就化为链表。
至此,HashMap的源码研究告一段落,欢迎大家一起讨论学习。
了解更多干货,欢迎关注我的微信公众号:爪哇论剑

 4558


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


