


Dual Attention Network for Scene Segmentation
提出了双重注意力网络(DANet)来自适应地集成局部特征和全局依赖。在传统的扩张FCN之上附加两种类型的注意力模块,分别模拟空间和通道维度中的语义相互依赖性。
- 位置注意力模块通过所有位置处的特征的加权和来选择性地聚合每个位置的特征。无论位置如何,类似的特征都将彼此相关。
- 通道注意力模块通过整合所有通道映射之间的相关特征来选择性地强调存在相互依赖的通道映射。
- 将两个注意力模块的输出相加并加以进一步改进特征表示,这有助于更精确的分割结果。
OverView
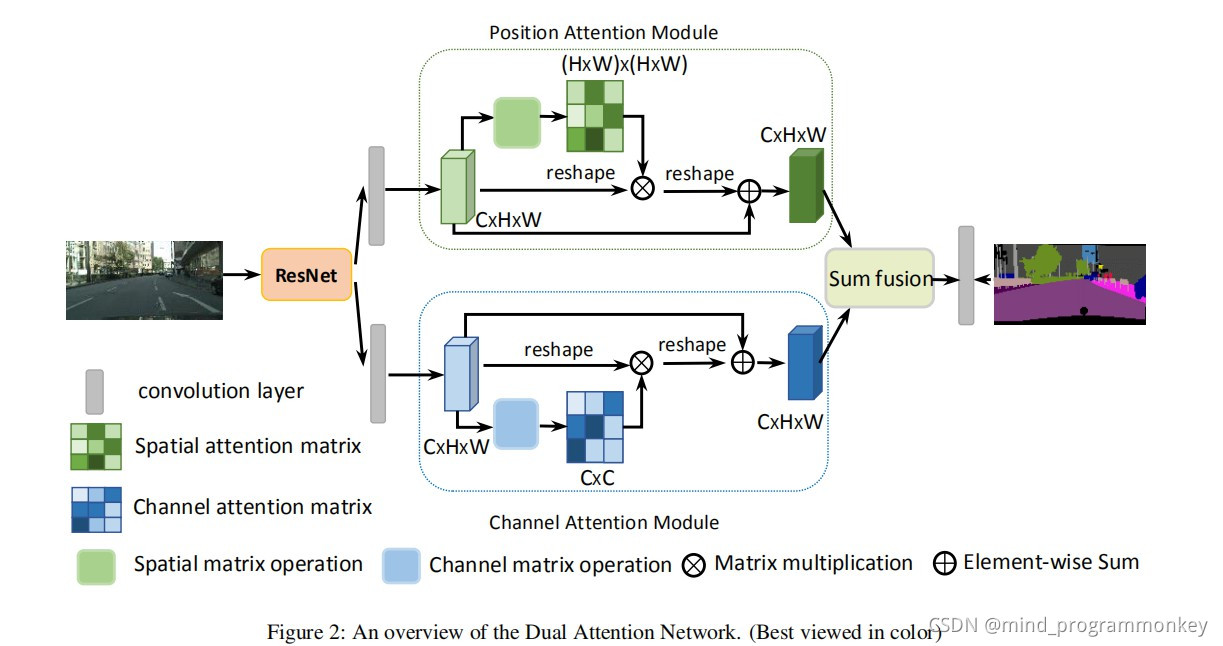
基础网络架构为dilated ResNet(与DeepLab相同),最后得到的feature map大小为输入图像的1/8之后使两国并行的attention module分贝捕获spatial 和 channel的依赖性,最后整合两个attention module的输出得到更好的特征表达。
Modules
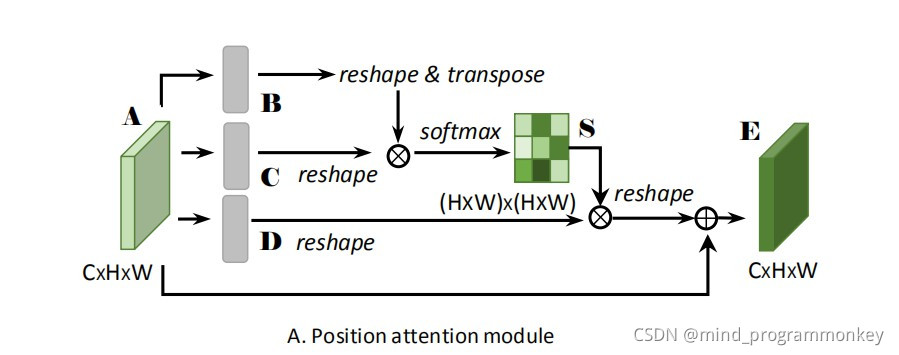
引入位置注意力模块,引入self-attention机制来捕获要素图的任意两个位置之间的空间依懒性。
- 特征图A(C×H×W)首先分别通过3个卷积层得到3个特征图B,C,D,然后将B,C,D reshape为C×N,其中N=H×W
- 之后将reshape后的B的转置(NxC)与reshape后的C(CxN)相乘,再通过softmax得到spatial attention map S(N×N)
- 接着在reshape后的D(CxN)和S的转置(NxN)之间执行矩阵乘法,再乘以尺度系数α,再reshape为原来形状,最后与A相加得到最后的输出E
- 其中α初始化为0,并逐渐的学习得到更大的权重
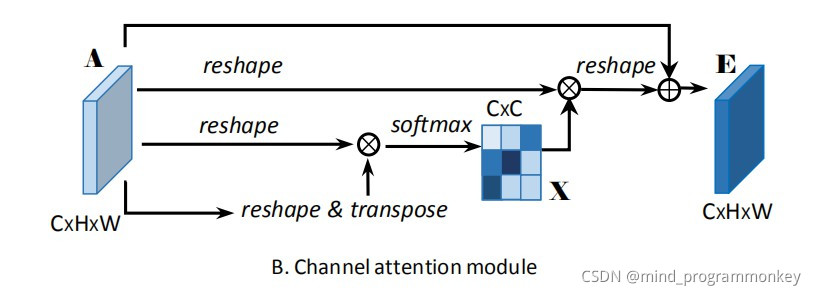
对于通道注意力模块,使用self-attention机制来捕获任意两个通道maps之间的通道依赖关系
- 分别对A做reshape(CxN)和reshape与transpose(NxC)
- 将得到的两个特征图相乘,再通过softmax得到channel attention map X(C×C)
- 接着把X的转置(CxC)与reshape的A(CxN)做矩阵乘法,再乘以尺度系数β,再reshape为原来形状,最后与A相加得到最后的输出E
- 其中β初始化为0,并逐渐的学习得到更大的权重
代码:
class PAM(Layer):
    def __init__(self,
                 gamma_initializer=tf.zeros_initializer(),
                 gamma_regularizer=None,
                 gamma_constraint=None,
                 **kwargs):
        super(PAM, self).__init__(**kwargs)
        self.gamma_initializer = gamma_initializer
        self.gamma_regularizer = gamma_regularizer
        self.gamma_constraint = gamma_constraint

    def build(self, input_shape):
        self.gamma = self.add_weight(shape=(1, ),
                                     initializer=self.gamma_initializer,
                                     name='gamma',
                                     regularizer=self.gamma_regularizer,
                                     constraint=self.gamma_constraint)

        self.built = True

    def compute_output_shape(self, input_shape):
        return input_shape

    def call(self, input):
        input_shape = input.get_shape().as_list()
        _, h, w, filters = input_shape

        b = Conv2D(filters // 8, 1, use_bias=False, kernel_initializer='he_normal')(input)
        c = Conv2D(filters // 8, 1, use_bias=False, kernel_initializer='he_normal')(input)
        d = Conv2D(filters, 1, use_bias=False, kernel_initializer='he_normal')(input)

        vec_b = K.reshape(b, (-1, h * w, filters // 8))
        vec_cT = tf.transpose(K.reshape(c, (-1, h * w, filters // 8)), (0, 2, 1))
        bcT = K.batch_dot(vec_b, vec_cT)
        softmax_bcT = Activation('softmax')(bcT)
        vec_d = K.reshape(d, (-1, h * w, filters))
        bcTd = K.batch_dot(softmax_bcT, vec_d)
        bcTd = K.reshape(bcTd, (-1, h, w, filters))

        out = self.gamma*bcTd + input
        return out
class CAM(Layer):
    def __init__(self,
                 gamma_initializer=tf.zeros_initializer(),
                 gamma_regularizer=None,
                 gamma_constraint=None,
                 **kwargs):
        super(CAM, self).__init__(**kwargs)
        self.gamma_initializer = gamma_initializer
        self.gamma_regularizer = gamma_regularizer
        self.gamma_constraint = gamma_constraint

    def build(self, input_shape):
        self.gamma = self.add_weight(shape=(1, ),
                                     initializer=self.gamma_initializer,
                                     name='gamma',
                                     regularizer=self.gamma_regularizer,
                                     constraint=self.gamma_constraint)

        self.built = True

    def compute_output_shape(self, input_shape):
        return input_shape

    def call(self, input):
        input_shape = input.get_shape().as_list()
        _, h, w, filters = input_shape

        vec_a = K.reshape(input, (-1, h * w, filters))
        vec_aT = tf.transpose(vec_a, (0, 2, 1))
        aTa = K.batch_dot(vec_aT, vec_a)
        softmax_aTa = Activation('softmax')(aTa)
        aaTa = K.batch_dot(vec_a, softmax_aTa)
        aaTa = K.reshape(aaTa, (-1, h, w, filters))

        out = self.gamma*aaTa + input
        return out
def conv3x3(x, out_filters, strides=(1, 1)):
    x = Conv2D(out_filters, 3, padding='same', strides=strides, use_bias=False, kernel_initializer='he_normal')(x)
    return x


def Conv2d_BN(x, nb_filter, kernel_size, strides=(1, 1), padding='same', use_activation=True):
    x = Conv2D(nb_filter, kernel_size, padding=padding, strides=strides, kernel_initializer='he_normal')(x)
    x = BatchNormalization(axis=3)(x)
    if use_activation:
        x = Activation('relu')(x)
        return x
    else:
        return x

def basic_Block(input, out_filters, strides=(1, 1), with_conv_shortcut=False):
    x = conv3x3(input, out_filters, strides)
    x = BatchNormalization(axis=3)(x)
    x = Activation('relu')(x)

    x = conv3x3(x, out_filters)
    x = BatchNormalization(axis=3)(x)

    if with_conv_shortcut:
        residual = Conv2D(out_filters, 1, strides=strides, use_bias=False, kernel_initializer='he_normal')(input)
        residual = BatchNormalization(axis=3)(residual)
        x = add([x, residual])
    else:
        x = add([x, input])

    x = Activation('relu')(x)
    return x

def bottleneck_Block(input, out_filters, strides=(1, 1), dilation=(1, 1), with_conv_shortcut=False):
    expansion = 4
    de_filters = int(out_filters / expansion)

    x = Conv2D(de_filters, 1, use_bias=False, kernel_initializer='he_normal')(input)
    x = BatchNormalization(axis=3)(x)
    x = Activation('relu')(x)

    x = Conv2D(de_filters, 3, strides=strides, padding='same',
               dilation_rate=dilation, use_bias=False, kernel_initializer='he_normal')(x)
    x = BatchNormalization(axis=3)(x)
    x = Activation('relu')(x)

    x = Conv2D(out_filters, 1, use_bias=False, kernel_initializer='he_normal')(x)
    x = BatchNormalization(axis=3)(x)

    if with_conv_shortcut:
        residual = Conv2D(out_filters, 1, strides=strides, use_bias=False, kernel_initializer='he_normal')(input)
        residual = BatchNormalization(axis=3)(residual)
        x = add([x, residual])
    else:
        x = add([x, input])

    x = Activation('relu')(x)
    return x
def danet_resnet101(height, width, channel, classes):
    input = Input(shape=(height, width, channel))

    conv1_1 = Conv2D(64, 7, strides=(2, 2), padding='same', use_bias=False, kernel_initializer='he_normal')(input)
    conv1_1 = BatchNormalization(axis=3)(conv1_1)
    conv1_1 = Activation('relu')(conv1_1)
    conv1_2 = MaxPooling2D(pool_size=(3, 3), strides=(2, 2), padding='same')(conv1_1)

    # conv2_x  1/4
    conv2_1 = bottleneck_Block(conv1_2, 256, strides=(1, 1), with_conv_shortcut=True)
    conv2_2 = bottleneck_Block(conv2_1, 256)
    conv2_3 = bottleneck_Block(conv2_2, 256)

    # conv3_x  1/8
    conv3_1 = bottleneck_Block(conv2_3, 512, strides=(2, 2), with_conv_shortcut=True)
    conv3_2 = bottleneck_Block(conv3_1, 512)
    conv3_3 = bottleneck_Block(conv3_2, 512)
    conv3_4 = bottleneck_Block(conv3_3, 512)

    # conv4_x  1/16
    conv4_1 = bottleneck_Block(conv3_4, 1024, strides=(1, 1), dilation=(2, 2), with_conv_shortcut=True)
    conv4_2 = bottleneck_Block(conv4_1, 1024, dilation=(2, 2))
    conv4_3 = bottleneck_Block(conv4_2, 1024, dilation=(2, 2))
    conv4_4 = bottleneck_Block(conv4_3, 1024, dilation=(2, 2))
    conv4_5 = bottleneck_Block(conv4_4, 1024, dilation=(2, 2))
    conv4_6 = bottleneck_Block(conv4_5, 1024, dilation=(2, 2))
    conv4_7 = bottleneck_Block(conv4_6, 1024, dilation=(2, 2))
    conv4_8 = bottleneck_Block(conv4_7, 1024, dilation=(2, 2))
    conv4_9 = bottleneck_Block(conv4_8, 1024, dilation=(2, 2))
    conv4_10 = bottleneck_Block(conv4_9, 1024, dilation=(2, 2))
    conv4_11 = bottleneck_Block(conv4_10, 1024, dilation=(2, 2))
    conv4_12 = bottleneck_Block(conv4_11, 1024, dilation=(2, 2))
    conv4_13 = bottleneck_Block(conv4_12, 1024, dilation=(2, 2))
    conv4_14 = bottleneck_Block(conv4_13, 1024, dilation=(2, 2))
    conv4_15 = bottleneck_Block(conv4_14, 1024, dilation=(2, 2))
    conv4_16 = bottleneck_Block(conv4_15, 1024, dilation=(2, 2))
    conv4_17 = bottleneck_Block(conv4_16, 1024, dilation=(2, 2))
    conv4_18 = bottleneck_Block(conv4_17, 1024, dilation=(2, 2))
    conv4_19 = bottleneck_Block(conv4_18, 1024, dilation=(2, 2))
    conv4_20 = bottleneck_Block(conv4_19, 1024, dilation=(2, 2))
    conv4_21 = bottleneck_Block(conv4_20, 1024, dilation=(2, 2))
    conv4_22 = bottleneck_Block(conv4_21, 1024, dilation=(2, 2))
    conv4_23 = bottleneck_Block(conv4_22, 1024, dilation=(2, 2))

    # conv5_x  1/32
    conv5_1 = bottleneck_Block(conv4_23, 2048, strides=(1, 1), dilation=(4, 4), with_conv_shortcut=True)
    conv5_2 = bottleneck_Block(conv5_1, 2048, dilation=(4, 4))
    conv5_3 = bottleneck_Block(conv5_2, 2048, dilation=(4, 4))

    # ATTENTION
    reduce_conv5_3 = Conv2D(512, 3, padding='same', use_bias=False, kernel_initializer='he_normal')(conv5_3)
    reduce_conv5_3 = BatchNormalization(axis=3)(reduce_conv5_3)
    reduce_conv5_3 = Activation('relu')(reduce_conv5_3)

    pam = PAM()(reduce_conv5_3)
    pam = Conv2D(512, 3, padding='same', use_bias=False, kernel_initializer='he_normal')(pam)
    pam = BatchNormalization(axis=3)(pam)
    pam = Activation('relu')(pam)
    pam = Dropout(0.5)(pam)
    pam = Conv2D(512, 3, padding='same', use_bias=False, kernel_initializer='he_normal')(pam)

    cam = CAM()(reduce_conv5_3)
    cam = Conv2D(512, 3, padding='same', use_bias=False, kernel_initializer='he_normal')(cam)
    cam = BatchNormalization(axis=3)(cam)
    cam = Activation('relu')(cam)
    cam = Dropout(0.5)(cam)
    cam = Conv2D(512, 3, padding='same', use_bias=False, kernel_initializer='he_normal')(cam)

    feature_sum = add([pam, cam])
    feature_sum = Dropout(0.5)(feature_sum)
    feature_sum = Conv2d_BN(feature_sum, 512, 1)
    merge7 = concatenate([conv3_4, feature_sum], axis=3)
    conv7 = Conv2d_BN(merge7, 512, 3)
    conv7 = Conv2d_BN(conv7, 512, 3)

    up8 = Conv2d_BN(UpSampling2D(size=(2, 2))(conv7), 256, 2)
    merge8 = concatenate([conv2_3, up8], axis=3)
    conv8 = Conv2d_BN(merge8, 256, 3)
    conv8 = Conv2d_BN(conv8, 256, 3)

    up9 = Conv2d_BN(UpSampling2D(size=(2, 2))(conv8), 64, 2)
    merge9 = concatenate([conv1_1, up9], axis=3)
    conv9 = Conv2d_BN(merge9, 64, 3)
    conv9 = Conv2d_BN(conv9, 64, 3)

    up10 = Conv2d_BN(UpSampling2D(size=(2, 2))(conv9), 64, 2)
    conv10 = Conv2d_BN(up10, 64, 3)
    conv10 = Conv2d_BN(conv10, 64, 3)

    conv11 = Conv2d_BN(conv10, classes, 1, use_activation=None)
    activation = Activation('softmax', name='Classification')(conv11)

    model = Model(inputs=input, outputs=activation)
    return model

 599


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


