技术解读 | 搭建NL2SQL系统需要大模型么?

2019年NLP的高光时刻,会从NL2SQL开始么? 2019年NLP的高光时刻,会从NL2SQL开始么? 作者:追一科技 算法研究员 Wayne 自2015年新一轮人工智能浪潮涌起,先是视觉、语音各领风骚,小火慢炖的NLP从2018下半年开始,也走入了高光时刻:BERT、GPT-2.0等一系列里程碑意义的模型横空出世,创新应用场景次第打开。 2019年,NLP又会给大家带来哪些惊喜呢? 作为智能语义的领跑者,追一科技一直在... 阅读详情

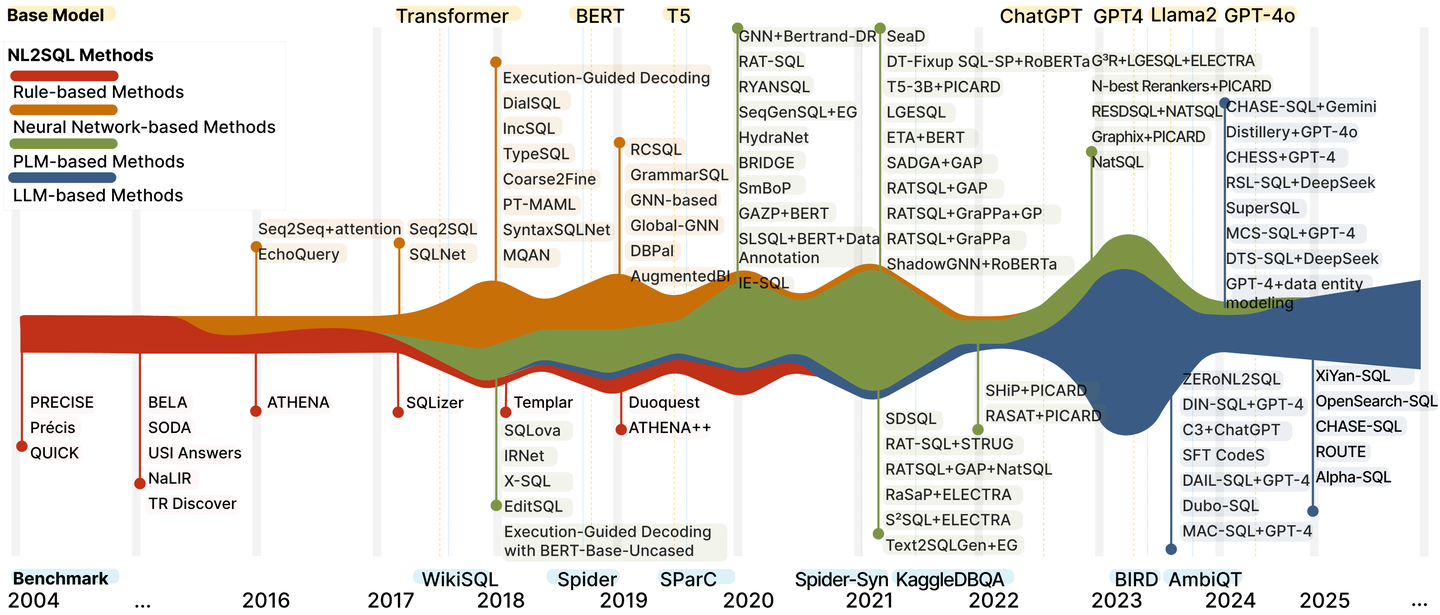
近年来,大模型(LLMs)的热潮推动了自然语言处理(NLP)任务的广泛进展,NL2SQL(自然语言转SQL)作为热门任务之一也不例外。 从下图可以看出,不同的benchmark以及测试方法在T5模型之后,出现了极速增长。
并且一些SOTA 模型在nl2sql任务的表现上和以往相比,有了极大的提升:
但是普遍的这些模型的参数量都在100B以上,而NL2SQL作为一个相对niche的场景,并且和业务场景结合密切的情况下,是否可以在一些小参数量的模型上也获得比较好的表现呢?

NL2SQL的核心是什么?

我们认为,NL2SQL的核心能力并不在于“语言建模”本身,而是在两个方面:

  1. 理解用户意图与问题背景(场景理解)

  2. 根据数据库结构正确地生成SQL(逻辑推理+语法生成)

这两个任务的挑战,不在于模型是否足够“大”,而在于:

  • 自然语言表达是否模糊(例如“订单总量是多少”可能有多种理解)

  • 数据库结构是否复杂、是否包含大量无关表/列

  • 字段命名是否清晰,是否有中文注释、是否包含样例数据

这些问题,很多时候靠“更大的模型”并不能直接解决。

先说结论, 来自工程实践中的关键启发:

模型并不是越大越好,Qwen Coder 3B/7B已足够胜任任务

我们尝试了多个模型:

  • Qwen 1.7B:参数过小小导致代码生成能力弱

  • Qwen2.5 Coder 3B & 7B:专为代码/SQL任务设计,结果优秀,微调后准确率达到 0.81 Execution Accuracy

这个结果已经超过了同等结构的SOTA方法(如RoBERTa + T5-3B组合),而且显著减少了部署成本。

✅ 结论:使用精调后的中型模型(3B-7B)已能解决大部分真实SQL生成任务。

Schema Linking 比模型大小更关键

很多真实数据库(如金盘数据库)存在如下问题:

  • 字段名不可读(如 VBELN, ZZHYYH)

  • 字段之间没有明确注释

  • 多张表字段重复,关联复杂

这时候,如果不先过滤schema,大模型也会“幻觉”严重,因为注意力被不相关字段稀释。

我们尝试了:

  • 简单DIN-SQL式的Schema Linking [1](https://arxiv.org/abs/2304.11015)

  • 强化版RESDSQL交叉编码器 + 列增强层 [2](https://arxiv.org/abs/2302.05965)

效果立竿见影,准确率从 0.44 → 0.81,说明大模型“理解错误”更多是输入结构的问题。

✅ 结论:场景理解靠结构优化(如schema linking),而不是盲目加参数。

训练样本设计、注释、示例数据远比模型大小重要

在对金盘等工业数据库做训练时,我们发现:

  • 表/列名没信息,靠注释

  • 不提供字段值样例,模型不知字段用途

  • 用户问题表达差异大,golden SQL却一样

我们通过:

  • 引入字段注释

  • 注入字段样例

  • 打乱schema顺序增强泛化

  • 构造不同表达相同SQL的样本

在没有换更大模型的前提下,准确率显著提升。

✅ 结论:训练数据质量和构造方式决定了最终效果。

“大模型 + 幻觉 + JOIN滥用”反而是风险

在没有schema linking的情况下,大模型非常容易:

  • 随意JOIN多张表

  • 忽略限制条件(distinct、只返回某一列)

  • 理解模糊表达错误,生成语义不符的SQL

反而小一点、结构清晰的模型,表现更稳定可靠。

回到问题:搭建NL2SQL系统需要大模型吗?

结论是:

❌ 不需要SOTA级别的大模型(70B+)才能做好NL2SQL。 ✅ 需要的是:

  • 良好的schema linking策略

  • 高质量的训练样本

  • 合理的prompt设计与数据增强

  • 中等规模、代码能力强的模型(如Qwen2.5 Coder 3B/7B)

展望

未来的NL2SQL系统,更像是一个结构化的“智能Agent”:

  • 能理解用户问题意图

  • 能快速筛选schema

  • 能学习约束和偏好

  • 能精准生成SQL并自我验证

而不是一个越大越好的“语言模型”。如果你也在搭建自己的NL2SQL系统,不妨先别上来就调用GPT-4或GPT-4o,先试试把schema理清楚,再加点样例数据,然后用一个3B模型看看效果——说不定,已经足够用了。

NL2SQL智能体搭建教程:自然语言提问,自动生成SQL查数|含Demo详解 用户用自然语言输入数据集相关的各类问题,如“利润最高的产品是哪一个?”“去年销量最高的产品是?”“去年整年哪个省份的销售额最高”等,点击“开始运行”即可收获结果。你不需要写任何后端代码,只需配置好节点逻辑,就能复现核心能力。这些练习不仅让系统更智能、更贴近实际业务,也帮你建立起迁移能力 —— 能将方法应用到自己的数据分析、报表问答、运营监控等场景中。通过“获取当前时间”代码节点,动态注入今天日期,帮助大模型正确理解“今年”“这个月”等相对时间。这个Demo并不是“照抄即用”的模版,课程还特别设计了一组。 阅读详情

相关推荐

NL2SQL基础系列(1):业界顶尖排行榜、权威测评数据集及LLM大模型(Spider vs BIRD)全面对比优劣分析[Text2SQL、Text2DSL]

NL2SQL基础系列(1):业界顶尖排行榜、权威测评数据集及LLM大模型(Spider vs BIRD)全面对比优劣分析[Text2SQL、Text2DSL]

丨汀、的博客 1万+

一篇大模型NL2SQL全栈技术最新综述

理解自然语言查询:首先理解用户的意图,识别NL中的关键部分,例如实体或属性、时间上下文和特定条件。链接数据库架构和检索内容:基于对NL的理解,检查数据库架构和内容,识别生成SQL所需的相关表、列和单元格值。将NL意图转换为SQL:最后,根据对NL和数据库概念的理解,编写相应的SQL查询。

m0_59235699的博客 1万+

NL2SQL基础系列(2):主流大模型与微调方法精选集,Text2SQL经典算法技术回顾七年发展脉络梳理

NL2SQL基础系列(2):主流大模型与微调方法精选集,Text2SQL经典算法技术回顾七年发展脉络梳理

丨汀、的博客 5489

大模型时代的NL2SQL初探

在当今信息化时代,数据库已成为各行各业的数据存储核心。然而,直接使用SQL(结构化查询语言)进行数据库查询,对许多缺乏专业技术背景的用户而言存在一定门槛。为此,NL2SQL(Natural Language to SQL)技术应运而生,旨在将自然语言转换为SQL查询,使用户能够以自然语言与数据库交互。

今晚打老虎的专栏 3280

NL2SQL技术方案系列(1):NL2API、NL2SQL技术路径选择;LLM选型与Prompt工程技巧,揭秘项目落地优化之道

NL2SQL技术方案系列(1):NL2API、NL2SQL技术路径选择;LLM选型与Prompt工程技巧,揭秘项目落地优化之道

丨汀、的博客 3411

NL2SQL技术方案系列(3):大模型工具调用实战NL2API技术方案以及行业案例讲解1

NL2SQL技术方案系列(3):大模型工具调用实战NL2API技术方案以及行业案例讲解1

丨汀、的博客 1986

NL2SQL调研

将用户的自然语言查询(NL)转换为 SQL 查询可以显著降低访问关系数据库的障碍,并支持各种商业应用。随着大语言模型(LLMs)的出现,NL2SQL 的性能得到了极大提高。在这种情况下,评估当前文本转 SQL 的转换、确定从业者针对特定场景应采用的 NL2SQL 解决方案以及确定研究人员接下来应探索的研究主题至关重要。

m0_57280180的博客 1573

NL2SQL技术方案系列(2):全系列技术选型完整版:从通用技术选型(向量、图数据库)、大模型选择、Prompt工程、前沿技术方案展示

NL2SQL技术方案系列(2):全系列技术选型完整版:从通用技术选型(向量、图数据库)、大模型选择、Prompt工程、前沿技术方案展示

丨汀、的博客 3527

NL2SQL的发展

前言 NL2SQL(Natural Language to SQL)是一项将用户的自然语句转为可执行 SQL 语句的技术,有很大的实际应用价值,对改善用户与数据库之间的交互方式有很大意义。在本文中,追一科技介绍了 NL2SQL 的价值,及其过去、现在与未来,希望能有更多关于 NL2SQL 的落地场景研究。 NL2SQL 的价值 在 AI、区块链、IoT、AR 等高新技术飞速发展的当下,数据库...

baidu_33512336的博客 8674

NL2SQL技术方案系列(4):金融领域NL2SQL技术方案以及行业案例实战讲解2

NL2SQL技术方案系列(4):金融领域NL2SQL技术方案以及行业案例实战讲解2

丨汀、的博客 1391

NL2SQL技术方案系列(5):金融领域NL2SQL技术方案以及行业案例实战讲解3--非LLM技术方案

NL2SQL技术方案系列(5):金融领域NL2SQL技术方案以及行业案例实战讲解3--非LLM技术方案

丨汀、的博客 1269

NL2SQL:基于LLM的解决方案是最好的吗?

【一一AGI大模型学习 所有资源获取处(无偿领取)一一】所有资料 ⚡️ ,朋友们如果有需要全套 《

chengxuyuanyy的博客 2544

NL2SQL技术方案系列(6):金融领域知识检索,NL2SQL技术方案以及行业案例实战讲解4

NL2SQL技术方案系列(4):金融领域知识检索,NL2SQL技术方案以及行业案例实战讲解4

丨汀、的博客 1165

自然语言问数系统(NL2SQL)

总的来说,构建NL2SQL系统是一个在“智能”与“可控”之间寻求平衡的过程。对于快速验证和简单场景,MindSQL或Chat2DB是不错的起点。若追求高精度和可控性,尤其在复杂企业环境中,推荐采用DB-GPT框架,并借鉴NL2DSL2SQL的架构思想引入语义层。无论选择哪条路径,严格的后端安全校验(Guard层)都是不可或缺的底线。

分享python,大模型,人工智能,机器学习相关的内容 1423

✨使用 vLLM + Docker 部署 Qwen3-Embedding-8B 并实现高效文本向量生成(附 `curl` 测试)

本文介绍了如何使用 vLLM 和 Docker 部署 Qwen3-Embedding-8B 嵌入模型服务,并通过标准 OpenAI 兼容接口进行调用和结果解析。如果你在部署中遇到任何问题,欢迎留言讨论!

用大模型重构生活:猫奴程序员的AI智能日常记录 6243

SQL注入:联合查询的三个绕过技巧

在SQL注入中,可以利用科学计数法来绕过对输入的限制。例如,可以使用科学计数法来绕过对字符串长度的限制,通过将字符串拆分成多个部分并使用科学计数法来表示。此外,还可以利用数据库的特定特性或语法来替代原始的查询语句,从而执行联合查询或其他恶意操作。另外,还可以尝试利用无列名注入的技巧,通过在原始查询中使用通配符或其他方式来绕过对列名的限制,从而执行恶意操作。

qq_68163788的博客 3795

NL2SQL 落地怎么选?四条技术路线讲清楚

NL2SQL(Natural Language to SQL)是指将用户的自然语言问题自动转换为可执行的 SQL 查询语句的技术。这是当下大模型在企业数据场景中最热门、也最具落地价值的应用方向之一。然而,NL2SQL 看似简单(“把话变成 SQL”),实际落地时却面临巨大挑战:企业数据表动辄成百上千张,字段命名五花八门(英文缩写、拼音、业务黑话),表间关联关系复杂,业务口径千差万别——“销售额”在不同部门可能有完全不同的定义。为了应对这些复杂性,业界从工程架构和技术演进两个维度,演化出多条技术路线。

secretWHD的博客 560

Auto.js实战:从解锁手机到自动阅读的全流程避坑指南(MIUI系统适配版)

本文详细介绍了Auto.js在MIUI系统下的自动化操作全流程优化指南,包括设备唤醒、应用启动、界面交互等关键环节的实战技巧。特别针对MIUI系统的变速检测机制和电源管理策略,提供了有效的避坑方案和性能优化建议,帮助开发者实现从解锁手机到自动阅读的稳定运行。

醉三国 247

LLMs之Text2SQL:《A Survey of NL2SQL with Large Language Models: Where are we, and where are we going?》

​ LLMs之Text2SQL:《A Survey of NL2SQL with Large Language Models: Where are we, and where are we going?》翻译与解读 目录 《A Survey of NL2SQL with Large Language Models: Where are we, and where are we going?》翻译与解读 Abstract

头部AI社区如有邀博主AI主题演讲请私信—心比天高,仗剑走天涯,保持热爱,奔赴向梦想!低调,专注,谦虚,自律,反思,成长,还算比较正能量的博主,公益免费传播…内心特别想在AI界做出一些可以推进历史进程影响力的技术(兴趣使然,有点小情怀,也有点使命感呀 2617

自动驾驶领域自动化数据标注应用

自动驾驶领域自动化数据标注应用 1. 背景介绍 1.1 自动驾驶技术的发展 自动驾驶技术近年来取得了长足的进步,吸引了众多科技公司和传统车企的投入。自动驾驶系统需要感知周围环境、做出决策并控制车辆,是一个极具挑战的任务。其中,环境感知是自

AI天才研究院 2215

ATS Request中的PASID的作用是什么

摘要: PASID(进程地址空间标识符)是PCIe ATS(地址转换服务)中的关键组件,用于标识不同进程或虚拟机的地址空间。其主要作用包括:1)支持多进程共享设备时隔离地址空间;2)实现共享虚拟地址(SVA),允许用户态程序直接访问设备;3)提升虚拟化性能(如SIOV),通过PASID区分虚拟机请求;4)增强安全性,基于PASID限制设备内存访问权限。PASID通过20位标识符在TLP前缀中传递,与IOMMU协作完成地址转换与缓存,适用于高性能计算、AI及虚拟化场景,但依赖硬件支持和软件适配。

元直的博客 1562

NL2SQL 落地怎么选?四条技术路线一张图讲透(附安全实践)

本文系统梳理了自然语言转SQL(NL2SQL)的四条主流技术路线: 1)大模型直出(LLM2SQL)速度快但稳定性差; 2)模板规则(DSL2SQL)通过填槽方式保证稳定可控; 3)指标语义层(MQL2SQL)实现口径统一; 4)逻辑计划(LP2SQL)实现业务逻辑与物理存储解耦。 文章详细分析了各路线优缺点、适用场景及代表产品,指出选型需综合考虑冷启动速度、治理难度和企业级需求。目前BIRD基准的SOTA模型准确率约70-80%,实际落地需重点解决权限控制、SQL注入防

secretWHD的博客 451

西门子S7-1200PLC控制步进电机的组态编程和具体步骤

西门子S7-1200PLC控制步进电机的组态编程和具体步骤 硬件准备: 1) 一个S7-1214C DC/DC/DC,订货号:6ES7 214-1AG40-0XB0 2) 一个86系的步进电机+相应的驱动器 3) 一个20A的西门子24V电源(步进驱动器及plc电源) 4) Portal V15版本 组态及编程: 1) 创建一个验证项目,添加cpu( S7-1214C),双击“工艺对象”,选择“运动控制”的TO_PositioningAxis V6.0版本,如下图所示: 2) “确定”后,系统自动生成名

Robot_PLC_HMI_Automation 1万+
上一篇: MatrixOne存储优化:HTAP场景下的智能存储优化策略
下一篇: 技术解读|MatrixOne高效 CDC:基于快照的分布式数据库优化方案
MatrixOrigin
博客等级 码龄5年 708粉丝 230原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值