Apache Solr 中文分词

solr中文分词器 立即下载
中文分词 (Chinese Word Segmentation) 指的是将一个汉字序列切分成一个一个单独的词。分词就是将连续的字序列按照一定的规范重新组合成词序列的过程。我们知道,在英文的行文中,单词之间是以空 格作为自然分界符的,而中文只是字、句和段能通过明显的分界符来简单划界,唯独词没有一个形式上的分界符,虽然英文也同样存在短语的划分问题,不过在词这 一层上,中文比之英文要复杂的多、困难的多。
             存在中文分词技术是由于中文在基本文法上有其特殊性,具体表现在:
             1.与英文为代表的拉丁语系语言相比,英文以空格作为天然的分隔符,而中文由于继承自古代汉语的传统,词语之间没有分隔。 古代汉语中除了连绵词和人名地名等,词通常就是单个汉字,所以当时没有分词书写的必要。而现代汉语中双字或多字词居多,一个字不再等同于一个词。
             2.在中文里,“词”和“词组”边界模糊
             现代汉语的基本表达单元虽然为“词”,且以双字或者多字词居多,但由于人们认识水平的不同,对词和短语的边界很难去区分。
             例如:“对随地吐痰者给予处罚”,“随地吐痰者”本身是一个词还是一个短语,不同的人会有不同的标准,同样的“海上”“酒厂”等等,即使是同一个人也可能做出不同判断,如果汉语真的要分词书写,必然会出现混乱,难度很大。
             中文分词的方法其实不局限于中文应用,也被应用到英文处理,如手写识别,单词之间的空格就很清楚,中文分词方法可以帮助判别英文单词的边界。
           
           中文分词对于搜索引擎来说,最重要的并不是找到所有结果,因为在上百亿的网页中找到所有结果没有太多的意义,没有人能看得完,最重要的是把最相关的结果排 在最前面,这也称为相关度排序。中文分词的准确与否,常常直接影响到对搜索结果的相关度排序。从定性分析来说,搜索引擎的分词算法不同,词库的不同都会影 响页面的返回结果

            常见的开源中文分词技术主要有
         

智呈分词


  功能性能
功能描述:
1.新词自动识别
对词典中不存在的词,可以自动识别,对词典的依赖较小;
2.词性输出
分词结果中带有丰富的词性;
3.动态词性输出
分词结果中的词性并非固定,会根据不同的语境,赋予不同的词性;
4.特殊词识别
比如化学、药品等行业词汇,地名、品牌、媒体名等;
5.智能歧义解决
根据内部规则,智能解决常见分词歧义问题;
6.多种编码识别
自动识别各种单一编码,并支持混合编码;
7.数词量词优化
自动识别数量词;
性能介绍:
处理器:AMD Athlon II x2 250 3GHZ
单线程大于833KB/s,多线程安全。

MFSOU中文分词PHP扩展

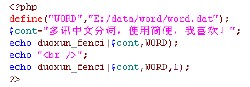
一个PHP函数实现中文分词。使分词更容易,使用如下图:
SCWS调用示例搜索引擎之阿堂Solr学习笔记系列2(基础篇:中文分词)
SCWS

Hightman 开发的一套基于词频词典的机械中文分词引擎,它能将一整段的汉字基本正确的切分成词。采用的是采集的词频词典,并辅以一定的专有名称,人名,地名,数字年 代等规则识别来达到基本分词,经小范围测试大概准确率在 90% ~ 95% 之间,已能基本满足一些小型搜索引擎、关键字提取等场合运用。45Kb左右的文本切词时间是0.026秒,大概是1.5MB文本/秒,支持PHP4和 PHP 5。

FudanNLP

FudanNLP主要是为中文 自然语言处理而开发的工具包,也包含为实现这些任务的 机器学习算法和数据集。本工具包及其包含数据集使用LGPL3.0许可证。开发语言为Java。功能包括中文分词等,不需要字典支持。

ICTCLAS

这 是最早的中文开源分词项目之一,ICTCLAS在国内973专家组组织的评测中活动获得了第一名,在第一届国际中文处理研究机构SigHan组织的评测中 都获得了多项第一名。ICTCLAS3.0分词速度单机996KB/s,分词精度98.45%,API不超过200KB,各种词典数据压缩后不到 3M.ICTCLAS全部采用C/C++编写,支持Linux、FreeBSD及Windows系列 操作系统,支持C/C++、C#、Delphi、Java等主流的开发语言。

HTTPCWS

HTTPCWS 是一款基于 HTTP协议的开源中文分词系统,目前仅支持Linux系统。HTTPCWS 使用“ICTCLAS 3.0 2009共享版中文分词算法”的API进行分词处理,得出分词结果。HTTPCWS 将取代之前的 PHPCWS 中文分词扩展。

CC-CEDICT

一个中文词典开源项目,提供一份以汉语拼音为中文辅助的汉英辞典,截至2009年2月8日,已收录82712个单词。其词典可以用于中文分词使用,而且不存在版权问题。Chrome中文版就是使用的这个词典进行中文分词的。

IK

IKAnalyzer是一个开源的,基于 java语言开发的轻量级的中文分词工具包。从2006年12月推出1.0版开始, IKAnalyzer已经推出了3个大版本。最初,它是以开源项目Luence为应用主体的,结合词典分词和文法分析算法的中文分词组件。新版本的IKAnalyzer3.0则发展为面向Java的公用分词组件,独立于Lucene项目,同时提供了对Lucene的默认优化实现。

Paoding

Paoding(庖丁解牛分词)基于Java的开源中文分词组件,提供lucene和solr 接口,具有极  高效率和  高扩展性。引入隐喻,采用完全的 面向对象设计,构思先进。
高效率:在PIII 1G内存个人机器上, 1秒可准确分词  100万汉字。
采用基于  不限制个数的词典文件对文章进行有效切分,使能够将对词汇分类定义。
能够对未知的词汇进行合理解析。
仅支持 Java语言。

MMSEG4J

MMSEG4J基于Java的开源中文分词组件,提供lucene和solr 接口:
1.mmseg4j 用 Chih-Hao Tsai 的 MMSeg 算法实现的中文分词器,并实现 lucene 的 analyzer 和 solr 的TokenizerFactory 以方便在Lucene和Solr中使用。
2.MMSeg 算法有两种分词方法:Simple和Complex,都是基于正向最大匹配。Complex 加了四个规则过虑。官方说:词语的正确识别率达到了 98.41%。 mmseg4j 已经实现了这两种分词算法。

盘古分词

盘古分词是一个基于.net 平台的开源中文分词组件,提供lucene(.net 版本) 和HubbleDotNet的接口
高效:Core Duo 1.8 GHz 下单线程 分词速度为 390K 字符每秒
准确:盘古分词采用字典和统计结合的分词算法,分词准确率较高。
功能:盘古分词提供中文人名识别,简繁混合分词,多元分词,英文词根化,强制一元分词,词频优先分词, 停用词过滤,英文专名提取等一系列功能。

Jcseg

jcseg是使用Java开发的一个中文分词器,使用流行的mmseg算法实现。 [3]  
1。mmseg四种过滤算法,分词准确率达到了98.4%以上。
2。支持自定义词库。在lexicon文件夹下,可以随便添加/删除/更改词库和词库内容,并且对词库进行了分类,词库整合了《现代汉语词典》和cc-cedict辞典。
3。词条拼音和同义词支持,jcseg为所有词条标注了拼音,并且词条可以添加同义词集合,jcseg会自动将拼音和同义词加入到分词结果中。
4。中文数字和分数识别,例如:"四五十个人都来了,三十分之一。"中的"四五十"和"三十分之一",并且jcseg会自动将其转换为对应的阿拉伯数字。
5。支持中英混合词的识别。例如:B超,x射线。
6。支持基本单字单位的识别,例如2012年。
7。良好的英文支持,自动识别电子邮件,网址,分数,小数,百分数……。
8。智能圆角半角转换处理。
9。特殊字母识别:例如:Ⅰ,Ⅱ
10。特殊数字识别:例如:①,⑩
11。配对标点内容提取:例如:最好的Java书《java编程思想》,‘畅想杯黑客技术大赛’,被《,‘,“,『标点标记的内容。
12。智能中文人名识别。中文人名识别正确率达94%以上。
jcseg佩带了jcseg.properties配置文档,使用文本编辑器就可以自主的编辑其选项,配置适合不同应用场合的分词应用。例如:最大匹配分词数,是否开启中文人名识别,是否载入词条拼音,是否载入词条同义词……。

friso

friso是使用c语言开发的一个中文分词器,使用流行的mmseg算法实现。完全基于模块化设计和实现,可以很方便的植入到其他程序中,例如:MySQL,PHP等。并且提供了一个php中文分词扩展robbe。
1。只支持UTF-8编码。【源码无需修改就能在各种平台下编译使用,加载完20万的词条,内存占用稳定为14M。】。
2。mmseg四种过滤算法,分词准确率达到了98.41%。
3。支持自定义词库。在dict文件夹下,可以随便添加/删除/更改词库和词库词条,并且对词库进行了分类。
4。词库使用了friso的Java版本jcseg的简化词库。
5。支持中英混合词的识别。例如:c语言,IC卡。
7。很好的英文支持,电子邮件,网址,小数,分数,百分数。
8。支持阿拉伯数字基本单字单位的识别,例如2012年,5吨,120斤。
9。自动英文圆角/半角,大写/小写转换。
并且具有很高的分词速度:简单模式:3.7M/秒,复杂模式:1.8M/秒。
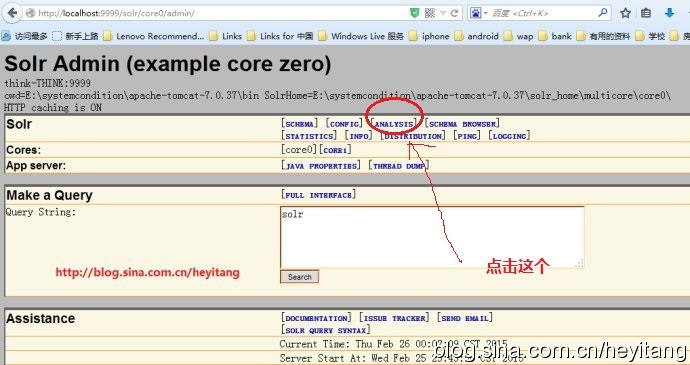
     Ok,上面说了这么多,下面阿堂以一个IKAnlyzer中文分词演示一下

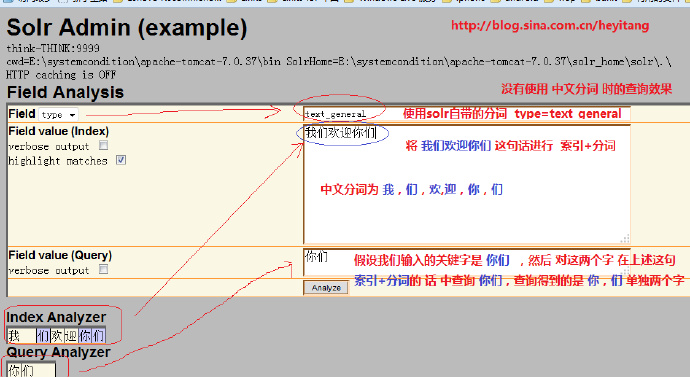
      首先,我以solr自带的英文分词技术进行测试

    搜索引擎之阿堂Solr学习笔记系列2(基础篇:中文分词)

搜索引擎之阿堂Solr学习笔记系列2(基础篇:中文分词)

         通过上面阿堂的测试,很显然solr自带的分词type解析查询是不准确的,对中文词语分词不准确,句子中的每一个字都分成一个词了。

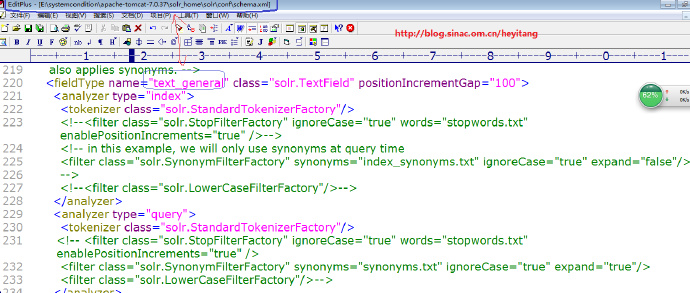
            E:\systemcondition\apache-tomcat-7.0.37\solr_home\solr\conf\schema.xml   ( text_general对应的type配置在schema.xml文件中)

          上面对应的 text_general具体描述如下

搜索引擎之阿堂Solr学习笔记系列2(基础篇:中文分词)


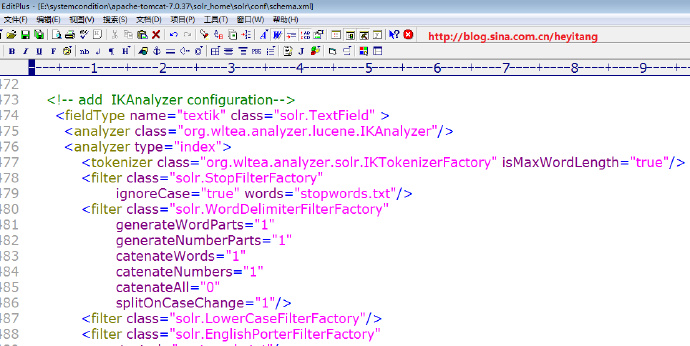
         然后,我在       E:\systemcondition\apache-tomcat-7.0.37\solr_home\solr\conf\schema.xml,文件中增加 fieldType=textik   (当然还要在sorl对应的web项目的 E:\systemcondition\apache-tomcat-7.0.37\webapps\solr\WEB-INF\lib 目录下,放置 IKAnalyzer.jar 包,我在上篇文章  基础篇:安装篇 中 已经提到了,这里就不重复了)
    
    搜索引擎之阿堂Solr学习笔记系列2(基础篇:中文分词)


      〈fieldType name="textik" class="solr.TextField" > 
      〈analyzer class="org.wltea.analyzer.lucene.IKAnalyzer"/>   
        〈analyzer type="index">   
          〈tokenizer class="org.wltea.analyzer.solr.IKTokenizerFactory" isMaxWordLength="true"/>   
           〈filter class="solr.StopFilterFactory"   
                    ignoreCase="true" words="stopwords.txt"/>   
            〈filter class="solr.WordDelimiterFilterFactory"   
                    generateWordParts="1"   
                    generateNumberParts="1"   
                    catenateWords="1"   
                    catenateNumbers="1"   
                    catenateAll="0"   
                    splitOnCaseChange="1"/>   
            〈filter class="solr.LowerCaseFilterFactory"/>   
            〈filter class="solr.EnglishPorterFilterFactory"   
                protected="protwords.txt"/>   
            〈filter class="solr.RemoveDuplicatesTokenFilterFactory"/>   
        〈/analyzer>
        〈analyzer type="query">   
            〈tokenizer class="org.wltea.analyzer.solr.IKTokenizerFactory" isMaxWordLength="true"/>   
           〈!--
          〈filter class="solr.StopFilterFactory"   
                    ignoreCase="true" words="stopwords.txt"/>   
            〈filter class="solr.WordDelimiterFilterFactory"   
                    generateWordParts="1"   
                    generateNumberParts="1"   
                    catenateWords="1"   
                    catenateNumbers="1"   
                    catenateAll="0"   
                    splitOnCaseChange="1"/>
           〈filter class="solr.LowerCaseFilterFactory"/>   
            〈filter class="solr.EnglishPorterFilterFactory"   
                protected="protwords.txt"/>   
           〈filter class="solr.RemoveDuplicatesTokenFilterFactory"/>  --> 
        〈/analyzer>          
     〈/fieldType> 

   
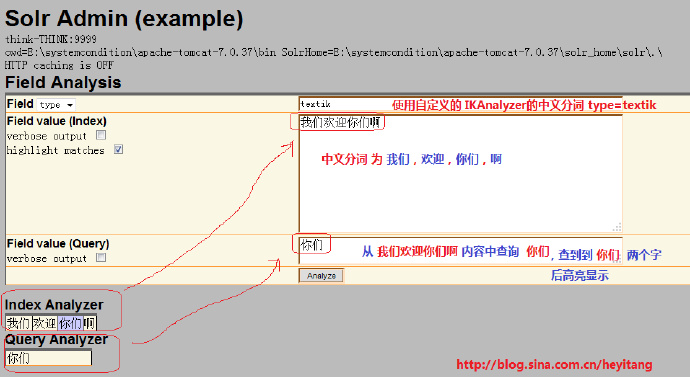
                 然后,停掉tomcat后,再重启 tomcat,继续测试如下
                搜索引擎之阿堂Solr学习笔记系列2(基础篇:中文分词)

         
           从上述测试图中,我们不难看出,阿堂配置的中文分词IKAnalyzer已经完全起到作用了,已经符合我们中文分词的习惯了。 至此,中文分词 IKAnalyzer技术已经成功配置到solr服务器中了。

           如果你理解上述过程后,那么阿堂要恭喜你已经基本掌握使用中文分词技术的使用了。当然,其它开源的中文分词的使用与此完全类似,只是jar包不同,实现类不同罢了。
search_api_solr_nlp 搜索API Solr NLP 立即下载

相关推荐

ROS相机内参标定详细步骤指南

相机标定的目的是为了确定相机内部参数和外部参数,以便修正图像并将图像坐标映射到世界坐标,或者从世界坐标映射到图像坐标。这个过程是计算机视觉和三维感知任务的关键步骤之一,它有以下主要目的: 1. **减小畸变**:相机镜头和传感器可能引入径向和切向畸变,使得图像中的直线变得弯曲或者物体的形状不准确。通过标定相机,可以矫正这些畸变,使图像更准确。

m0_56661101的博客 1万+

Apache Lucene几种分词系统

1、 StopAnalyzer StopAnalyzer能过滤词汇中的特定字符串和词汇,并且完成大写转小写的功能。 2、 StandardAnalyzer StandardAnalyzer根据空格和符号来完成分词,还可以完成数字、字母、E-mail地址、IP地址以及中文字符的分析处理,还可以支持过滤词表,用来代替StopAnalyzer能够实现的过滤功能。 3、 SimpleAnalyzer SimpleAnalyzer具备基本西文字符词汇分析的分词器,处理词汇单元时,以非字母字符作为分割符号。分

GET知识不迷路,点赞评论加关注! 718

Vivado时序违例debug

显示了数据路径延迟。例如,对于违例路径,若布线延迟超过50%,说明该延迟是导致时序不能收敛的主要因素,因此可围绕降低布线延迟这一靶心达到时序收敛。对于跨时钟域路径,Requirement数值会有所变化,但如果数值为0.1,显然是不合理的。目的时钟路径单元,时钟从adc0_bufg/O输出,到达PLLE4_ADV,经过BUFGCE输出,最终到达SRLC32E移位寄存器,对应。源时钟路径单元,时钟从adc0_bufg/O输出,到达PLLE4_ADV,经过BUFGCE输出,最终到达FDRE触发器,对应。

weixin_44513618的博客 1618

Solr系列二:Solr与mmseg4j的整合

mmseg4j是一个很好的中文分词器,solr与mmseg4j的整合也非常简单。如下: 第一步:下载mmseg4j的jar包,网上搜索一下有很多下载地址,如下是csdn上的一个连接:http://download.youkuaiyun.com/detail/nrs12345/6986585 第二步:将下载的mmseg4j-analysis-1.9.1.jar、mmseg4j-core-1.9.1.jar、...

weixin_33725515的博客 118

Duilib的简单使用(五、DuiDesigner/DuiEditor的下载编译)

一、前言 在Duilib的简单使用(一、duilib demo)中我们介绍了利用duilib简单的构造一个项目 在Duilib的简单使用(二、xml实现界面与业务分离)中我们介绍了XML在duilib中的使用 在Duilib的简单使用(三、界面逻辑交互)中我们已经知道如何简单的进行界面的交互 在Duilib的简单使用(四、换肤)中,我们提了一下Duilib强大的一键换肤功能。 通过之前的说明,我们知道duilib是通过xml来分离界面和业务逻辑的,但是xml如果不能预览,那每次敲一个再运行一下看看效果,这不

LyRics1996的博客 2887

避坑指南:STM32H7不同DMA控制器(MDMA/DMA2D/BDMA)到底该用哪个?

本文深入解析STM32H7系列芯片的DMA控制器选型策略,涵盖MDMA、DMA2D、BDMA等不同控制器的架构原理与性能对比。通过实际项目案例,提供高速TCM数据搬运、GUI加速、低功耗传输等场景的选型决策树,并分享性能优化与调试技巧,帮助工程师避开常见陷阱,提升系统效率。

weixin_26876073的博客 447

全文检索引擎Solr系列——整合中文分词组件mmseg4j

http://www.importnew.com/12860.html 全文检索引擎Solr系列——整合中文分词组件mmseg4j 2014/08/28 | 分类: 基础技术, 教程 | 0 条评论 | 标签: SOLR 分享到:8 本文作者: ImportNew - 刘志军 未经许可,禁止转载! 默认Solr提供的分词

xiangbq的博客 1028

Halcon工业相机开发全流程:从SDK配置到实时图像采集(C++版)

本文详细介绍了使用C++进行Halcon工业相机开发的完整流程,从SDK配置到实时图像采集的实现。涵盖环境搭建、设备初始化、回调机制、参数控制等关键环节,并提供异常处理和实战案例,帮助开发者快速掌握工业视觉系统的开发技巧。

weixin_33728268的博客 512

Solr 7 - 中文分词、数据导入、查询 基本使用篇

接着之前的 Solr 7 - CentOS 部署篇 继续 Go! 准备一下 /opt/solr-7.6.0 实际安装目录 /opt/solr 指向实际安装目录的链接 我们先链接一份 solr 命令到 /usr/local/bin 内 ln -s /opt/solr/bin/solr /usr/local/bin/solr 现在我们就能在任何地方使用 solr 命令了 创建 Core 上一篇提到过...

Right! I'm Max Sky. 2005

GLMM(广义线性混合模型)原理以及分析步骤

广义线性混合模型(GLMM)是生态与进化研究中处理非正态数据的定制化工具,能同时分析固定效应和随机效应。它通过链接函数连接响应变量与预测因子,支持二项分布、泊松分布等非正态数据。研究流程包括:明确分析目标(固定效应影响与随机效应方差)、选择合适变量与分布、数据验证、参数估算(需根据模型复杂度选择PQL、拉普拉斯近似等方法)及模型优化(检验过离散与残差,通过信息准则或假设检验筛选最优模型)。GLMM能有效解决传统方法无法处理的"伪重复"和推广性问题,为复杂生物数据提供可靠分析框架。

wewil_lwin的博客 4969

Ubuntu22.04 apt 安装 ROS1 ROS Noetic Ninjemys

ubuntu 22.04 apt-get 安装 ros1 ros Noetic 最新版

autolabor的博客 5万+

solr安装及ik中文分词器配置

Solr 是Apache 下的一个顶级开源项目,采用 Java 开发,它是基于 Lucene 的全文搜索服务器。Solr 提供了比 Lucene 更为丰富的查询语句,同时实现了可配置、可扩展,并对索引、搜索性能进行了优化Solr 可以独立运行,运行在 Jetty、Tomact 等这些 Servlet 容器中,Solr 索引的实现方式很简答,用Post 方法向 Solr 服务器发送一些描述 Field 及其内容的 XML 文档,Solr 根据XML 文档添加、删除、更新索引。

专注于 Java 后端架构、微服务、分布式、前端及 AI 领域的技术分享,是开发者获取硬核知识、交流实战经验的专业博客。 1407

【软考】高项论文写作常见模板

本文主要介绍了YYYY年MM月DD日,我所在公司承接了XXXX项目的建设过程,包括了XXX,XXX,XXX内容,涉及到XXX,XXX,XXX技术。本人在项目中承载着项目经理的角色,主要负责了XXX,XXX,XXX方面事宜。此项目时间紧,任务重,实施过程中,我们特别注重了1、XXX 2、XXX 3、XXX几个方面,经过团队的一致努力,本项目按时交付,运行至今,客户反馈良好。但是在实施过程中,也曝露除了一些问题,包括了XXX,XXX等,通过应急处理和协调,这些问题都得到了妥善解决,没有影响到项目进度。

奶爸的编程之路,也就一周冷个三天 1686

Apache Solr(介绍、安装部署、Java接口、中文分词)

Apache Solr 介绍 Solr 是什么?   Solr 是一个开源的企业级搜索服务器,底层使用易于扩展和修改的Java 来实现。服务器通信使用标准的HTTP 和XML,所以如果使用Solr 了解Java 技术会有用却不是必须的要求。   Solr 主要特性有:强大的全文检索功能,高亮显示检索结果,动态集群,数据库接口和电子文档(Word ,PDF 等)的处理。而且

不了了之专栏 1680

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

Apache Solr单机环境配置(包括中文分词和Java API的使用)

一、使用场景说明 项目中需要实现一个地址查询框,类似于在谷歌地图中输入地址,根据定义的规则实时检索并展现匹配的地址的功能(当然比那简单的多),为了减小数据库压力和提高检索效率,现采用apache solr实现。由于对性能和可靠性可用性等没太高的要求,所以此处没有考虑集群,只是一个简单的单机版环境。 二、概念介绍   三、安装启动和中文分词配置 1、下载solr-4.10.2.zip,解压

小爷,有点狂 3169

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

Apache Solr 4.9上配置IKAnalyzer中文分词插件

文章目录solr的介绍及其安装下载IKAnalyzer安装并配置IKAnalyzer记两个bug solr的介绍及其安装 一句话概括:solr是基于Lucene的Java搜索引擎服务器,其部署要搭配tomcat Solr的介绍及其安装详见:什么是Solr,它能为我们解决什么问题,怎么用? Apache Solr 4.9.0下载:https://pan.baidu.com/s/1Ld1dzt2FQ_xAyom8Yd8ppQ 提取码:tnn2 下载IKAnalyzer 下载IKAnalyzer可以到这个地址

阿坨的博客 545

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

【Apache Solr系列】使用IKAnalyzer中文分词以及自定义分词字典

之前写的Apache Solr只介绍了简单的搭建以及导入数据等功能,最近由于项目要求,添加索引分词和搜索分词功能;分词的项目有包括好几个:

Jonathan.Wei的专栏 7658

Apache Solr 初级教程(介绍、安装部署、Java接口、中文分词)

Python爬虫视频教程零基础小白到scrapy爬虫高手-轻松入门 https://item.taobao.com/item.htm?spm=a1z38n.10677092.0.0.482434a6EmUbbW&id=564564604865 http://outofmemory.cn/code-snippet/3588/Apache-Solr-chuji-course-intr...

weixin_30929195的博客 80

Solr Apache Solr 初级教程(介绍、安装部署、Java接口、中文分词)

2019独角兽企业重金招聘Python工程师标准>>> ...

weixin_34221332的博客 134

Apache Solr 4.9 和 IKAnalyzer中文分词配置(下)

接上一篇:Apache Solr 4.9 和 IKAnalyzer中文分词配置(上) 下一篇:Apache Solr 4.9 和 IKAnalyzer中文分词配置(续)Ubuntu 上的 Drupal 上一次我们成功配置了Solr搜索以及IKAnalyzer的中文分词,但是在IKAnalyzer_2012FF_hf1版本的IKAnalyzer类中没有读取配置中的useSmart属性,所

menghuannvxia的专栏 1303

Apache Solr4 on Windows Tomcat7及中文分词安装

安装环境: Tomcat 7.0.42 http://apache.fayea.com/apache-mirror/tomcat/tomcat-7/v7.0.42/bin/apache-tomcat-7.0.42.exe 安装到C:\Tomcat 7.0 JDK 7u25 http://download.oracle.com/otn-pub/java/jdk/7u25-b17/jdk-7

新手刚入门 879

Spring Boot + Solr

一.首先下载solr 下载路径:http://archive.apache.org/dist/lucene/solr/8.5.0/ 中文分词器下载:在中央仓库中下载对应的版本 ik-analyzer-8.5.0.jar 二.本地安装solr 1.解压solr压缩包 2.进入安装目录(如:E:\config\solr\solr-8.5.0\server\solr),创建自己的索引库(如:文件夹myInventoryCore) 3.添加索引库的配置文件,将E:\config\solr\solr-8.5.0\s

weixin_45267345的博客 3291

Apache Solr 实践(一)solr在Tomcat中部署部署及中文分词配置

之前看过Lucen方面的资料,但是一直没机会使用,也就没深入。当时觉得中文分词效果一直不理想,也尝试过几个开元插件,IK,paoding... 直到去年因项目需要,开始了解Lucen的封装框架Solr,同时实践了中科院分词的Java开元版本imdict-chinese-analyzer ,效果很好。以下是实践的过程,solr版本为4.3.0 第一步按照http://wiki.apache.o...

shuaizhuaidym的专栏 223
上一篇: Apache Solr 查询参数
下一篇: Python 操作MySQL中文显示乱码的解决方法
CallMeJiaGu
博客等级 码龄12年 149粉丝 99原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值