TeraData Basics

Teradata到GBase 8a迁移总结 阅读详情

TeraData Basics

持续更新中。。
插图画得很辛苦

1. Basic concept

1.1 Parallel Processing
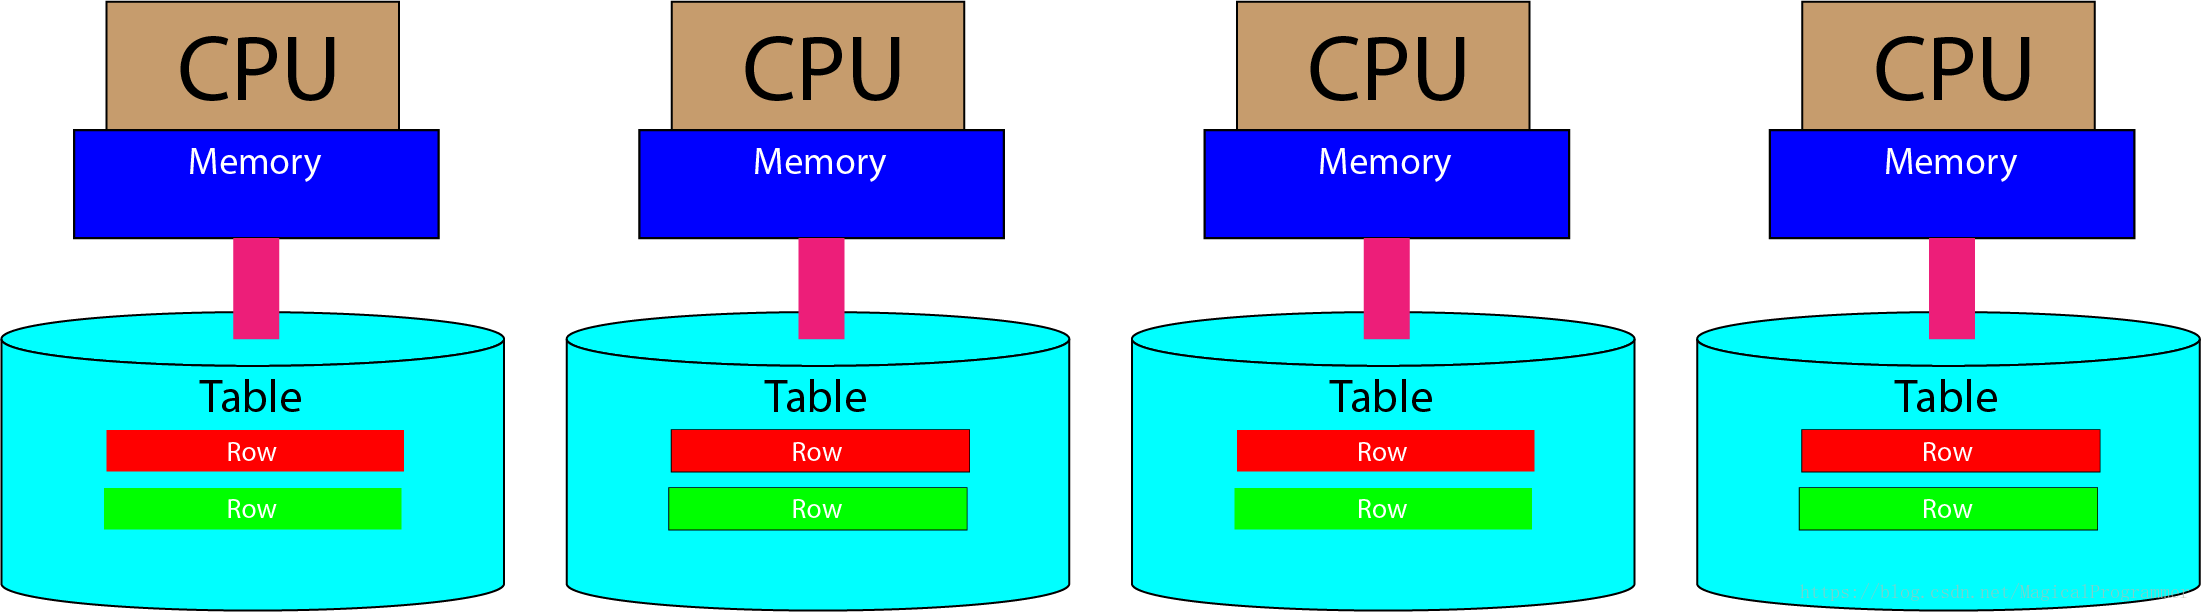
001

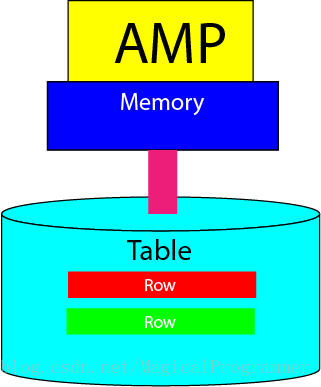
AMP(Access Module Processor)

002

1.2 Linear Scalability

All Teradata tables are spread across ALL AMPs
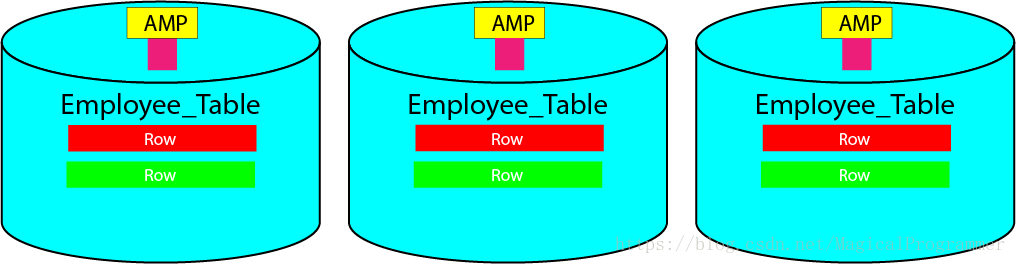
003

3. Four Different Primary Indexes

3.1 UPI

CREATE TABLE Employee_Table
( Employee_No       INTEGER
 ,Last_Name         CHAR(20)
 ,Mgr_No            VARCHAR(12)
 ,Salary            Decimal(10,2)
) UNIQUE PRIMARY INDEX(Employee_No)

Teradata hashes UPI to distribute the date to all the AMPs evenly

3.2 NUPI

CREATE TABLE Employee_Intl
( Employee_No       INTEGER
 ,Dept_No           INTEGER
 ,Last_Name         CHAR(20)
 ,Salary            Decimal(10,2)
) PRIMARY INDEX(Dept_No)

Teradata distributes same NUPI into one AMPs, normally unevenly

3.3 Multi-Column Primary Index

Apply to both UPI & NUPI

CREATE TABLE Employee_Intl
( Employee_No       INTEGER
 ,Dept_No           INTEGER
 ,First_Name        CHAR(10)
 ,Last_Name         CHAR(20)
 ,Salary            Decimal(10,2)
) PRIMARY INDEX(First_Name,Last_Name)

Where write query, you need to combine the multi-column primary index, in order to get single AMP retrieving.

SELECT FROM Employee_Intl WHERE First_Name = '' AND Last_Name = '';

3.4 No Primary Index Tables

Random distribution, which is always even.

CREATE TABLE Employee_Intl
( Employee_No       INTEGER
 ,Dept_No           INTEGER
 ,First_Name        CHAR(10)
 ,Last_Name         CHAR(20)
 ,Salary            Decimal(10,2)
) PRIMARY INDEX(First_Name,Last_Name)

When execute the query, it will do a full table scan, usually for staging, which makes loading data faster.

Or use it for Columnar design

CREATE TABLE Employee_Columnar
( Employee_No       INTEGER
 ,Dept_No           INTEGER
 ,First_Name        CHAR(10)
 ,Last_Name         CHAR(20)
 ,Salary            Decimal(10,2)
) No Primary Index
Partition By Column
  • must be a NoPI table
  • COLUMN keyword

4. Nodes

4.1 SMP Node

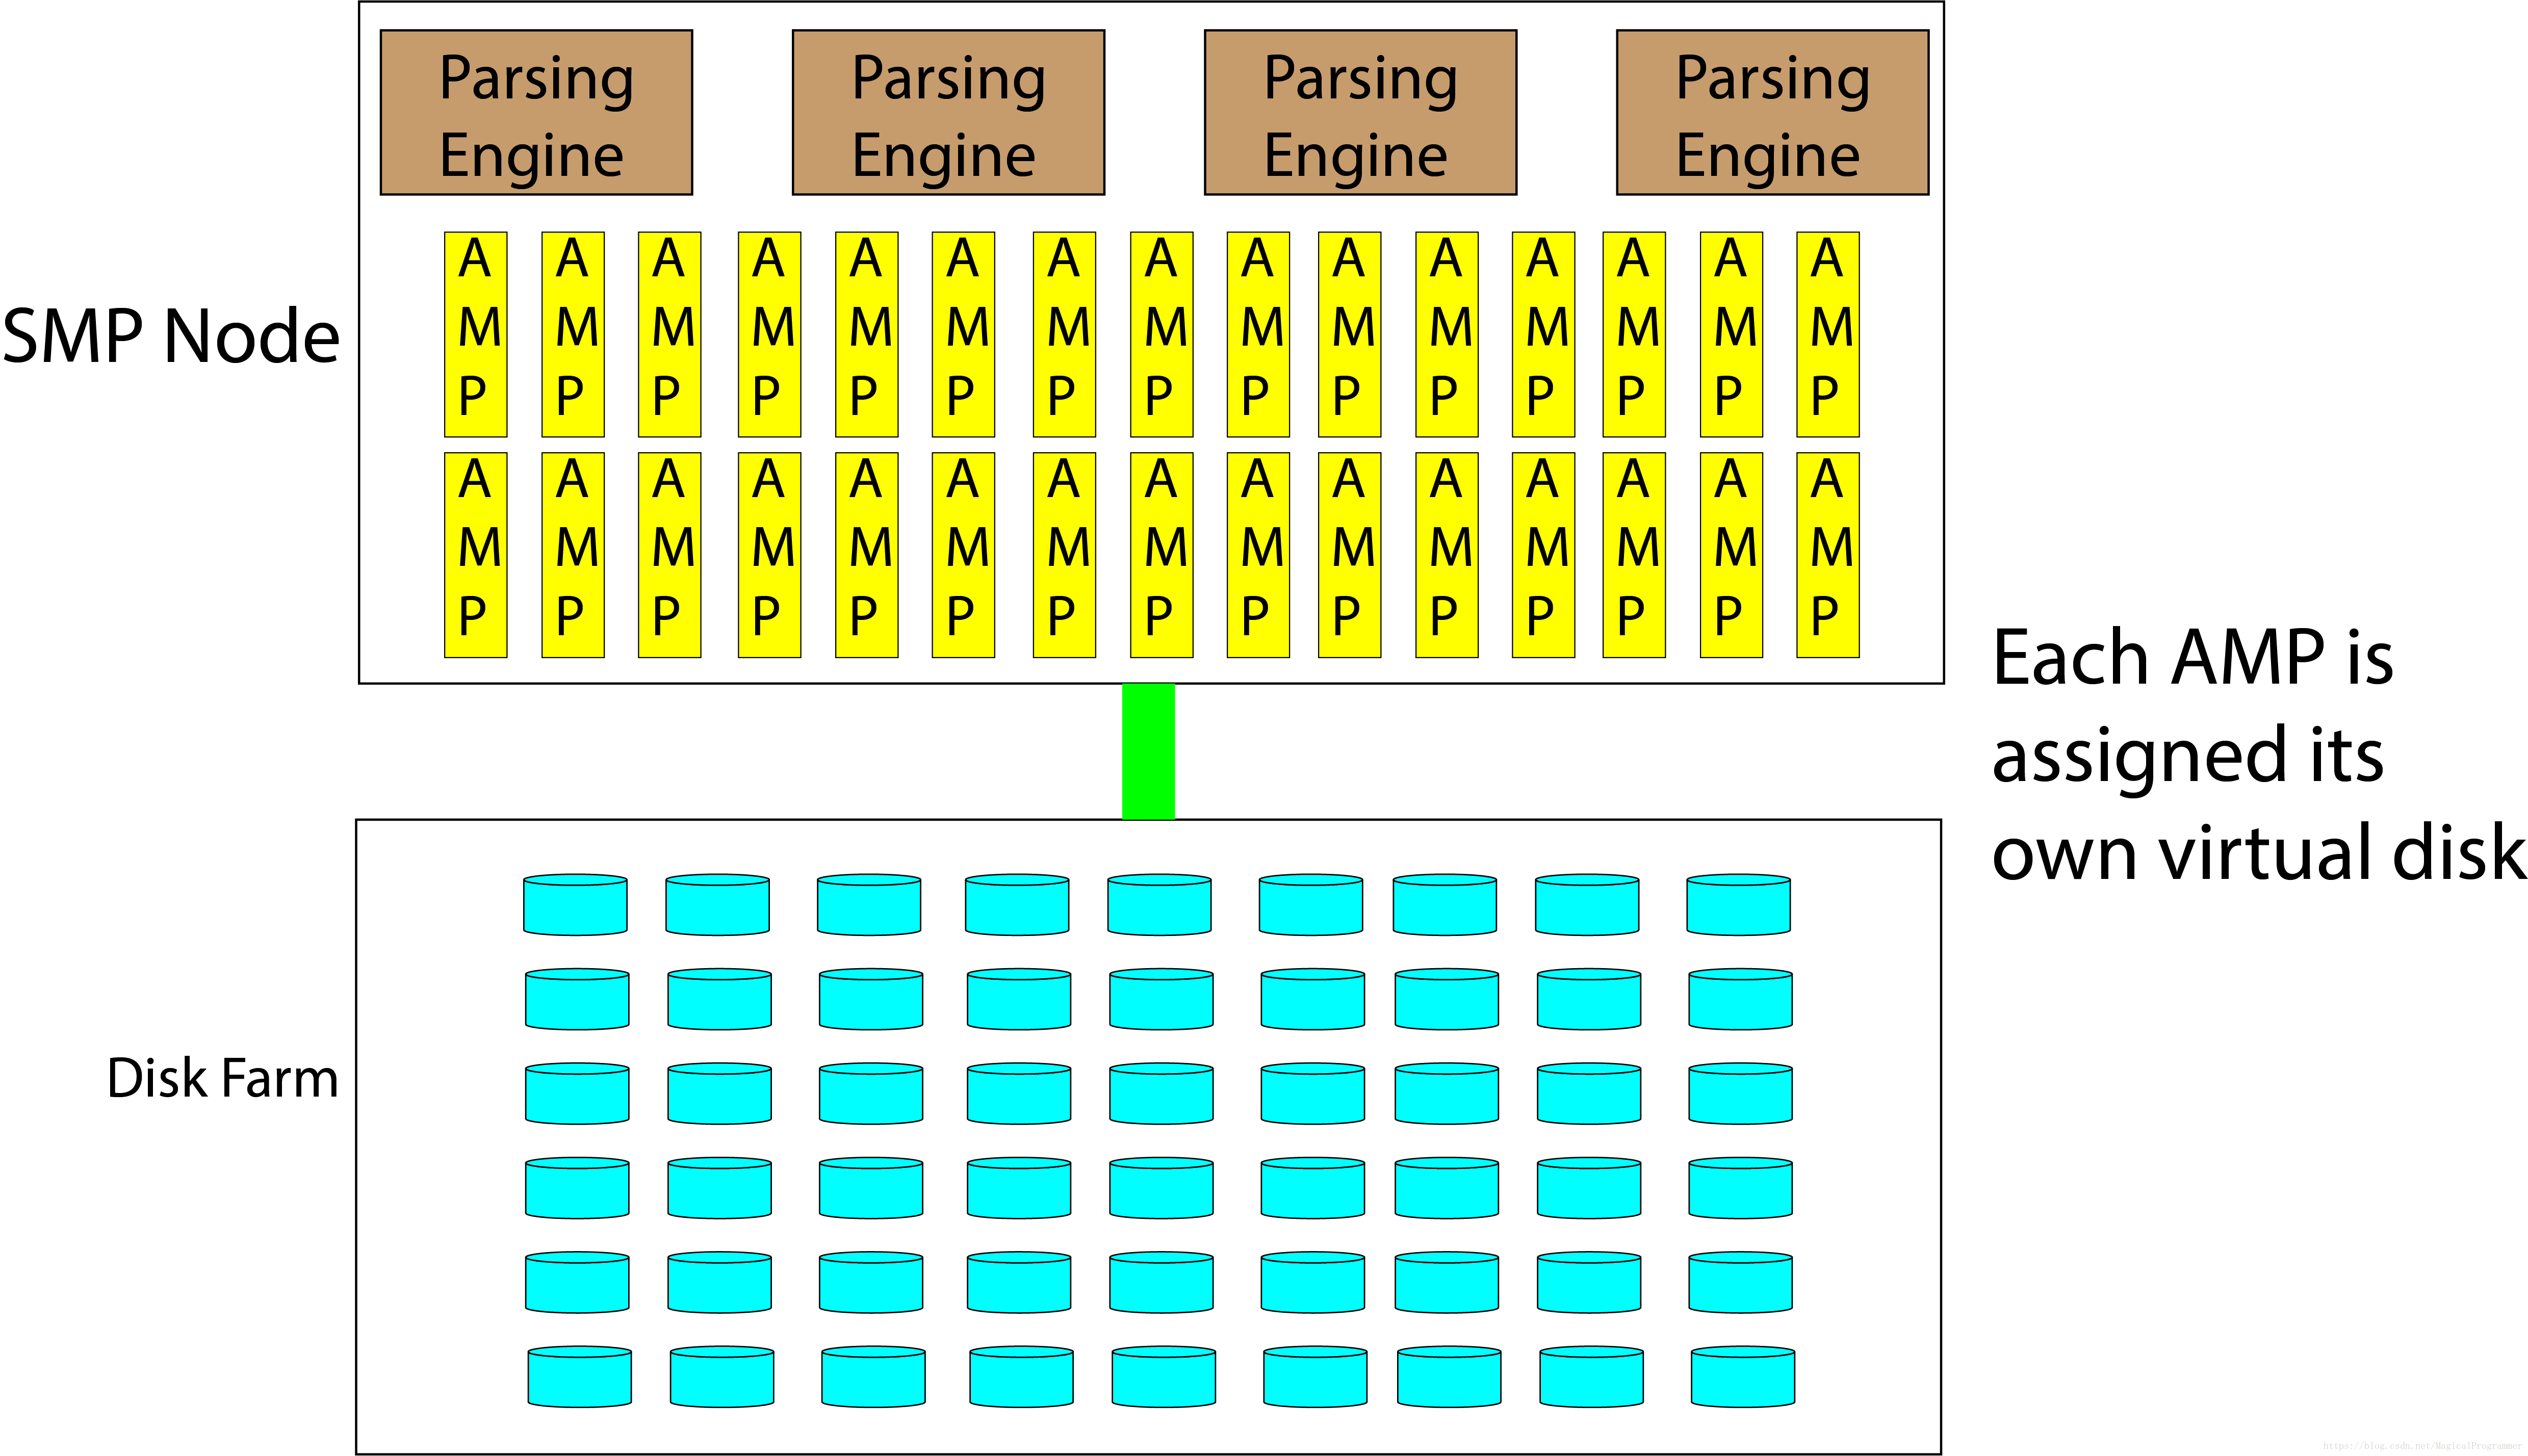
AMPs and Parsing Engines live inside SMP (Symmetric Multi-Processing) Nodes
004

AMPs share nothing, each of them has its own disk, memory, CPU

4.2 MPP

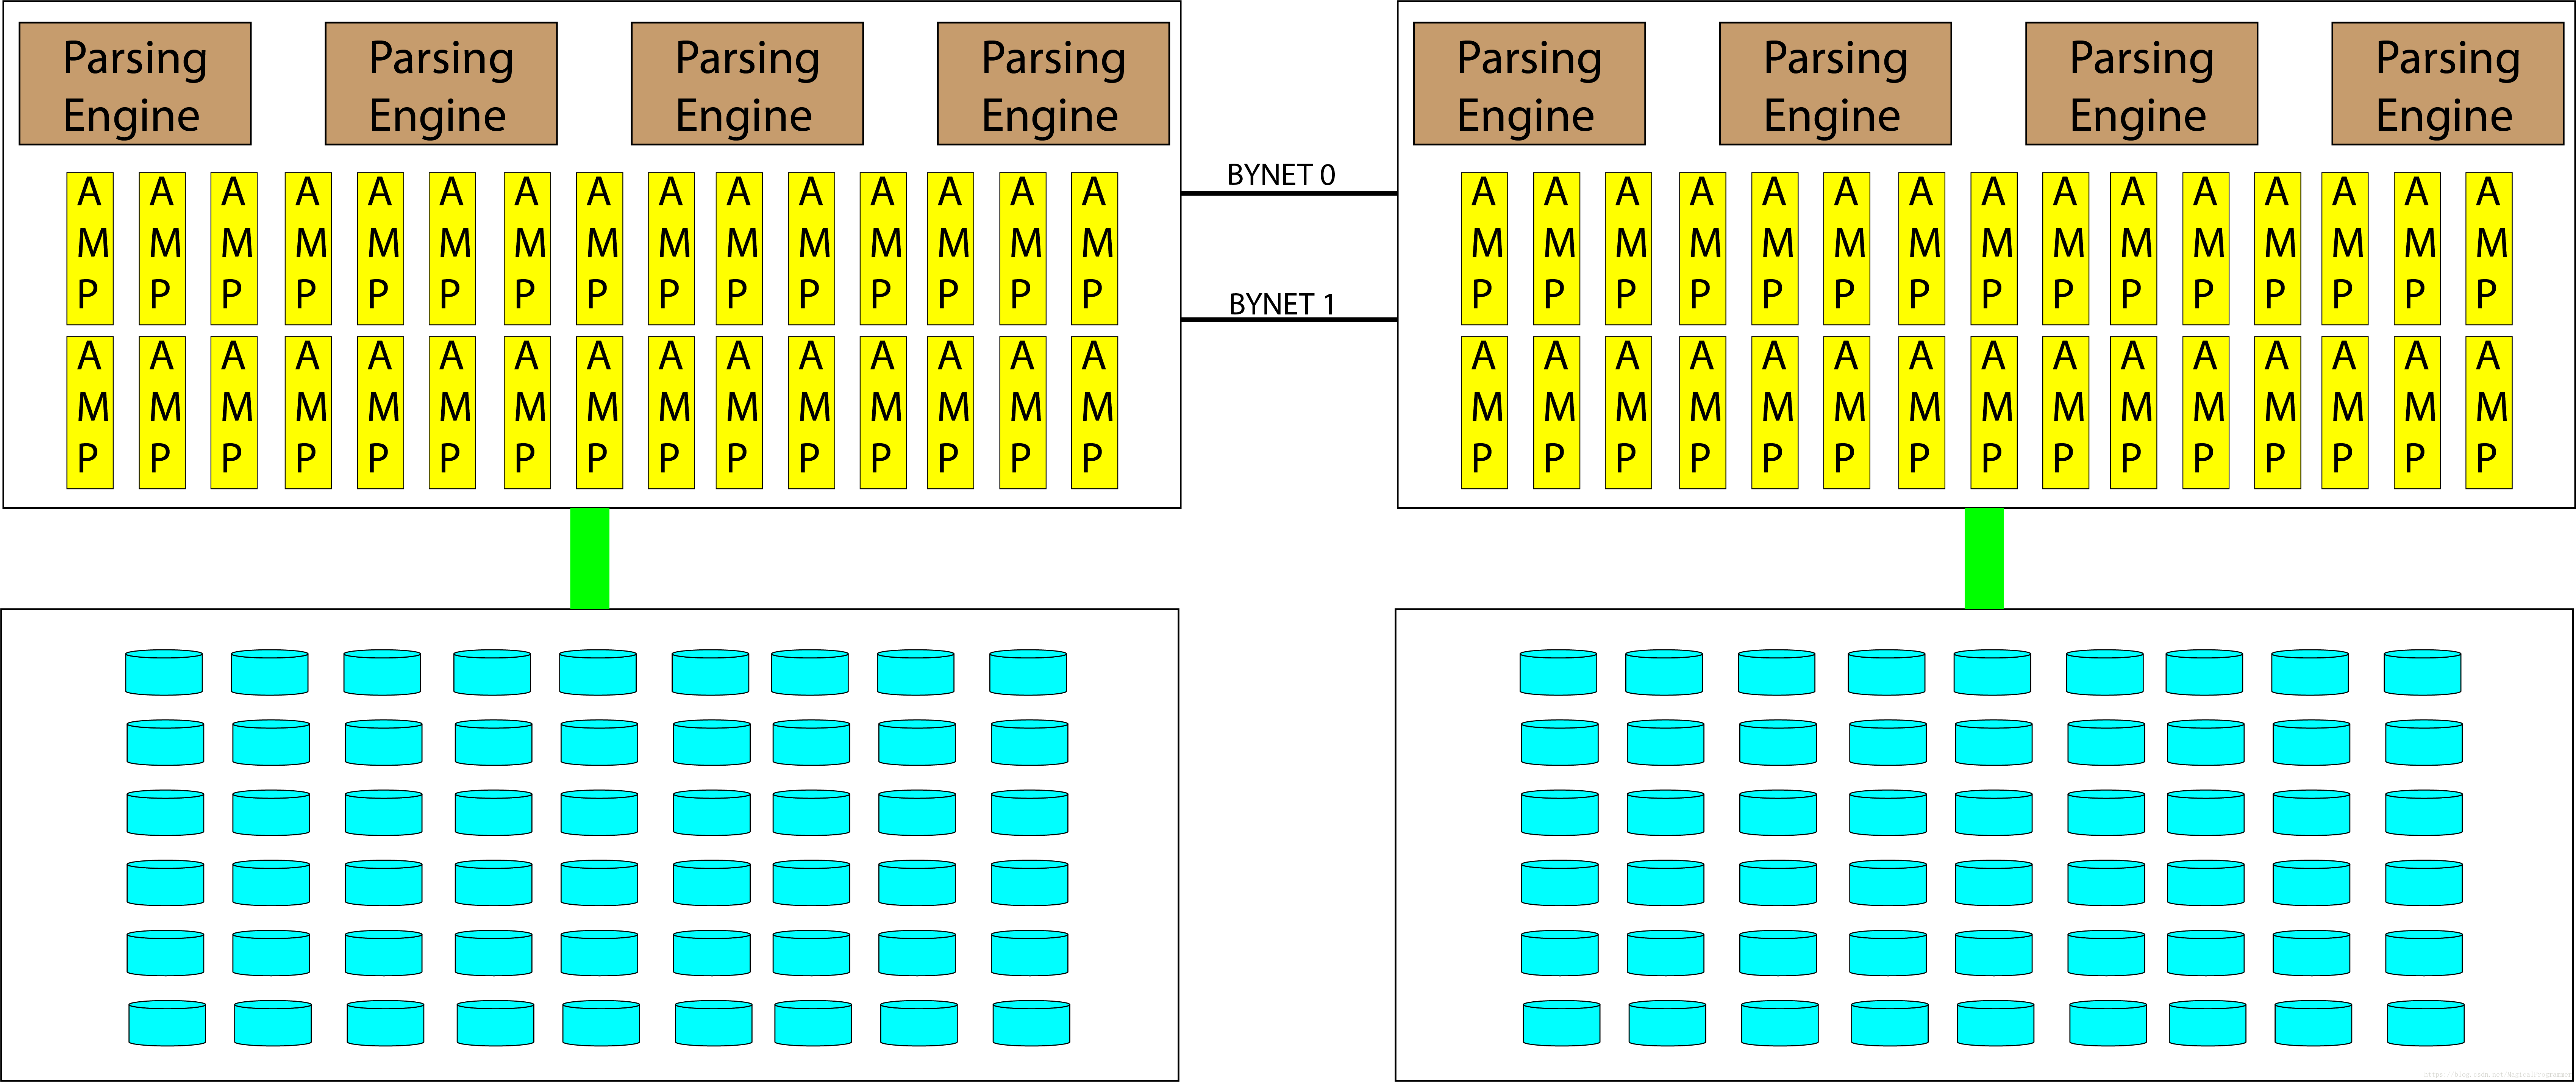
Two SMP nodes connected become one MPP (Massive Parallel Processing) system
005

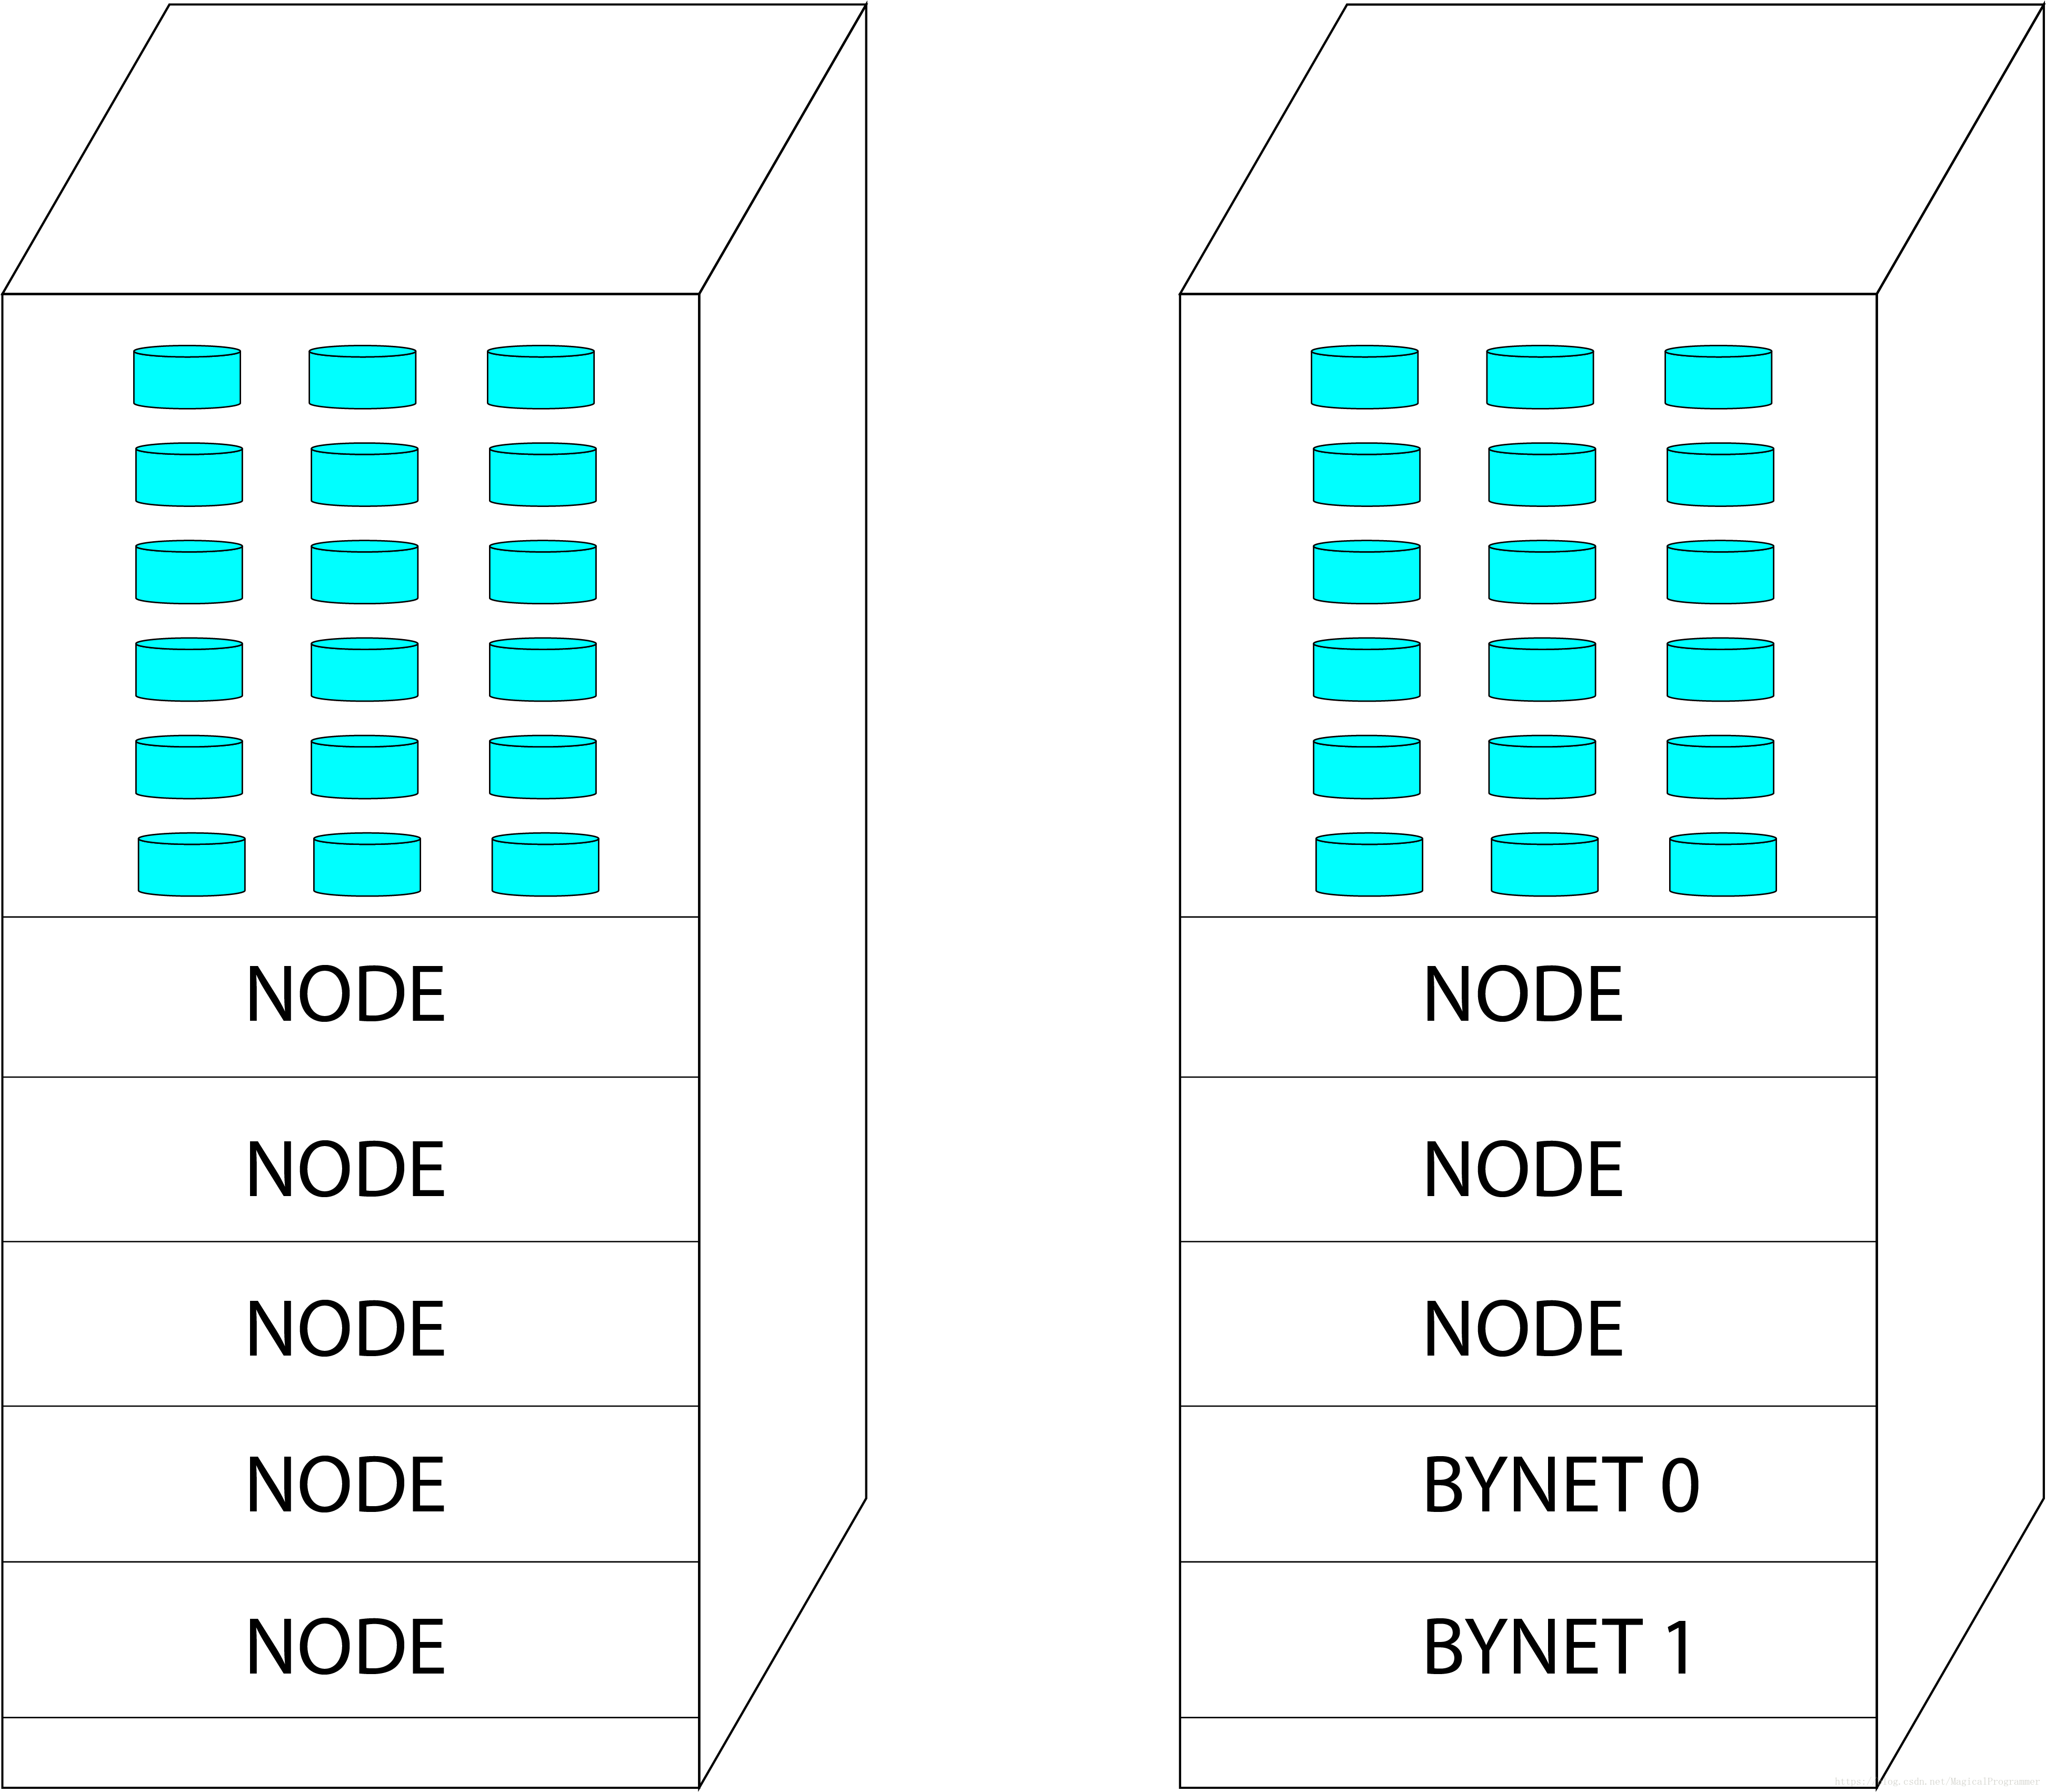
4.3 Teradata Cabinet

006

4.4 Inside a Node

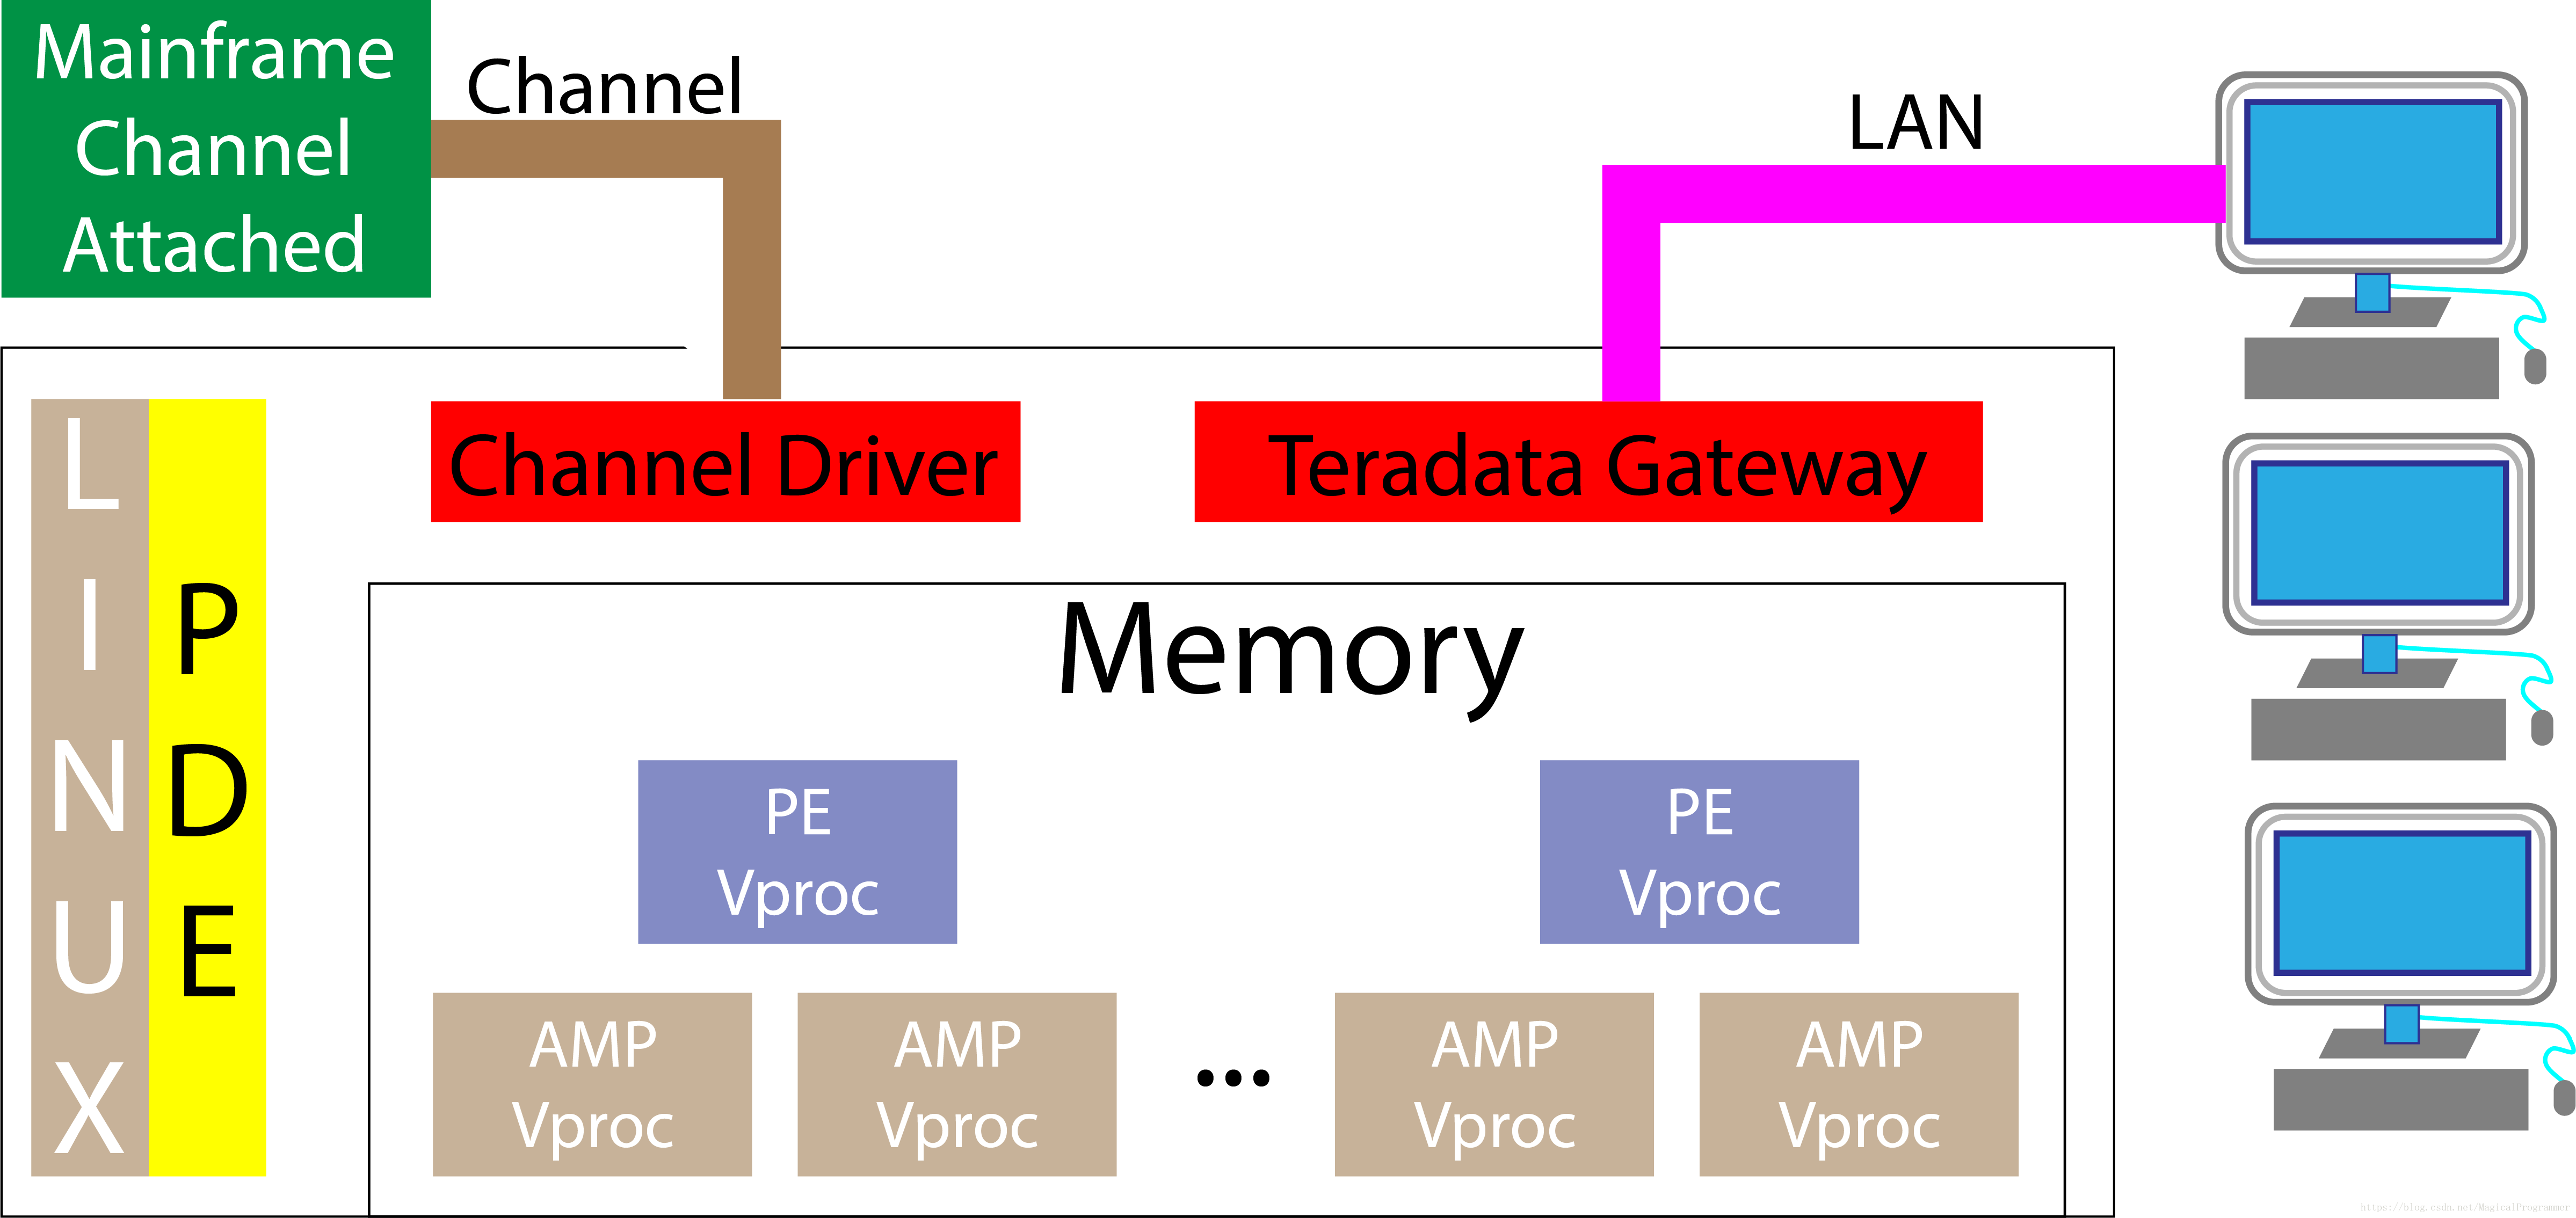
PDE - Parallel Database Extensions, which controls the BYNET

PE - Parsing Engines

Vproc - Virtual Processes
007

4.5 Boardless BYNET and Physical BYNET

Each PE controls every AMP, but why multiple PEs instead of one? Because each PE handles 120 sessions (users), which makes Teradata available for many users at the same time.


008

5. Hashing the primary index

Teradata_Basic_中英文对照版(整理版) 立即下载

相关推荐

teradata数据库基础教程(pdf中文版)

最基础,最实用,做全面的商业智能teradata数据库教程。

Teradata数据库调研及迁移KADB建议(三)

如果经常对同一列执行相同的聚合操作,聚合JI可以提供更好的查询性能,因为Teradata数据库可以使用聚合索引来满足查询,而不是为每个查询重复聚合计算。虽然唯一性不能保证数据行的统一分布,但索引的唯一性程度将决定行的分配,因为具有相同PI值的所有行都分布到相同的AMP,频繁重复的不同值的数量不能成为良好的PI候选。为了满足查询,Teradata数据库可以使用一种称为“分区消除”的优化,将数据搜索限制为仅包含与查询相关的数据的分区。通过使用多级分区,表或联接索引可以是列分区的、行分区的或两者兼有。

littlegirll的专栏 235

Teradata 学习手册

当用入门学习,也可以当作提高之用和工作的帮手

teradata PI-- 数据分布

(–本文是个人学习和使用过程中的总结,如有错误欢迎指正)teradata Primary Index简称PI teradata 建表时强烈建议明确指定PI列(尽管不指定PI teradata会根据DBScontrol配置自动选定PI),可以是一列或者多列,最多64列 PI主要有三个作用: 数据分布(Data Distribution) 快速检索数据(Fastest way to retrieve

wali_wang的博客 4971

Teradata 14.10 数据库设计

Teradata原厂资料,不可多得。详细描述了数据库的设计和Teradata体系架构。

TERADATA 学习资料

Teradata是全球最大的数据仓库解决方案提供商,在国外具有绝对的市场占有率,本书是学习Teradata数据仓库的入门书籍必读

TERADATA的主键与索引

  在传统的关系型数据库中,像Oracle、SQL Sever、DB2等,建表时一定要设定明确的主键约束,以唯一地区分记录。   TERADATA虽也是关系型数据库,但因专为数据仓库而生,仓库汇集多方数据,数据质量很难保证,故对主键的概念和限制也大大地淡化了,取而代之的是索引。具体体现在:     1) 有主键概念,存在于仓库E-R图中。清晰的主键和外键,便于理解和关联查找;     2...

Lianming2009的专栏 2424

基于斜坡补偿的Buck电路峰值电流+电压电流双闭环控制【附说明文档】(Simulink仿真实现)优快云首页发布文章优快云同步助手LLC谐振变换器开环+闭环软启动仿真设计(Simulink

内容概要:本文围绕三电平VIENNA整流器的双闭环控制与中点电位平衡问题展开仿真研究,提出了一种基于上下电容电压差值补偿的中点电位平衡策略。该策略在传统电压电流双闭环PI控制的基础上,引入电容电压差值作为反馈信号,通过SVPWM调制中冗余小矢量的时间分配实现中点电荷的定向调节,从而在不改变主控制结构的前提下有效抑制中点电位偏差。仿真结果表明,该方法不仅确保直流母线电压稳定跟踪800V给定值,还能显著提升上下电容电压的均衡度,同时保持输入电流低谐波水平,验证了控制策略的可行性和有效性。; 适合人群:电力电子、电气自动化及相关专业的研究生、科研人员及工程技术人员,具备一定的MATLAB/Simulink仿真基础和电力电子拓扑知识背景者更佳。; 使用场景及目标:①掌握三电平VIENNA整流器的工作原理与中点电位波动的成因;②理解电压电流双闭环PI控制的设计要点与参数整定原则;③学习基于差值补偿的中点电位平衡控制策略及其与SVPWM的协同机制;④应用于充电桩、航空电源、通信电源等中大功率单向整流场合的控制系统设计与优化。; 阅读建议:建议结合文中提供的仿真模型与参数设置进行动手实践,重点关注中点电位平衡投入前后电容电压波形的变化,对比分析不同工况下的系统动态响应,深入理解控制策略的作用机理。同时可进一步探索在电网不平衡、轻载等复杂工况下的控制性能,以拓展应用场景。

六大机构好评的Teradata 究竟有哪些过人之处?

在Gartner、Forrester Research、The Information Difference等六大全球顶级研究机构2017年发布的分析师评估报告中,Teradata天睿公司都被列为数据仓库相关市场的领导者。一直以来,能够获得这些顶级分析机构认可的企业,其在全球范围内的技术、应用、市场份额等方面都拥有无可争议的竞争力。 在笔者看来,Teradata天睿公司在全球市场的脱颖而

常言道 7433

SOPHGO SG2000/SG2002 AI SoC异构架构解析与应用

异构计算架构通过整合不同指令集核心(如RISC-V、Arm和8051)实现性能与功耗的平衡,是现代嵌入式系统和AIoT设备的关键技术。其原理是根据任务特性分配至最适合的计算单元,例如通用计算使用高性能核心,实时任务交由专用核心处理。这种架构在智能视觉、工业检测等场景具有显著优势,能高效处理AI推理、多媒体编解码等任务。SOPHGO SG2000系列SoC采用创新的三核异构设计,集成了0.5-1TOPS的NPU加速器,支持Linux/Android/FreeRTOS多系统并行运行。开发中需注意核心间的IPC通

weixin_30684743的博客 356

UE5网络模块实战:属性复制、RPC与联机开发踩坑指南

多人联机开发中,网络同步是核心难题。UE5网络模块以服务器权威为基础,通过Actor复制、RPC和所有权机制实现多端状态一致。理解属性复制与OnRep回调、区分Server/Client/Multicast RPC的适用场景,是构建稳定联机架构的关键。本文结合数字孪生与多端协作场景,探讨如何将渲染与逻辑分离,并针对打包后网络失效、端口防火墙、崩溃排查等工程实践问题给出解决方案。通过蓝图接口解耦表现层,利用C++创建StaticMesh组件实现服务器逻辑与客户端表现分离,同时注意专用服务器不加载渲染依赖(如D

weixin_29010003的博客 274

mysql实现可重复读(解决幻读)的原理(MVCC机制的版本链和读视图)

MVCC(Multi-Version Concurrency Control ,多版本并发控制)指的就是在使用READ COMMITTD、REPEATABLE READ这两种隔离级别的事务在执行普通的SEELCT操作时访问记录的版本链的过程,这样子可以使不同事务的读-写、写-读操作并发执行,从而提升系统性能。READ COMMITTD、REPEATABLE READ这两个隔离级别的一个很大不同就是生成ReadView的时机不同,READ COMMITTD在每一次进行普通SELECT操作前都会生成一个

lzf的博客 3万+

点云工具CloudCompare下载、安装与汉化

打开软件后,是英文界面,找到菜单栏【Display】-【Language Translation】,选择简体中文。进入官网后,点击菜单栏【Download】提示需要重启软件才能生效,点OK即可。重启软件后,已经是中文了。选择合适系统进行下载。常规软件安装流程即可。

sagima_sdu的博客 1万+

【Teradata SQL】优化技巧总结

1.多次关联码表,只为更新不同字段。 可以考虑把码表统一到一张表,改成case筛选。 2.主表普通字段与码表PI字段关联,主表重分布,且倾斜较严重。 解决思路:码表设置为NOPI或者多个字段PI 方案原理:关联时因为码表为PI字段,所以优化器会将主表按照关联字段进行重分布。一般主表数据量较大,而且因为是码值,数据重复值会非常多。只需要改变码表的PI定义即可,执行计划就会进行码表的dupli...

weixin_30394251的博客 1090

The moving least square approximation(MLS).

移动最小二乘法, moving least square

fanglovel的博客 300

HDMI与DisplayPort混搭方案:如何用Xilinx Video PHY Controller实现多协议视频接口转换

本文详细解析了如何利用Xilinx Video PHY Controller IP核实现HDMI与DisplayPort协议转换,涵盖混合视频接口架构设计、GT收发器动态重配置策略及跨协议时钟域处理方案。通过实战案例和配置技巧,帮助开发者构建高性能多协议视频转换系统,适用于医疗影像、工业控制等场景。

weixin_30776273的博客 447

Teradata数据库简介

Teradata数据库基础 最近在在公司用的数据仓库是Teradata,在网上找了一些Teradata数据库的资料,顺便做一些笔记啦。 1.Teradata数据库简介 Teradata是比较比较受欢迎的数据库管理系统,定位就是大数据仓库系统,定位比较高,主要应用于数据存储和数据处理,处理速度比Hive要高10倍左右。 2. Teradata数据库的特点 a.无限并行化—Teradata数据库系统是...

数据爱好者 2万+

存储硬盘格式怎么把512还原为520格式??

硬盘厂商工具(如SeaChestsg_format)可以调整扇区大小。备份数据,因为调整扇区会清除硬盘内容。根据硬盘型号和接口类型,选择合适的工具进行调整。如果你需要更详细的帮助,请提供你的硬盘型号和存储设备类型。希望如上措施及解决方案能够帮到有需要的你。PS:如若遇到采纳如下方案还是未解决的同学,希望不要抱怨&&急躁,毕竟影响因素众多,我写出来也是希望能够尽最大努力帮助到同类似问题的小伙伴,即把你未解决或者产生新Bug黏贴在评论区,我们大家一起来努力,一起帮你看看,可以不咯。

**My Coding Family** 1146

结合Teradata数据仓库特点浅谈其检索机制

1、数据自动分配 Teradata中只有一种基于HASH算法的数据分配机制,当要插入一条记录时,根据主索引计算出相应的AMP,该条记录即通过此AMP存到其对应的磁盘上。由于主索引值的不同,一个表的各条记录将通过各AMP均匀地分布到各个磁盘上。分配过程完全自动进行,不需要DBA干预,这一点和其它OLTP DBMS有很大的区别。Teradata的HASHING算法经过长期的发展,已经十分完善。它采用

cuijieb的专栏 1489

pycharm一直选择不了conda正确路径弹框报错:latinit property envs_dirs has not been initialized...如何解决?

🏆本文收录于 《全栈 Bug 调优(实战版)》 专栏。专栏聚焦真实项目中的各类疑难 Bug,从成因剖析 → 排查路径 → 解决方案 → 预防优化全链路拆解,形成一套可复用、可沉淀的实战知识体系。无论你是初入职场的开发者,还是负责复杂项目的资深工程师,都可以在这里构建一套属于自己的「问题诊断与性能调优」方法论,助你稳步进阶、放大技术价值 。

**My Coding Family** 2928

【EB_Tresos专题】-01-EB Tresos导入工程

<--返回「Autosar_BSW高阶配置」总目录--> <--返回「Autosar_BSW高阶配置」专栏主页--> <--返回「个人博客」首页--> <--返回「Autosar_BSW高阶配置」总目录--> <--返回「Autosar_BSW高阶配置」专栏主页--> <--返回「个人博客」首页--> 结尾 ...

「汽车电子助手」的博客 6440

teradata查看执行计划

Teradata 执行计划   查看Teradata执行计划使用如下语句: Explain SQL Statement

漫步云端 2784

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

SQL-Teradata基础

1.创建一个和表 pnr_1 结构一样的表 Create table pnr_2 as pnr_1 with no data 不含数据 Create table pnr_2 as pnr_1 with data 含数据 2.NULLIF(exp1,exp2) 当字段exp1与exp2相等时返回 空;当两者不相等时返回 exp1 -------常用在除数不能为0的限制下 RP...

weixin_30251829的博客 865

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

成为数据库专家必读书目推荐

1 《SQL必知必会》1.1 内容简介SQL 是目前使用最为广泛的数据库语言之一。本书没有涉及理论,而是从实践出发,由浅入深地讲解了广大读者所必需的SQL 知识,适用于各种主流数据库。实例丰富,便于查阅。 本书涉及不同平台上数据的排序、过滤和分组,以及表、视图、联结、子查询、游标、存储过程和触发器等内容,通过本书读者可以系统地学习到SQL 的知识和方法。目前已出到第 4 版1.2 作者简介Ben

读万卷书,行万里路 1万+

贝叶斯统计 [韦来生编]

贝叶斯(Bayes)统计是近几十年来迅速发展起来的数理统计的一个重要分支。贝叶斯方法与经典统计方法的主要不同之处是进行统计推断时除了利用样本信息外,还要利用参数的先验信息,因此可以提高统计推断或统计决策的效果。它在经济、金融、生物、医学、自然科学和社会科学等许多领域具有广泛的应用。贝叶斯方法的研究已渗透到了统计学的几乎所有领域。作者在给中国科学技术大学概率论与数理统计专业本科生开设的“数理统计”课程中有一章专门讲授“贝叶斯方法和统计决策理论”,近十年来也给中国科学技术大学概率统计专业研究生开设过几次“贝叶斯分析”课。本书是在对过去讲稿的内容作了适当的增减和调整的基础上完成的。  本书共分六章。第1章是绪论,介绍了贝叶斯统计的若干基本概念,同时对必要的数理统计的基础知识有重点地作了回顾。第二章介绍了确定先验分布的若干可供选择的方法。第三章介绍了几类常见统计模型参数的后验分布的主要结果和计算方法。第四章和第五章分别介绍了“贝叶斯统计推断”和“贝叶斯统计决策”的内容。第六章介绍了贝叶斯统计计算的若干方法,包括蒙特卡洛方法和马尔可夫链蒙特卡洛(MCMC)方法以及相关统计软件的简介。本书的每一章附右大量的例题和习题,书末附有常用的几个表格和部分习题解答供读者查用。  大约可在54学时内讲授本书的第1章至第六章的主要内容,教师可根据学时需要选讲本书第1章至第六章的部分内容。书中标“*”号的章节可略去不讲,留给读者作为阅读材料。第六章例题中的R代码和部分例题的数据文件等可从作者个人主页下载。  作者在编写本书的过程中参考了J.O.Berger教授的《统计决策论及贝叶斯分析》和茆诗松教授编写的《贝叶斯统计》等书中的一些内容,以及《贝叶斯分析》一书中由张伟平博士编写的有关贝叶斯统计计算的一些内容。在此表示衷心感谢。  本书编写准备过程中,中国科学技术大学统计与金融系的几个研究生帮助完成了本书部分中文的录入和排版,作者对他们的辛勤工作表示真诚的感谢。高等教育出版社为本书的出版给予了大力支持。在此一并致谢。

Teradata sql 常用语句总结

工作使用TD数据库,转载常用语句方便查看 从参考文章中截取工作中经常的语句,不定时更新 参考文章1:https://blog.youkuaiyun.com/u010020099/article/details/82219967 需求1.数据源表某大字段分别截取需要的部分,入仓某表多个字段 解决方案:使用substr()函数 Substr(exp,m,n)-- 从字段exp的第m位开始截取,截取长度为 n ...

qq_43117856的博客 3076
上一篇: Oracle PL/SQL Nutshell
下一篇: Sublime列对齐插件
DataPeak
博客等级 码龄15年 32粉丝 68原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值