





什么是网络爬虫?
网络爬虫(Web Crawler)是一种自动获取网页内容的程序。它可以访问网站,抓取页面内容,并从中提取有价值的数据。在信息爆炸的时代,爬虫技术可以帮助我们高效地收集、整理和分析互联网上的海量数据。
爬虫的发展历程
要理解今天的爬虫技术,我们需要先了解它的历史演变。爬虫技术的发展与互联网的成长紧密相连,经历了从简单工具到复杂系统的转变。
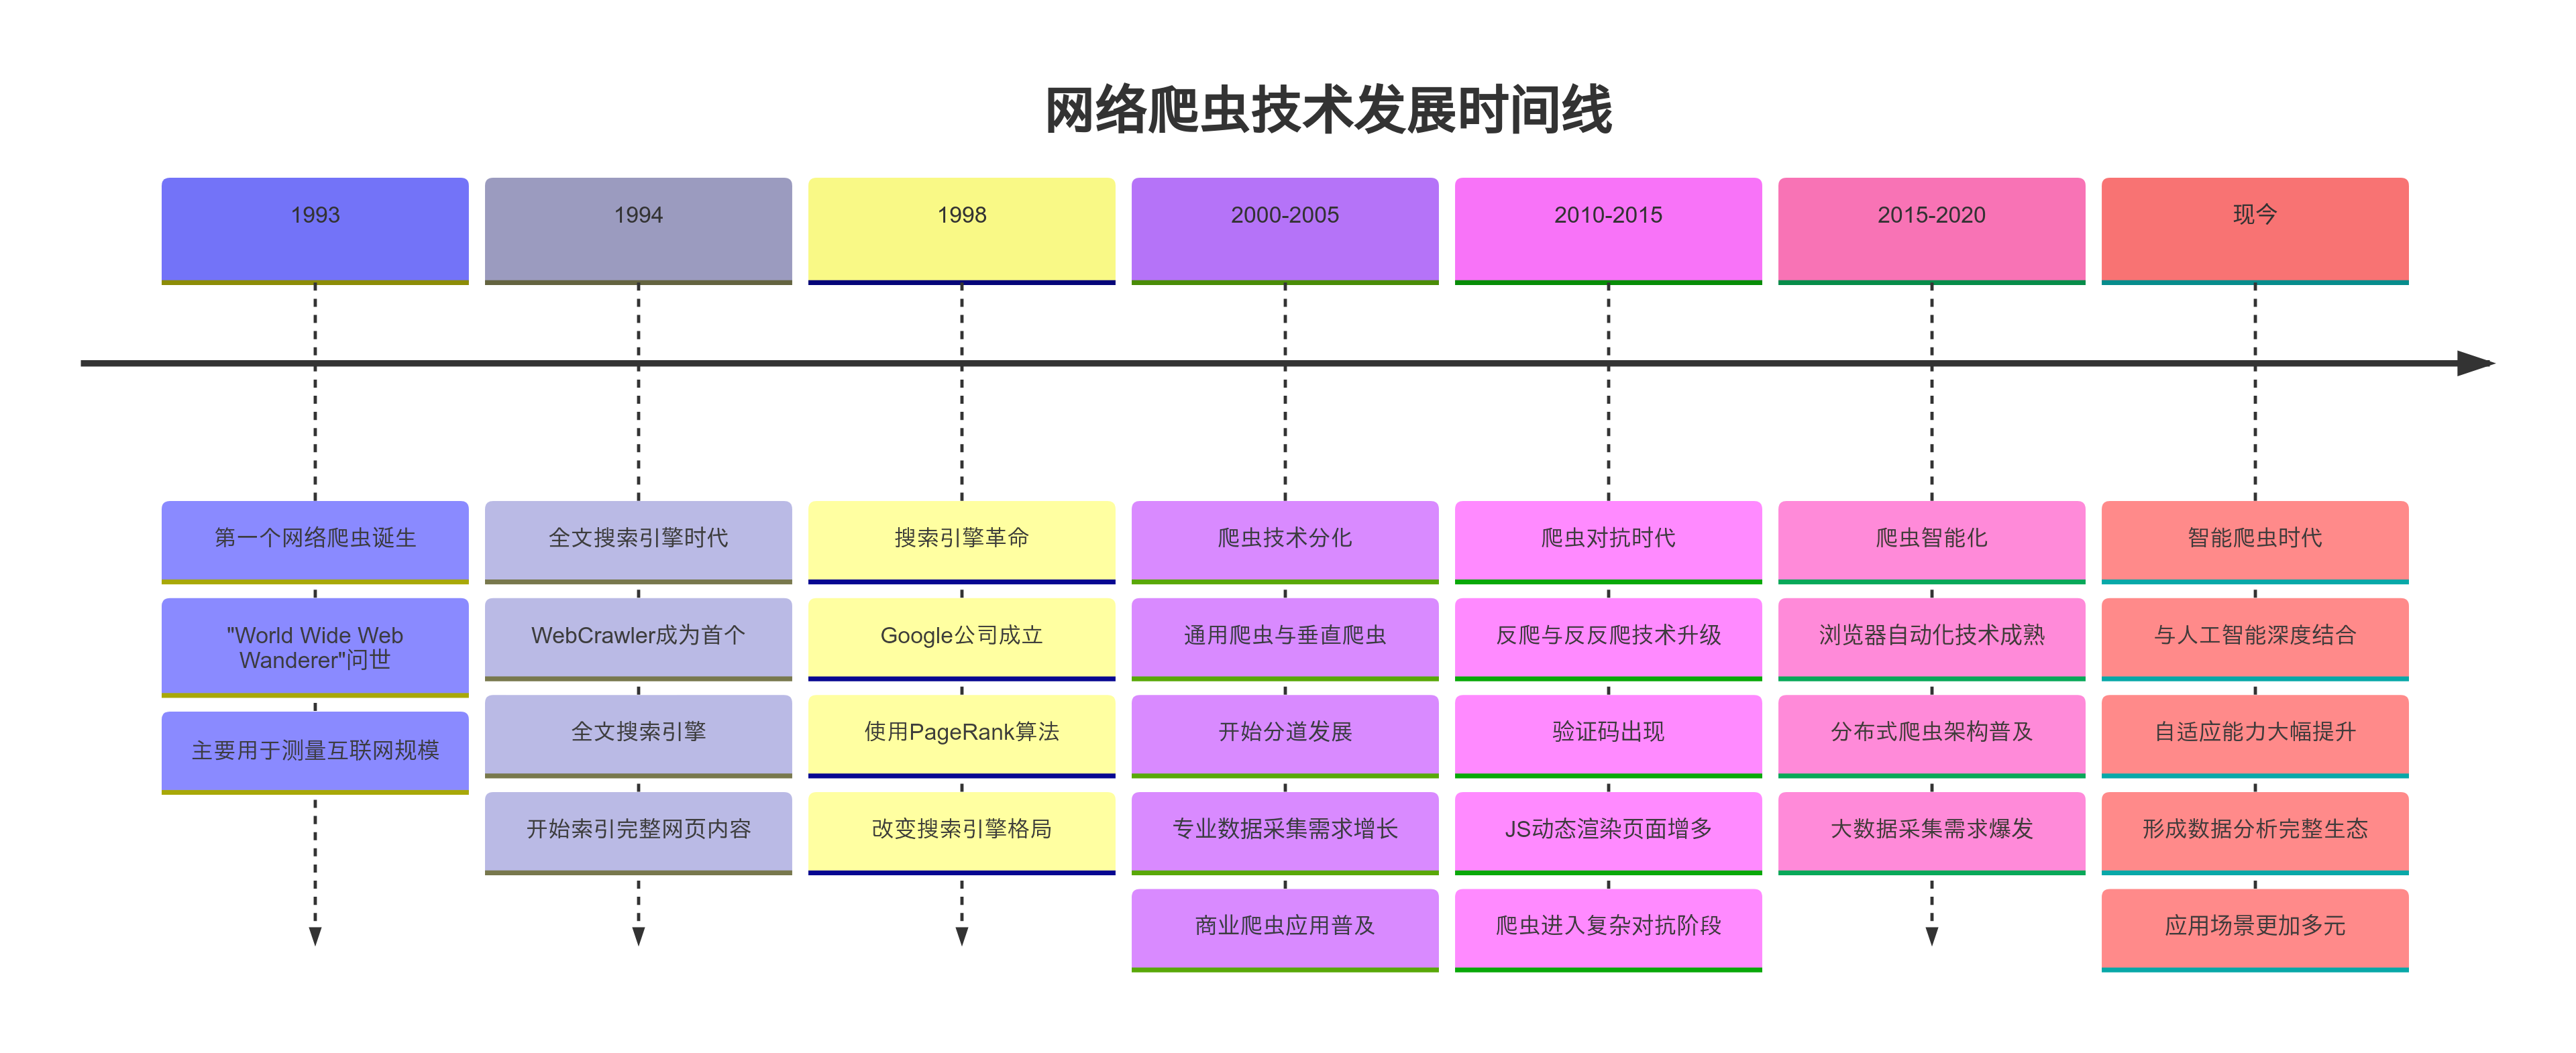
- 1993年 - 第一个网络爬虫 “World Wide Web Wanderer” 出现,主要用于测量互联网规模
- 1994年 - WebCrawler成为第一个全文搜索引擎,开始索引整个网页内容
- 1998年 - Google建立,使用PageRank算法的爬虫技术革新了搜索引擎
- 2000年代初 - 通用爬虫和垂直爬虫开始分化,专业数据采集需求增长
- 2010年代 - 反爬与反反爬技术不断升级,爬虫技术进入复杂对抗阶段
- 现今 - 爬虫技术与人工智能、大数据分析结合,应用场景更加广泛
随着爬虫技术的不断发展,它们也逐渐形成了不同的类型以满足各种需求。
爬虫的分类
根据工作方式和目标不同,爬虫可以分为几种主要类型:
- 通用爬虫: 也称为全网爬虫,类似于搜索引擎使用的爬虫系统。它们不针对特定网站,而是尝试抓取互联网上尽可能多的网页,建立广泛的数据索引。百度、谷歌等搜索引擎使用的就是这类爬虫。通用爬虫通常规模庞大,需要处理海量数据和复杂的网页排名算法。
- 垂直爬虫: 专注于特定领域或网站的爬虫,只抓取与特定主题相关的内容。比如只抓取电商网站的商品信息、只收集新闻网站的文章或只获取社交媒体的特定数据。垂直爬虫更加精准高效,适合有明确目标的数据采集需求。
- 增量式爬虫: 关注数据的更新变化,只抓取新增或修改的内容,而不是重复抓取整个网站。这类爬虫通常会记录上次抓取的时间戳或内容特征,通过比对确定哪些内容需要更新。增量式爬虫大大减少了重复工作,提高了效率和资源利用率。
- 深层爬虫: 能够突破常规爬虫的限制,处理需要用户交互、表单提交或JavaScript动态渲染的内容。普通爬虫可能只能获取静态HTML,而深层爬虫能够模拟浏览器行为,执行JavaScript代码,处理AJAX请求,甚至能填写表单并提交,从而获取隐藏在"深层网络"中的数据。
网络爬虫工作原理
网络爬虫虽然种类多样,但基本工作原理是相似的。下图展示了爬虫的典型工作流程:
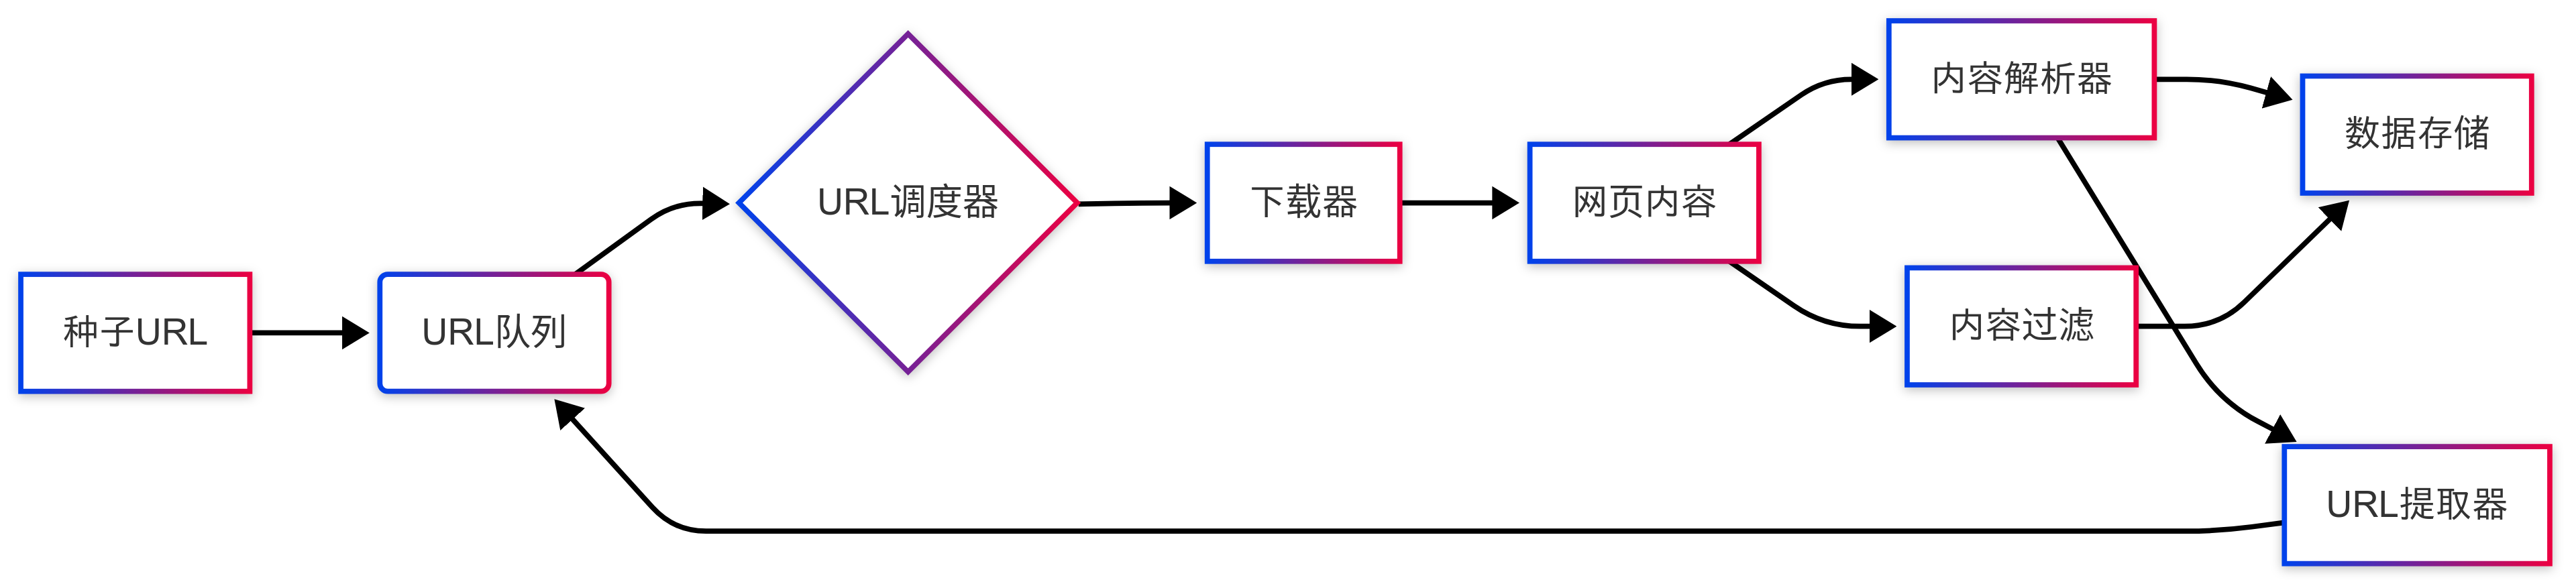
网络爬虫的工作流程通常遵循一个循环往复的过程,主要包括以下几个环节:
-
初始化种子URL:爬虫从一组预定义的起始URL(称为种子URL)开始工作。这些URL是爬取过程的入口点,类似于探索迷宫的起点。
-
URL队列管理:爬虫维护一个待爬取的URL队列。初始时,队列中只有种子URL,随着爬取过程的推进,新发现的URL会不断加入队列。
-
URL调度器:负责从URL队列中选择下一个要爬取的URL。调度器会考虑各种因素,如URL优先级、访问频率限制、网站礼仪(robots.txt)等。
-
网页下载:爬虫向目标URL发送HTTP请求,获取网页内容。这一步可能会处理各种HTTP状态码、重定向、超时等情况。
-
内容解析:获取到网页内容后,爬虫会解析HTML/XML结构,提取有价值的数据。常用的解析方法包括正则表达式、XPath、CSS选择器或专门的解析库(如BeautifulSoup)。
-
数据过滤与存储:对提取的数据进行清洗、去重、格式化等处理,然后存储到文件、数据库或其他存储系统中。
-
URL提取:从已下载的页面中提取新的URL链接,这些新URL经过筛选后(去除重复、不符合规则的URL)加入到URL队列中,等待后续爬取。
-
循环迭代:重复上述过程,直到达到预定的终止条件,如队列为空、达到最大爬取数量或时间限制等。
在实际应用中,爬虫系统还会增加很多功能模块,如反爬处理、分布式协作、失败重试、数据验证等,以提高爬取的效率、稳定性和准确性。
为什么选择Python进行网络爬取?
了解了爬虫的基本原理后,接下来的问题是:用什么工具和语言来实现爬虫?虽然许多编程语言都可以开发爬虫,但Python已成为这一领域的主导语言。这不是偶然的,而是有充分理由的选择,主要原因包括:
- 简洁易学:Python语法简单清晰,代码可读性高,学习曲线平缓。与其他语言相比,用更少的代码就能实现相同功能,让开发者可以专注于爬虫逻辑而非语法细节。比如我使用下面的3行代码就能实现爬取百度搜索页面的数据:
import requests
response = requests.get("https://www.baidu.com")
print(response.text)
-
丰富的库支持:Python拥有为爬虫量身定制的工具生态系统:
- Requests:直观易用的HTTP库,简化网络请求
- BeautifulSoup:强大的HTML/XML解析器
- Scrapy:全功能爬虫框架,提供完整解决方案
- Selenium/Playwright:浏览器自动化工具,处理动态网页
- Pandas:高效的数据处理与分析库
-
活跃的社区支持:大量教程、文档和示例代码,遇到问题时容易找到解决方案。爬虫技术不断更新,社区也持续提供应对各种反爬策略的方法。
-
跨平台兼容性:Python程序可在Windows、Mac、Linux等各种操作系统上无缝运行,便于部署和维护。
-
与数据科学生态系统紧密集成:爬虫的最终目的往往是数据分析,Python在这方面具有独特优势。爬取后的数据可直接使用Pandas、NumPy处理,用Matplotlib可视化,甚至用于机器学习。
-
并发处理能力:通过多线程、异步IO(asyncio)和协程,Python能高效处理大量并发请求,这对爬虫至关重要。
-
应对反爬策略的灵活性:Python生态提供了多种工具来处理cookies、会话管理、用户代理伪装和验证码识别等反爬挑战。
虽然其他语言也可以开发爬虫,但Python在易用性、开发效率和功能完整性上的优势使其成为爬虫开发的理想选择,特别适合从入门到精通的学习过程。
爬虫与网络请求模型
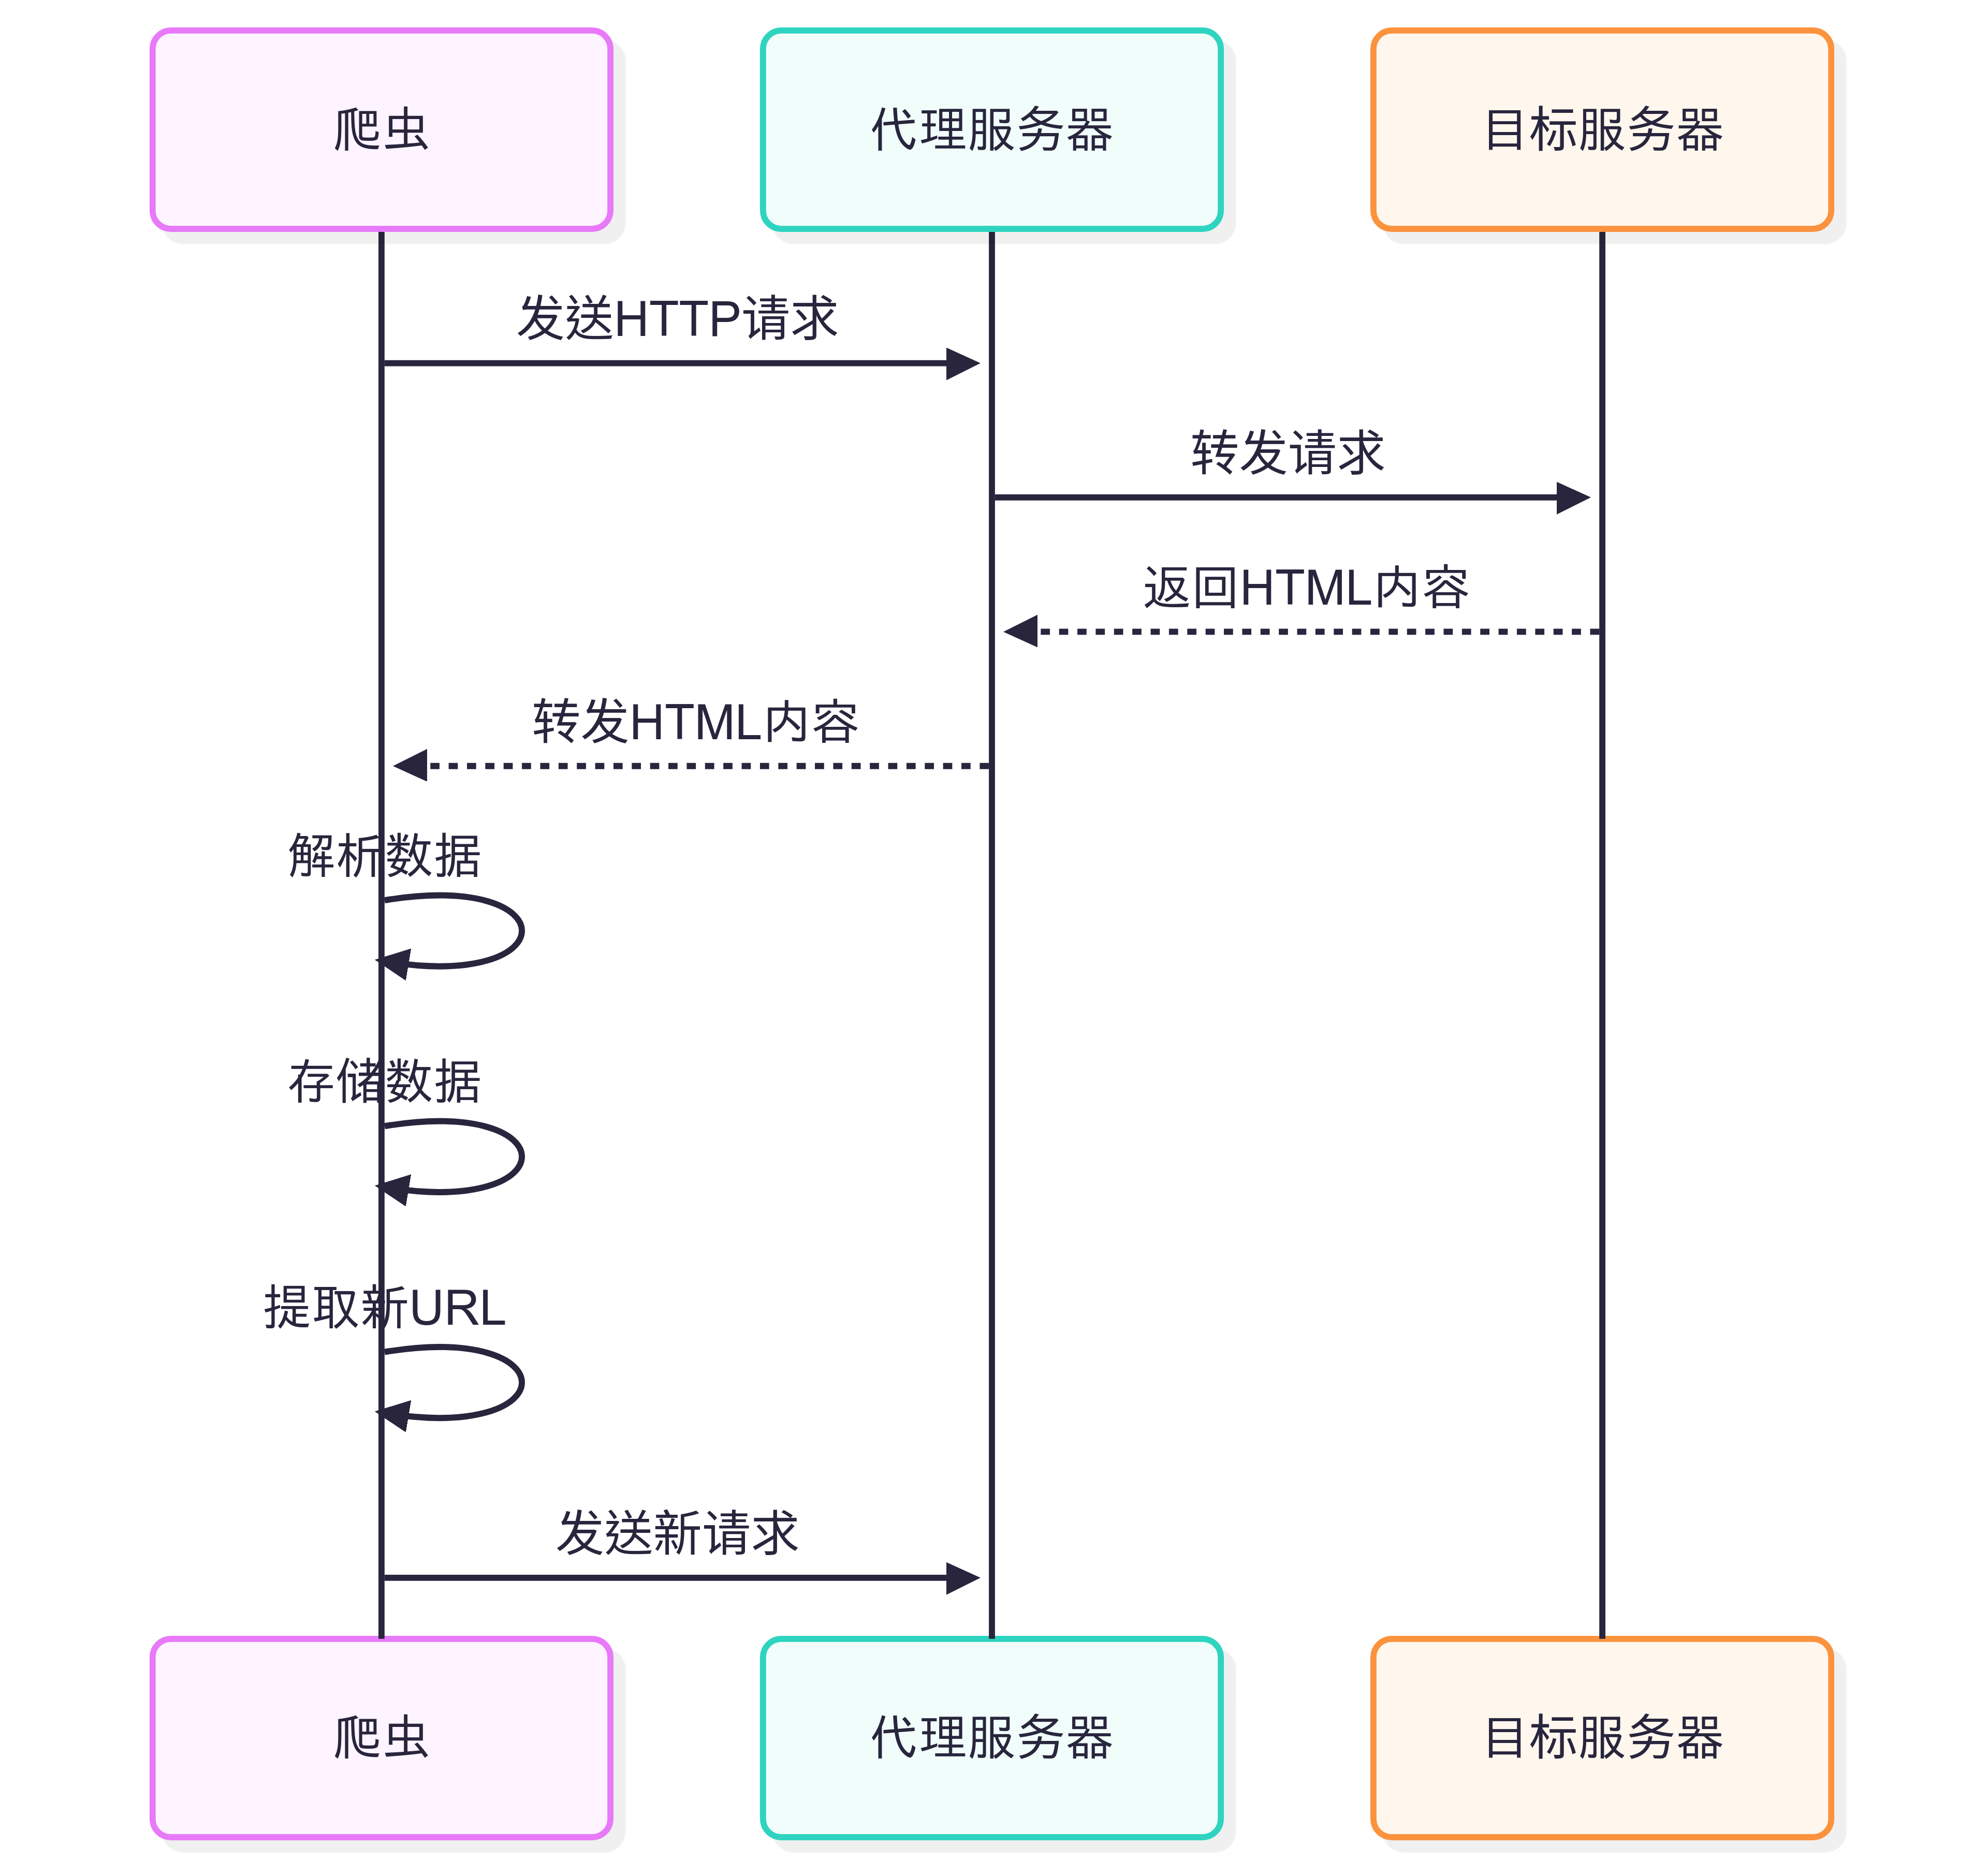
上图展示了爬虫工作过程中的网络请求交互模型。整个过程可以分为以下几个步骤:
-
发起请求:爬虫程序首先向代理服务器发送HTTP请求,这一步通常包含目标URL和各种请求参数。
-
请求转发:代理服务器接收到爬虫的请求后,将其转发给目标服务器。使用代理服务器可以隐藏爬虫的真实IP地址,减少被目标网站封禁的风险。
-
内容返回:目标服务器处理请求后,将HTML内容返回给代理服务器。
-
内容传递:代理服务器将收到的HTML内容转发回爬虫程序。
-
数据处理:爬虫收到HTML内容后,进行三个关键操作:
- 解析数据:使用解析器提取需要的信息
- 存储数据:将有价值的数据保存到文件或数据库
- 提取新URL:从页面中发现新的链接,加入待爬取队列
-
循环爬取:爬虫根据新提取的URL,向代理服务器发送新的请求,整个过程循环往复,直到满足终止条件。
这种模型体现了爬虫工作的基本流程,特别是在使用代理服务器的情况下,既能提高爬取效率,又能增强爬虫的隐蔽性和稳定性。
如何查看和遵守robots.txt
作为负责任的爬虫开发者,我们应该尊重网站所有者的意愿。robots.txt是网站根目录下的一个文本文件,用于告诉爬虫哪些页面可以爬取,哪些不可以。遵守robots.txt是网络爬虫的基本道德准则。
如何查看robots.txt文件:
- 直接访问: 将网址后面加上"/robots.txt"
https://www.baidu.com/robots.txt
- 通过Python代码查看:
import requests

def get_robots_txt(url):
    # 确保URL格式正确
    if not url.startswith('http'):
        url = 'https://' + url

    # 移除URL末尾的斜杠(如果有)
    if url.endswith('/'):
        url = url[:-1]

    # 获取robots.txt文件
    robots_url = url + '/robots.txt'
    try:
        response = requests.get(robots_url)
        if response.status_code == 200:
            print(f"成功获取 {robots_url}")
            return response.text
        else:
            print(f"无法获取robots.txt,状态码: {response.status_code}")
            return None
    except Exception as e:
        print(f"发生错误: {e}")
        return None

# 使用示例
robots_content = get_robots_txt('www.baidu.com')
print(robots_content)
robots.txt文件典型内容示例:
User-agent: *
Disallow: /private/
Disallow: /admin/
Allow: /public/
Crawl-delay: 10
解释:
User-agent: *- 适用于所有爬虫Disallow: /private/- 禁止爬取/private/目录下的内容Allow: /public/- 允许爬取/public/目录下的内容Crawl-delay: 10- 建议爬虫每次请求之间间隔10秒
robots.txt文件分析图解:
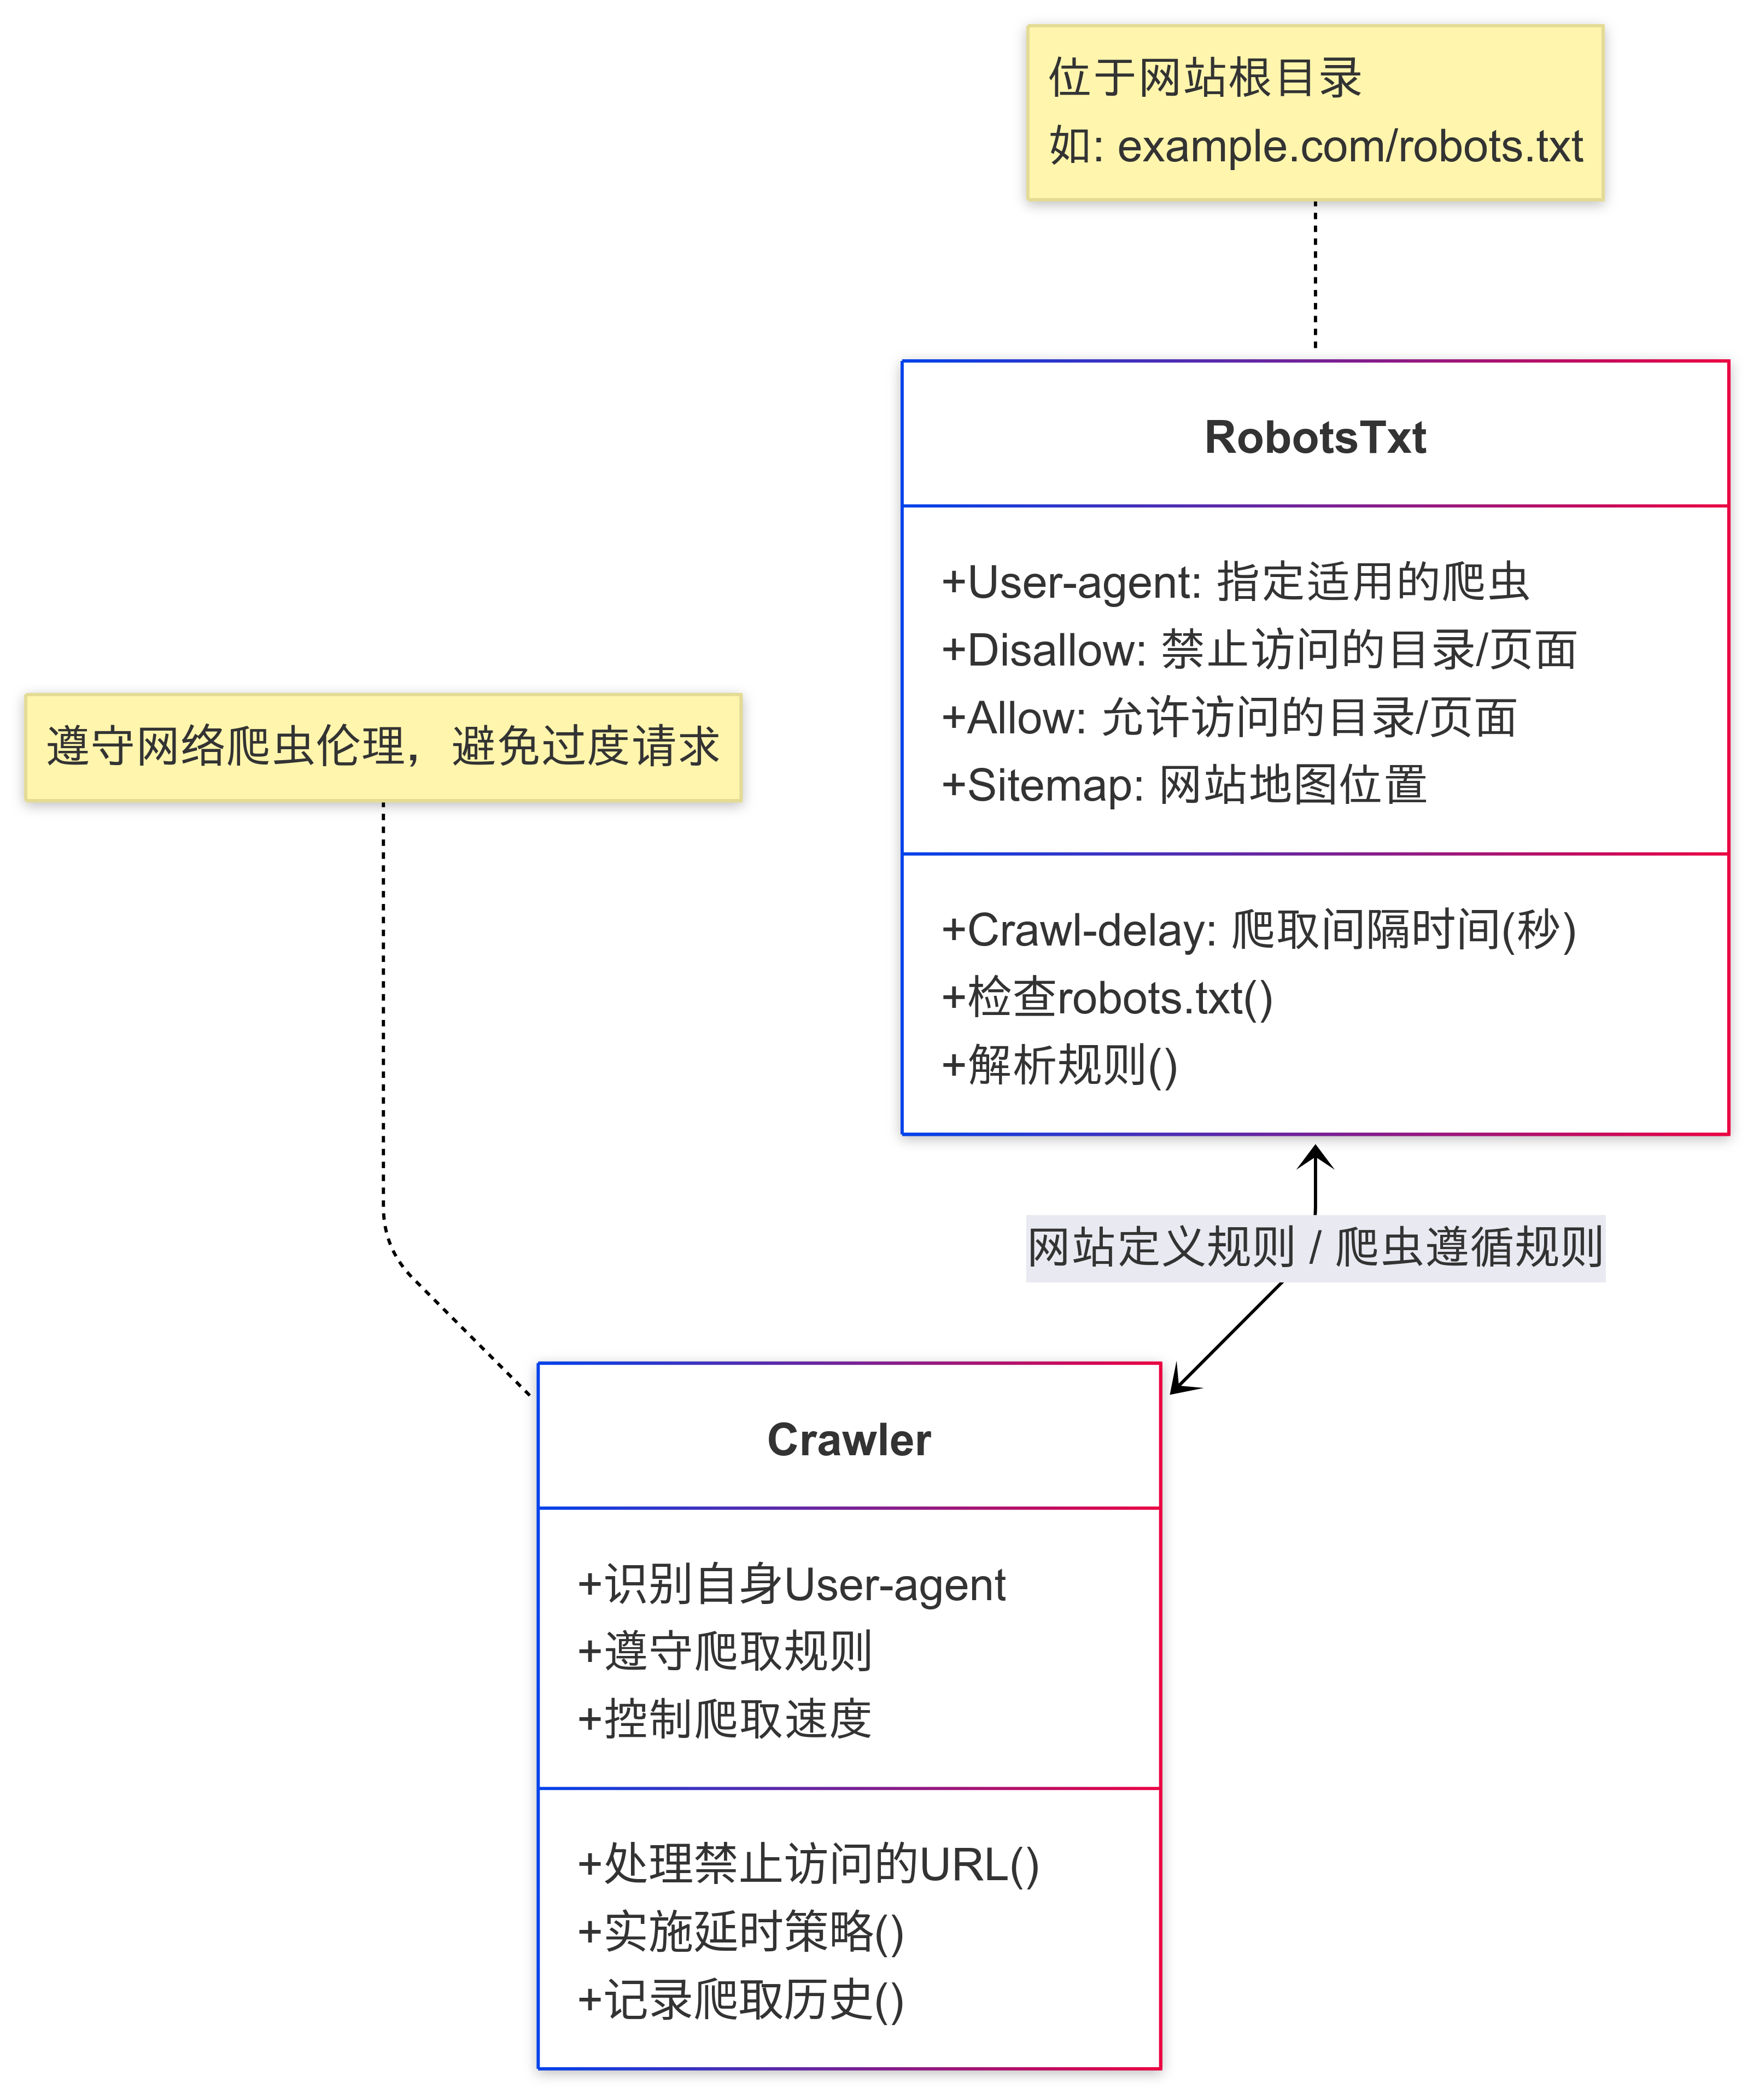
理解了网站的爬取规则后,我们可以开始实际的爬虫编写。下面是一个简单的Python爬虫示例,展示了基本的爬取过程。
一个简单的Python爬虫示例
以下是一个基础的Python爬虫示例,用于爬取百度热搜榜的内容:
import requests
from bs4 import BeautifulSoup

# 发送HTTP请求
url = "https://top.baidu.com/board?tab=realtime"
headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"}
response = requests.get(url, headers=headers)

# 检查请求是否成功
if response.status_code == 200:
    # 解析HTML内容
    soup = BeautifulSoup(response.text, 'html.parser')

    # 提取热搜标题
    hot_titles = soup.select("div.c-single-text-ellipsis")

    for i, title in enumerate(hot_titles, 1):
        print(f"{i}. {title.text.strip()}")
else:
    print(f"请求失败,状态码: {response.status_code}")
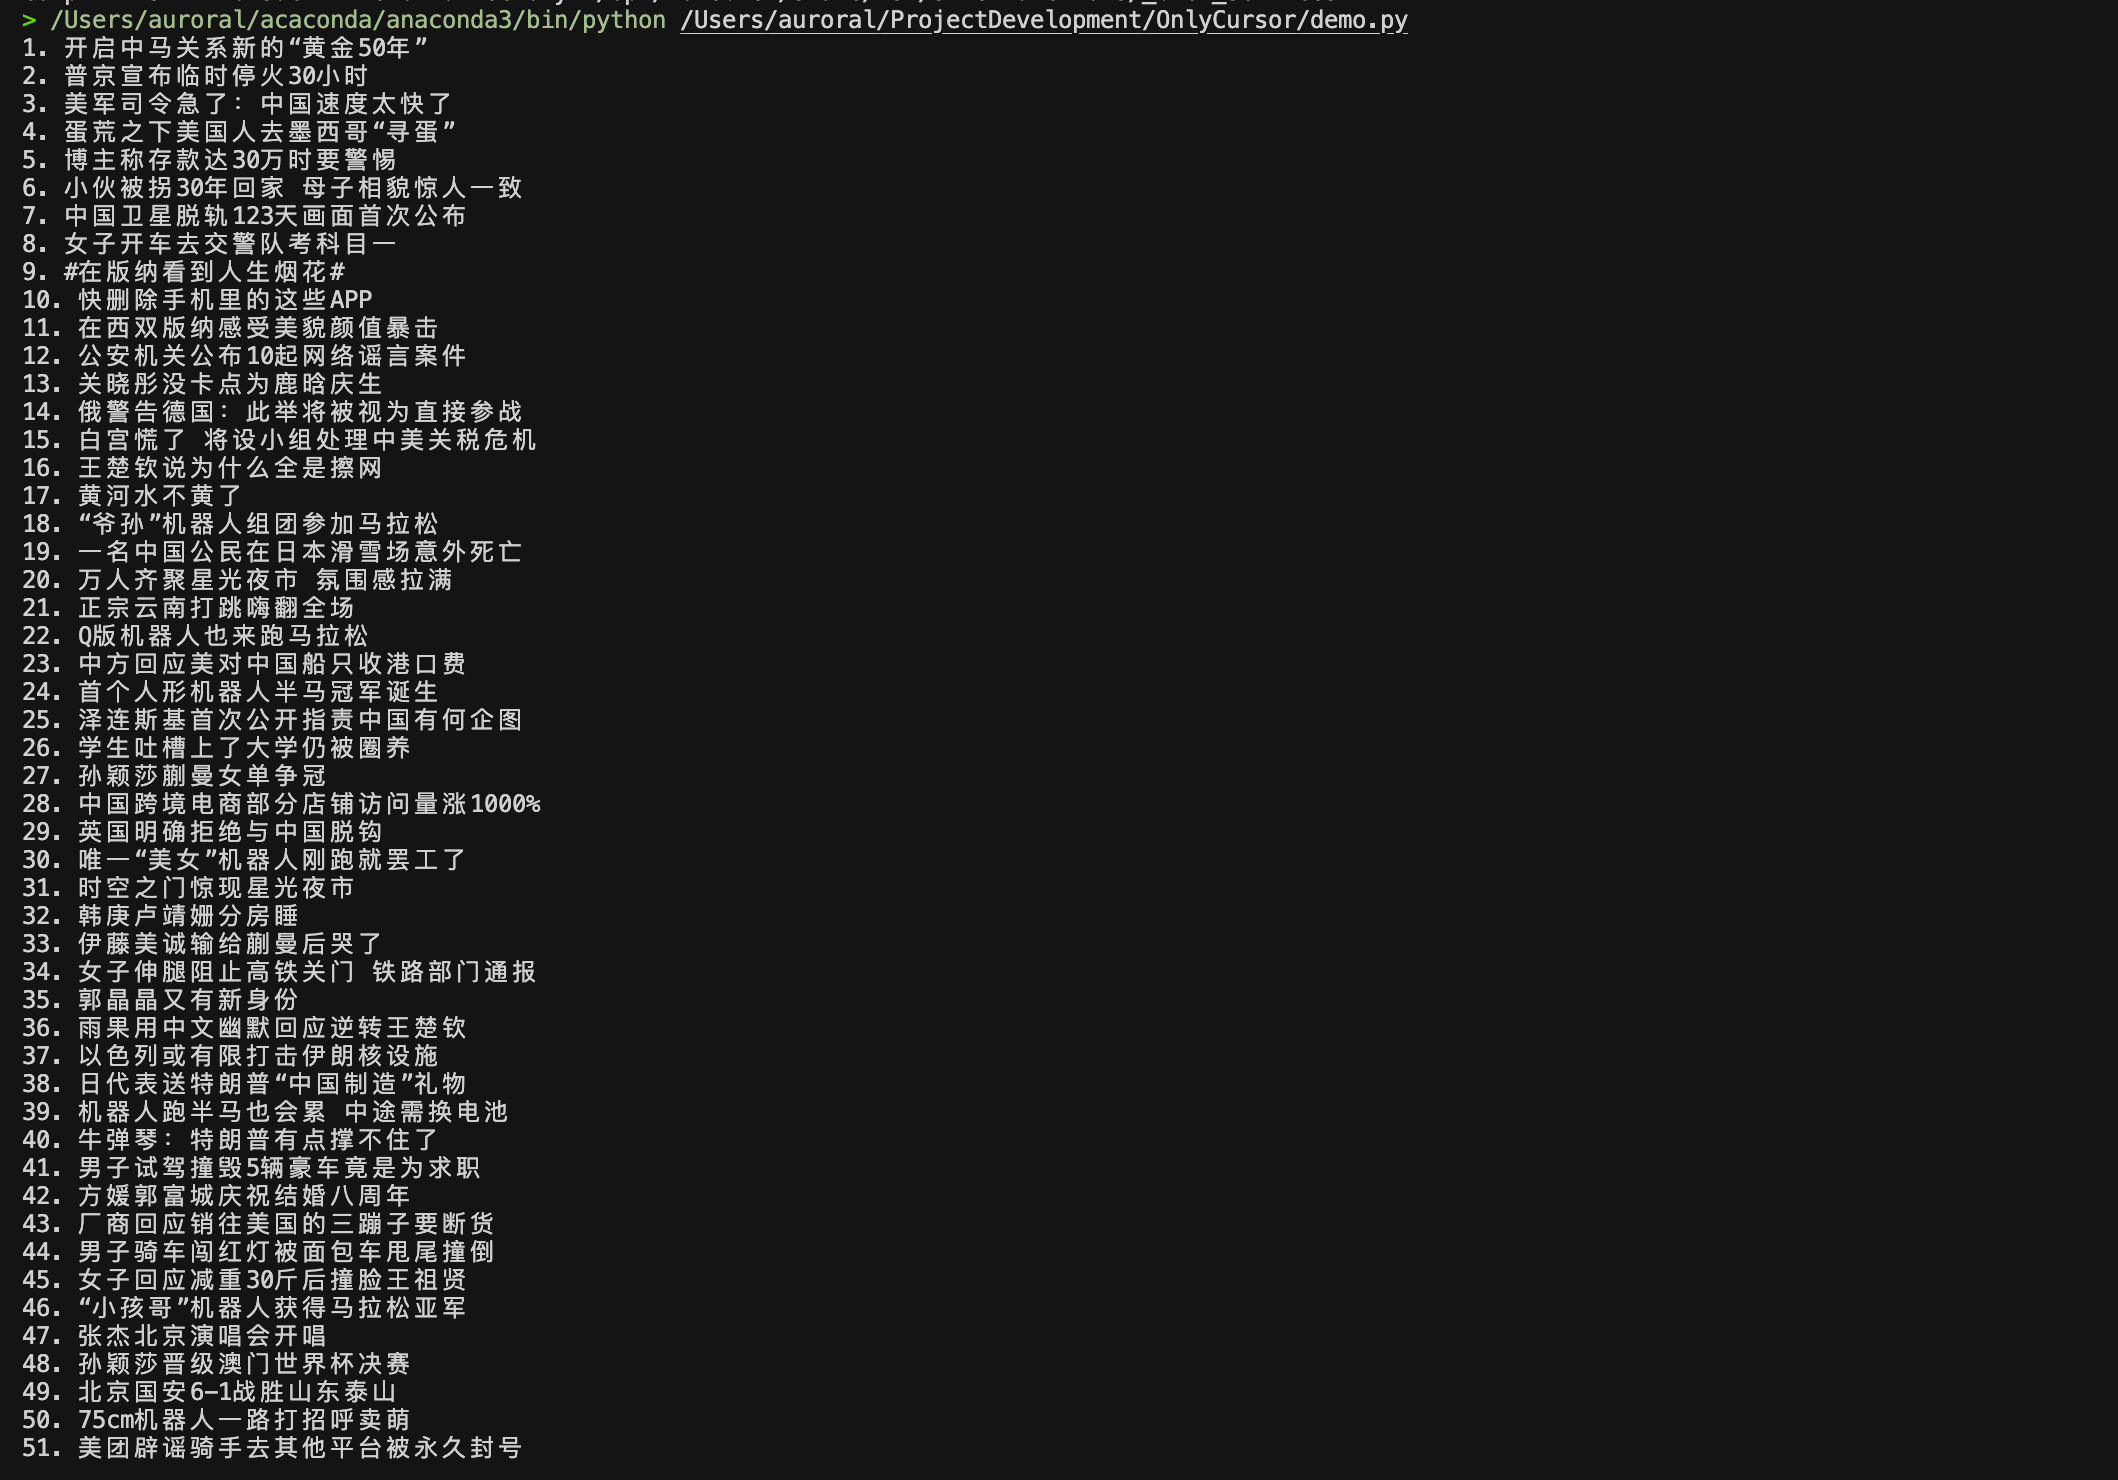
这个示例中我们使用requests库对百度热搜榜发起HTTP请求,获取页面的HTML内容。然后利用BeautifulSoup库(这是一个强大的HTML解析工具,后续博客会详细介绍)对获取的内容进行解析。通过选择器定位到热搜标题所在的元素(具有"c-single-text-ellipsis"类的div元素),我们能够准确提取出当前的热搜话题,并按顺序打印出来。代码中还添加了请求头信息和错误处理机制,确保爬取过程更加稳定可靠。
代码运行结果如下图所示:
虽然上面的例子很简单,但在实际开发爬虫时,我们需要考虑很多因素。接下来,让我们看看爬虫开发中需要注意的一些重要事项。
网络爬虫需要注意的重要事项
1. 法律与道德考量
- 尊重robots.txt:这是网站指定爬虫行为的标准文件,应当遵守。
- 识别网站的爬虫政策:有些网站明确禁止爬虫,有些则有特定的API可用。
- 避免过度请求:高频率的请求可能导致服务器负担过重。
- 遵守数据使用条款:确保你对抓取的数据的使用符合网站的条款。
- 注意个人隐私数据:不应爬取和存储涉及个人隐私的数据。
2. 技术注意事项
- 设置合理的请求间隔:使用
time.sleep()控制请求频率。 - 使用代理IP:避免IP被封禁。
- 模拟真实用户行为:添加请求头,随机调整请求间隔。
- 处理反爬机制:验证码识别、JavaScript渲染等。
- 异常处理:网络连接、解析错误等都需要妥善处理。
3. 性能考虑
- 异步爬取:使用
asyncio和aiohttp提高效率。 - 分布式爬取:对于大规模爬取任务,考虑使用多机协作。
- 数据存储优化:选择合适的存储方式(文件、数据库等)。
爬虫与反爬的攻防关系
随着互联网数据价值的不断提升,爬虫技术与反爬技术之间形成了一种此消彼长的攻防关系。这种关系呈现出明显的阶段性特征,从最初的简单对抗发展到如今的复杂博弈。
在早期阶段,爬虫通常以简单的HTTP请求方式获取网页内容,网站则主要通过访问频率限制来防御。爬虫工程师很快发现,只需在请求中添加随机延时就能有效规避这类限制。这种基础层面的对抗促使网站开发者升级防御策略。
随着对抗升级,网站开始实施更复杂的防御措施,例如检测请求头中的用户代理信息,以及限制单一IP的访问次数。爬虫技术随之调整,不仅能够伪装请求头信息,还发展出代理IP池技术,通过不断切换IP地址来绕过访问限制。这一阶段的特点是技术门槛明显提高,双方对抗更加精细化。
当前,我们已进入高级对抗阶段。网站普遍采用验证码挑战、前端JavaScript渲染数据以及用户行为分析等技术手段。爬虫则相应发展出验证码识别、浏览器自动化以及用户行为模拟等对抗技术。例如,Selenium和Puppeteer等工具能够模拟真实浏览器环境,执行JavaScript并渲染页面,而机器学习算法则用于识别各类验证码。
这种持续升级的攻防关系,某种程度上推动了双方技术的不断创新与进步。对于数据分析工作而言,理解这种技术演进对于构建稳定的数据获取渠道至关重要。
常见的Python爬虫库介绍
为了应对不同的爬取需求和反爬挑战,Python生态系统提供了多种爬虫相关的库。以下是一些最常用的工具:
| 库名 | 特点 | 适用场景 |
|---|---|---|
| Requests | 简单易用的HTTP库 | 基础网页获取 |
| BeautifulSoup | HTML/XML解析器 | 静态网页内容提取 |
| Scrapy | 全功能爬虫框架 | 大型爬虫项目 |
| Selenium | 浏览器自动化工具 | 需要JavaScript渲染的网页 |
| Pyppeteer | Puppeteer的Python版本 | 复杂的动态网页 |
| lxml | 高效的XML/HTML解析器 | 需要高性能解析的场景 |
| PyQuery | 类jQuery语法的解析库 | 熟悉jQuery的开发者 |
| aiohttp | 异步HTTP客户端/服务器 | 高并发爬虫 |
掌握了这些工具后,我们就能应对各种网页爬取的需求。爬虫技术的应用场景也非常广泛。
爬虫的应用场景
爬虫技术不仅仅是一种技术能力,更是解决各种数据获取需求的实用工具。以下是一些常见的应用场景:
- 数据分析与商业智能: 收集市场数据、竞品情报
- 搜索引擎: 建立网页索引和排名
- 学术研究: 获取大量研究数据
- 内容聚合: 新闻、价格比较等聚合服务
- 社交媒体监测: 舆情分析、品牌监控
- 机器学习训练数据: 为AI模型提供训练数据集
结语
Python爬虫技术为我们提供了一种强大的工具,可以自动化获取互联网上的各种信息。在掌握基础知识后,你可以创建从简单到复杂的各种爬虫程序,解决数据收集的需求。
在接下来的系列文章中,我们将深入探讨各种爬虫技术,从HTML结构的基本分析开始,逐步学习如何处理不同类型的网站、如何应对各种反爬措施,以及如何构建高效的大规模爬虫系统。
记住,强大的技术需要负责任地使用。合法合规的爬虫行为不仅能帮助你获取所需的数据,也能维护互联网的健康生态。
下一篇:【Python爬虫详解】第二篇:HTML结构的基本分析
 3680


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


