


- 🍨 本文为🔗365天深度学习训练营 中的学习记录博客
- 🍖 原作者:K同学啊 | 接辅导、项目定制
文章目录
前言
本文将采用CNN实现多云、下雨、晴、日出四种天气状态的识别。较上篇文章,本文为了增加模型的泛化能力,新增了Dropout层并且将最大池化层调整成了平均池化层。简单讲述实现代码与执行结果,并浅谈涉及知识点,涉及知识点包括。
关键字:pathlib的使用,tf.keras.preprocessing.image_dataset_from_directory() 简介,配置数据集,CNN网络模型结构,Dropout层 tf.keras.layers.Dropout() 介绍,编译参数。
一、我的环境
- 电脑系统:Windows 11
- 语言环境:python 3.8.6
- 编译器:pycharm
- 深度学习环境:TensorFlow 2.10.1
二、代码实现与执行结果
1.引入库
import PIL
from pathlib import Path
import tensorflow as tf
from tensorflow.keras import datasets, layers, models
import matplotlib.pyplot as plt
import warnings
warnings.filterwarnings('ignore')  # 忽略一些warning内容,无需打印
2.设置GPU(如果使用的是CPU可以忽略这步)
'''前期工作-设置GPU(如果使用的是CPU可以忽略这步)'''
gpus = tf.config.list_physical_devices("GPU")
if gpus:
    gpu0 = gpus[0]  # 如果有多个GPU,仅使用第0个GPU
    tf.config.experimental.set_memory_growth(gpu0, True)  # 设置GPU显存用量按需使用
    tf.config.set_visible_devices([gpu0], "GPU")
本人电脑无独显,故该步骤被注释,未执行。
3.导入数据
天气测试数据(提取码:hqij)
'''前期工作-导入数据'''
data_dir = "D:/DeepLearning/data/weather_photos/"
data_dir = Path(data_dir)
4.查看数据
'''前期工作-查看数据'''
# 数据集一共分为cloudy、rain、shine、sunrise四类,分别存放于weather_photos文件夹中以各自名字命名的子文件夹中。
image_count = len(list(data_dir.glob('*/*.jpg')))
print("图片总数为:", image_count)
roses = list(data_dir.glob('sunrise/*.jpg'))
image = PIL.Image.open(str(roses[0]))
# 查看图像实例的属性
print(image.format, image.size, image.mode)
plt.imshow(image)
plt.show()

5.加载数据
 '''数据预处理-加载数据'''
# 使用image_dataset_from_directory方法将磁盘中的数据加载到tf.data.Dataset中
batch_size = 32
img_height = 180
img_width = 180
"""
关于image_dataset_from_directory()的详细介绍可以参考文章:https://mtyjkh.blog.youkuaiyun.com/article/details/117018789
"""
train_ds = tf.keras.preprocessing.image_dataset_from_directory(
    data_dir,
    validation_split=0.2,
    subset="training",
    seed=123,
    image_size=(img_height, img_width),
    batch_size=batch_size)
"""
关于image_dataset_from_directory()的详细介绍可以参考文章:https://mtyjkh.blog.youkuaiyun.com/article/details/117018789
"""
val_ds = tf.keras.preprocessing.image_dataset_from_directory(
    data_dir,
    validation_split=0.2,
    subset="validation",
    seed=123,
    image_size=(img_height, img_width),
    batch_size=batch_size)

# 我们可以通过class_names输出数据集的标签。标签将按字母顺序对应于目录名称。
class_names = train_ds.class_names
print(class_names)
运行结果:
图片总数为: 1125
JPEG (750, 500) RGB
Found 1125 files belonging to 4 classes.
Using 900 files for training.
Found 1125 files belonging to 4 classes.
Using 225 files for validation.
['cloudy', 'rain', 'shine', 'sunrise']
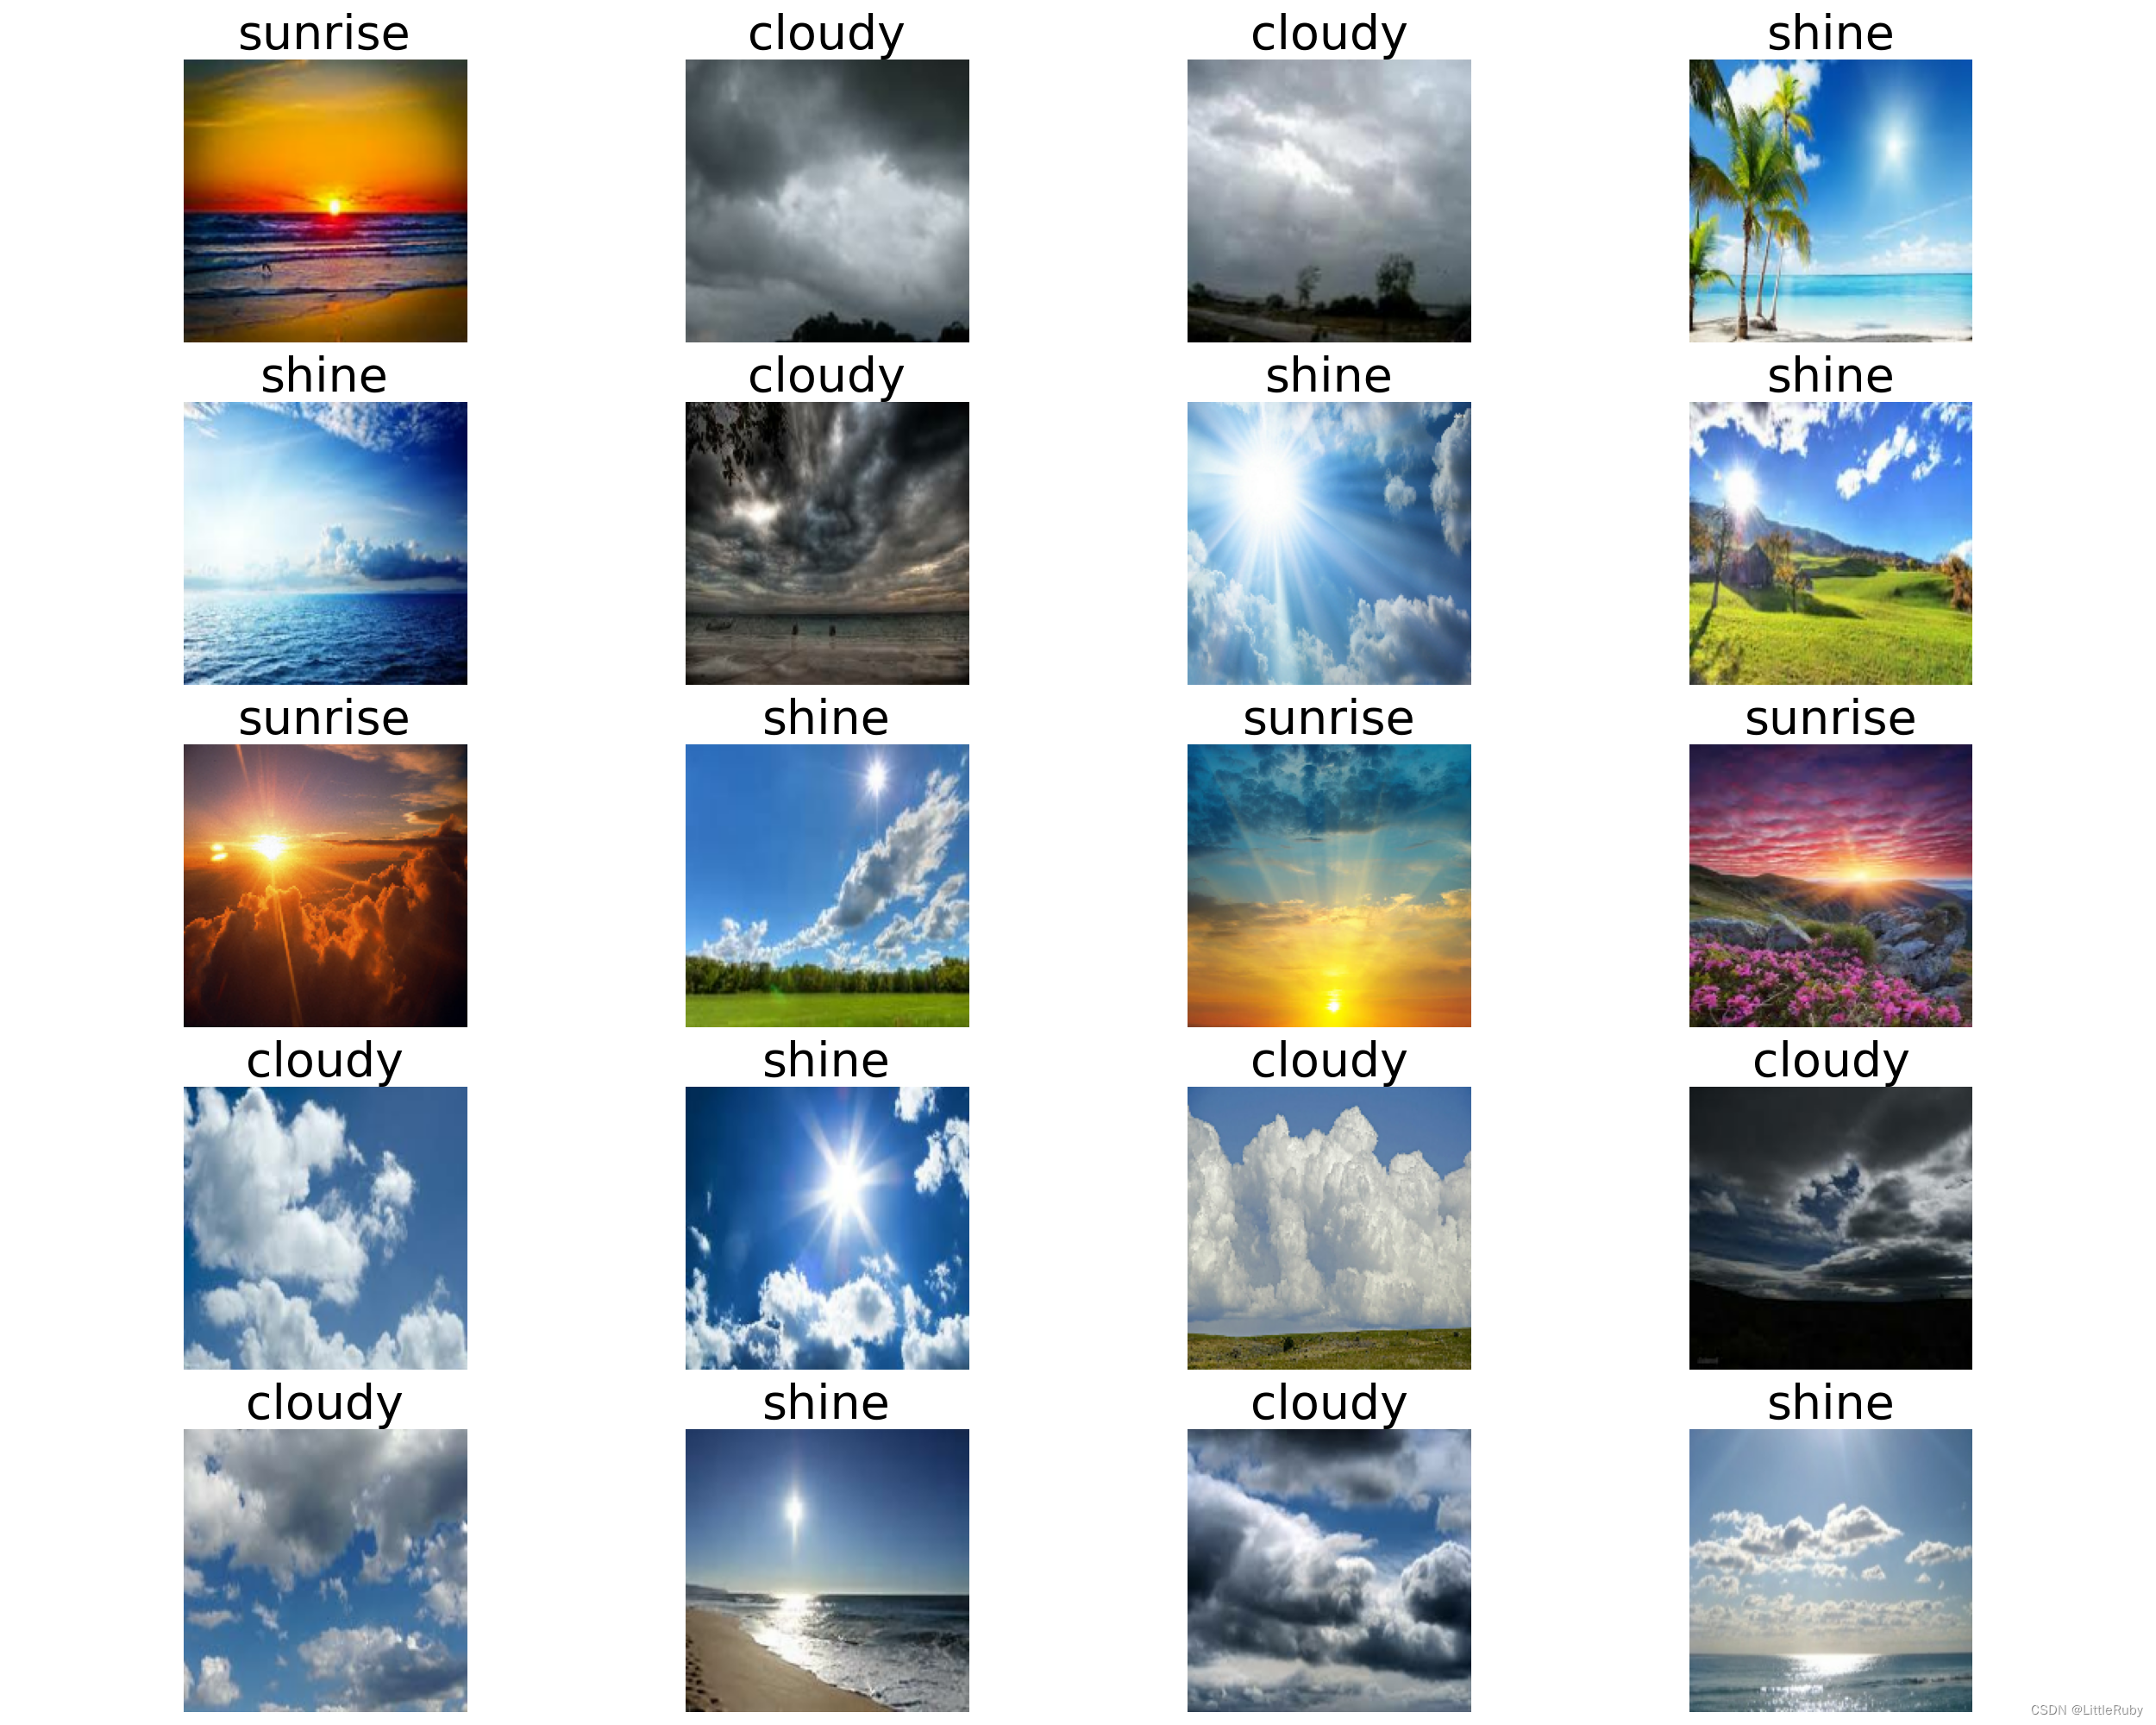
6.可视化数据
'''数据预处理-可视化数据'''
plt.figure(figsize=(25, 20))
for images, labels in train_ds.take(1):
    for i in range(20):
        ax = plt.subplot(5, 4, i + 1)
        plt.imshow(images[i].numpy().astype("uint8"))
        plt.title(class_names[labels[i]], fontsize=40)
        plt.axis("off")
# 显示图片
plt.show()
7.再次检查数据
'''数据预处理-再次检查数据'''
# Image_batch是形状的张量(32,180,180,3)。这是一批形状180x180x3的32张图片(最后一维指的是彩色通道RGB)。
# Label_batch是形状(32,)的张量,这些标签对应32张图片
for image_batch, labels_batch in train_ds:
    print(image_batch.shape)
    print(labels_batch.shape)
    break
运行结果
(32, 180, 180, 3)
(32,)
8.配置数据集
本人电脑无GPU加速,故并未起到加速作用
'''数据预处理-配置数据集'''
AUTOTUNE = tf.data.AUTOTUNE
# shuffle():打乱数据,关于此函数的详细介绍可以参考:https://zhuanlan.zhihu.com/p/42417456
# prefetch():预取数据,加速运行
# cache():将数据集缓存到内存当中,加速运行
train_ds = train_ds.cache().shuffle(1000).prefetch(buffer_size=AUTOTUNE)
val_ds = val_ds.cache().prefetch(buffer_size=AUTOTUNE)
9.构建CNN网络模型
'''构建CNN网络'''
num_classes = 4
"""
关于卷积核的计算不懂的可以参考文章:https://blog.youkuaiyun.com/qq_38251616/article/details/114278995
layers.Dropout(0.4) 作用是防止过拟合,提高模型的泛化能力。
在上一篇文章花朵识别中,训练准确率与验证准确率相差巨大就是由于模型过拟合导致的
关于Dropout层的更多介绍可以参考文章:https://mtyjkh.blog.youkuaiyun.com/article/details/115826689
"""
model = models.Sequential([
    layers.experimental.preprocessing.Rescaling(1. / 255, input_shape=(img_height, img_width, 3)),

    layers.Conv2D(16, (3, 3), activation='relu', input_shape=(img_height, img_width, 3)),  # 卷积层1,卷积核3*3
    layers.AveragePooling2D((2, 2)),  # 池化层1,2*2采样
    layers.Conv2D(32, (3, 3), activation='relu'),  # 卷积层2,卷积核3*3
    layers.AveragePooling2D((2, 2)),  # 池化层2,2*2采样
    layers.Conv2D(64, (3, 3), activation='relu'),  # 卷积层3,卷积核3*3
    layers.Dropout(0.3),  # 让神经元以一定的概率停止工作,防止过拟合,提高模型的泛化能力。

    layers.Flatten(),  # Flatten层,连接卷积层与全连接层
    layers.Dense(128, activation='relu'),  # 全连接层,特征进一步提取
    layers.Dense(num_classes)  # 输出层,输出预期结果
])
model.summary()  # 打印网络结构
网络结构结果如下:
Model: "sequential"
_________________________________________________________________
 Layer (type)                Output Shape              Param #
=================================================================
 rescaling (Rescaling)       (None, 180, 180, 3)       0

 conv2d (Conv2D)             (None, 178, 178, 16)      448

 average_pooling2d (AverageP  (None, 89, 89, 16)       0
 ooling2D)

 conv2d_1 (Conv2D)           (None, 87, 87, 32)        4640

 average_pooling2d_1 (Averag  (None, 43, 43, 32)       0
 ePooling2D)

 conv2d_2 (Conv2D)           (None, 41, 41, 64)        18496

 dropout (Dropout)           (None, 41, 41, 64)        0

 flatten (Flatten)           (None, 107584)            0

 dense (Dense)               (None, 128)               13770880

 dense_1 (Dense)             (None, 4)                 516

=================================================================
Total params: 13,794,980
Trainable params: 13,794,980
Non-trainable params: 0
10.编译模型
'''编译模型'''
# 设置优化器
opt = tf.keras.optimizers.Adam(learning_rate=0.001)
model.compile(optimizer=opt,
              loss=tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True),
              metrics=['accuracy'])
11.训练模型
'''训练模型'''
epochs = 10
history = model.fit(
    train_ds,
    validation_data=val_ds,
    epochs=epochs
训练记录如下:
Epoch 1/10
29/29 [==============================] - 8s 219ms/step - loss: 1.3720 - accuracy: 0.6022 - val_loss: 0.5899 - val_accuracy: 0.7333
Epoch 2/10
29/29 [==============================] - 6s 200ms/step - loss: 0.5170 - accuracy: 0.8256 - val_loss: 0.5279 - val_accuracy: 0.7689
Epoch 3/10
29/29 [==============================] - 6s 207ms/step - loss: 0.4007 - accuracy: 0.8711 - val_loss: 0.5166 - val_accuracy: 0.7822
Epoch 4/10
29/29 [==============================] - 7s 248ms/step - loss: 0.3768 - accuracy: 0.8511 - val_loss: 0.5604 - val_accuracy: 0.7733
Epoch 5/10
29/29 [==============================] - 8s 292ms/step - loss: 0.2884 - accuracy: 0.8978 - val_loss: 0.5355 - val_accuracy: 0.7956
Epoch 6/10
29/29 [==============================] - 9s 297ms/step - loss: 0.2292 - accuracy: 0.9122 - val_loss: 0.4942 - val_accuracy: 0.8400
Epoch 7/10
29/29 [==============================] - 8s 290ms/step - loss: 0.1475 - accuracy: 0.9511 - val_loss: 0.5258 - val_accuracy: 0.8311
Epoch 8/10
29/29 [==============================] - 9s 294ms/step - loss: 0.1177 - accuracy: 0.9622 - val_loss: 0.5492 - val_accuracy: 0.8311
Epoch 9/10
29/29 [==============================] - 9s 301ms/step - loss: 0.1156 - accuracy: 0.9644 - val_loss: 0.4820 - val_accuracy: 0.8267
Epoch 10/10
29/29 [==============================] - 9s 302ms/step - loss: 0.0895 - accuracy: 0.9700 - val_loss: 0.6318 - val_accuracy: 0.8000
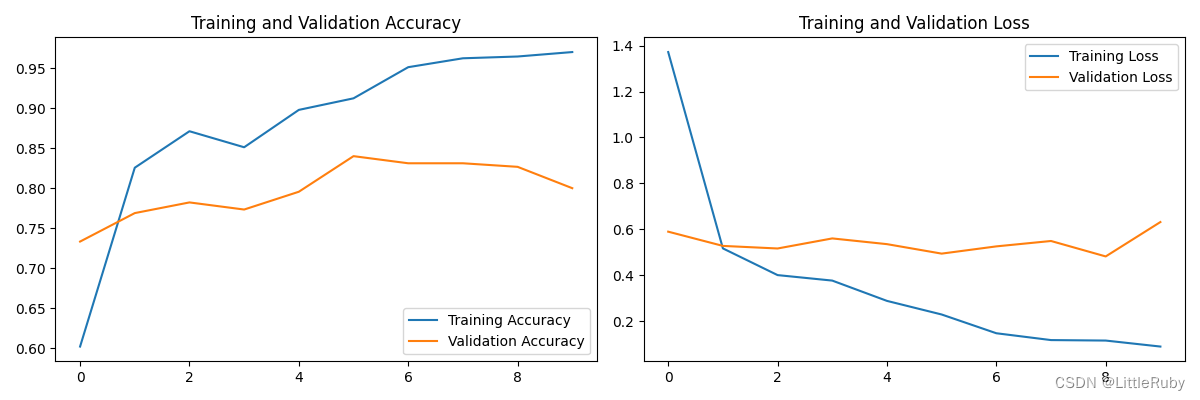
12.模型评估
'''模型评估'''
acc = history.history['accuracy']
val_acc = history.history['val_accuracy']
loss = history.history['loss']
val_loss = history.history['val_loss']
epochs_range = range(epochs)
plt.figure(figsize=(12, 4))
plt.subplot(1, 2, 1)
plt.plot(epochs_range, acc, label='Training Accuracy')
plt.plot(epochs_range, val_acc, label='Validation Accuracy')
plt.legend(loc='lower right')
plt.title('Training and Validation Accuracy')
plt.subplot(1, 2, 2)
plt.plot(epochs_range, loss, label='Training Loss')
plt.plot(epochs_range, val_loss, label='Validation Loss')
plt.legend(loc='upper right')
plt.title('Training and Validation Loss')
plt.show()
执行结果
三、知识点详解
1.pathlib的使用
pathlib 不直接访问 OS 来操作 path,占内存少, 不用考虑底层是Linux还是Windows, 使代码可移植性更佳。
pathlib 模块从 python3.4 开始,到 python3.6 已经比较成熟。
# pathlib常用命令
from pathlib import Path

print("当前路径:", Path.cwd())
print("上层目录:", Path.cwd().parent)
print("上上层目录:", Path.cwd().parent.parent)
print("绝对路径:", Path(r"..\data\weather_photos").resolve())
path = Path(__file__).resolve()
print("当前文件:", path)
print("文件名(不带扩展名):", path.stem)
print("文件名全名:", path.name)
print("文件名后缀:", path.suffix)
print("文件路径分解上层目录:", path.parents[0])
print("文件路径分解上上层目录:", path.parents[1])
print("路径拼接1:", path.parents[1] / "abc" / "de.txt")
print("路径拼接2:", path.parents[1].joinpath("abc", "de.txt"))
print("路径是否存在:", path.exists())
print("是否为目录:", path.is_dir())
print("是否为文件:", path.is_file())
path1=Path(r"D:\DeepLearning\abcd\a")
path2=Path(r"D:\DeepLearning\abcd\a.txt")
print(r"写文件D:\DeepLearning\abcd\a.txt",path2.write_text('Text file contents'))
print(r"删除文件:\DeepLearning\abcd\a.txt:", path2.unlink(missing_ok=False))  #默认 missing_ok = False, 如果文件不存在,会产生 FileNotFoundError 异常,设置为True, 则忽略该异常。
print(r"创建文件夹D:\DeepLearning\abcd\a:", path1.mkdir(parents=True, exist_ok=True)) # parents = True: 创建中间级父目录,exist_ok= True: 目标目录存在时不报错
print(r"删除文件夹,文件夹必须为空D:\DeepLearning\abcd\a:", path1.rmdir())
print("type(Path.cwd():", type(Path.cwd()))
print("type(str(type(Path.cwd()))):", type(str(type(Path.cwd()))))
# rglob()是递归的,glob()不是
p = Path.cwd()
print("type(p.glob(\"*\")):", type(p.glob("*")))
print("type(list(p.glob(\"*\"))):", type(list(p.glob("*"))))
print("Path模块下的 glob(*),当前目录中的所有文件和文件夹:")
for i in p.glob("*"):
    print(i)
print("\nPath模块下的 glob(**),当前目录及其下所有子目录中的所有文件夹:")
for i in p.glob("**"):
    print(i)
print("\nPath模块下的 rglob(*),当前目录及所有子目录中的所有文件和文件夹:")
for i in p.rglob("*"):
    print(i)
print(f"\nPath模块下的 rglob(**),当前目录及其下所有子目录中的所有文件夹,相当于 glob(**):")
for i in p.rglob("**"):
    print(i)
参考链接:
Python Pathlib与os浅析对比
Python开发中使用 pathlib 模块高效地操作目录及文件
Python路径操作模块pathlib
2.tf.keras.preprocessing.image_dataset_from_directory() 简介
函数原型
tf.keras.preprocessing.image_dataset_from_directory(
    directory,
    labels="inferred",
    label_mode="int",
    class_names=None,
    color_mode="rgb",
    batch_size=32,
    image_size=(256, 256),
    shuffle=True,
    seed=None,
    validation_split=None,
    subset=None,
    interpolation="bilinear",
    follow_links=False,
)
官网地址:https://tensorflow.google.cn/api_docs/python/tf/keras/preprocessing/image_dataset_from_directory
作用
将文件夹中的数据加载到tf.data.Dataset中,且加载的同时会打乱数据。
注: 如果你的目录结构是:
main_directory/
…class_a/
…a_image_1.jpg
…a_image_2.jpg
…class_b/
…b_image_1.jpg
…b_image_2.jpg
然后调用 image_dataset_from_directory(main_directory, labels=‘inferred’) 将返回一个tf.data.Dataset, 该数据集从子目录class_a和class_b生成批次图像,同时生成标签0和1(0对应class_a,1对应class_b),
支持的图像格式:jpeg, png, bmp, gif. 动图被截断到第一帧。
参数
- directory: 数据所在目录。如果标签是inferred(默认),则它应该包含子目录,每个目录包含一个类的图像。否则,将忽略目录结构。
- labels: inferred(标签从目录结构生成),或者是整数标签的列表/元组,其大小与目录中找到的图像文件的数量相同。标签应根据图像文件路径的字母顺序排序(通过Python中的os.walk(directory)获得)。
- label_mode:
int:标签将被编码成整数(使用的损失函数应为:sparse_categorical_crossentropy loss)。- categorical:标签将被编码为分类向量(使用的损失函数应为:categorical_crossentropy loss)。
- binary:意味着标签(只能有2个)被编码为值为0或1的float32标量(例如:binary_crossentropy)。
None:(无标签)。- class_names: 仅当labels为inferred时有效。这是类名称的明确列表(必须与子目录的名称匹配)。用于控制类的顺序(否则使用字母数字顺序)。
- color_mode: grayscale、rgb、rgba之一。默认值:rgb。图像将被转换为1、3或者4通道。
- batch_size: 数据批次的大小。默认值:32
- image_size: 从磁盘读取数据后将其重新调整大小。默认:(256,256)。由于管道处理的图像批次必须具有相同的大小,因此该参数必须提供。
- shuffle: 是否打乱数据。默认值:True。如果设置为False,则按字母数字顺序对数据进行排序。
- seed: 用于shuffle和转换的可选随机种子。
- validation_split: 0和1之间的可选浮点数,可保留一部分数据用于验证。
- subset: training或validation之一。仅在设置validation_split时使用。
- interpolation: 字符串,当调整图像大小时使用的插值方法。默认为:bilinear。支持bilinear, nearest, bicubic, area, lanczos3, lanczos5, gaussian, mitchellcubic。
follow_links: 是否访问符号链接指向的子目录。默认:False。
Returns
一个tf.data.Dataset对象。
- 如果label_mode为None,它将生成float32张量,其shape为(batch_size, image_size[0], image_size(1), num_channels),并对图像进行编码。
否则,将生成一个元组(images, labels),其中图像的shape为(batch_size, image_size[0], image_size(1), num_channels),并且labels遵循下面描述的格式。
关于labels格式规则:- 如果label_mode 是 int, labels是形状为(batch_size, )的int32张量
- 如果label_mode 是 binary, labels是形状为(batch_size, 1)的1和0的float32张量。
- 如果label_mode 是 categorial, labels是形状为(batch_size, num_classes)的float32张量,表示类索引的one-hot编码。
有关生成图像中通道数量的规则:
- 如果color_mode 是 grayscale, 图像张量有1个通道。
- 如果color_mode 是 rgb, 图像张量有3个通道。
- 如果color_mode 是 rgba, 图像张量有4个通道。
参考链接
tf.keras.preprocessing.image_dataset_from_directory() 简介
3.配置数据集
● shuffle():打乱数据,关于此函数的详细介绍可以参考:https://zhuanlan.zhihu.com/p/42417456
● prefetch():预取数据,加速运行
prefetch()功能详细介绍:CPU 正在准备数据时,加速器处于空闲状态。相反,当加速器正在训练模型时,CPU 处于空闲状态。因此,训练所用的时间是 CPU 预处理时间和加速器训练时间的总和。prefetch()将训练步骤的预处理和模型执行过程重叠到一起。当加速器正在执行第 N 个训练步时,CPU 正在准备第 N+1 步的数据。这样做不仅可以最大限度地缩短训练的单步用时(而不是总用时),而且可以缩短提取和转换数据所需的时间。如果不使用prefetch(),CPU 和 GPU/TPU 在大部分时间都处于空闲状态,无GPU/TPU加速时,prefetch()不起作用。
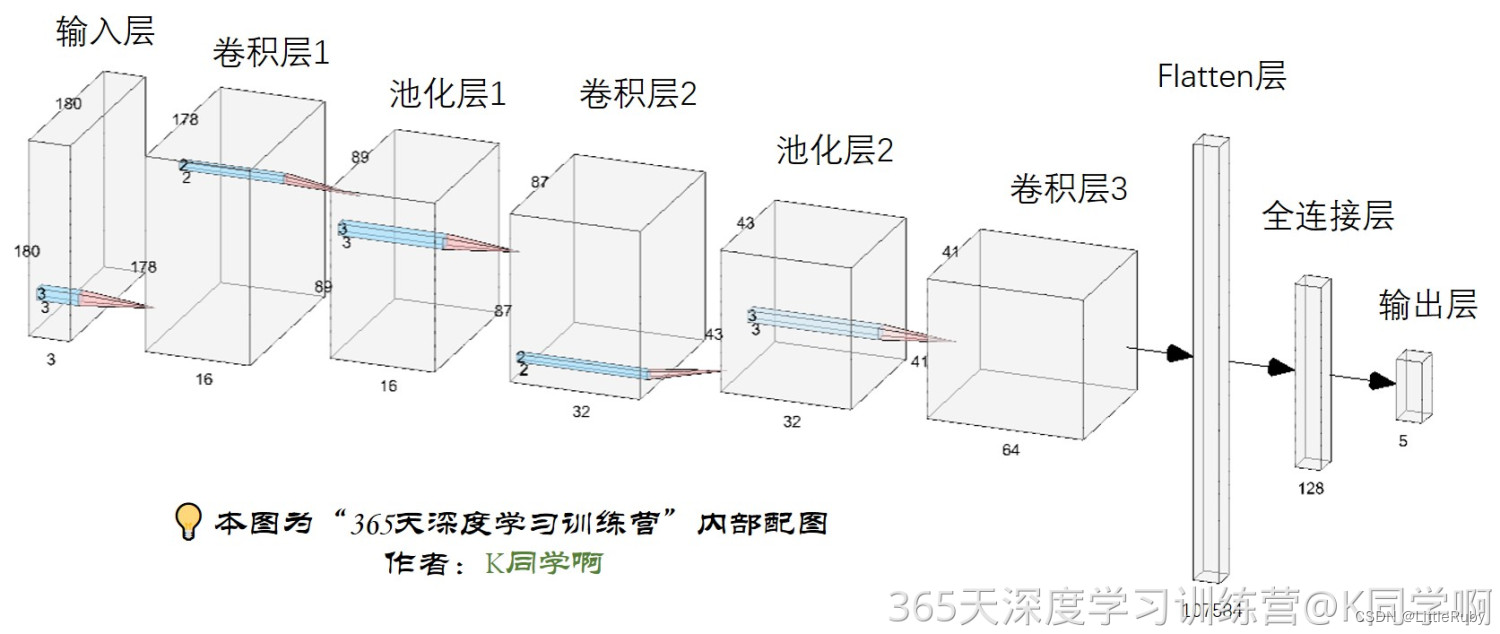
3.CNN网络模型结构
本文网络模型按一下方式构建:
4.Dropout层 tf.keras.layers.Dropout() 介绍
函数原型
tf.keras.layers.Dropout(rate, noise_shape=None, seed=None, **kwargs)
官网地址:https://tensorflow.google.cn/api_docs/python/tf/keras/layers/Dropout
作用
防止过拟合,提高模型的泛化能力。
参数
rate:0~1之间的小数。让神经元以一定的概率rate停止工作,提高模型的泛化能力。
noise_shape:1D张量类型,int32表示将与输入相乘的二进制丢失掩码的形状;例如,如果您的输入具有形状(batch_size, timesteps, features),并且你希望所有时间步长的丢失掩码相同,则可以使用noise_shape=[batch_size, 1, features],就是哪一个是1,那么就在哪一维度按照相同的方式dropout,如果没有1就是普通的。
这个参数有篇文章我觉得解释的很好,dropout中的noise_shape参数的作用
seed:随机种子
参考链接
Dropout层 tf.keras.layers.Dropout() 介绍
5.编译参数
在准备对模型进行训练之前,还需要再对其进行一些设置。以下内容是在模型的编译步骤中添加的:
● 损失函数(loss):用于衡量模型在训练期间的准确率。
● 优化器(optimizer):决定模型如何根据其看到的数据和自身的损失函数进行更新。
● 指标(metrics):用于监控训练和测试步骤。以下示例使用了准确率,即被正确分类的图像的比率。
总结
通过本次的学习,能通过tenserflow框架创建cnn网络模型进行天气识别,并了解到pathlib在文件操作中的应用,学会image_dataset_from_directory()的方式加载训练及验证数据,知道在使用GPU或TPU加速时,可采用prefetch的方式预取数据,节约时间,新增dropout层为了防止过拟合。
 1万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


