scrapy框架爬取虎扑论坛球队新闻

python爬虫,爬取虎扑网新闻 以前写过的代码过一段时间就会忘记,需要按时复习 最近闲来无事,写了一个简单的爬虫程序,无奈知识遗忘太快,竟然花了我好长时间 女票喜欢库里,但无奈库里新闻太少,只好爬一波勇士队消息 【女票是不会喜欢从文件中看信息的。。。但我还是要写】# -*- coding:utf-8 -*-  import requests from bs4 import BeautifulSoup import re im 阅读详情

目录

Scrapy 框架

制作 Scrapy 爬虫 一共需要4步:

Scrapy的安装介绍

Windows 安装方式

一. 新建项目(scrapy startproject)

二、明确目标(mySpider/items.py)

三、制作爬虫 (spiders/itcastSpider.py)

1. 爬数据

2. 取数据

Item Pipeline

编写pipeline.py


用python爬虫scrapy框架爬取虎扑论坛的30支球队新闻

Scrapy 框架

  • Scrapy是用纯Python实现一个为了爬取网站数据、提取结构性数据而编写的应用框架,用途非常广泛。

  • 框架的力量,用户只需要定制开发几个模块就可以轻松的实现一个爬虫,用来抓取网页内容以及各种图片,非常之方便。

  • Scrapy 使用了 Twisted['twɪstɪd](其主要对手是Tornado)异步网络框架来处理网络通讯,可以加快我们的下载速度,不用自己去实现异步框架,并且包含了各种中间件接口,可以灵活的完成各种需求。

制作 Scrapy 爬虫 一共需要4步:

  • 新建项目 (scrapy startproject xxx):新建一个新的爬虫项目
  • 明确目标 (编写items.py):明确你想要抓取的目标
  • 制作爬虫 (spiders/xxspider.py):制作爬虫开始爬取网页
  • 存储内容 (pipelines.py):设计管道存储爬取内容

Scrapy的安装介绍

Scrapy框架官方网址:http://doc.scrapy.org/en/latest

Scrapy中文维护站点:http://scrapy-chs.readthedocs.io/zh_CN/latest/index.html

Windows 安装方式

  • Python 2 / 3
  • 升级pip版本:pip install --upgrade pip
  • 通过pip 安装 Scrapy 框架pip install Scrapy

一. 新建项目(scrapy startproject)

  • 在开始爬取之前,必须创建一个新的Scrapy项目。进入自定义的项目目录中,运行下列命令:
     scrapy startproject HupuSpider
  • 其中, HupuSpider为项目名称(自定义),可以看到 将会创建一个 HupuSpider文件夹,目录结构大致如下:
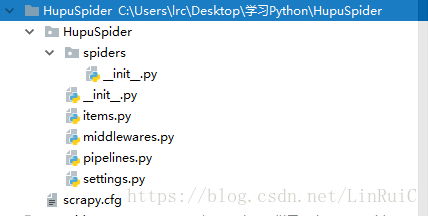


下面来简单介绍一下各个主要文件的作用:

 scrapy.cfg :项目的配置文件

 mySpider/ :项目的Python模块,将会从这里引用代码

 mySpider/items.py :项目的目标文件

 mySpider/pipelines.py :项目的管道文件

 mySpider/settings.py :项目的设置文件

 mySpider/spiders/ :存储爬虫代码目录

二、明确目标(mySpider/items.py)

我们打算抓取:https://voice.hupu.com/nba 网站里的30支球队新闻内容以及新闻配图。

  1. 打开mySpider目录下的items.py

  2. Item 定义结构化数据字段,用来保存爬取到的数据,有点像Python中的dict,但是提供了一些额外的保护减少错误。

  3. 可以通过创建一个 scrapy.Item 类, 并且定义类型为 scrapy.Field的类属性来定义一个Item(可以理解成类似于ORM的映射关系)。

  4. 接下来,创建一个HupuSpiderItem类,和构建item模型(model)。

    class HupuspiderItem(scrapy.Item):
        # 球队名称
        teamname = scrapy.Field()
        # 球队url
        teamurl = scrapy.Field()
        # 新闻标题
        newstitle=scrapy.Field()
        # 新闻链接
        newsurl=scrapy.Field()
        # 新闻内容
        content=scrapy.Field()
        # 新闻配图url
        imageurl=scrapy.Field()

三、制作爬虫 (spiders/itcastSpider.py)

爬虫功能要分两步:

1. 爬数据

  • 在当前目录下输入命令,将在mySpider/spider目录下创建一个名为nba_news的爬虫,并指定爬取域的范围:
    scrapy genspider nba_news "hupu.com"
  • 打开 mySpider/spider目录里的 nba_news
Scrapy爬虫实战—虎扑步行街发帖爬取 0. 前言 在B站上看了黑马的scrapy,老师讲的超细致,赞! 本文主要用scrapy的基本操作完成爬取,适合入门级学习。 1. scrapy scrapy有很多命令,在terminal输入scrapy可以看到 这里我们主要用startproject来创建整个项目,genspider生成爬虫,完成编程以后再crawl一下即可。 首先:scrapy startproject XXXX 就可以在本... 阅读详情

相关推荐

【项目实战】使用urllib爬取虎扑首页的所有新闻

虎扑是我从高中就开始关注的网站,学习了网络爬虫后,写一个小程序来爬取虎扑首页的所有新闻,其中使用了urllib,正则表达式。防止爬虫被识别出来,将爬虫伪装成浏览器,下面直接上代码。    import urllib.request import re import ssl #全局取消证书验证,避免SSL: CERTIFICATE_VERIFY_FAILED ssl._create_defau

mxt的博客 493

python网络爬虫-爬取虎扑步行街数据

前言 由于虎扑页面的限制,因为访问虎扑步行街的第11个页面就需要用户进行登录,鉴于此时技术还没有学全,只能爬取1到10的页面。 抓取什么数据 帖子名称 帖子链接 发帖人 发帖人链接 发帖时间 帖子回复数 帖子浏览数 最后回复帖子的人 最后回复的时间 如何抓取数据 首先我们发现这个页面是用gzip进行压缩的,gzip是用utf-8进行编码的,也就是我们抓取的页面是用utf-8编码的,而r.t...

weixin_42100456的博客 1686

Python 爬虫深度实践:虎扑论坛热帖数据全方位爬取指南

在数据驱动的当今时代,网络爬虫成为了获取海量信息的关键技术之一。虎扑论坛,作为体育迷们热衷交流的社区,其中蕴含的丰富热帖数据对于分析体育热点、粉丝行为等极具价值。本文将带领各位深度探索运用 Python 爬虫全方位爬取虎扑论坛热帖数据的完整过程,从基础环境搭建到进阶数据处理,关键步骤层层剖析,让大家轻松掌握这一实用技能。

u014481728的博客 310

python scrapy爬虫爬取虎扑NBA新闻前十页,以及所有现役球星信息虎扑

运行scrapy,可获得虎扑NBA新闻前十页信息以及现役所有NBA球员信息,还有flask把获取的数据渲染出来

《工程测量学》笔记/期末复习资料

《工程测量学》笔记/期末复习资料。

@HNUSTer的博客 5562

基于STM32的多路火灾报警系统设计

本文设计了一款基于STM32的多路火灾报警系统,利用多个传感器组合(如烟雾传感器、温度传感器等)进行数据采集与处理,精确判断火灾情况,并及时发出报警信号,保障生命与财产安全。本系统设计了一款基于STM32的多路火灾报警系统,通过结合烟雾传感器和温度传感器,提升了火灾检测的准确性和可靠性。未来,系统可以进一步集成更多传感器,如气体传感器、湿度传感器等,进一步提升火灾报警系统的智能化水平。本系统采用STM32F103单片机作为核心处理单元,结合烟雾传感器、温度传感器和报警模块,实现多通道火灾报警功能。

stm32d1219的博客 2029

STM32 ST-LINK Utility 无法烧录程序的解决方法

当你打开STM32 ST-LINK Utility,硬件连接好st-link V2,打开了要烧写的文件,点那个Program verify烧录时, 如果出错了: Programming error @ 0x08000000! 我的方法是: 点你想要烧录那个HEX文件的小格,复制 然后去到你前面的文件的格子里,点粘贴: 成功! ...

wocute的博客 9521

PICO+Unity MR空间网格开发实战:从零构建透视交互场景

本文详细介绍了使用PICO 4 Ultra与Unity引擎进行MR空间网格开发的完整实战流程。从环境准备、项目初始化、核心组件配置,到空间网格的生成、可视化与物理交互实现,手把手教你构建一个能识别真实环境并发射虚拟小球的透视交互场景。文章重点解析了PICO SDK中空间网格功能的关键配置与优化技巧,并提供了真机部署与调试的实用指南。

e3f4g5的博客 490

使用 Simulink + Simscape Electrical 实现一个变压器耦合式单相全波整流器的仿真模型

本文介绍了基于Simulink的变压器耦合式单相全波整流器建模与仿真方法。详细说明了从项目创建、模块添加、电路搭建到参数配置的完整建模过程,重点分析了整流器的效率与损耗特性,包括变压器损耗和二极管导通损耗。通过仿真展示了输入输出波形特征,并提出了选用高效元件、优化变压器设计等改进建议。该案例为电力电子系统建模提供了实用参考,有助于深入理解整流电路工作原理和性能优化方法。

amy_mhd的博客 186

华为OD机试 双机位A卷 - 流量波峰 (C++ & Python & JAVA & JS & GO)

华为OD机试双机位A卷 流量波峰,提供Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解

qq_45776114的博客 1377

8.5华为OD机试真题 新系统 - 最长不连续子串 (Java/Py/C/C++/Js/Go)

8.5华为OD机试真题 新系统 - 最长不连续子串 (Java/Py/C/C++/Js/Go)

算法大师! 626

地统计插值学习心得(一)

(创建地统计图层工具用于根据现有的地统计图层或者地统计模型来创建包含新要素数据集的地统计图层,也就是使用构建好的地统计模型用到新的数据集中)这表明,远离极值的区域预测不受极值的影响,并且还表明,包括极值会导致钼元素浓度高的区域周围的预测明显变高。通常,我们使用同一个数据集进行建模和预测,但是在实际插值过程中,这两步的数据可以是不同的,这就是处理极值的诀窍。如果你的数据集有无法忽略的极值时(比如这些钼元素浓度),一种常见的方法是首先显式移除极值进行建模,然后在预测中使用整个数据集(包括极值)。

JData_Engineer的博客 286

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

下一篇: python实现简单翻译软件
爱做呢!~
博客等级 码龄10年 88粉丝 35原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
