2025版最新大模型微调方法汇总,零基础入门到精通,收藏这篇就够了

大模型微调的几种常见方法 在文章《深入理解大语言模型微调技术》中,我们详细了解大语言模型微调的概念和训练过程,本篇给大家介绍大模型微调常见的7种训练方法。 阅读详情

全量微调

主要思路:在预训练模型的每一层(或某些层)中添加适配器模块,微调时冻结预训练模型主体,由适配器模块学习特定下游任务的知识。每个适配器模块由两个前馈子层组成,第一个前馈子层将模型的输出作为输入,将原始输入维度投影到一个较小的维度,第二个前馈子层再将其还原到原始输入维度作为输出。因为对模型的所有参数进行了调整,所以可以充分利用预训练模型的通用特征,能够较好地适应特定任务,在一些情况下可以获得较高的性能表现。例如,在图像分类任务中,如果有足够的计算资源和数据,全量微调可以使模型对特定类别的识别准确率大幅提高。

但计算成本较高,需要大量的计算资源和时间来训练模型,尤其是对于非常大的模型。而且,如果特定任务的数据量较少,可能会导致过拟合的问题。

基于适配器的微调

在预训练的大型模型基础上,对模型的所有层和参数进行调整,使其适应特定任务。在这个过程中,模型会根据特定任务的数据重新学习和更新所有的权重参数,以达到更好地完成该任务的目的。

优点是因为对模型的所有参数进行了调整,所以可以充分利用预训练模型的通用特征,能够较好地适应特定任务,在一些情况下可以获得较高的性能表现。例如,在图像分类任务中,如果有足够的计算资源和数据,全量微调可以使模型对特定类别的识别准确率大幅提高。

缺点是计算成本较高,需要大量的计算资源和时间来训练模型,尤其是对于非常大的模型。而且,如果特定任务的数据量较少,可能会导致过拟合的问题。
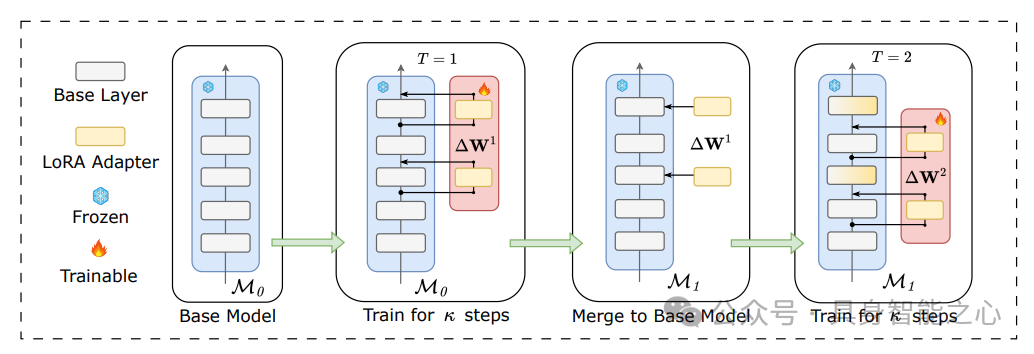
基于低秩适应(LoRA)的微调

LoRA的实现思想很简单,如下图所示,就是冻结一个预训练模型的矩阵参数,并选择用A和B矩阵来替代,在下游任务时只更新A和B。

基于提示学习(Prompt Tuning)的微调

通过在输入文本中添加提示信息,引导模型更好地理解任务,并根据提示信息进行预测。提示信息可以是一些特定的文本片段、关键词或者问题模板等,其目的是将下游任务转化为与预训练模型的预训练任务相似的形式,以便模型能够更好地利用预训练的知识。

主要优势是不需要对模型的结构进行修改,只需要在输入层进行操作,因此非常简单方便。同时,提示学习可以灵活地应用于各种不同的任务,具有较强的通用性。

缺点是提示的设计需要一定的经验和技巧,不同的提示可能会对模型的性能产生较大的影响。而且,如果提示信息与模型的预训练知识不匹配,可能会导致性能下降。

基于动态预测加速的微调

利用一些技巧减少在预测时花费的时间,例如动态地选择模型的部分层进行计算,或者根据输入数据的特点自适应地调整模型的计算策略等。优点是可以在不影响模型性能的前提下,提高模型的预测速度,对于一些对实时性要求较高的应用场景非常重要。

但需要对模型的结构和计算流程进行深入的理解和优化,实现起来相对复杂,而且可能需要根据不同的模型和任务进行定制化的开发。

知识蒸馏方法

训练一个小的学生模型来模拟大的老师模型。首先使用大量的数据训练一个大型的预训练模型(老师模型),然后使用老师模型的输出作为监督信号,来训练一个较小的学生模型。在训练过程中,学生模型学习老师模型的行为和预测结果,从而在保持较高性能的同时,降低模型的复杂度和计算成本。

优点:可以大大降低模型的计算成本和存储需求,同时能够保持较高的性能。对于一些资源受限的场景,如移动设备或嵌入式系统,模型蒸馏是一种非常有效的方法。

缺点:训练过程相对复杂,需要先训练一个大型的老师模型,然后再训练学生模型。而且,如果老师模型的性能不够好,或者学生模型的结构设计不合理,可能会导致性能下降。

下面给大家分享一份2025最新版的大模型学习路线,帮助新人小白更系统、更快速的学习大模型!
因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享**

一、2025最新大模型学习路线

一个明确的学习路线可以帮助新人了解从哪里开始,按照什么顺序学习,以及需要掌握哪些知识点。大模型领域涉及的知识点非常广泛,没有明确的学习路线可能会导致新人感到迷茫,不知道应该专注于哪些内容。

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

L1级别:AI大模型时代的华丽登场

L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的核心原理,关键技术,以及大模型应用场景;通过理论原理结合多个项目实战,从提示工程基础到提示工程进阶,掌握Prompt提示工程。

L2级别:AI大模型RAG应用开发工程

L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3级别:大模型Agent应用架构进阶实践

L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造我们自己的Agent智能体;同时还可以学习到包括Coze、Dify在内的可视化工具的使用。

L4级别:大模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调;并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

整个大模型学习路线L1主要是对大模型的理论基础、生态以及提示词他的一个学习掌握;而L3 L4更多的是通过项目实战来掌握大模型的应用开发,针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

二、大模型经典PDF书籍

书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)

三、大模型视频教程

对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。

四、大模型项目实战

学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。

五、大模型面试题

面试不仅是技术的较量,更需要充分的准备。

在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。


因篇幅有限,仅展示部分资料,需要点击下方链接即可前往获取

2024最新版优快云大礼包:《AGI大模型学习资源包》免费分享

大模型微调技术(Adapter-Tuning、Prefix-Tuning、Prompt-Tuning(P-Tuning)、P-Tuning v2、LoRA) 阅读详情

相关推荐

【LLM大模型】指令微调、peft高效参数微调

LLaMA 是 Meta AI 发布的包含 7B、13B、33B 和 65B 四种参数规模的基础语言模型集合,LLaMA-13B 仅以 1/10 规模的参数在多数的 benchmarks 上性能优于 GPT-3(175B),LLaMA-65B 与业内最好的模型 Chinchilla-70B 和 PaLM-540B 比较也具有竞争力。通过使用与 ChatGLM(chatglm.cn)相同的技术,ChatGLM-6B 初具中文问答和对话功能,并支持在单张 2080Ti 上进行推理使用。

发现问题,并解决问题,批判性思维 1万+

【大模型微调】一文掌握7种大模型微调的方法

本篇文章深入分析了大型模型微调的基本理念和多样化技术,细致介绍了LoRA、适配器调整(Adapter Tuning)、前缀调整(Prefix Tuning)等多个微调方法。详细讨论了每一种策略的基本原则、主要优点以及适宜应用场景,使得读者可以依据特定的应用要求和计算资源限制,挑选最适合的微调方案。大型语言模型(LLM)的训练过程通常分为两大阶段:阶段一:预训练阶段在这个阶段,大型模型会在大规模的无标签数据集上接受训练,目标是使模型掌握语言的统计特征和基础知识。

python123456_的博客 5万+

Linux-ftrace-双nop机制的实现

linux-ftrace内核追踪-双nop机制的实现原理

qq_43707773的博客 1070

大模型微调方法综述

保存时只需要为每个任务保存重参数的结果即可。

lovely_yoshino的博客 2万+

【电击防护篇】电击防护技术详解:从人体效应到接地系统全解析

本文系统讲解了电击防护的关键知识,包括电流对人体的影响(如30mA是心室颤动阈值)、人体电阻特性(700Ω-6100Ω)以及电气接触防护措施。重点分析了TT、TN和IT三大接地系统的结构特点与应用场景,强调TN-S系统最安全,IT系统供电连续性最佳。详细介绍了漏电保护器(RCD)的工作原理与选型指南,建议人身防护选用30mA高灵敏度RCD。文章通过对比表总结三大系统的安全性、成本及适用场景,为电气安全设计提供实用参考。

2301_81299416的博客 1742

Amos实战:如何用Bootstrap法检验中介效应?附完整操作步骤

本文详细介绍了如何使用Amos软件通过Bootstrap法检验中介效应,包括模型设定、参数配置和结果解读。Bootstrap方法因其不依赖正态分布假设、统计功效高等优势,成为中介效应分析的首选方法。文章提供了完整的操作步骤和实用建议,帮助研究者准确评估变量间的中介作用机制。

zz67890的博客 1436

2025版最新大模型微调方法汇总,(非常详细)从零基础入门到精通,收藏这篇就够了

主要思路:在预训练模型的每一层(或某些层)中添加适配器模块,微调时冻结预训练模型主体,由适配器模块学习特定下游任务的知识。每个适配器模块由两个前馈子层组成,第一个前馈子层将模型的输出作为输入,将原始输入维度投影到一个较小的维度,第二个前馈子层再将其还原到原始输入维度作为输出。因为对模型的所有参数进行了调整,所以可以充分利用预训练模型的通用特征,能够较好地适应特定任务,在一些情况下可以获得较高的性能表现。例如,在图像分类任务中,如果有足够的计算资源和数据,全量微调可以使模型对特定类别的识别准确率大幅提高。

Javachichi的博客 1638

Stable Diffusion跑图总爆显存?别急着换显卡,试试这个PYTORCH_CUDA_ALLOC_CONF参数调优

本文深入解析了Stable Diffusion运行中常见的显存不足问题,特别是由显存碎片化导致的假性OOM现象。通过详细讲解PYTORCH_CUDA_ALLOC_CONF参数中的max_split_size_mb设置技巧,提供了一套完整的显存优化方案,帮助用户在无需升级硬件的情况下显著提升AI绘画的稳定性与效率。

weixin_42524100的博客 346

2025版最新大模型微调方法汇总,零基础入门到精通,收藏这篇就够了_大模型微调的学习路线

首先使用大量的数据训练一个大型的预训练模型(老师模型),然后使用老师模型的输出作为监督信号,来训练一个较小的学生模型。在训练过程中,学生模型学习老师模型的行为和预测结果,从而在保持较高性能的同时,降低模型的复杂度和计算成本。提示信息可以是一些特定的文本片段、关键词或者问题模板等,其目的是将下游任务转化为与预训练模型的预训练任务相似的形式,以便模型能够更好地利用预训练的知识。而L3 L4更多的是通过项目实战来掌握大模型的应用开发,针对以上大模型的学习路线我们也整理了对应的学习视频教程,和配套的学习资料。

HUANGXIN9898的博客 1169

第1部分 基础算法(提高篇)--第2章 二分与三分1439:【SCOI2010】传送带

1439:【SCOI2010】传送带 时间限制: 2000 ms 内存限制: 65536 KB 提交数: 372 通过数: 212 【题目描述】 在一个2维平面上有两条传送带,每一条传送带可以看成是一条线段。两条传送带分别为线段AB和线段CD。lxhgww在AB上的移动速度为P,在CD上的移动速度为Q,在平面上的移动速度R。现在lxhgww想从A点走到D点,他想知道最少需要走多长时间。 【输入】 输入数据第一行是4个整数,表示A和B的坐标,分别为Ax,Ay,Bx,By 第二行是4个整

zqhf123的博客 834

Dify平台隐患url:/console/api/remote-files/upload暴露高危漏洞,配置nginx htpasswd模块认证机制屏蔽解决

内部网络探测: 攻击者可通过SSRF扫描内网服务云元数据访问: 可能访问AWS/Aliyun/腾讯云等元数据服务服务端请求伪造: 以服务器身份发起任意HTTP请求。

CN_Eden 1317

【2025最新】大模型微调方法汇总,零基础入门到精通,看这篇就够了!

大模型微调方法汇总,零基础入门到精通,看这篇就够了!

程序员若风的博客 1476

多径衰落信道的 MATLAB 仿真

在无线通信系统中,信号在传输过程中会经历多径传播现象,导致信号在接收端出现时域和频域上的扩展。通过以上示例代码,我们可以进行多径衰落信道的 MATLAB 仿真。同时,我们还可以通过调整信道参数和信号特性,进一步研究多径衰落对系统性能的影响。常用的模型之一是瑞利衰落信道模型,它假设信号在传输过程中受到多个散射路径的影响。除了瑞利衰落信道模型,我们还可以使用其他类型的信道模型,如高斯衰落信道模型。在上述代码中,我们首先定义了信道的参数,包括最大多普勒频移、多径延迟和多径功率衰落。函数来模拟高斯衰落信道。

TechCraze的博客 665

2025版最新大模型微调方法理论,零基础入门到精通,收藏这篇就够了

在调研过程中,感觉现在用的多的都是LoRA派系的微调方法,比如LLaMA-Factory就拿它LoRA去对比ChatGLM的P-Tuning,结果显示3.7倍的加速比,更高的Rouge分数,使用QLoRA还进一步减低GPU显存消耗。图:LLaMA-Factory的性能对比。

Javachichi的博客 2031

Android Shadow插件化框架分析与集成(一)

到此为止,本篇文章先介绍到这里,本篇文章主要介绍了:从源码的角度去集成shadow框架,从下载源码开始,到集成到自己的项目中,其中插件项目我是新建的demo应用,宿主应用是之前搭的一个MVP框架。文章中一步一步详细的介绍了宿主该如何集成,并提供了源码;介绍了插件该如何集成,同时也提供了源码。文章中还介绍了gradle的版本与AGP版本使用不当造成的问题,以及shadow源码的gradle版本与APG版本的配置,及和宿主插件应用gradle版本与AGP版本的关系。

superzhang6666的博客 1234

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

2025版最新大模型微调入门实战,零基础入门到精通,收藏这篇就够了

Qwen2是通义千问团队最近开源的大语言模型,由阿里云通义实验室研发。以Qwen2作为基座大模型,通过指令微调的方式做高精度文本分类,是学习LLM微调的入门任务。在本文中,我们会使用 Qwen2-1.5b-Instruct 模型在 复旦中文新闻 数据集上做指令微调训练,同时使用SwanLab监控训练过程、评估模型效果。采用了Lora方法,所以显存要求不高,10GB左右就可以跑。代码:完整代码直接看本文第5节 或 Github,Jupyter Notebook。

leah126的博客 1270

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

2025版最新微调大模型的五个技巧,零基础入门到精通,收藏这篇就够了

做大模型,微调可太重要了。大家都知道,大型语言模型(LLM)配备了处理广泛任务的通用能力,包括文本生成、翻译、提取摘要和回答问题。然而,尽管LLM的性能表现非常强大,但它们在特定的任务导向型问题或特定领域(例如医学和法律等)上仍然效果不佳。LLM微调是指对预训练好的LLM进行进一步训练,使用更小、更具体的数据集,以增强其在特定领域任务(如理解医疗行业的术语)上的表现。无论是从头开始构建LLM还是使用额外的微调数据来扩展LLM,遵循以下这些技巧都将获得更健壮的模型。

leah126的博客 1525

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

2025版最新如何微调(Fine-tuning)大语言模型?零基础入门到精通,收藏这篇就够了

图片由DALL-E 生成阿里妹导读本文介绍了微调的基本概念,以及如何对语言模型进行微调。从 GPT3 到 ChatGPT、从GPT4 到 GitHub copilot的过程,微调在其中扮演了重要角色。什么是微调(fine-tuning)?微调能解决什么问题?什么是 LoRA?如何进行微调?本文将解答以上问题,并通过代码实例展示如何使用 LoRA 进行微调。

Libra1313的博客 4492

2025版最新大模型微调终极指南,零基础入门到精通,收藏这篇就够了

今天给大家带来一篇大模型微调相关的最新综述,主要大模型微调归纳为7个阶段分别为数据准备、模型初始化、训练环境配置、模型微调、模型评估与验证、模型部署以及模型监控与维护。模型微调(Fine-Tuning)就是以预训练模型为基础,通过相对较少的特定数据集进行的进一步训练,主要是在模型预先存在的知识之上用过减少数据和计算成本来提高特定任务的效果。模型预训练与微调之间差距大模型微调的优势:迁移学习:利用预训练过程中获得的知识,通过减少计算时间和资源,将其适应于特定任务。

leah126的博客 1421

2025版最新大模型微调指南,零基础入门到精通,收藏这篇就够了

Prompt工程技术文章专栏系列已更新七章,涵盖了AI开发生态中的多种使用场景,并提供了足够实用的Prompt技巧。而现在,随着大模型调用变得越来越简单,tokens成本也大幅降低,AI开发者可以轻松进行API封装与二次开发。部分平台更是支持定制场景微调,推动着“AI+”模式在市场上蓬勃发展。本系列文章将开启“大模型微调”专栏,作为第一篇文章,我们将从基础概念入手,通俗易懂地讲解大模型微调技术的演变与发展,并通过简单的代码示例帮助大家理解微调的核心理念与方法。

2401_84205765的博客 1268

2025版最新大模型微调基本概念指北,零基础入门到精通,收藏这篇就够了

大模型微调,通常指有监督微调(Supervised Fine-Tuning, SFT),是在预训练模型(一般称为“基座模型”)的基础上进行的训练过程。预训练模型通常已经掌握了广泛的语言知识和语义表示,但为了让模型在特定任务或领域上表现得更好,我们会在特定任务的数据集上对其进行微调。1)Language Model,LM:一个预训练语言模型 LM,对基础模型微调得到一个微调后的模型使用人工标注的数据对预训练模型进行监督微调,以获得初始版本的生成模型。2)

Libra1313的博客 2318

【2025版】最新大模型微调项目 / 数据集调研汇总,零基础入门到精通,收藏这篇就够了

总结了一些热门的大模微调项目的亮点以及数据集。 >>加入极市CV技术交流群,走在计算机视觉的最前沿本文主要总结本人最近跑过的大模型微调项目。相信大家这几个月都会不断新出的微调大模型项目刷屏,频率基本每天都有高星的项目诞生,部分还宣称自己达到GPT的百分之多少,一方面弄得大家过度乐观,一方面弄得大家焦虑浮躁。面对这种情况,我的建议是「多动手」。把这些项目 clone 下来,跑跑代码,把项目用到的数据集下载下来做做EDA,把项目训练完的checkpoint下载下来,用自己的例子跑跑。多接触反而心态平定了许多。回

Javachichi的博客 4430

2025版最新大模型微调教程,零基础入门到精通,收藏这篇就够了

最近huggingface开源了一个微调大模型免费课程,然后最近自己也在学习,想着边学习边分享,开源地址会放在文章结尾,进度快的小伙伴可以自己看一下。首先,让我们理解什么是聊天模板以及为什么它们如此重要:聊天模板本质上是一个结构化的对话格式系统,就像是AI模型与人类交谈时需要遵循的"礼仪规则"。想象一下,如果我们在参加一个正式的商务会议,我们需要遵循特定的沟通规则和格式 - 聊天模板就是AI模型的这样一个规则系统。

leah126的博客 1756
上一篇: 2024年十大网络攻击事件概览,从零基础到精通,收藏这篇就够了!
下一篇: 暴击!亚马逊钓鱼邮件卷土重来!已有卖家中招,从零基础到精通,收藏这篇就够了!
黑客大白
博客等级 码龄5年 1万+粉丝 3206原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

