attention总结(补充附代码)

多模态对齐与 Cross Attention 模块实战解析:扩散模型中的融合机制与工程实现路径 在多模态生成任务中,实现不同模态(如文本、图像、结构图等)的有效对齐,是保证生成质量与控制精度的关键前提。Cross Attention 模块作为当前扩散模型中最核心的多模态融合机制,广泛应用于 UNet、DiT 等架构中。本文将从多模态输入的本质对齐需求出发,深入解析 Cross Attention 的实现逻辑、对齐策略、工程调优路径与未来演进方向,并结合 HuggingFace Diffusers 等开源工具链,提供实战级的工程部署与优化建议。 阅读详情

上期链接

引言

  • attention 总结的初版主要介绍了注意力机制的理论概念,本文主要作为其补充,补充个人理解的一个加深以及相关变体的一些代码实现。
  • 以下为个人的一些比较疑惑的地方以及个人理解,仅供参考

实际问题中 key,value 到底是什么?

  • 参考1
  • 参考2
  • 个人理解:key 和 value 的值其实来自于同一输入,某种程度上说是等价的,只是不同转换方法得到的一个输出
  • 计算 attention 值的过程:首先要计算 q 和 k 的相关性,相关性的值要经过 softmax 函数类似的归一化操作,来表示不同的 key 对 query 的重要程度,再使用归一化后的值乘以对应的 value,个人认为是表示对实际的输入内容进行加权,加权求和后的输出代替 query 参与后面的运算
  • 点积计算,结果越大其实就是向量乘积越大表示这俩向量越相似

self-attention

  • 自注意力机制个人简介理解:相对于上面介绍的传统的 attention,q,k,v 三个角色是指向不同的词语,自注意力机制关注的就是输入序列之间的关系,即每个词语都有自己的 k,q,v,这样不仅包含了词语本身的信息,又考虑了上下文的信息
  • 上图中每个输入的 Xi 都有各自的 q,k,v,这些是通过各自的输入乘以对应的权重矩阵 Wq,Wk,Wv得到,这三个权重矩阵对所有的输入元素是共享的,而且是可学习的;(缩放点积公式就是上图中Attentiion(Q,K,V))
    • 这个权重矩阵可学习,意味着其实初始矩阵可以自行设置(个人理解,感觉有点问题的,此处作为一个 flag)
  • 如上图所示每个 k 和 q 都会计算相似度,最终家加权求和
  • 注意,此时考虑上下文信息的时候,x1和x2的关系与 x2 和 x1 的关系不一样,也就是顺序不同关系也不同,比如小明喜欢小红,但是小红不喜欢小明,那么计算q小明k小红的分数要远大于q小红k小明的分数
  • 以下为上面参考链接中的例子
    • dk 是数据embedding 的维度,除以更号它是为了缩小点积的范围,确保 softmax 的梯度稳定性,具体详情可见参考资料


  • 此处补充一个自注意力中 k,q,v 的设计由来(仅供参考)

多头注意力机制

  • 个人理解,多头注意力机制就是多个自注意力机制的堆叠,就像每个自注意力头都取输入数据的不同信息;
    • 对每个词语的 q,k,v根据分头的个数进行拆分,每个头部都是一个子空间(注意 embedding 的维度要是分头数的倍数,不然没法平均拆分)
    • 对每个头部按照自注意力的计算缩放点积,最后将所有的头部输出拼接在一起得到最终的输出矩阵
  • 以下为参考资料中的例子图解


padding mask

  • 参考文章中padding mask 部分个人理解是,在处理数据长度的时候,为了保持长度一致会使用 0 来进行填充,但是在计算 attention 值的时候这个位置的值是无用的需要 mask 掉,具体方法应该就是下图所说的内容(个人理解,仅供参考,后续理解加深会修改)

关于多模态 cross-attention 部分这里不做详解,上面的自注意力和多头主要是为了后面学习 transform 铺垫的

  • 多模态说的是处理两个不同模态序列之间的关联,比如文本和图片数据进行交互处理,具体应用例如 stable diffusion 的实现(更详细的可以看上面参考链接)。

代码部分()

import torch
import torch.nn as nn
import torch.nn.functional as F
import math
from einops import rearrange, repeat
from torch.nn import MultiheadAttention


class SelfAttention(nn.Module):
    def __init__(self, emb_dim):
        super(SelfAttention, self).__init__()
        # 定义三个权重矩阵(通过线性变换的方式)
        self.emb_dim = emb_dim

        self.Wq = nn.Linear(emb_dim, emb_dim, bias=False)
        self.Wk = nn.Linear(emb_dim, emb_dim, bias=False)
        self.Wv = nn.Linear(emb_dim, emb_dim, bias=False)

        self.fc = nn.Linear(emb_dim, emb_dim)

    def forward(self, x, pad_mask=None):
        # 得到输入的Q, K, V的值
        # [batch_szie, seq_len, emb_dim] = [3, 5, 512]
        Q = self.Wq(x)
        K = self.Wk(x)
        V = self.Wv(x)
        
        # 缩放点积公式
        # torch.bmm批量矩阵乘法 batch matrix multiplication
        # (3,512) * (512,3)
        print(Q.shape, K.shape, V.shape, K.transpose(1, 2).shape)
        att_weights = torch.bmm(Q, K.transpose(1, 2))
        # [batch_szie, seq_len, seq_len] = [3, 5, 5]
        print("att_weights1", att_weights)
        att_weights = att_weights / math.sqrt(self.emb_dim)
        print("att_weights2", att_weights,att_weights.shape)
        
        # padding mask 部分处理,因为x是 3*5,而 pad_mask的时候是5*5,俩矩阵无法相乘,故先注释掉
#         if pad_mask is not None:
#             att_weights = att_weights.masked_fill(pad_mask, -1e9)
        
        att_weights = F.softmax(att_weights, dim=-1)
        print("att_weights3", att_weights,att_weights.shape)
        # [batch_szie, seq_len, emb_dim] = [3, 5, 512]
        # (5,5) * (5, 512)
        output = torch.bmm(att_weights, V)  
        print("output, att_weights的 shape",output.shape, att_weights.shape)
        output = self.fc(output)
        # torch.Size([3, 5, 512]) torch.Size([3, 5, 5])
        print("output, att_weights的 shape",output.shape, att_weights.shape)
        return output, att_weights

class MultiHeadAttention(nn.Module):
    def __init__(self, emb_dim, num_heads, att_dropout=0.0):
        super(MultiHeadAttention, self).__init__()
        self.emb_dim = emb_dim
        self.num_heads = num_heads
        self.att_dropout = att_dropout # 此处是参考文章作者处理padding mask处用到
        
        # embedding 需要是头数的倍数
        assert emb_dim % num_heads == 0, "emb_dim must be divisible by num_heads"
        self.depth = emb_dim // num_heads

        self.Wq = nn.Linear(emb_dim, emb_dim, bias=False)
        self.Wk = nn.Linear(emb_dim, emb_dim, bias=False)
        self.Wv = nn.Linear(emb_dim, emb_dim, bias=False)

        self.fc = nn.Linear(emb_dim, emb_dim)

    def forward(self, x, pad_mask=None):
        # [batch_szie, seq_len, emb_dim] = [3, 5, 512]
        batch_size = x.size(0)

        # [batch_szie, seq_len, emb_dim] = [3, 5, 512]
        Q = self.Wq(x)
        K = self.Wk(x)
        V = self.Wv(x)
        print(Q.shape, K.shape, V.shape, K.transpose(1, 2).shape)
        # 分头 [batch_szie, num_heads, seq_len, depth] = [3, 8, 5, 512/8=64]
        Q = Q.view(batch_size, -1, self.num_heads, self.depth).transpose(1, 2)
        K = K.view(batch_size, -1, self.num_heads, self.depth).transpose(1, 2)
        V = V.view(batch_size, -1, self.num_heads, self.depth).transpose(1, 2)
        print(Q.shape, K.shape, V.shape, K.transpose(1, 2).shape)
        
        # [batch_szie, num_heads, seq_len, seq_len] = [3, 8, 5, 5]
        att_weights = torch.matmul(Q, K.transpose(-2, -1))
        print("att_weights",att_weights.shape)
        att_weights = att_weights / math.sqrt(self.depth)
        
#         if pad_mask is not None:
#             # 因为是多头,所以mask矩阵维度要扩充到4维  [batch_size, seq_len, seq_len] -> [batch_size, nums_head, seq_len, seq_len]
#             pad_mask = pad_mask.unsqueeze(1).repeat(1, self.num_heads, 1, 1)
#             att_weights = att_weights.masked_fill(pad_mask, -1e9)

        att_weights = F.softmax(att_weights, dim=-1)
        print("att_weights2",att_weights.shape)
        
#         # 自己的多头注意力效果没有torch的好,我猜是因为它的dropout给了att权重,而不是fc
#         if self.att_dropout > 0.0:
#             att_weights = F.dropout(att_weights, p=self.att_dropout)

        # [batch_szie, num_heads, seq_len, depth] = [3, 8, 5, 64]
        output = torch.matmul(att_weights, V)
        print("output1",output.shape)
        
        # 不同头的结果拼接 [batch_szie, seq_len, emb_dim] = [3, 5, 512]
        output = output.transpose(1, 2).contiguous().view(batch_size, -1, self.emb_dim)
        print("output2",output.shape)
        output = self.fc(output)

        return output, att_weights

import torch
import torch.nn as nn
import torch.nn.functional as F
import math
from einops import rearrange, repeat
from torch.nn import MultiheadAttention

if __name__ == '__main__':
    batch_size = 3
    seq_len = 5
    emb_dim = 512
    # 本例子则词表大小为 301
    vocab_size = 301

    input_ids = torch.tensor([[100, 200, 300, 300, 0],
                 [22, 33, 44, 0, 0],
                 [66, 55, 66, 30, 0]], dtype=torch.long)
    
    # 逻辑矩阵pad_mask:将填充位置标记为True,其他位置标记为False
#     pad_mask = input_ids.eq(0)  
#     print("pad_mask",pad_mask.shape)
    inputs = nn.Embedding(vocab_size, embedding_dim=emb_dim)(input_ids)   # [batch_szie, seq_len, emb_dim] = [3, 5, 512]
  
    self_att = SelfAttention(emb_dim=emb_dim)
    self_att(inputs, pad_mask=pad_mask)
    #self_att(inputs, pad_mask=pad_mask)
    
    multi_att = MultiHeadAttention(emb_dim=emb_dim, num_heads=8)
    multi_att(inputs, pad_mask=pad_mask)
    #multi_att(inputs, pad_mask=pad_mask)
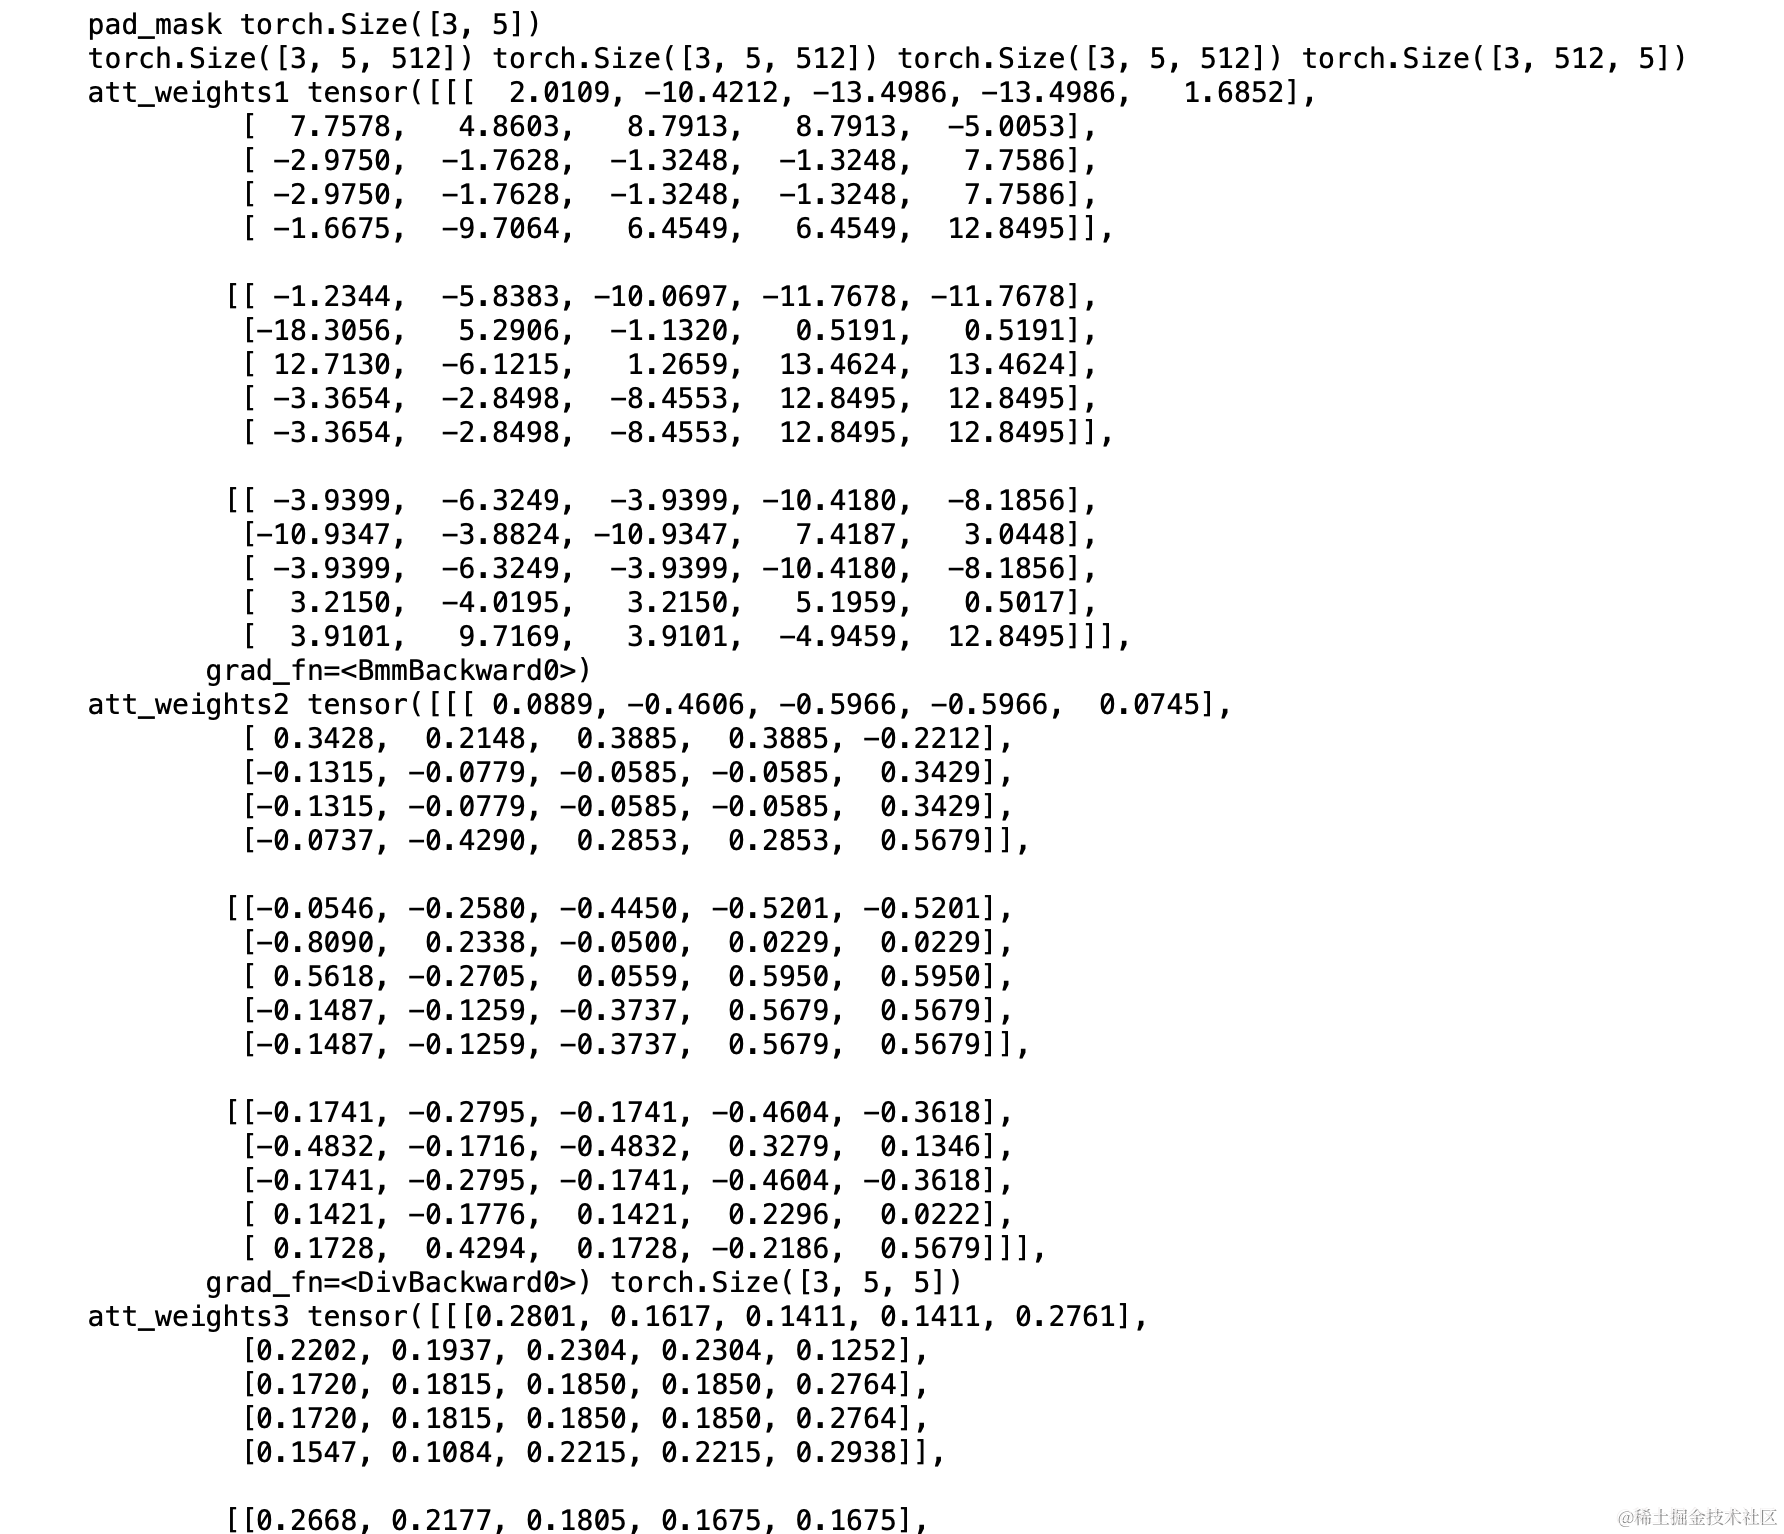
  • 可见维度变化以及结果,可自行测试上述代码查看具体结果


结语

  • 本文总结更像是对参考文章的部分一笔带过却不太易于理解的部分做个人理解,通过这样的方式加深个人学习 attention 的印象,想要更准确更深刻的理解可以参考文中参考链接。
  • 希望自己能早日工作!
【深度】交叉注意力机制 交叉注意力机制,也称为cross-attention,是指在注意力机制中,一个序列中的某个位置与另一个序列中的所有位置进行注意力计算。 阅读详情

相关推荐

多头注意力(Multi-Head Attention)和交叉注意力(Cross-Attention)两种常用注意力机制的原理及区别

在类的初始化函数中,我们需要设置注意力头数num_heads,以及每个注意力头的k维度k_dim和v维度v_dim。在前向传播函数中,我们使用全连接层将x1投影到k_dim * num_heads维度,x2投影到k_dim * num_heads和v_dim * num_heads的空间,再将结果按注意力头和k_dim/v_dim维度进行调整。注意力计算完成后,将得分与v相乘,再将结果按注意力头和v_dim维度进行调整,最终使用全连接层将结果投影会in_dim维度,即可得到多头注意力计算的结果。

ywfwyht的博客 5万+

人工智能|深度学习——多模态条件机制 Cross Attention 原理及实现

虽然之前写过 Attention 的文章,但现在回头看之前写的一些文章,感觉都好啰嗦,正好下一篇要写的 Stable Diffusion 中有 cross-attention,索性就再单拎出来简单说一下 Attention 吧,那么这篇文章的作用有两个:第一是为 Stable Diffusion 做补充,第二是为后续的 Vision Transformer 和 Swin Transformer 做铺垫。

也许有一天我们再相逢 睁开眼睛看清楚 我才是英雄! 2万+

图解Transformer模型(Multi-Head Attention)

本文内容主要源于Attention is all you need:https://arxiv.org/abs/1706.03762 由于本人最近在研究文本的判别式模型,如文本分类任务,所以学习了Transformer,并根据自己的理解制作了PPT介绍总结Transformer中几个比较重要的部分. 文章内容为本人制作的PPT,同时在需要解释的slide写上了补充说明; 主要内容包括 1...

black_shuang的博客 1万+

多模态条件机制 Cross Attention 原理及实现

多模态条件机制 Cross Attention 原理及实现

WGS. 1万+

Flash Attention

因为SRAM利用晶体管存储数据,而HBM则是通过堆叠DRAM芯片实现高带宽和容量。然而,在实际应用中,由于HBM的堆叠设计和高速串行接口,其整体性能仍然非常出色。:HBM通过堆叠多个DRAM芯片实现了更高的容量和带宽,而SRAM的。因此,在需要处理大规模数据集和复杂计算任务的应用中,HBM更具优势。

weixin_42264784的博客 1148

Hierarchical Attention Network for Document Classification阅读笔记

最近看了”Hierarchical Attention Network for Document Classification”一篇文章,也在网上找了一些资料结合理解,发现在此之前有篇文章跟他提出的模型架构基本相似,只不过不包含attention机制:“Document Modeling with Gated Recurrent Neural Network for Sentiment Class

呜呜哈的博客 1万+

Transformer 代码补充

本文是对以及的补充,是对相关代码的理解。先说个题外话,在之前李宏毅老师的课程中提到multi-head attention是把得到的qkv分别乘上不同的矩阵,得到更多的qkv。实际上,这里采用的方法是直接截取,比如这里有两个头,那么q^i就被分成两部分q^{i,1}和q^{i,2}。在中有解释,也推荐。

Karen_Yu_的博客 1258

Attention 升级篇

这类方法减少了查询或键值记忆对的数量,以减少注意力矩阵的大小;训练过程:不会显著影响训练过程,训练速度不变,会引起非常细微的模型效果损失;该系列研究探索了不同的替代多头机制。矩阵与内核特征图,然后以相反的顺序计算。的大小,减少显存占用,提升推理速度。导致 内存开销大,性能是内存受限;参数量规模,会有轻微的模型效果损失。参数量规模,就不会损失模型效果。用并行公式替换了串行,提升了。:每个注意力头都有各自的。,阿联酋推出的开源大模型。都使用了该技术来加速训练。机制可以降低了复杂性;在所有的注意力头上共享。

Java架狗师知识框架速查表 992

【Transformer模型】:Attention is all your need(附attention的代码)

tranformer已经火了好长一段时间了,一直只是只闻其名不知其意,特地看了attention is all your need。 这篇论文摒弃了传统encoder-decoder模型必须结合cnn或者rnn的固有模式,只用了attention模型,可谓大道至简。现在主流的序列转化模型都是基于端到端的encoder-decoder的RNN或者CNN网络结构模式。现在都是在该框架中引入了a...

快来学习鸭~~~ 5024

Attention 升级面

Multi-Query Attention 在所有注意力头上 共享 key 和 value.

u012374012的专栏 1066

层层剖析,让你彻底搞懂Self-Attention、MultiHead-Attention和Masked-Attention的机制和原理

本文内容 本文基于李宏毅老师对 Self-Attention 的讲解,进行理解和补充,并结合Pytorch代码,最终目的是使得自己和各位读者更好的理解Self-Attention 李宏毅Self-Attention链接: https://www.youtube.com/watch?v=hYdO9CscNes PPT链接见视频下方 通过本文的阅读,你可以获得以下知识: 什么是Self-Attention,为什么要用Self-Attention? Self-Attention是如何做的? Self-Atten

iioSnail的博客 2万+

self-attention与Transformer补充

self-attention与Transformer 文章目录self-attention与Transformer参考整体介绍内部结构multi-head self-attention回过头来看Transformerencoder部分decoder部分 参考 此前笔记:Tranformer 李宏毅2021春机器学习课程:self-attention 李宏毅2021春机器学习课程:Transformer 双曲正切 整体介绍 之前有记过Transformer的笔记,但是属于一知半解的情况

椰子奶糖的博客 857

突破NER性能瓶颈:BERT与LLM协同的混合架构实践

性能卓越:在多个测试集上,F1分数比单一模型提升5-15%成本可控:相比纯LLM方案,成本降低60%以上易于落地:架构清晰,便于调试和优化这种"专才+通才"的组合思路可以扩展到其他NLP任务中,如关系抽取、事件提取、文本分类等。更精细的流水线优化多模型投票机制在线学习与自适应调整不追求单一模型的万能,而是通过精心设计的组合,让每个组件发挥其独特优势,最终实现系统性能的最优化。欢迎在评论区分享你在NER任务中的实践经验,或者对这个混合架构的改进建议!

Ven%的博客 1022

基于CRNN+Attention 的英文单词识别(Attention-OCR)

前言: 针对OCR问题,有各种各样的检测和识别网络,虽然架构各不相同,但是基本思想都是通过CNN网络提取文本特征,然后通过RNN网络学习特征之间的关系,从而实现文本识别。目前已经完成CRNN网络的相关工作,在生成的样本上取得较好的识别效果,但是在应用于扫描生成的PDF文件进行识别时,错误率还是很高的,可能的原因是样本不够贴近具体的应用场景,所以样本中应该包含来自真实场景的采样,或者在生成数据时应...

zshluckydogs的博客 8935

【Web攻防】SQLMap实战进阶:从数据猜解到高权限渗透的全流程指南

本文介绍了SQLMap工具在Web安全渗透测试中的实战应用,重点讲解了数据猜解、高权限操作、复杂请求提交、Tamper脚本开发和指纹绕过等核心场景。文章提供了可直接复用的命令示例,包括数据库信息获取、文件读写、命令执行等操作,并详细说明了POST/JSON/Cookie注入的实现方法。同时,介绍了Tamper脚本的开发模板和指纹伪装技巧,帮助降低检测风险。最后强调SQLMap在自动化渗透全链路中的价值,从漏洞发现到权限提升的完整流程,并提供了优化测试效率的实用建议。所有技术内容仅限合法授权场景使用。

YsChunQiu777的博客 440

瑞芯微RK3576上手实测:8nm新U配6TOPS NPU,做AIoT项目选它还是RK3588/RK3568?

本文深度评测瑞芯微RK3576芯片在中高端AIoT项目中的表现,对比RK3588和RK3568的性能差异。RK3576采用8nm工艺,配备6TOPS NPU,在解码能力、AI推理效率和功耗控制方面表现均衡,是中端项目的黄金选择。实测数据显示其在多路视频解码和AI加速性能上优势明显,特别适合智能摄像头和工业HMI设备。

weixin_42627853的博客 716

CNN-Attention

Attention Mechanism可以帮助模型对输入的X每个部分赋予不同的权重,抽取出更加关键及重要的信息,使模型做出更加准确的判断,同时不会对模型的计算和存储带来更大的开销,这也是Attention Mechanism应用如此广泛的原因。  之前在做知识库问答和阅读理解问答的研究中都用到了attention机制,效果确实比较显著(虽然减慢训练速度的效果也比较显著…)。在是谷歌发布论文Atte...

zhuiqiuk的专栏 9368

从零到一:用AXI DataMover在Zynq MPSoC上实现高效DMA传输(附Vitis HLS驱动示例)

本文详细介绍了如何在Xilinx Zynq UltraScale+ MPSoC平台上使用AXI DataMover实现高效的DMA数据传输。通过解析AXI DataMover架构、Vivado工程配置、Vitis HLS驱动开发及性能优化技巧,帮助开发者快速构建高性能数据传输通道,并提供了可直接复用的代码示例。

weixin_42520796的博客 424

Stable Diffusion 中 Cross Attention 实现原理解析(含代码讲解)

在 Stable Diffusion 的 U-Net 中,是将文本提示与图像特征对齐融合的关键模块,本文将结合一段 Python 实现代码,逐行解释其原理。

qq_43069203的博客 2733

OnePose++: Keypoint-Free One-Shot Object Pose Estimation without CAD Models

算法:首先采用LoFTR的细匹配模块,将粗匹配点周围的小窗口内,通过对比特征找到最相似的位置,细化当前特征点的位置。算法:PnP算法,利用3D点和2D投影点的对应关系,计算相机相对于物体的6D姿态(位置朝向)。算法:使用COLMAP,对2D粗匹配对(不依赖传统关键点匹配)进行特征轨迹计算并生成半稠密点云,每个3D点包含坐标和对应的2D投影点。算法:LoFTR粗匹配模块,将每一个像素点视为伪关键点,生成半稠密的2D匹配对。输入:优化后的3D、当前视图的2D特征点。输出:粗半稠密点云以及物体的特征轨迹。

雨落倾城的博客 885

即插即用系列(代码实践)| GRSL 2024 ARConv核心模块:自适应矩形卷积——专为遥感图像设计,打破固定方形卷积束缚

摘要: 本文提出了一种用于遥感图像处理的自适应矩形卷积模块(ARConv),解决了传统方形卷积核在处理复杂几何结构(如细长道路、密集建筑物)时导致的光谱混叠和边缘模糊问题。ARConv通过动态调整卷积核的长宽比和旋转角度,使卷积核形状与地物特征自适应匹配。该模块可即插即用于全色锐化、语义分割等遥感任务,有效提升边缘保持能力和光谱保真度。核心代码基于PyTorch实现,包含偏移量生成和几何变换逻辑,支持梯度缩放以稳定训练。

分享顶会顶刊论文即插即用模块 140

Transformer(self attention)超详解&示例代码

说明 attention机制(注意力机制)有效解决了RNN网络对长序列编码效果差的问题。但是attention机制是对RNN网络编码后的特征序列进行打分,如果输入序列长度是30(即输入30个连续的原始特征),则RNN网络会编码出30个编码后的特征。在解码时,每解码一次,都会对这30个编码后的特征进行打分求和,结果作为输入传给解码器。 既然每次都是对全部编码后的特征进行打分,即每次解码都使用了全部信息,那么可不可以不使用编码后的特征,直接对原始特征进行打分呢,答案是可以的,即self attention。

weixin_39228381的博客 1万+

【Claude】媒体文件处理错误:PDF 与 Image 过大的检测与预处理方法 bug报错已解决

图片压缩是必须的:原始图片的 base64 会占用大量 TokenPDF 提取文本优于传图片:文本版 PDF 比扫描版更省 Token分块处理大文件:不要一次性处理整个大文件控制分辨率:800x800 通常足够 Claude 分析。

博客 6359

【Attention讲解】

Multi-Query Attention在所有注意力头上共享key和 value.Grouped query attention:介于multi head和multi query之间,多个key和value。

qq_41980734的博客 1197

PointNet++改进策略目录

后续我将如何使用文章中创新点加入的PointNet++中代码实现部分进行更新。

u012901740的博客 2196

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

手写self-attention的四重境界 self-attention

其实包含很多的细节,因此可能面试官对于 self-attention 实现到什么程度是有不同的预期。因此这里想通过写不同版本的 self-attention 实现来达到不同面试官的预期。以此告诉面试官,了解细节,但是出于时间考虑,可能只写了简化版本,如果有时间可以把完整的写出来。> 本文首发于:https://bruceyuan.com/hands-on-code/from-self-attention-to-multi-head-self-attention.html (更好的阅读体验)

具身机器人和通用AI 733

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

上一篇: Fpgrowth /FP Tree算法原理总结(附测试代码)
下一篇: transformer 总结(超详细-初版)
矮人三等
博客等级 码龄6年 173粉丝 65原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

矮人三等

秀儿,是你吗秀儿?

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值