


前言❤️❤️
hello hello💕,这里是洋不写bug~😄,欢迎大家点赞👍👍,关注😍😍,收藏🌹🌹
这篇博客会解析7道二叉树的经典算法题目,这7道题目相比二叉树(三)中的题目,综合难度是有提升的,思路和代码都不算简单
初学数据结构的铁汁建议多画一点时间,细品下每个题目,二叉树解题能力就会有个很大的提升
这个专栏的数据结构是代码都是用Java来写的,JavaSE专栏现在已经全部更新完成,铁汁们复习基础知识时非常推荐使用,可以试一下💪💪💪
🎇个人主页:洋不写bug的博客
🎇所属专栏:数据结构专栏
🎇复习Java基础知识:Java学习之旅,从入门到进阶
🎇铁汁们对于数据结构基础的各种核心知识(不太常用的也有😆),都可以在上面的数据结构专栏学习,专栏正在持续更新中🐵🐵,有问题可以写在评论区或者私信我哦~
1,二叉树的最近公共祖先
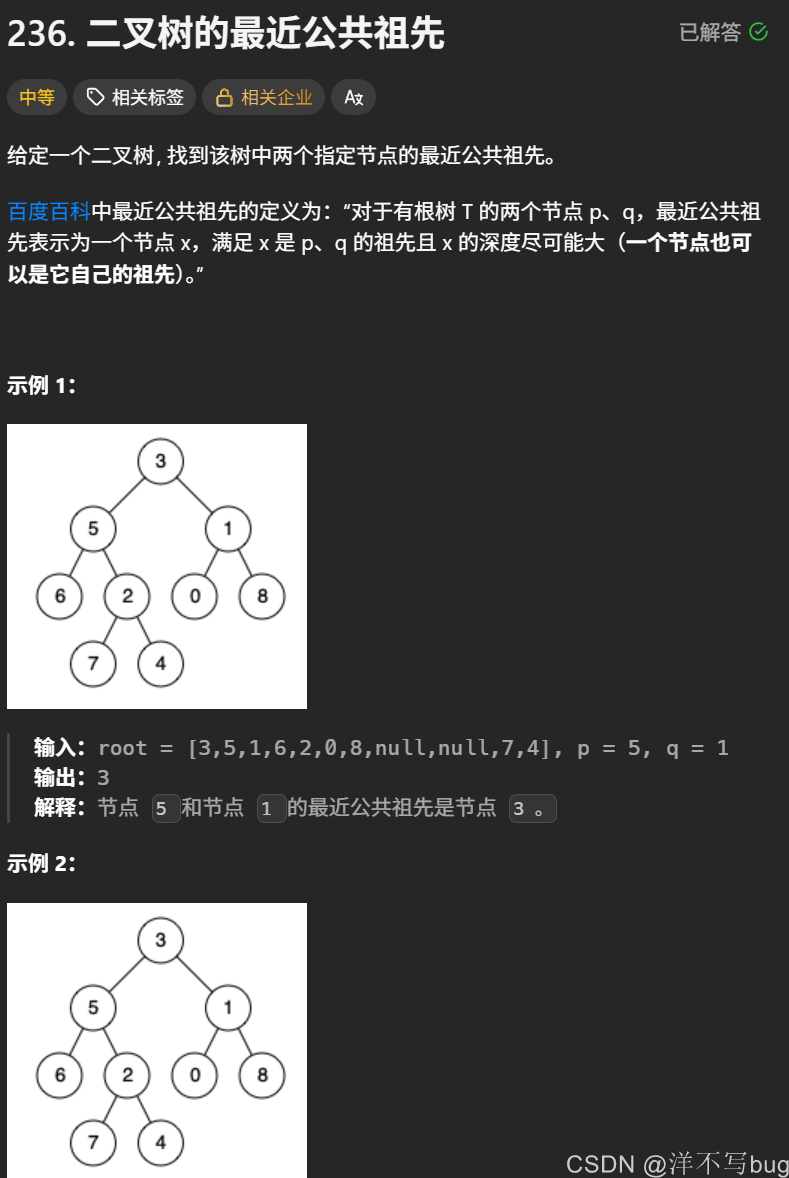
这个题目的难度还是比较大的,首先需要分析例子,总结出规律,就以示例1中的树结构为例,多分析几种情况
- 1和5的公共祖先为3,最小公共祖先为3
- 2和7的公共祖先为2、5、3,最小公共祖先为2
- 2和6的公共祖先为5、3,最小公共祖先为5
- 8和4的公共祖先为3,最小公共祖先为3
- 6和5的公共祖先为5、3,最小公共祖先为5
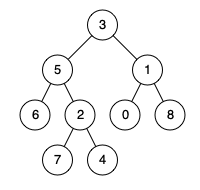
p和q与公共祖先的位置无非就是下面三种情况:
- p/q就是公共祖先(前面分析的第一种情况和第二种情况)
- p/q在公共祖先的左子树中
- p/q在公共祖先的右子树中
结合上面5种情况分析下,会得到这样一个规律,如果是最近的公共祖先,p和q与公共祖先的位置关系分布在这3种情况的两种之中;如果不是最近的公共祖先,p和q与公共祖先的位置关系分布在这3种情况的一种之中
这个规律确实不太好分析,举例来验证下,2和7的公共祖先有2、5、3;
对于3来说,2和7都属于它的左子树,p和q属于这三种情况中的一种;对于5来说,2和7都属于它的右子树,p和q属于这三种情况的一种;对于2来说,2是公共祖先,7是公共祖先的左子树,p和q就属于三种情况中的两种,因此2是最小公共祖先
写代码时大概思路就是:遍历整棵树,对每个结点查找左子树中是否包含p/q,右子树中是否包含p/q,以及当前结点是否就是p/q,这三种查找符合的话就返回1,最后计算这三种查找的和,如果等于2,就说明当前结点就是最小公共祖先
需要写个int类型的find方法,里面传入3个参数:root、p、q;递归的调用find方法,来遍历二叉树的每个结点;find的返回类型为int,但是需要返回的是公共祖先的结点,因此就可以搞个成员变量lca,在OJ题目中如果使用成员变量,一定要每次都把lca的值重新更新下
代码如下,但是这个写法有一处写错了,铁汁们可以分析下是哪里
class Solution {

    private TreeNode lca = null;


    public TreeNode lowestCommonAncestor(TreeNode root, TreeNode p, TreeNode q) {
        lca = null;
        if(root == null){
            return null;
        }
        if(root == p || root == q){
            return root;
        }
        find(root,p,q);
        return lca;
    }

    public int find(TreeNode root,TreeNode p,TreeNode q){
        if(root == null){
            return 0;
        }
        int mid = (root == p || root == q) ? 1 : 0;
        int left = find(root.left,p,q);
        int right = find(root.right,p,q);

        if(mid + left + right == 2){
            lca = root;
        }

        return mid + left + right;
    }
}
写错的地方是find方法的返回值,不应该是返回mid + left + right,就比如调用find(root.left,p,q),就是看在左子树中能不能找到p和q这两个结点,无论是只找到p或者p,还是p和q都找到了,find方法的返回值都是1
换句话说,find方法的返回值只有1和0两种选择,如果把find方法的返回值写成mid + left + right,那find(root.left,p,q)如果p和q都在root,left子树上,那返回值就是2,这是不符合find方法的作用的
find方法的返回值就需要修改为mid + left + right > 0 ? 1 : 0,因为find方法只看有没有找到,不看找到了几个
接着画图分析下递归过程,当root为2这个结点时,满足mid + left + right的值等于2,lca赋值,lca只赋值一次,在find方法中递归,是会递归到每个结点的,就算lca已经赋值完成,find还是会把其余的结点都遍历一遍
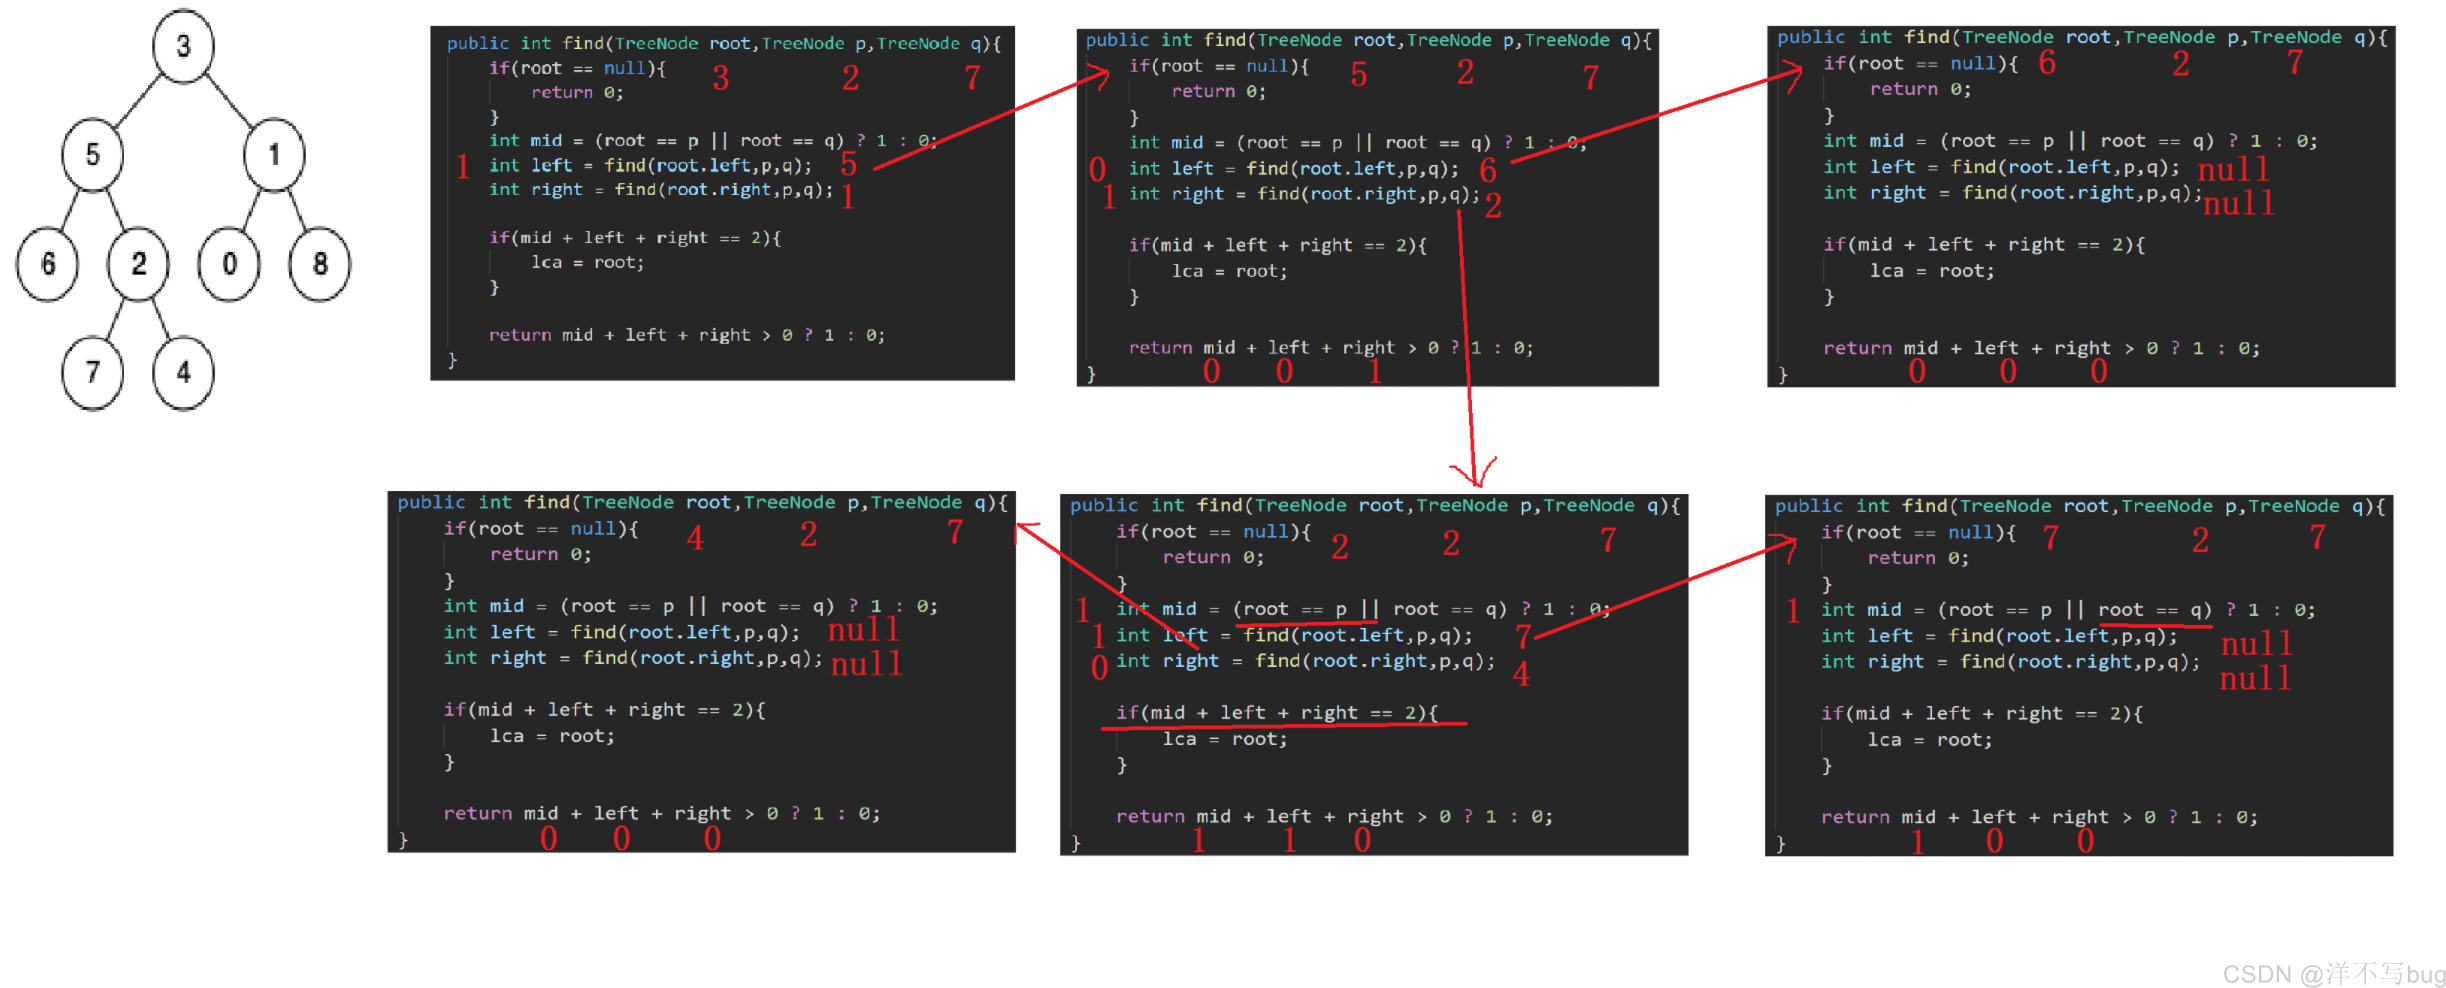
这个题目的强度算是二叉树中比较大的了,就算把规律分析出来,代码也并不是很好写,铁汁们可以多画一点时间细品下这个题目,能够很好的锻炼代码能力
2,通过先序和中序序列构造二叉树
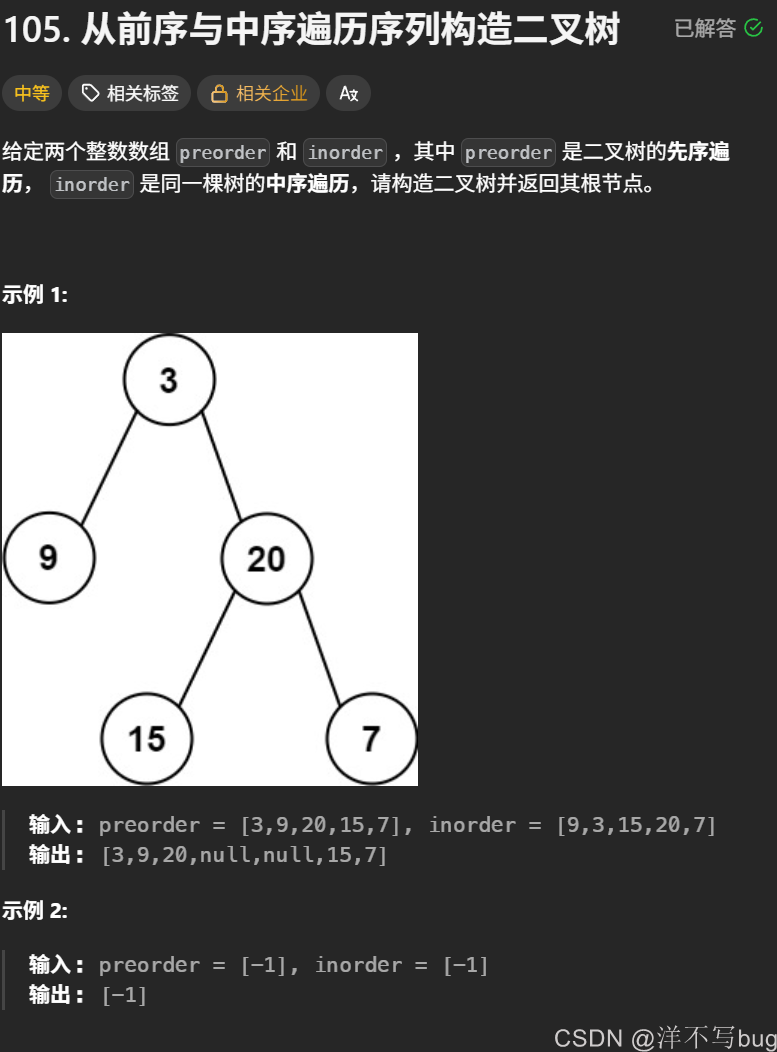
在二叉树(一)博客中已经详细解析了如何通过两个序列来还原出二叉树,在4.规律分析中,想要复习下的铁汁可以看下
拿示例1中的树来说,简单分析下构建过程:
- 先序序列的第一个元素是根结点,3就是树的根结点
- 再把3拿到中序中查找,9是左子树,15、20、17是右子树
- 再回到前序序列中来看,20、15、17是3的右子树的先序遍历的结果,此时20就是根结点
- 拿着20去对应的中序结果中15、20、17中查找,15是20的左子树,17是20的右子树
总结下,从preorder中从前往后遍历,拿到根结点,取出3这个元素,在inorder中查找,3.left就是9构成的子树,3.right就是(15、20、7)构成的子树
这里就有个问题需要解决,3是第一个结点,所以我们知道,在中序序列中,3左子树就是3左边的元素,3的右子树就是3右边的元素,接下来继续遍历preorder,拿到9这个元素,在中序序列中怎么看呢,难道说9的右子树是9右边的所有元素吗,这显然是不对的
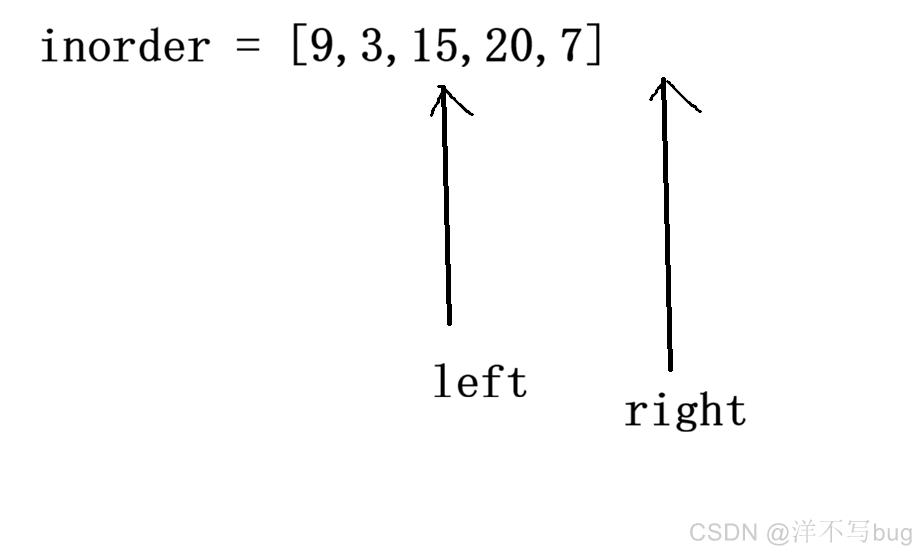
因此,就需要搞两个int类型的变量,inLeft和inRight,这两个参数记录的是当前要创建的子树在中序中元素的分布范围,是前闭后开的,也就是[inLeft,inRight),当然铁汁们设置为前闭后闭也可以
就比如说从preorder中遍历到20这个元素了,拿着20在inorder中去查找,如下图,这时候[inLeft,inRight)就表示以20为根结点的子树在中序中的范围,在这个范围内,20.left就是20左边的元素,20.right就是20右面的元素
首先写个findPos方法,在preorder中遍历取出元素之后,使用findPos查找元素在inorder中的位置,为了提高效率,还可以传入inLeft和inRight,直接在inorder的这片区域上找
写个buildHelper方法,递归构建子树,里面传入inLeft和inRight,遍历preorder,取出root,接着用findPos方法查找root在inorder中的位置pos,root.left在inorder中的位置就是(inLeft,pos),root.right在inorder中的位置就是(pos + 1,inRight)
还需要创建个成员变量index,记录preorder遍历到的位置,注意每次要把index清0,那这里为什么不用for循环来preorder呢,多方便,但是这里buildTreeHelper是要递归调用的,写for循环每次递归都要重新跑一遍for循环,就成无限循环了😅
class Solution {

    private int index = 0;

    public TreeNode buildTree(int[] preorder, int[] inorder) {
        index = 0;
        return buildTreeHelper(preorder,inorder,0,inorder.length);
    }

    public TreeNode buildTreeHelper(int[] preorder, int[] inorder,int inLeft,int inRight){
        if(inLeft >= inRight){
            return null;
        }
        if(index >= preorder.length){
            return null;
        }

        TreeNode root = new TreeNode(preorder[index]);
        index++;
        int pos = findPos(inorder,inLeft,inRight,root.val);
        root.left = buildTreeHelper(preorder,inorder,inLeft,pos);
        root.right = buildTreeHelper(preorder,inorder,pos + 1,inRight);
        return root;

    }

    public int findPos(int[] inorder,int inLeft,int inRight,int val){
        for(int i = inLeft;i < inRight;i++){
            if(inorder[i] == val){
                return i;
            }
        }
        return -1;

    }
}
这个题目如果铁汁们细品一下,是不用写这个if判断的,因为当index走到preorder.length位置的时候,再调用buildTreeHelper方法,inLeft是一定大于等于inRight的,就直接返回null了
        if(index >= preorder.length){
            return null;
        }
3,通过后序后中序序列构造二叉树
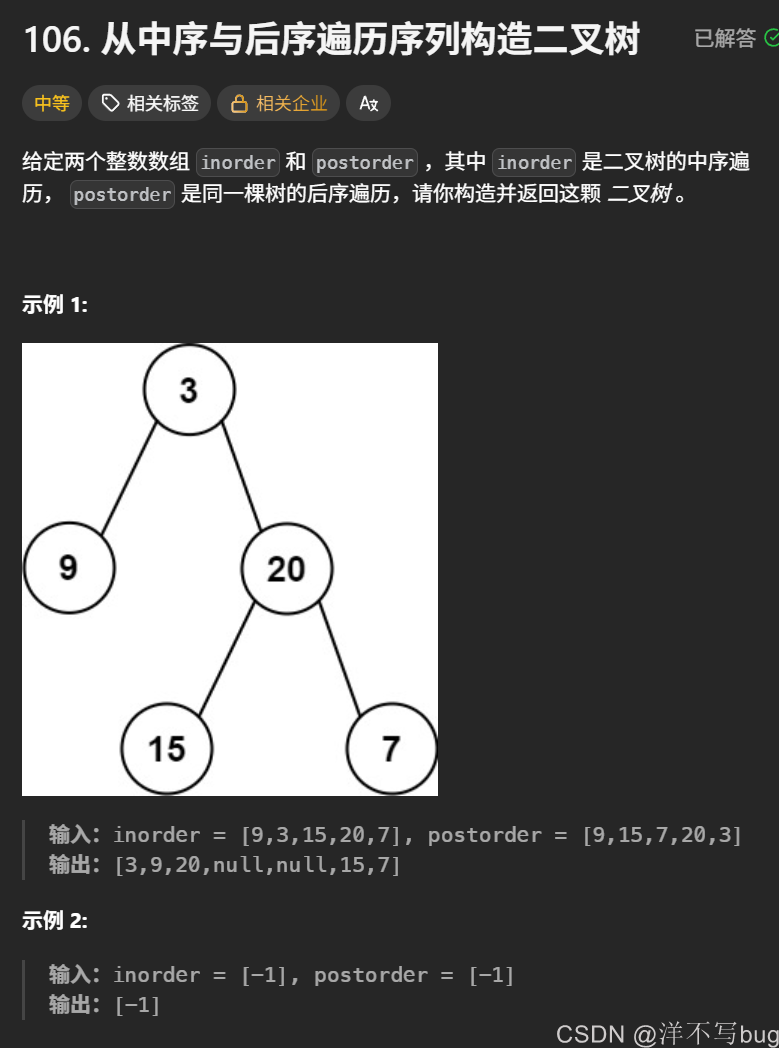
这个题目跟上个比较类似,preorder是从前往后遍历,postorder改为从后往前遍历就行了,后序序列中,从后往前遍历是先根结点,后右子树,再左子树,构建树的顺序改一下即可
class Solution {

    private int index = 0;
    public TreeNode buildTree(int[] inorder, int[] postorder) {
        index = postorder.length - 1;
        return buildTreeHelper(inorder,postorder,0,inorder.length);
    }

    public TreeNode buildTreeHelper(int[] inorder, int[] postorder,int inLeft,int inRight){
        if(inLeft >= inRight){
            return null;
        }
        TreeNode root = new TreeNode(postorder[index]);
        index--;
        int pos = findPos(inorder,inLeft,inRight,root.val);
        root.right = buildTreeHelper(inorder,postorder,pos + 1,inRight);
        root.left = buildTreeHelper(inorder,postorder,inLeft,pos);
        return root;
    }

    public int findPos(int[] inorder,int inLeft,int inRight,int val){
        for(int i = inLeft;i < inRight;i++){
            if(inorder[i] == val){
                return i;
            }
        }
        return -1;
    }
}
4,根据二叉树创建字符串
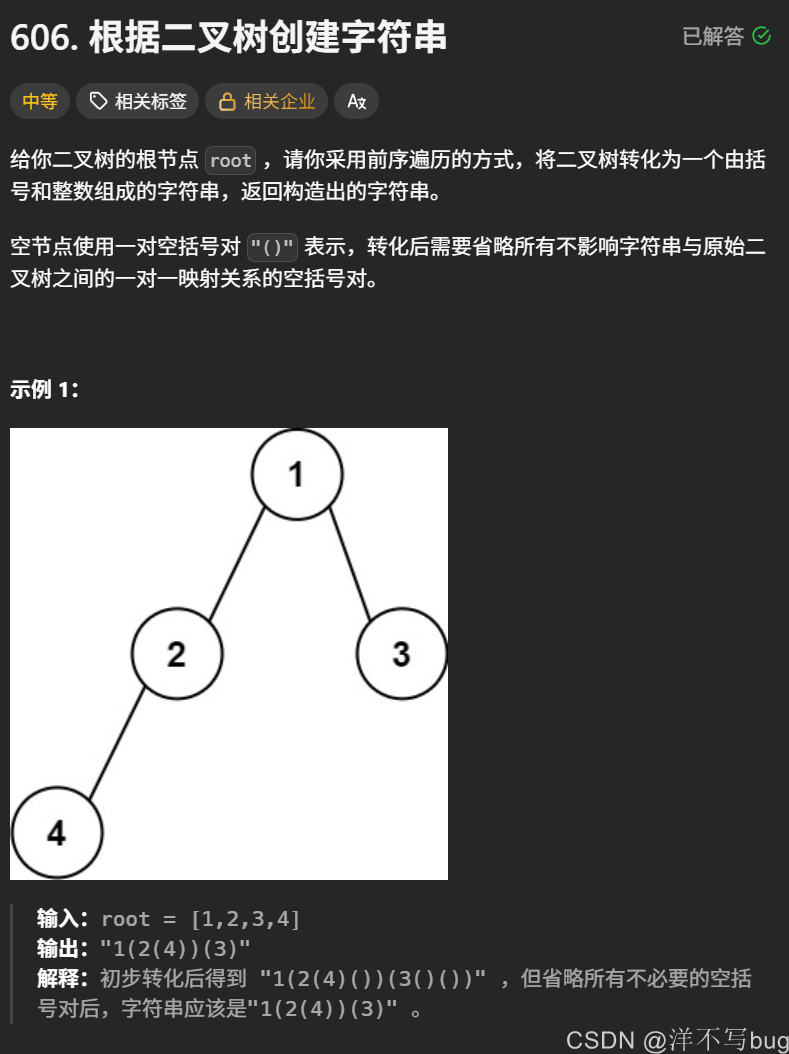
题目的意思就是在先序遍历的结果上,加上括号表示子树,就比如示例1,(2(4))和(3)就是1的左子树和右子树
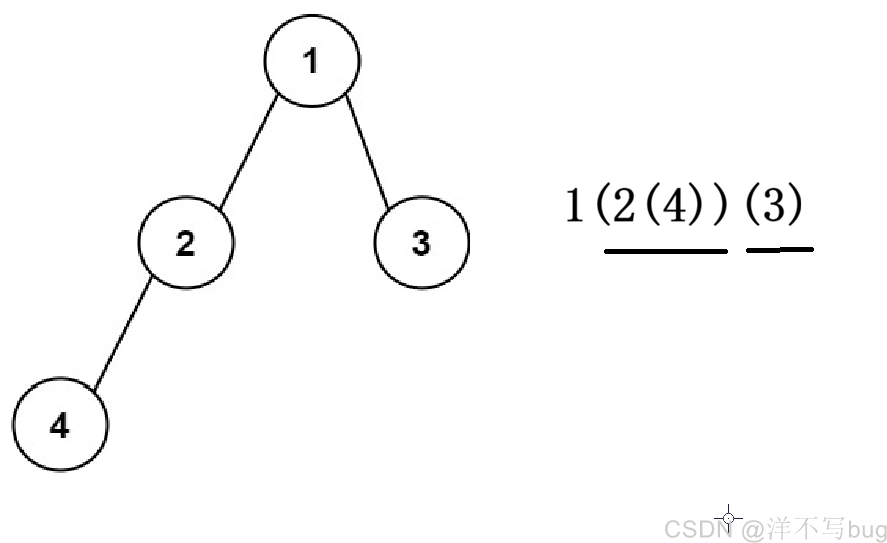
还需要注意一点,当一个结点的左子树为空,右子树不为空时,还要额外的加上个空括号,就比如示例2中,2的左子树为空,就写成(2()(4)),其他情况下都是不需要加空括号的
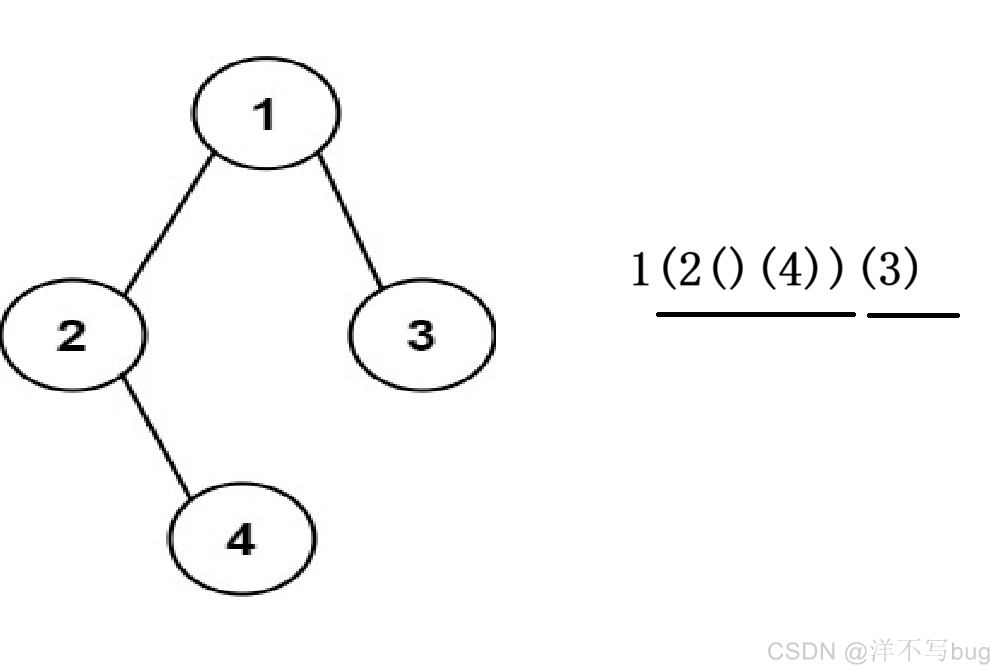
这个题目就是在先序遍历中,加入一些添加括号的逻辑,对于子树来说,就是先在根结点外打印括号,接着里面加入元素,例如示例1中的(2(4))
写代码的时候创建个StringBuilder类型的成员变量result,再整个void类型的tree2strHelper方法,在里面递归构建字符串
在result中添加完成root.val,的时候,还需要判断下左子树是否为空,如果为空,就添加一个()
结果最外层是没有括号的(根结点是一个特例),还需要用deleteCharAt方法把最外层的括号给删除掉
class Solution {

    private StringBuilder result = new StringBuilder();
    public String tree2str(TreeNode root) {
        if(root == null){
            return " ";
        }
        result = new StringBuilder();
        tree2strHelper(root);
        result.deleteCharAt(0);
        result.deleteCharAt(result.length() - 1);
        return result.toString();
    }

    public void tree2strHelper(TreeNode root){
        if(root == null){
            return;
        }
        result.append("(");

        result.append(root.val);
        if(root.left == null && root.right != null){
            result.append("()");
        }
        tree2strHelper(root.left);
        tree2strHelper(root.right);
        result.append(")");

    }
}
5,二叉树的前序遍历(非递归)
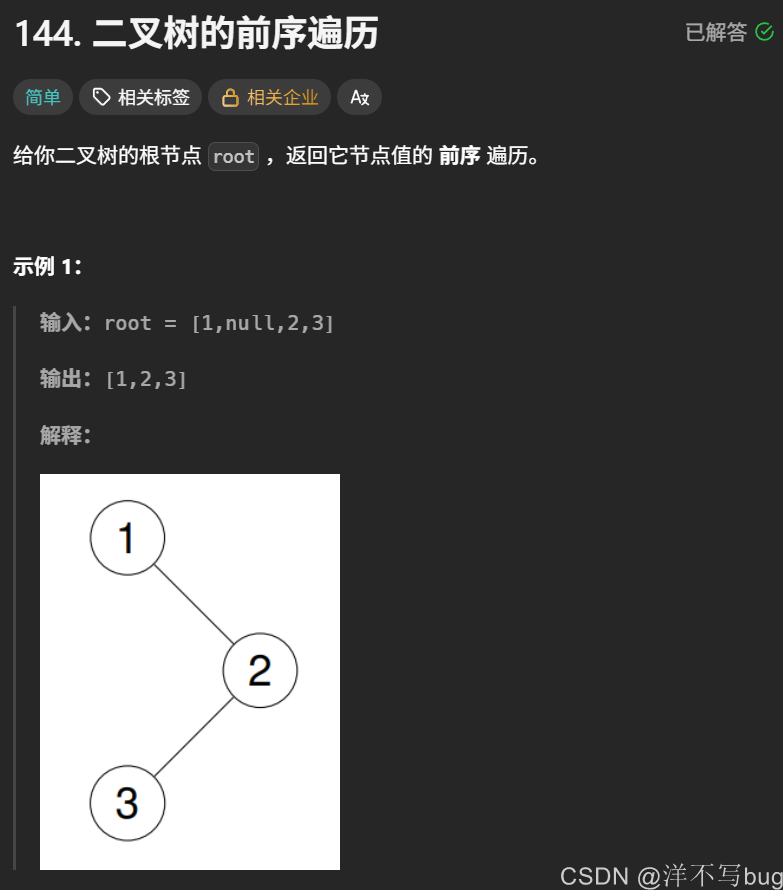
前序遍历递归代码大家都会写,这个题目最下方提到说能否通过迭代的方式来完成前序遍历,在面试中为了考量代码能力,这种要求是很有可能提出来的
递归的关键就是“回溯”,例如前序遍历,先访问根结点,再访问左子树,再访问右子树;左子树的结点都访问完成后,就会回溯到根结点,再访问根结点的右子树
我们就可以使用栈,来模拟左子树递归完成,回溯到根结点,再去访问右子树的情况,具体分为以下几步:
- 创建栈,根结点入栈
- 接着循环的把栈顶元素出栈,访问这个元素
- 把右子树先入栈,再把左子树入栈,因为栈的特点是后进先出
- 下次循环取出的栈顶元素就是左子树的根结点,访问这个元素,把这个元素的左子树和右子树再入栈
- 当整个左子树的结点都访问完成后,出栈就轮到了右子树的根结点
class Solution {

    public List<Integer> preorderTraversal(TreeNode root) {
        List<Integer> result = new ArrayList<>();
        if(root == null){
            return result;
        }
        Stack<TreeNode> stack = new Stack<>();
        stack.push(root);
        while(!stack.isEmpty()){
            TreeNode cur = stack.pop();
            result.add(cur.val);
            if(cur.right != null){
                stack.push(cur.right);
            }
            if(cur.left != null){
                stack.push(cur.left);
            }
        }
        return result;
    }

}
铁汁们可以拿示例2中的那棵树代入方法,看下迭代过程,这里博主就不画图了
6,二叉树的中序遍历(非递归)
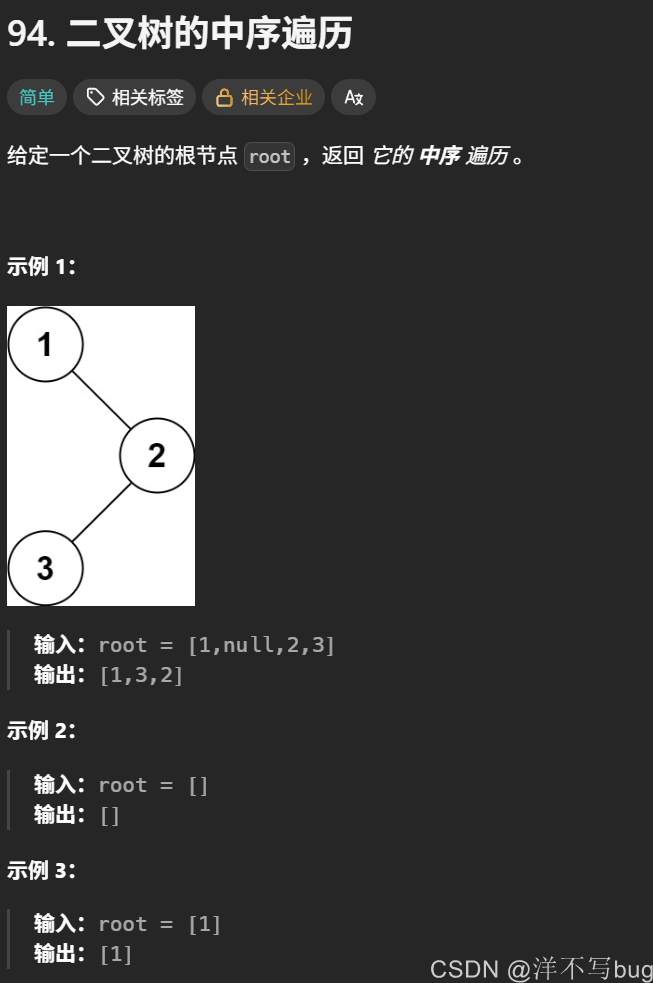
中序遍历是先递归左子树,再访问根结点,最后递归右子树
中序遍历一上来不能访问根结点,要访问根结点的左子树,访问到左子树的根结点后,还是不能继续访问,要等到左子树为空时,才能访问根结点,步骤如下
- 从根结点触发,一路入栈左子树,直到遇到左子树为空的情况
- 当出现左子树为空的情况时,就说明当前结点可以访问了,访问栈顶元素(出栈),把这个元素加入到list中
- 再取到栈顶元素的右子树根结点,重复第一个步骤,一路入栈左子树,直到遇到左子树为空的情况
代码如下,个人感觉中序遍历的代码要比前序遍历难想,非常建议铁汁们找个树结构,代入代码,模拟下栈出入队列的过程🐵
class Solution {
    public List<Integer> inorderTraversal(TreeNode root) {
        List<Integer> result = new ArrayList<>();
        if(root == null){
            return result;
        }
        Stack<TreeNode> stack = new Stack<>();
        TreeNode cur = root;
        while(true){
            while(cur != null){
                stack.push(cur);
                cur = cur.left;
            }

            if(stack.isEmpty()){
                break;
            }
            TreeNode top = stack.pop();
            result.add(top.val);
            cur = top.right;
        }
        return result;
    }
}
7,二叉树的后序遍历(非递归)
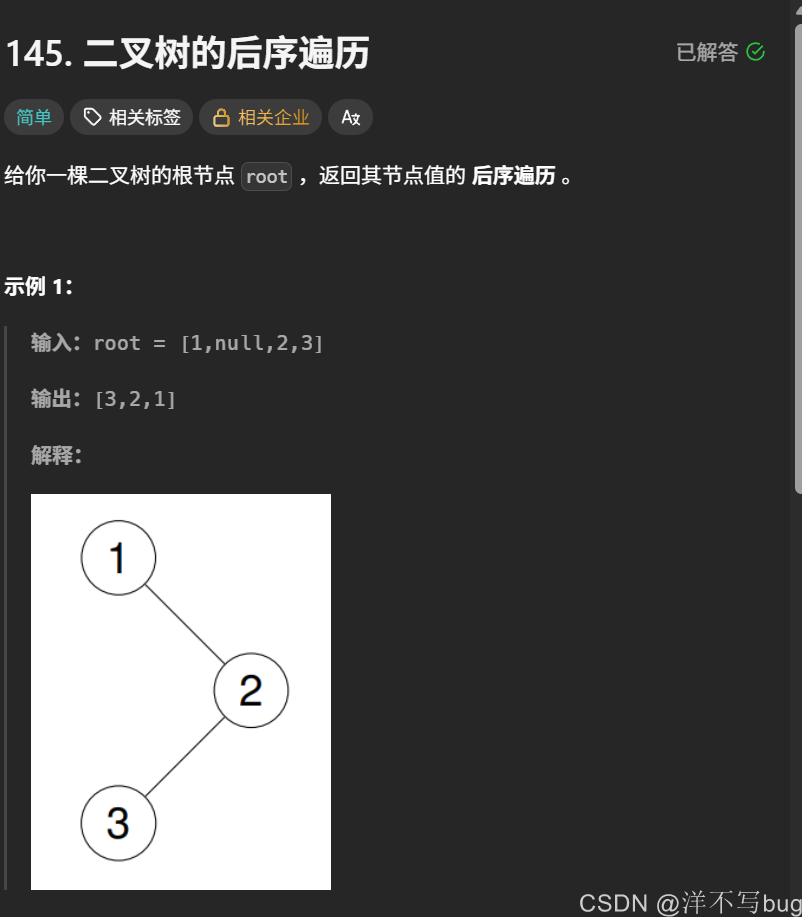
后序遍历的特点就是当左子树和右子树都访问过了,才去访问根结点
后序遍历和中序遍历都是先访问左子树,因此起手式是一样的,都是从根结点开始,一路左子树入栈,直到左子树为空,单靠左子树为空是不能访问栈顶结点的,还要判断右子树的情况
步骤如下:
- 如果右子树为空,就可以直接访问栈顶结点
- 如果右子树不为空,已经被访问过了,也可以直接访问栈顶结点
- 如果右子树不为空,并且没有被访问,那就拿到右子树的根结点,继续重复前面的步骤:一路左子树入栈,直到左子树为空
那如何去判断右子树有没有被访问过呢?
因为是后序遍历,完成遍历后,倒数第一个结点是根结点,倒数第二个结点就是右子树的根结点,也就是说,如果右子树被访问过了,那上一次出栈的元素就是右子树的根结点,我们就可以维护一个TreeNode类型的引用prev,记录最近一次出栈的栈顶元素,判断时只需要比较下prev是否与右子树的根结点相同即可
class Solution {

    public List<Integer> postorderTraversal(TreeNode root) {
        List<Integer> result = new ArrayList<>();
        if(root == null){
            return result;
        }
        TreeNode prev = null;
        Stack<TreeNode> stack = new Stack<>();
        TreeNode cur = root;
        while(true){
            while(cur != null){
                stack.push(cur);
                cur = cur.left;
            }
            if(stack.isEmpty()){
                break;
            }
            TreeNode top = stack.peek();
            if(top.right == null || top.right == prev){
                result.add(top.val);
                stack.pop();
                prev = top;
            }else{
                cur = top.right;
            }
        }
        return result;
    }
}
结语
- 二叉树(二)(三)(四)博客都是解析二叉树的相关算法,这部分内容也经常被称为数据结构中最难的部分,难的就是递归算法的分析,学习这部分内容最好的方法就是画图细品
- 到这篇博客,数据结构中的知识已经解析了一多半了,最难的部分也已经过去了,恭喜铁汁们🎉🎉,下篇博客会解析堆
以上就是今天的所有内容啦~完结撒花~🥳🎉🎉
 428


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


