多线程redis项目基石

Redis高阶篇之Redis单线程与多线程 之前写过关于Redis的十篇文章,关于Redis快的原因是单线程执行指令和IO多路复用比较笼统,所以打算单开一篇文章深入介绍Redis单线程与多线程。以及Redis不同版本的多线程和IO多路复用情况。Redis自身出道就是优秀,基于内存操作、数据结构简单、多路复用和非阻塞I/O、避免了不必要的线程上下文切换等特性,在单线程的环境下依然很快; 阅读详情

目录

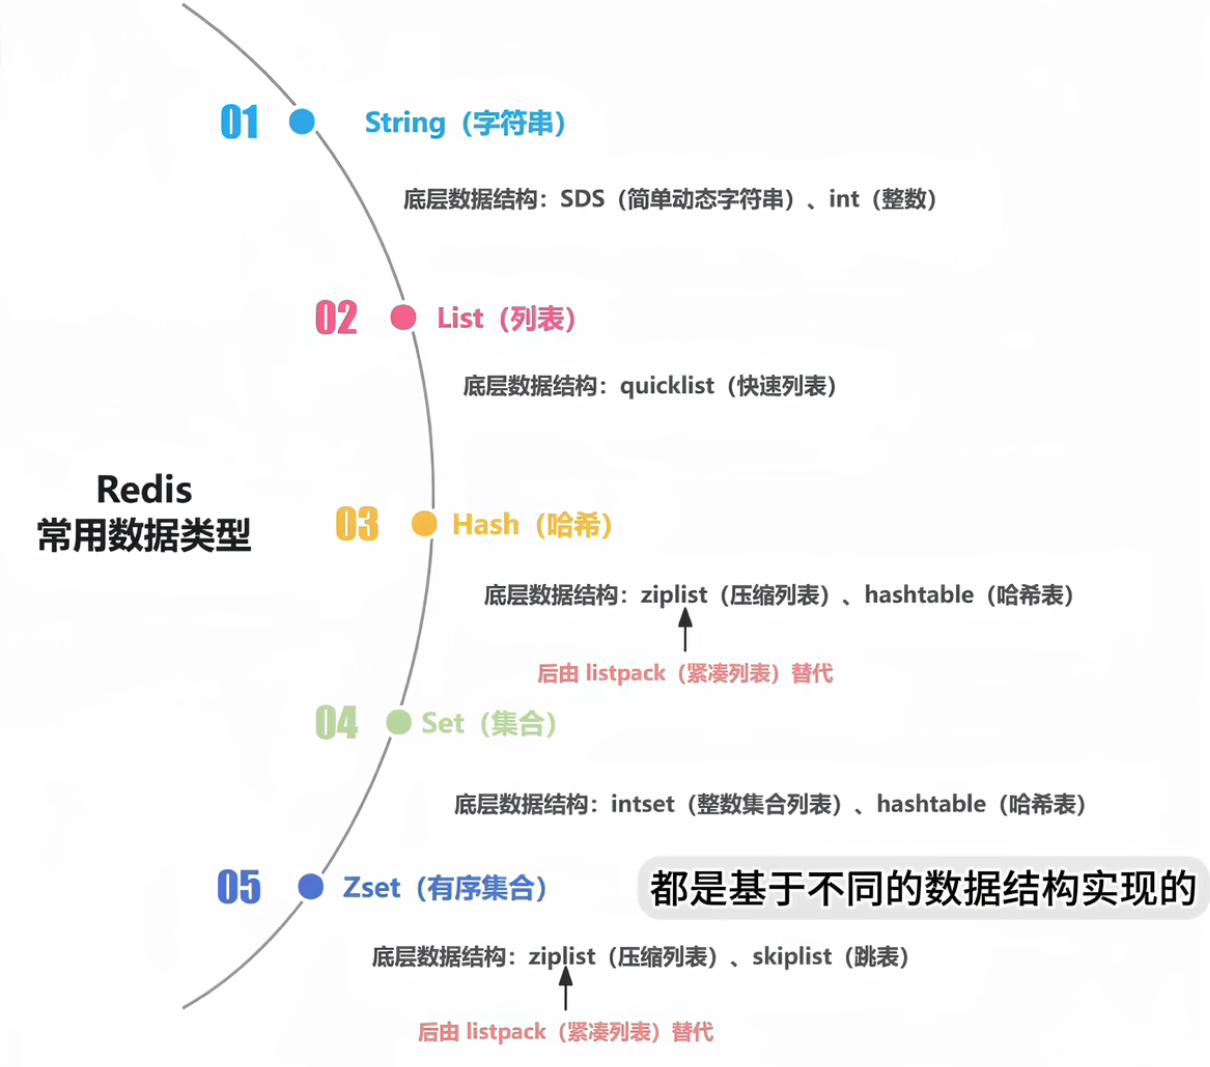
前提:redis项目之存储类型

一、redis源码如何做的

二、获取当前时间

三、掌握容器的查找

四、关于redis的过期策略

3.1 惰性删除

3.2 定期删除

五、关于redis的持久化策略

5.1 rdb生成快照

5.2 aof

六、跳表


前提:redis项目之存储类型

b站仙可程序员的总结

一、redis源码如何做的

typedef struct dict {
    dictType *type;      // 函数指针表:哈希函数、键对比函数等
    void *privdata;      // 私有数据:传给 type 里的函数
    dictht ht[2];        // 【核心】两个哈希表!ht[0] 是主表,ht[1] 是 rehash 临时表
    long rehashidx;      // rehash 进度:-1 表示没在 rehash,≥0 表示当前 rehash 到的桶索引
    unsigned long iterators; // 安全迭代器数量
} dict;

typedef struct dictht {
    dictEntry **table;   // 哈希桶数组:每个元素是指向 dictEntry 的指针
    unsigned long size;  // 桶数组的大小(必须是 2^n)
    unsigned long sizemask; // 桶数组的掩码:size-1(用于快速计算哈希值对应的桶索引)
    unsigned long used;  // 已存储的键值对数量
} dictht;

typedef struct dictEntry {
    void *key;           // 键(通常是 SDS)
    union {              // 【核心】值用 union 节省内存
        void *val;
        uint64_t u64;
        int64_t s64;
        double d;
    } v;
    struct dictEntry *next; // 指向下一个节点(链地址法处理哈希冲突)
} dictEntry;

//注意dictEntry中的联合体中的val实际指向一个redisObject(里面存储实际value)
typedef struct redisObject {
    unsigned type:4;        // 【核心标记】4位,标记 Value 的类型
    unsigned encoding:4;    // 4位,标记 Value 的底层数据结构
    unsigned lru:LRU_BITS;  // LRU 时间(用于内存淘汰)
    int refcount;            // 引用计数(用于对象共享)
    void *ptr;               // 指向实际的底层数据结构
} robj;

一句话说清楚:采用了链地址法,hash桶,每个桶都是一条链子,避免了hash冲突

dict里面有两个hash表,其中一个是为了rehash的,哈希表里面是哈希桶,每个桶存储的是dictEntry*(也就是链头节点),然后每个节点存储的是key-value

1.最核心设计亮点:渐进式 rehash

这是 Redis dict 最经典的设计,解决了 大哈希表扩容时的阻塞问题。

1.1 为什么需要渐进式 rehash?

普通哈希表(比如 std::unordered_map)扩容时是一次性的:

  • 当 used > size * load_factor(通常 0.75)时,分配新的桶数组;

  • 把所有节点从旧桶数组一次性拷贝到新桶数组;

  • 如果哈希表很大(比如 1000 万个键),这一步会阻塞几百毫秒甚至几秒,Redis 作为实时数据库绝对不能接受。

1.2 Redis 的解决方案:渐进式 rehash

核心思路:不一次性拷贝所有节点,而是分多次、逐步拷贝,把扩容开销分摊到每次操作中。

具体步骤

  1. 触发扩容:当 ht[0].used > ht[0].size * load_factor 时:

    • 给 ht[1] 分配新的桶数组(大小是 ht[0].size 的 2 倍,且是 2 的幂);

    • 把 rehashidx 设为 0(表示开始 rehash)。

  2. 逐步迁移:每次对 dict 进行增删改查时:

    • 顺便把 ht[0].table[rehashidx] 这个桶里的所有节点从 ht[0] 拷贝到 ht[1];

    • rehashidx++;

    • 如果 rehashidx 达到 ht[0].size,说明所有节点都迁移完了。

  3. 完成迁移:

    • 把 ht[1] 设为 ht[0];

    • 释放旧的 ht[0];

    • 把 rehashidx 设为 -1(表示 rehash 结束)。

效果

  • 扩容的开销被分摊到每次操作中,单次操作的延迟只有几纳秒,完全不会阻塞;

  • 用户感知不到扩容的存在。


2. 哈希冲突处理:链地址法

和 std::unordered_map 类似,Redis 用 链地址法 处理哈希冲突:

  • 当两个键的哈希值落在同一个桶里时,用链表把它们串起来;

  • 查找时,先算哈希值找到桶,再遍历链表对比键。


3. 哈希函数和桶大小的选择

3.1 哈希函数

Redis 用 MurmurHash2 哈希函数:

  • 计算速度快;

  • 哈希值分布均匀,减少哈希冲突;

  • 适合字符串、整数等多种类型的键。

3.2 桶大小的选择

  • 桶大小必须是 2 的幂;

  • 配合 sizemask(size-1)用位运算快速计算桶索引:hash & sizemask;

  • 比取模运算(hash % size)快很多。


4. Redis dict vs C++ std::unordered_map 核心对比

维度

Redis dict

C++ std::unordered_map

扩容方式

渐进式 rehash(分多次,不阻塞)

一次性扩容(可能阻塞)

桶大小

必须是 2^n(位运算快速计算索引)

通常是质数(取模计算索引)

值存储

用 union 节省内存

直接存储对象(或指针)

迭代器安全性

支持安全迭代器(迭代时不 rehash)

迭代时修改可能导致迭代器失效

内存开销

更小(自研,无 C++ 标准库的额外元数据)

更大(有标准库的额外元数据)

代码复杂度

高(需要自己实现哈希表、渐进式 rehash)

低(直接用标准库)


总结

  1. 宏观作用:全局哈希表是 Redis KV 存储的核心骨架,所有 Key 都存在这里;

  2. 三层结构:dict(管理两个哈希表)→ dictht(实际哈希表)→ dictEntry(哈希节点);

  3. 最核心亮点:渐进式 rehash,解决大哈希表扩容阻塞问题;

  4. 哈希冲突处理:链地址法;

  5. 性能优化:MurmurHash2 哈希函数、桶大小 2^n、位运算计算索引。

编码的作用:如果所有的key、redisObject、value都分开存,那会造成内存离散,所以编码的作用就是在一些value非常小的情况下,让redisObject和value一块存(也就是开同一块大的内存空间,前面存redisObject,后面存value),这样能够避免内存离散

但是注意不能都开一块,如果value很大,你都开一块了,会造成连续的很大,有时候没有内存分配,内存总量可能还剩很多,但都是 “小块碎片”,没有足够大的连续块;

不是不想都开连续内存,而是大数据下连续内存的 “操作效率、扩容成本、分配成功率” 都太差了,所以 Redis 做了权衡:

  • 小数据:连续内存(省内存、Cache 好);
  • 大数据:离散内存(操作快、分配易、扩容灵活)。

这次项目我们主要采用unordered_map实现这个复杂的hash表

维度Redis dictstd::unordered_map
最大亮点✅ 渐进式 rehash(不阻塞)❌ 一次性扩容(可能阻塞)
内存统计✅ 内置(zmalloc)❌ 无(需自己封装)
值存储优化✅ union 节省内存❌ 无
安全迭代器✅ 支持❌ 不支持
哈希函数✅ MurmurHash2(均匀、快)⚠️ 取决于标准库
桶大小✅ 必须 2^n(位运算快)⚠️ 通常 2^n,但非必须
内存碎片✅ 少(jemalloc/tcmalloc)⚠️ 较多(libc malloc)
适用场景✅ 高性能内存数据库✅ 通用场景
redis在各个能够优化的地方都做了优化处理

二、获取当前时间

int64_t KeyValueStore::nowMs()
{
  using namespace std::chrono; // 简化 chrono 库的命名空间
  // 核心逻辑:获取当前时间 → 转换为从"纪元"开始的毫秒数 → 返回
  return duration_cast<milliseconds>( // 步骤3:把时间间隔转换成「毫秒」单位
    steady_clock::now()              // 步骤1:获取当前系统的稳定时钟时间点
    .time_since_epoch()              // 步骤2:计算从"纪元时间"到当前时间的总间隔
  ).count();                         // 步骤4:取出毫秒数的数值(转成 int64_t)
}
  • steady_clock(稳定时钟):系统的 “单调递增时钟”,不会因系统时间修改(比如手动调时间、NTP 同步)而跳变,适合计算「时间间隔」;
  • time_since_epoch():计算从 “纪元时间”(不同系统略有差异,通常是 1970-01-01 00:00:00 UTC 或系统启动时间)到当前时间的总时间间隔;
  • duration_cast<milliseconds>:把时间间隔强制转换成「毫秒」单位(也可以转成秒 seconds、微秒 microseconds);
  • .count():取出时间间隔的 “数值部分”(比如 1710000000000 毫秒),返回整数。

steady_clock::now() 返回的不是 “普通数值”,而是 std::chrono::time_point 类型的时间点对象——.time_since_epoch() 是这个对象的成员函数,作用是把 “时间点” 转换成 “从纪元开始的时间间隔”,最终才能换算成毫秒数。

核心就是为了避免有人修改系统时间而导致key的定时删除出现问题

三、掌握容器的查找

find_if

四、关于redis的过期策略

3.1 惰性删除

惰性删除:不主动轮询所有 Key 检查过期,而是在「访问 / 操作 Key 前」先检查是否过期,若过期则直接删除,保证用户获取的永远是未过期的有效数据;

简单来说在get等函数的获取key的时候,先检查一下key是否过期,如果过期直接删除,然后返回nil即可

3.2 定期删除

这是一种主动的删除策略。Redis 会周期性地随机从数据库中取出一定数量的键,检查它们是否过期,并删除其中过期的键。Redis 会通过配置文件中的 hz 参数(默认值是 10 ,表示每秒执行 10 次过期扫描)来控制定期删除操作的执行频率。每次扫描时,Redis 会随机选择一些数据库,然后从每个数据库中随机取出一定数量的键进行检查。这种策略能有效减少过期键对内存的占用 ,不过如果执行过于频繁,会消耗较多 CPU 资源;如果执行频率过低,又会导致过期键长时间占用内存。

五、关于redis的持久化策略

5.1 rdb生成快照

1. 定义

RDB(Redis Database)是一种结构化二进制文件,用于将内存中的 KV 数据序列化后持久化到磁盘,服务重启后可通过加载 RDB 文件恢复数据。

2. 关键澄清:不是 “内存 01 直接拷贝”

对比项内存直接拷贝(原始二进制)RDB(结构化二进制)
跨平台性差(依赖操作系统 / CPU 内存布局)优(按统一协议序列化)
压缩性无(直接存内存字节)有(可对短字符串、整数做编码压缩)
兼容性差(代码修改后内存布局变化,无法恢复)优(有版本号,可向前 / 向后兼容)
安全性差(无校验,数据损坏无法检测)优(有 CRC64 校验和,可检测数据完整性)
+----------------+----------------+----------------+----------------+----------------+
| 魔数头部       | 版本号         | 数据库数据块    | 结束标记       | 校验和         |
| "MINIREDIS"    | 4字节整数      | 多个 Key-Value  | 1字节(0xFF)    | 8字节CRC64     |
| (8字节)        | (如 0x00000001)| 对(带类型)    |                |                |
+----------------+----------------+----------------+----------------+----------------+

// 单个 Key-Value 数据块结构(以 String 为例)
+------------+------------+------------+------------+------------+
| 数据类型    | Key长度    | Key内容    | Value长度  | Value内容  |
| 1字节       | 变长整数   | 字节流     | 变长整数   | 字节流     |
| (0x00=String)|            |            |            |            |
+------------+------------+------------+------------+------------+

// Hash 数据块结构
+------------+------------+------------+------------+------------+------------+
| 数据类型    | Key长度    | Key内容    | Field数量  | Field1-Value1 | ... |
| 1字节(0x02) | 变长整数   | 字节流     | 4字节整数  | (变长+变长)   | ... |
+------------+------------+------------+------------+------------+------------+

// ZSet 数据块结构(区分 vector/跳表,统一按有序存储)
+------------+------------+------------+------------+------------+------------+
| 数据类型    | Key长度    | Key内容    | 成员数量  | Member1-Score1 | ... |
| 1字节(0x03) | 变长整数   | 字节流     | 4字节整数  | (变长+8字节double) | ... |
+------------+------------+------------+------------+------------+------------+

简单来说就是按照一定的格式,序列化存储起来

5.2 aof

AOF(Append Only File)是 Redis 另一种核心持久化方式,本质是 “追加式写命令日志”—— 和 RDB(快照)不同,AOF 不保存内存数据的副本,而是把每一条写操作命令(如 set/hset/zadd/zrem)按顺序追加到文件末尾;服务重启后,通过重放(Replay) AOF 中的所有写命令来恢复数据,数据安全性比 RDB 更高(可配置秒级持久化)。

维度AOF(Append Only File)RDB(Redis Database)
保存内容写操作命令(如 set key value)内存数据的结构化快照
保存方式追加写入(Append)全量覆盖写入
数据安全性高(可配置每秒 / 每次写同步)中(全量快照,可能丢失最后一次快照后的数据)
文件大小大(记录所有写命令,需重写压缩)小(结构化二进制,可压缩)
恢复速度慢(需重放所有命令)快(直接加载快照)
典型场景数据安全性要求高(如金融、交易)备份、快速恢复、数据迁移
Redis 的 AOF 默认使用 RESP(Redis Serialization Protocol) 文本协议记录命令,可读性比 RDB 高(Vim 打开能直接看懂命令)。 

简单来说,采用我们之前写的resp协议进行写进硬盘存储起来

六、跳表

以下是b站仙可程序员的总结

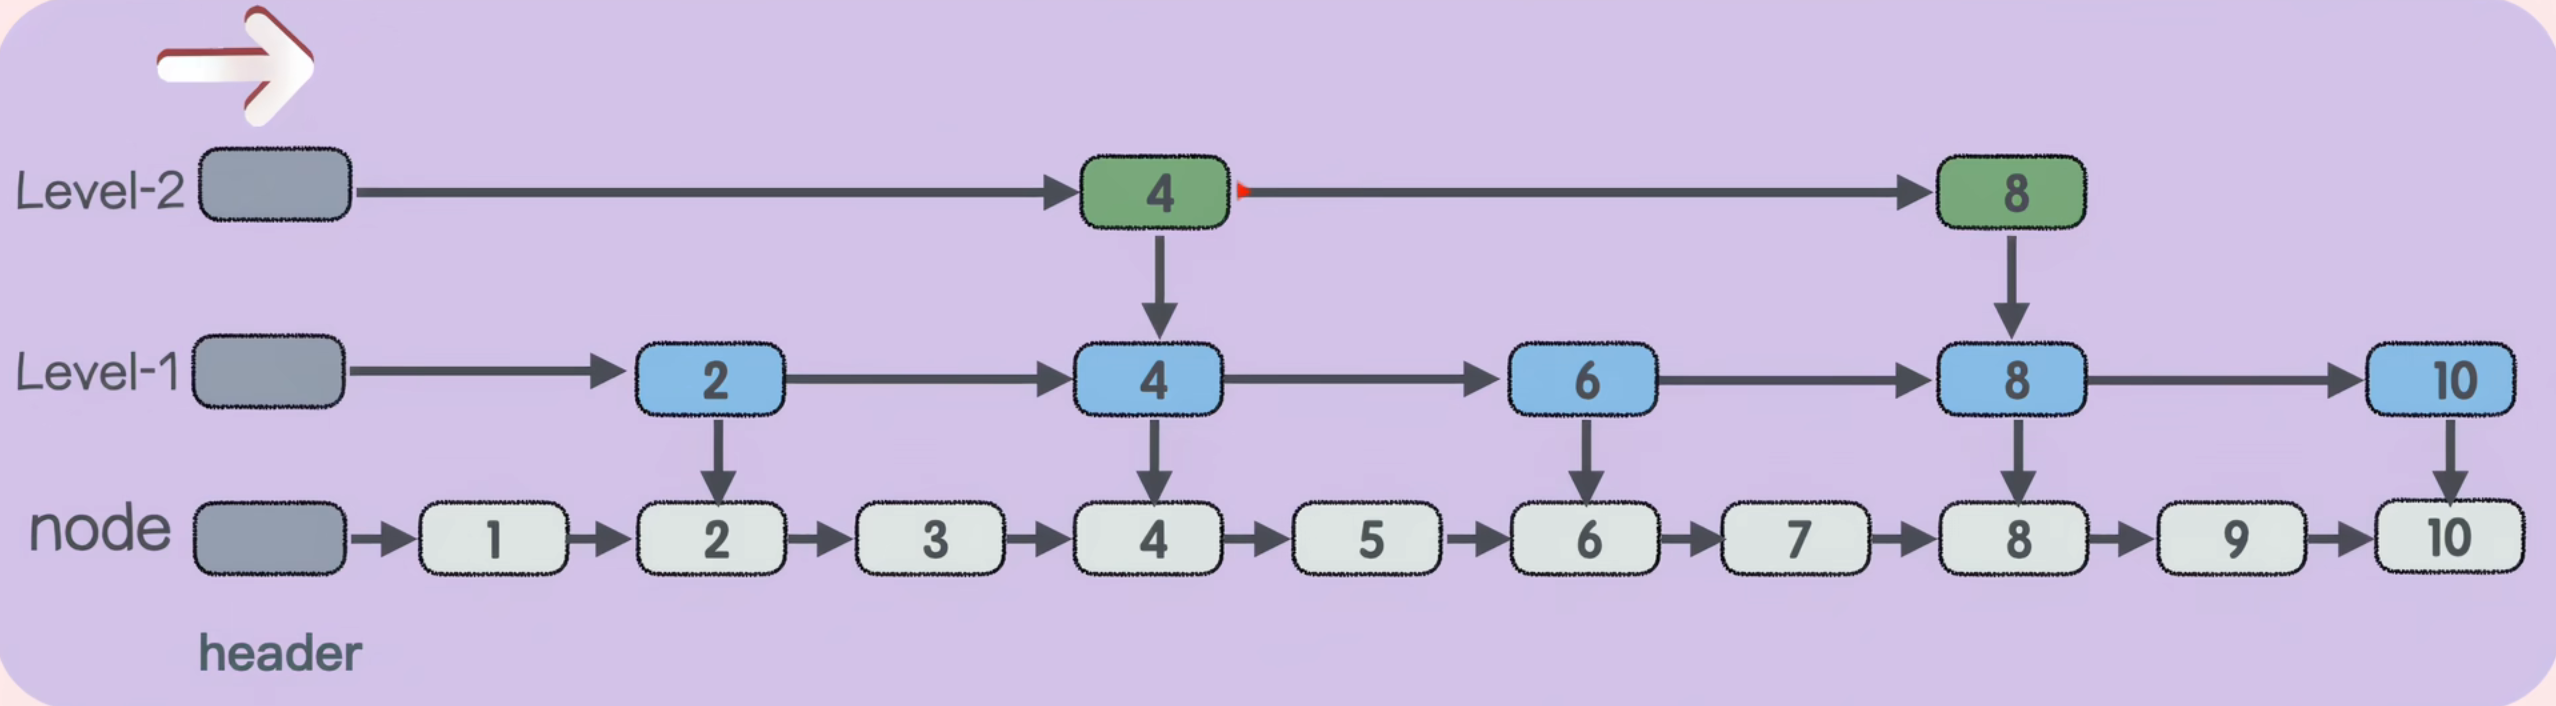
常规链表不便于查找,所以我们在常规链表的基础上增加多级索引,即跳表

决定底层元素能否成为level的索引取决于随机概率p(晋升概率),如果p=0.5,说明每个节点都有一半的机会往上跃迁

注意每一层都有一个头节点

比如查找4,先进入level-2查找,刚好可以则返回

比如查找5,先进入level-2查找,比4大,去下一个节点,即8,因为8比5大,回退上一个节点,然后由节点4进入level-1查找,往右,因为6比5大,所以回退上一个节点,进入node层

然后往右查,5==5,然后返回即可

总结:建立多级索引,达到时间复杂度O(logN),p 越大,查询越快但内存越高;p 越小,内存越省但查询越慢。

p=0.25 的查询性能和 p=0.5 几乎无感知差异(差 1 倍查询次数,但每次查询都是内存操作,微秒级)。redis选择了0.25

注意p:这里指的是每个节点都有机会往上晋升的概率,真实的跳表(如 Redis)就是通过 “每个节点有 25% 概率晋升一层” 的规则,在概率上实现 “高层节点数≈底层的 1/4”
【Redis】 - Redis 6.0 新特性之多线程模型 在执行命令阶段:Redis是单线程来执行命令的,每一条到达读服务端的命令并不会立即执行,所有的命令都会进入一个 socket 任务队列中,当 socket 可读则交给单线程事件分发器逐个被执行,即一个线程处理所有网络请求。如下图所示:从Redis 4.0 以后并不是严格意义上的单线程,除了主线程外,Redis 也有后台线程或子进程处理一些其他较为缓慢的操作(例如:无用连接的释放、慢IO访问和一些其他类似操作 - 清理脏数据、生成快照、AOF重写等)。 阅读详情

相关推荐

Redis高级之单线程和多线程

Redis高级之单线程和多线程

qq_55846232的博客 1903

Redis6 多线程模型

线程,都同时处理图中的“队列”,是不是会存在锁竞争的关系尼?还需要注意的是,线程数并不是越大越好,官方认为超过了。,并对数据进行协议解析,当队列全部处理完毕后,主线程会对队列中请求串行“执行。官方建议:只在机器至少有4个内核时才启用多线程模型,且至少留下一个备用内核。【6】主线程执行所有命令并清空整个等待队列,等待客户端后续的请求队列;件事情串行一起执行,因为是基于内存,所以执行速度非常快。开启多线程后,还需要设置线程数,否则是不生效的。和串行操作,某个操作“出问题”会“阻塞”后续操作。

程序猿进阶 2719

Redis为什么这么快?Redis为什么引入多线程?Redis多线程实现机制是怎样?

Redis 为什么这么快单线程模型:避免了多线程的上下文切换和锁竞争,简化了并发控制。内存数据库:所有数据存储在内存中,避免了磁盘 I/O 延迟。高效数据结构:Redis 使用高效的 SDS、跳表、哈希表等数据结构,优化了查询和修改操作。异步操作:持久化和数据同步操作是异步的,避免了阻塞主线程。为什么引入多线程Redis 的单线程模型在 I/O 密集型操作(如持久化、主从复制等)上存在瓶颈,特别是无法充分利用多核 CPU 的性能。引入多线程可以将 I/O 密集型操作并行化,提高整体性能。

longgelaile的博客 910

Redis 多线程网络模型全面揭秘

导语一文带你完全吃透 Redis 整个核心网络模型的原理和源码。 目录 导言 Redis 有多快? Redis 为什么快? Redis 为何选择单线程? 避免过多的上下文切换开销 避免同步机制的开销 简单可维护 Redis 真的是单线程? 单线程事件循环 多线程异步任务 Redis 多线程网络模型 设计思路 源码剖析 性能提升 模型缺陷 总结 博客原文 导言 在目前的技术选型中,Redis 俨然已经成为了系统高性能缓存方案的事实标准,因此现在 Redis...

少说,多做。 4357

保姆级避坑指南:在NVMe SSD上安装Ubuntu 24.04,搞定RST错误和分区方案

本文提供在NVMe SSD上安装Ubuntu 24.04的详细指南,解决RST错误和分区方案问题。从BIOS设置到分区策略优化,帮助用户充分发挥NVMe固态硬盘性能,避免常见安装陷阱,实现无痛安装和后期调优。

weixin_26976635的博客 560

c764-基于Vue的实时温湿度监控系统

🌟 毕业设计指导交流 🌟 同学们好!作为一名计算机专业的技术爱好者,我在毕业设计领域积累了一些经验,希望能和大家分享交流。从选题到答辩,欢迎一起探讨技术问题。💡 技术方向: 熟悉Java全栈(SSM/Spring Boot)、Python数据分析、微信小程序/安卓开发等技术栈,可以互相学习项目开发经验。📂 学习资源: 整理了一些开源项目案例(含代码和文档),需要参考的同学可以留言讨论,也欢迎分享你的项目经验。🛠 交流内容:✨ 欢迎在评论区留言讨论,一起进步!记得遵守社区规范,保持学术

weixin_39513710的博客 1069

Redis为什么这么快?Redis的线程模型与Redis多线程

一、Redis有多快? Redis是基于内存运行的高性能 K-V 数据库,官方提供的测试报告是单机可以支持约10w/s的QPS 二、Redis为什么这么快: (1)完全基于内存,数据存在内存中,绝大部分请求是纯粹的内存操作,非常快速,跟传统的磁盘文件数据存储相比,避免了通过磁盘IO读取到内存这部分的开销。 (2)数据结构简单,对数据操作也简单。Redis中的数据结构是专门进行设计的,每种数据结构都有一种或多种数据结构来支持。Redis正是依赖这些灵活的数据结构,来提升读取和写入的性能。 .

张维鹏的博客 2万+

Isaac Sim仿真平台学习(2)系统架构

isaac sim系统架构

weixin_75067193的博客 2698

Redis 线程模型,Redis多线程到底是什么

Redis多线程,一文说明其本质

zwl2220943286的博客 1691

用Seurat和ComplexHeatmap绘制单细胞marker基因热图:从数据处理到可视化全流程

本文详细介绍了使用Seurat和ComplexHeatmap绘制单细胞marker基因热图的全流程,涵盖从数据处理、基因筛选、平均表达矩阵计算到高级可视化与注释添加。重点解析了如何利用ComplexHeatmap生成发表级热图,并整合热词信息,解决单细胞数据可视化中的常见问题,提升科研图表质量。

weixin_29048775的博客 529

保姆级教程:用GROMACS的FEP方法计算小分子结合自由能(附完整mdp配置)

本文提供了一份详细的GROMACS自由能微扰(FEP)计算教程,涵盖从系统准备、参数配置到结果分析的全流程。通过具体案例演示如何计算小分子结合自由能,包括λ窗口设计、动力学参数优化及并行化执行技巧,帮助研究者克服FEP计算中的常见问题,获得可靠的自由能数据。

weixin_30598225的博客 353

33.Redis多线程

反应”器名字中”反应“的由来:“反应”即“倒置”,“控制逆转”,具体事件处理程序不调用反应器,而向反应器注册一个事件处理器,表示自己对某些事件感兴趣,有时间来了,具体事件处理程序通过事件处理器对某个指定的事件发生做出反应;这种控制逆转又称为“好莱坞法则”(不要调用我,让我来调用你)Redis 基于 Reactor 模式开发了自己的网络事件处理器- 文件事件处理器(file event handler,后文简称为 FEH),而该处理器又是单线程的,所以redis设计为单线程模型。

Csdn_xzh的博客 1972

SAP ABAP SM50 的另类用途 - ABAP 工作进程对数据库表读取操作的检测

今天是2020年五一国际劳动节,Jerry祝大家劳动节快乐。 虽然五一国际劳动节来源于一百多年前国外无产阶级的一次大罢工,但由于国情原因,国内很多行业的从业人员,好像天生就是劳碌命。比如程序员行业。 2014年五一劳动节,我在和一个不是总能重现的SAP CRM incident做斗争。详情参考Jerry之前的文章记一次SAP开发工程师给微软Azure报incident的体验. 当时处理完这个复杂...

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 8676

Redis 多线程

在Redis 6.0中,非常受关注的第一个新特性就是多线程。这是因为,Redis一直被大家熟知的就是它的单线程架构,虽然有些命令操作可以用后台线程或子进程执行(比如数据删除、快照生成、AOF重写)。但是,从网络IO处理到实际的读写命令处理,都是由单个线程完成的。 随着网络硬件的性能提升,Redis的性能瓶颈有时会出现在网络IO的处理上,也就是说,单个主线程处理网络请求的速度跟不上底层网络硬件的速度。为了应对这个问题,一般有两种方法。 第一种方法是,用用户态网络协议栈(例如DPDK)取代内核网络协议栈,让网络

凝神遐想的博客 5938

RH850 GreenHillSoftware Install

IDE一次链接到一个Compiler/Green Hills Debug Probe安装目录。如果您安装了IDE、编译器和绿山调试探测器软件,安装程序会将安装链接在一起。如果您只使用Advanced Install选项安装IDE,那么当您第一次启动它时,IDE会提示您链接到编译器和绿山调试探针安装*。如果您使用Advanced Install选项只安装编译器和绿山调试探针软件,安装程序会提示您将IDE的安装链接到新的编译器和绿山调试探针安装。

舊梦的博客 1214

【AI大模型:认知升级】1、全面解析AI大模型:从起源到发展脉络与应用价值

AI大模型是具备超大规模参数(千亿至万亿级)、海量训练数据(TB级)和强迁移学习能力的基础模型。其技术特征包括Transformer架构革新、大数据预训练范式及参数规模超过临界值后的能力涌现。发展历程经历了语言模型突破(2018-2020)、多模态融合(2021-2023)和架构创新(2023至今)三波浪潮,遵循数据、算力、算法协同进化规律。底层驱动因素包括能力涌现机制、算力基础设施突破和应用场景拓展,正在重构产业价值链。通过"知识星系""认知

2025博客之星Top81。专注AI工程化与架构实战。从分布式思维到模型部署,用工程化视角为你厘清AI落地的真实路径。 2292

Redis 多线程模型详解

在 Redis 的早期版本中,Redis 采用了典型的单线程模型,即所有的客户端请求都是由 Redis 的主线程依次处理的。具体来说,Redis 使用单线程的事件循环模型来处理客户端的请求和响应,使用了操作系统的selectpoll或epoll来管理多个客户端连接。为什么 Redis 选择单线程?简单性:单线程模型不需要考虑线程间数据竞争问题,避免了锁机制带来的复杂性和潜在的性能开销。避免上下文切换:多线程环境下,线程的上下文切换会引入额外的 CPU 负担,而单线程架构没有这个问题。性能足够。

lssffy的博客 2027

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

多线程redis解决线程安全问题?你知道这些吗?

​Memcached 执行主逻辑也是在 worker 线程里,模型更加简单,实现了真正的线程隔离,符合我们对线程隔离的常规理解。​ 使用了单线程后,可维护性高。多线程模型虽然在某些方面表现优异,但是它却引入了程序执行顺序的不确定性,带来了并发读写的一系列问题,增加了系统复杂度、同时可能存在线程切换、甚至加锁解锁、死锁造成的性能损耗。但如果严格来讲从 Redis 4 之后并不是单线程,除了主线程外,它也有后台线程在处理一些较为缓慢的操作,例如清理脏数据、无用连接的释放、大 key 的删除等等。

蓝鲸鱼计算机软件开发工作室 1438

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

Redis学习:SpringBoot集成Redis、Redis单线程 VS 多线程、BigKey问题

Redis学习:SpringBoot集成Redis、Redis单线程 VS 多线程、BigKey问题

LiuYQi的博客 1038

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

【Redis进阶】Redis单线程模型和多线程模型

文件事件处理器是单线程模式运行的,但是通过IO多路复用机制监听多个socket,并根据socket目前执行的任务来为套接字关联不同的事件处理器。可以实现高性能的网络通信模型。又可以跟内部其他单线程的模块进行对接,保证了Redis内部的线程模型的简单性。

2401_83045332的博客 2302

Redis(十三):Redis多线程

1. Redis 3.0前多线程 2. Redis 4.0多线程 3. Redis 6.0多线程 3.1 线程池初始化 3.2 读取请求 3.3 写回响应 3.4 I/O线程主逻辑 3.5 性能提升 如果从Redis的核心网络模型来看,从 Redis 的 v1.0 到 v6.0 版本之前,Redis 的核心网络模型一直是一个典型的单 Reactor 模型:利用 epoll/select/kqueue 等多路复用技术,在单线程的事件循环中不断去处...

蓬莱道人的博客 6778

Redis多线程模型探究

代多核心CPU架构是指一个处理器内集成了多个处理核心(CPU Core),每个核心可以独立执行程序指令。这些核心可以并行处理多个任务(或线程),相比于单核心CPU,它们能够更有效地提高计算能力和处理速度,特别是对于并行化设计良好的软件来说。并行处理热效率资源共享与独立可扩展性随着计算环境的不断演进,Redis的多线程模型在未来版本中可能会经历更多的优化和发展。

码农小郑有话说的博客 1236

【Redis】高级篇: 一篇文章讲清楚Redis的单线程和多线程

一种同步的IO模型,实现一个线程监视多个文件句柄,一旦某个文件句柄就绪,就能通知到对应程序进行相应的读写操作,没有文件句柄就绪时,就会阻塞应用程序,从而释放CPU资源。I/O网络I/O,尤其在操作系统层面指数据在内核态和用户态之间的读写操作多路多个客户端连接(连接就是套接字描述符,即socket或者channel)复用复用一个或者几个线程连接IO多路复用也就是说一个或者一组线程处理多个TCP,使用单进程就能实现同时处理多个客户端的连接,无需创建或者维护过多的进程/线程总结。

aqin1012的博客 4639

和 杠精 聊Redis多线程 :(

不羡鸳鸯不羡仙,一行代码调半天。原创:小姐姐味道(微信公众号ID:xjjdog),欢迎分享,转载请保留出处。周末被一位小同学憋的很窝火。他要和我探讨一下,redis到底是多线程的还是单线...

小姐姐味道 2929

Redis 6.0多线程模型总结

前言:Redis 6.0.1 于 2020 年 5 月 2 日正式发布了,如 Redis 作者 antirez 所说,这是迄今为止最“企业”化的版本,也是有史以来改动最大的一个 Redis 版本。这个版本提供了诸多令人心动的新特性及功能改进,比如新网络协议RESP3,新的集群代理,ACL等,其中关注度比较高的应该是多线程模型了。 1、Redis6.0之前的版本真的是单线程吗? Redis在处理客户端的请求时,包括获取 (socket 读)、解析、执行、内容返回 (socket 写) 等都由一个顺序串行的

何哥的博客 7121
上一篇: 高并发内存池如何实现
下一篇: redis项目之命令解析器
Fcw0551
博客等级 码龄2年 330粉丝 115原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值