


1、保留小数点后n位
cpp8:cout << fixed << setprecision(1) << cost << endl;
只要出现了fixed,则后面都是以fixed输出。
cout<<fixed<<x<<endl;
cout<<y<<endl;//之后不用再打一遍fixed了
特点:无科学记数法即使用fixed时,输出小数点后的位数是6位。
这样输出的方法叫做定点表示法表示浮点数!
fixed与setprecision(n)连用可以控制小数点后的位数,现在就可以理解因为那是定点数记数法。
如果没有fixed的话,就是浮点数记数法了,那么它控制的应该就是有效数字的位数(包括小数点前的)
2、按照区间分类时从高到低写if语句
问题:BMI=体重/身高2(kg/m2)。小于 18.5 属于"偏瘦",大于等于 18.5 小于 20.9 属于"苗条",大于等于 20.9 小于等于 24.9 属于"适中",超过 24.9 属于"偏胖"。
    if(BMI>=24.9)
    {
        cout<<"偏胖"<<endl;
    }
    else if (BMI>=20.9) {
    cout<<"适中"<<endl;
    }
        else if (BMI>=18.5) {
    cout<<"苗条"<<endl;
    }
        else if (BMI>0) {
    cout<<"偏瘦"<<endl;
    }
注意:如果区间有上限则不能像上述代码编写。,需要将每个区间写出来
比如:
90-100 优秀
80-89 良
70-79 中
60-69 及格
0-59 差
如果区间不连续可以使用'' || ''或运算符或者使用case语句进行编写
比如:3 - 5 月为春季、6 - 8 月为夏季、9 - 11 月为秋季、12,1,2 月为冬季
3、while循环与for循环的转换
作用:满足循环条件,执行循环语句
语法: while(循环条件){ 循环语句 }
解释:只要循环条件的结果为真,就执行循环语句
    while(n)
    {
        if(n%2==0)
        {
            sum+=n;
        }
        n--;
    }
注意:在while循环语句里一般都要控制循环条件++或者-- 因为不能陷入死循环!
do{ 循环语句 } while(循环条件); 与 while 的区别在于do...while 会先执行一次循环语句,再判断 循环条件。
语法: for(起始表达式;条件表达式;末尾循环体) { 循环语句; }
    for(int i=1;i<=n;i++)
    {
        if(i%2==0)
        {
            sum+=i;
        }
    }
在for循环中,条件表达式比较重要,因为这是跳出循环的依据
补充1:阶乘一般需要用到*=运算符
补充2:a++;++a;a--;--a
前置递增先对变量进行++,再计算表达式
后置递增先计算表达式,后对变量进行++
补充3:如何提取三位数的个十百位
a=i%10;
b=i%100/10;
c=i/100;
补充4:外层循环执行 1 次,内层循环执行 1 轮
补充5:很大的数特别是乘积的和或者阶乘的结果要用long long长长整型
补充6:除与取模的用途
/ 除 10 / 5 = 2
% 取模(取余) 10 % 3 = 1
除一般用于得到高位的数 比如:int 188/100=1 188%100=88 88/10=8
取余一般用于这个数是否能被另一个数整除 如果可以则为0 不可以则为其他数
4、数组的基本操作
一维数组定义方式: 数据类型 数组名[ 数组长度 ]; int arr[6];
"整个数组所占内存空间为: " << sizeof(arr)
"每个元素所占内存空间为: " << sizeof(arr[0])
"数组的元素个数为: " << sizeof(arr) / sizeof(arr[0])
补充1:找数组中的最值:求解思路 先定义最值 遍历整个数组 若遍历到的数比最值大或者小 则将最值赋予此值
    int max=arr[0],min=arr[0];//将最值赋给任意一值
    for(int i=1;i<len;i++)//遍历数组
    {
        if(arr[i]>max)
        {
            max=arr[i];
        }
        if(arr[i]<min)
        {
            min=arr[i];
        }
    }
补充2:数组元素反转
定义一个临时变量,第一个和最后一个成对的进行交换,交换次数为len/2
    int temp=0;//定义一个临时变量
    for(int i=0;i<len/2;i++){//成对进行交换 所以只需要len/2
        temp=arr[i];
        arr[i]=arr[len-1-i];
        arr[len-1-i]=temp;
    }
补充3:冒泡排序 是对数组内元素进行排序
1. 比较相邻的元素。如果第一个比第二个大,就交换他们两个。
2. 对每一对相邻元素做同样的工作,执行完毕后,找到第一个最大值。
3. 重复以上的步骤,每次比较次数-1,直到不需要比较
    for(int i=0;i<len-1;i++) {//冒泡排序需要做len-1次
        for (int j=0; j<len-1-i; j++) {//每次需要交换len-1-i次
        if(arr[j]>arr[j+1]) {
            int temp=arr[j];
            arr[j]=arr[j+1];
            arr[j+1]=temp;
        }
        }
    }
补充4:选择排序即选定一位最值,将其他的与之比较
    for(int i=0;i<len-1;i++)//进行len-1次选择
    {
        int min=i;//选定一位为最小值
        for(int j=i+1;j<len;j++)//选定一位后 将其后面的数分别再比较
        {
            if(arr[j]<arr[min])//若有比选定的数更小的数 则重新赋值给最小值
            {
                min=j;
            }
        }
        swap(arr[i],arr[min]);//比较之后进行交换
    }
补充5:二维数组
定义方式为 数据类型 数组名[ 行数 ][ 列数 ] = { {数据 1,数据 2 } ,{数据 3,数据 4 } };
遍历二维数组的方式是嵌套循环:
    for(int i = 0; i < 行数; i++) {
        for(int j = 0; j < 列数; j++) {
            sum += arr[i][j];//求数组总和
        }
    }
补充6:指针和数组: 利用指针访问数组中元素
int * p = arr; //指向数组的指针
for (int i = 0; i < 10; i++)
{ //利用指针遍历数组
cout << *p << endl;
p++;
}
5、字符串的基本语法
输入字符串的方法:
1、cin >> str
虽然可以使用 cin 和 >>运算符来输入字符串,当 cin 读取数据时,一旦它接触到第一个非空格字符即开始阅读,当它读取到下一个空白字符(空格、制表符、换行符)时,它将停止读取,并自动在结尾添加空字符。
故 cin 不能输入包含嵌入空格的字符串。
2、面向行的输入:getline(cin,temp) 第二个参数为string类型的变量。还有get()函数
为了解决cin的问题,可以使用一个叫做 getline 的 C++ 函数。此函数可读取整行,包括前导和嵌入的空格,并将其存储在字符串对象中。
cin.getline(1,2) 参数1是用来储存输入行数组的名称,参数2是要读取的字符数。如果参数为20,函数最多读取19个字符,余下的空间用来存储自动在结尾处添加的空字符。
getline()将丢弃换行符,而get()将换行符保留在输入序列里。
补充1:字符串拼接可以直接使用+号进行拼接:string s=s1+s2;
6、结构体简单使用
结构体定义:struct 结构体名 { 结构体成员列表 };
结构体变量利用操作符 ''.'' 访问成员
结构体数组:struct 结构体名 数组名[元素个数] = { {} , {} , ... {} }
结构体指针:利用操作符 `-> `可以通过结构体指针访问结构体属性
struct student * p = &stu;
p->score = 80; //指针通过 -> 操作符可以访问成员
结构体作为参数向函数进行地址传递也就是 使用指针访问结构体成员
7、new和delete运算符
在 C++中主要利用 new 在堆区开辟内存,堆区开辟的数据,由程序员手动开辟,手动释放,释放利用操作符delete
int* a = new int(10);
delete p;//利用 delete 释放堆区数据
int *p=new int[n];//在堆区开辟数组 p为数组名
delete[] arr;//释放数组 delete 后加 []
8、函数的使用
函数的定义:
返回值类型 函数名 (参数列表)
{
函数体语句
return 表达式
}
函数定义里小括号内称为形参,函数调用时传入的参数称为实参。
函数的声明:告诉编译器函数名称及如何调用函数。函数的实际主体可以单独定义。声明可以多次,但是函数的定义只能有一次
补充1:值传递:是函数调用时实参将数值传入给形参,值传递时,如果形参发生,并不会影响实参,值传递时,形参是修饰不了实参
void mySwap01(int a, int b) {
int temp = a;
a = b;
b = temp;
}
补充2:地址传递会改变实参 调用方式:mySwap02(&a, &b);
void mySwap02(int* a, int* b) {
int temp = *a;
*a = *b;
*b = temp;
}
补充3:引用传递会改变实参,让形参修饰实参,引用可以简化指针修改实参
通过引用参数产生的效果同按地址传递是一样的。引用的语法更清楚简单
void mySwap03(int& a, int& b) {
int temp = a;
a = b;
b = temp;
}指针、数组、函数:当数组名传入到函数作为参数时,被退化为指向首元素的指针
void func(int* p, int n) //指针指向一个数组 n表示数组的长度
{
    for(int i=0;i<n;i++)//循环遍历数组
    {
        if(p[i]==0)//检查数组中索引为 i 的元素是否为零
        {
            for(int j=i;j<n-1;j++)//将0后面的元素移到0的前面 这个循环只定义了0前面的那个元素
            {
                p[j]=p[j+1];//将0元素右移一位
                //此时并没有更改最后一位
            }
           p[n-1]=0;//将数组中最后一个元素设置为零
            n--;//更新长度
        }
    }
}
函数的分文件编写:一般有 4 个步骤
1. 创建后缀名为.h 的头文件
2. 创建后缀名为.cpp 的源文件
3. 在头文件中写函数的声明
4. 在源文件中写函数的定义
补充4:字符串的大小可以通过ACSLL码来比较,如果字符串的长度不同,可以通过判断字符串是否遍历结束即指针指向空字符'\0'
int mystrcmp(const char* src, const char* dst) {

    // 先判断两个字符串的长度
    while(*src&&*dst)
    {
        //两个字符串长度相同 字符不同时的比较
        if(*src-*dst>0)
        {
            return 1;
        }
        else if(*src-*dst<0)
        {
            return -1;
        }
        src++;
        dst++;
    }
    //判断两个字符串是否遍历结束
    if(*src=='\0'&&*dst!='\0')
    {
        return -1;
    }
    else if(*src=='\0'&&*dst=='\0')
    {
        return 0;
    }
    else
    {
        return 1;
    }
补充5:函数strncmp()、strlen()、strcpy()
函数原型:int strncmp(const char* str1, const char* str2, size_t num)
头 文 件:#include <string.h>
返 回 值:(与strncmp相同)str1 = str2 则返回0,比较字符串str1和str2的前num个字符。
str1 > str2 则返回大于0的值,
str1 < str2 则返回小于0的值
strncmp可用于比较两个字符串常量或比较数组和字符串常量,不能比较数字等其他形式的参数。
strlen()函数:
1.strlen函数的函数原型:size_t strlen(const char*str) 该函数包含在string.h的头文件中。
2.该函数用于求参数str指向字符串的长度。
3.注意:字符串中’\0’作为结束标志,strlen函数返回的是在字符串中’\0’前面的字符个数(不包含’\0’),当字符串的下一位不是’\0’时,无法用strlen函数求长度,求出的为随机值。
    for (int i = 0; i < strlen(str) - strlen(substr) + 1; i++)
    //strlen(str)为源字符串长度 strlen(substr)为比较字符串长度
    {
        if (strncmp(str + i, substr, strlen(substr)) == 0)
            count++;
}strcpy()函数:strcpy即string copy缩写,strcpy函数实现将源指针指向的空间里面的数据拷贝到目的地指针指向的空间,包括终止空字符('\0'),并在该点停止,char* strcpy(char* destination,char* source);源字符串必须以'\0'结束且源字符串的'\0'也会被拷贝到目标空间
注意:对于字符型数组来说,结尾字符为'\0',占一个空间。
  public:
    char* name; // 姓名
    int age;    // 年龄

    Person(const char* name, int age) {
        //int n=strlen(name);
        this->name = new char[strlen(name)+1];
        //字符串结尾符占一个数组元素位置
        //strlen函数:计算的是字符串str的长度,计算的长度并不包含'\0'
        //对于字符型数组来说,结尾字符为'\0',占一个空间。
        strcpy(this->name, name);//将源指针指向的空间里面的数据拷贝到目的地指针指向的空间
        this->age = age;
    }

    //如果不利用深拷贝在堆区创建新内存,会导致浅拷贝带来的重复释放堆区问题
    Person(const Person& p) {
        this->name = new char[strlen(p.name)+1];
        strcpy(this->name, p.name);//char* strcpy(char* destination,char* source)
        //this->name=p.name;
        this->age = p.age;
    }
补充6:字符函数:判断字母字符、数字字符、空白、标点符号的函数
1、isalpha()函数用来判断一个字符是否为字母,如果是字母则返回非零,否则返回零。
2、isdigit()函数用来判断一个字符是否为数字,如果是字母则返回非零,否则返回零。
3、isspace()函数用来判断一个字符是否为空格,如果是字母则返回非零,否则返回零。
4、isalnum()函数用来判断一个字符是否为数字或字母,是则输出非零,否则输出零。
5、islower()函数用来判断一个字符是否为小写字母。
6、ispuuer()函数用来判断一个字符是否为大写字母。
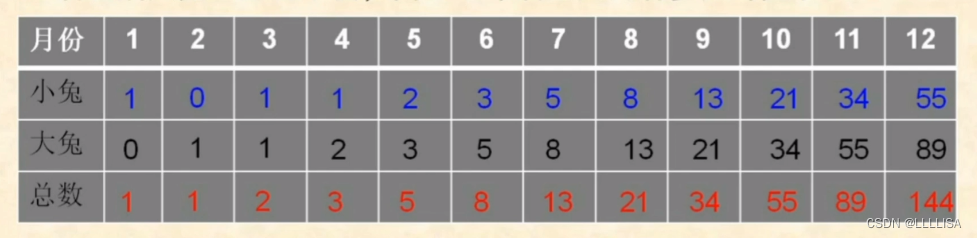
补充7:函数递归和迭代
long long factorial(int n) {

    //递归实现
    if(n==1){
        return 1;
    }
    return factorial(n-1)*n;
    //f(5)=f(4)*5
    //f(4)=f(3)*4
    //f(3)=f(2)*3
    //f(2)=f(1)*2
    //f(1)=1    //1*2*3*4*5
    //f(n-1)*n
}

    //实际上是斐波那契数列问题:f(n)=f(n−1)+f(n−2)
    //递归法
    if(n<3){
        return 1;
    }
    else{
        return getSum(n-1)+getSum(n-2);
    }

    //迭代法
    //除了自上而下的递归,我们还可以利用像上述数组一样的自下而上的相加
    //除了第一二月外,这个月的值等于它前两个月的值相加,我们可以从第三个月开始不断累加,并更新前两个月的值即可

    if(n<3) {
        return 1;
    }
    else{
        int a=1,b=1;//a表示当前要计算的月份n-2一个月 b表示当前要计算的月份n-1个月
        int sum=0;
        for(int i=3;i<=n;i++){
            sum=a+b;//前两个月的值相加
            b=a;//上月的总和
            a=sum;//这月的总和
        }
        return sum;
    }
补充8:引用的基本使用
1、给变量起别名:数据类型 &别名 = 原名 int &b = a;
2、引用必须初始化,引用在初始化后,不可以改变
3、函数传参时,可以利用引用的技术让形参修饰实参
4、引用的本质在 c++内部实现是一个指针常量,指针常量是指针指向不可改,也说明为什么引用不可 更改
9、类和对象——封装
C++面向对象的三大特性为:==封装、继承、多态==对象上有其属性和行为
封装的意义: 将属性和行为作为一个整体,表现生活中的事物,将属性和行为加以权限控制
1、在设计类的时候,属性和行为写在一起,表现事物
语法:class 类名{ 访问权限: 属性 / 行为 };
2、类在设计时,可以把属性和行为放在不同的权限下,加以控制
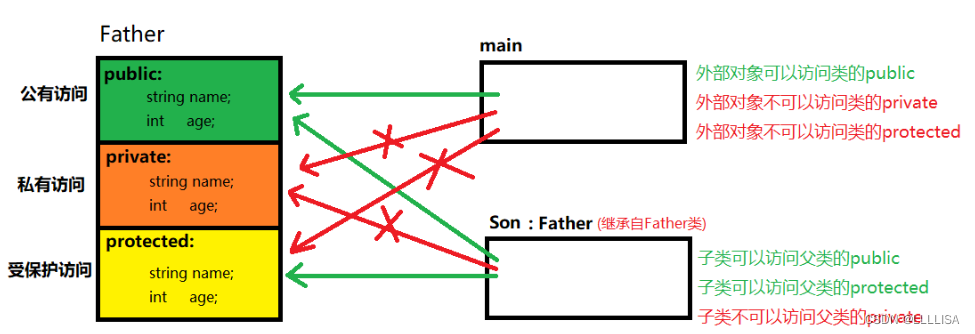
访问权限有三种:
1. public 公共权限 类内类外都可以访问
2. protected 保护权限 只有类内可以访问 当公共继承时,子类可以访问protected权限 但在外部 不能通过子类对象访问protected成员
Son类的成员函数中,可以直接访问它的父类的protected成员,
3. private 私有权限 只有类内可以访问 但可以使用友元让一个函数或者类 访问另一个类中私有成员
补充1:构造函数和析构函数
这两个函数将会被编译器自动调用, 完成对象初始化和清理工作。对象的初始化和清理工作是编译器强制要我们做的事情,因此如果我们不提供构造和析构, 编译器会提供。编译器提供的构造函数和析构函数是空实现。
构造函数语法:类名(){} 析构函数语法:~类名(){}
1. 构造、析构函数,没有返回值也不写 void
2. 构造函数名称与类名相同,析构在名称前加上符号 ~
3. 构造函数可以有参数,因此可以发生重载 析构函数不可以有参数,因此不可以发生重载
4. 程序在调用对象时候会自动调用构造,无须手动调用,而且只会调用一次
5、程序在对象销毁前会自动调用析构--一般用于将堆区开辟的数据做释放操作
class Person {
public:
//无参(默认)构造函数
Person() {
cout << "无参构造函数!" << endl;
}
//有参构造函数
Person(int a) {
age = a;
cout << "有参构造函数!" << endl;
}
//拷贝构造函数
Person(const Person& p) {
age = p.age;
cout << "拷贝构造函数!" << endl;
}
//析构函数
~Person() {
cout << "析构函数!" << endl;
}
public:
int age;
};
关于构造函数的调用:1、调用无参构造函数不能加括号,如果加了编译器认为这是一个函数声明
2、不能利用 拷贝构造函数 初始化匿名对象 编译器认为是对象声明
拷贝构造函数的调用
C++中拷贝构造函数调用时机通常有三种情况
* 使用一个已经创建完毕的对象来初始化一个新对象 Person newman(man); //调用拷贝构造函数
* 值传递的方式给函数参数传值
//相当于 Person p1 = p;
void doWork(Person p1) {}
void test02() {
Person p; //无参构造函数
doWork(p);
}
* 以值方式返回局部对象
Person doWork2()
{
Person p1;
cout << (int *)&p1 << endl;
return p1;
}
void test03()
{
Person p = doWork2();
cout << (int *)&p << endl;
}
如果用户定义拷贝构造函数,c++不会再提供其他构造函数
如果不写拷贝构造,编译器会自动添加拷贝构造,并且做浅拷贝操作
补充2:深拷贝与浅拷贝
浅拷贝:简单的赋值拷贝操作 编译器提供的默认拷贝构造函数
深拷贝:在堆区重新申请空间,进行拷贝操作
Person(const Person& p) {
cout << "拷贝构造函数!" << endl;
//如果不利用深拷贝在堆区创建新内存,会导致浅拷贝带来的重复释放堆区问题
m_age = p.m_age;
m_height = new int(*p.m_height);
}
//析构函数
~Person() {
cout << "析构函数!" << endl;
if (m_height != NULL)
{
delete m_height;
}
}
如果属性有在堆区开辟的,一定要自己提供拷贝构造函数,防止浅拷贝带来的问题-----重复释放堆区问题

构造和析构函数的调用是先进后出,顺序为P1的构造-P2的构造-P2的析构-P1的析构
故在编译器默认的浅拷贝中,先调用P2的析构,释放在堆区开辟的数据,最后调用P1的析构也会释放在堆区的数据,故重复释放堆区数据即进行非法操作!
深拷贝解决浅拷贝的问题

//拷贝构造函数
Person(const Person& p) {
cout << "拷贝构造函数!" << endl;
m_age = p.m_age;
//m_height = p.m_height; //浅拷贝——编译器默认实现的拷贝构造是这行代码
m_height = new int(*p.m_height);//*解引用
}
总结:一般是类的属性 定义为一个指针比如 int *height 会在堆区开辟内存,若需要调用拷贝构造,需要自己写拷贝构造,避免浅拷贝
友元的目的就是让一个函数或者类 访问另一个类中私有成员
友元的关键字为 ==friend==
友元的三种实现
* 全局函数做友元
class Person {

    friend void showAge(Person& p);

    public:
        Person(int age) {
            this->age = age;
        }

    private:
        int age;
};


void showAge(Person& p) {
    cout << p.age << endl;
}
* 类做友元
class Building;
class goodGay
{
public:
goodGay();
void visit();
private:
Building *building;//building指针维护开辟在堆区的Building对象
};
class Building
{
//告诉编译器 goodGay 类是 Building 类的好朋友,可以访问到 Building 类中私有内容
friend class goodGay;
public:
Building();
public:
string m_SittingRoom; //客厅
private:
string m_BedRoom;//卧室
};
//类外实现
Building::Building()
{
this->m_SittingRoom = "客厅";
this->m_BedRoom = "卧室";
}
goodGay::goodGay()
{
building = new Building;//building指针在堆区创建建筑物对象
}
void goodGay::visit()
{
cout << "好基友正在访问" << building->m_SittingRoom << endl;
cout << "好基友正在访问" << building->m_BedRoom << endl;//访问Building类内的私有属性
}
void test01()
{
goodGay gg;
gg.visit();
}
* 成员函数做友元
class Building;
class goodGay
{
public:
goodGay();
void visit(); //只让 visit 函数作为 Building 的好朋友,可以发访问 Building 中私有内容
void visit2();
private:
Building *building;
};
class Building
{
//告诉编译器 goodGay 类中的 visit 成员函数 是 Building 好朋友,可以访问私有内容
friend void goodGay::visit();
public:
Building();
public:
string m_SittingRoom; //客厅
private:
string m_BedRoom;//卧室
};
Building::Building()
{
this->m_SittingRoom = "客厅";
this->m_BedRoom = "卧室";
}
goodGay::goodGay()
{
building = new Building;
}
void goodGay::visit()
{
cout << "好基友正在访问" << building->m_SittingRoom << endl;
cout << "好基友正在访问" << building->m_BedRoom << endl;
}
void goodGay::visit2()
{
cout << "好基友正在访问" << building->m_SittingRoom << endl;
//cout << "好基友正在访问" << building->m_BedRoom << endl;
}
void test01()
{
goodGay gg;
gg.visit();
}
运算符重载
补充1:加号运算符重载:实现两个自定义数据类型相加的运算
        // 成员函数实现+号运算符重载
        Time operator+(const Time&t)
        {
            //this 指针指向被调用的成员函数所属的对象
            Time temp;
            //分钟超过60要进位给小时
            //此时的this指的是t1 传进的t为t2
            temp.hours=this->hours+t.hours+(this->minutes+t.minutes)/60;
            temp.minutes=(this->minutes+t.minutes)%60;
            return temp;
        }
        int h, m;
        cin >> h;
        cin >> m;

        Time t1(h, m);
        Time t2(2, 20);
        //调用加号运算符重载
        Time t3 = t1 + t2;//相当于 t1.operaor+(t2)
补充2:左移运算符重载:可以输出自定义数据类型
重载左移运算符配合友元可以实现输出自定义数据类型
//全局函数实现左移重载
//ostream 对象只能有一个
ostream& operator<<(ostream& out, Person& p) {
out << "a:" << p.m_A << " b:" << p.m_B;
return out;
}
void test() {
Person p1(10, 20);
cout << p1 << "hello world" << endl; //链式编程
}
补充3:递增运算符重载: 通过重载递增运算符,实现自己的整型数据
递增运算符重载需要配合左移运算符重载 为了输出
//前置++
MyInteger& operator++() {
//先++
m_Num++;
//再返回
return *this;
}
//后置++
MyInteger operator++(int) {
//先返回
MyInteger temp = *this; //记录当前本身的值,然后让本身的值加 1,但是返回的是
以前的值,达到先返回后++;
m_Num++;
return temp;
}
前置递增返回引用,后置递增返回值
补充4:赋值运算符 operator=, 对属性进行值拷贝
如果类中有属性指向堆区,做赋值操作时也会出现深浅拷贝问题
//重载赋值运算符
Person& operator=(Person &p)
{
if (m_Age != NULL)
{
delete m_Age;
m_Age = NULL;
}
//编译器提供的代码是浅拷贝
//m_Age = p.m_Age;
//提供深拷贝 解决浅拷贝的问题
m_Age = new int(*p.m_Age);
//返回自身
return *this;
}


p3 = p2 = p1; //赋值操作
补充5:关系运算符重载:重载关系运算符,可以让两个自定义类型对象进行对比操作
bool operator==(Person & p)
{
if (this->m_Name == p.m_Name && this->m_Age == p.m_Age)
{
return true;
}
else
{
return false;
}
}
bool operator!=(Person & p)
{
if (this->m_Name == p.m_Name && this->m_Age == p.m_Age)
{
return false;
}
else
{
return true;
}
}


//调用

if (a == b)
{
cout << "a 和 b 相等" << endl;
}
else
{
cout << "a 和 b 不相等" << endl;
}
if (a != b)
{
cout << "a 和 b 不相等" << endl;
}
else
{
cout << "a 和 b 相等" << endl;
}
补充6:函数调用运算符()重载:由于重载后使用的方式非常像函数的调用,因此称为仿函数
class MyPrint
{
public:
void operator()(string text)
{
cout << text << endl;
}
};
void test01()
{
//重载的()操作符 也称为仿函数
MyPrint myFunc;
myFunc("hello world");
}
10、类和对象——继承
定义这些类时,下级别的成员除了拥有上一级的共性,还有自己的特性。就可以考虑利用继承的技术,减少重复代码
class A : public B; 继承的语法:`class 子类 : 继承方式 父类`
A 类称为子类 或 派生类 B 类称为父类 或 基类
**派生类中的成员,包含两大部分**:
一类是从基类继承过来的,一类是自己增加的成员。
从基类继承过过来的表现其共性,而新增的成员体现了其个性。
公共继承时,可访问 protected 权限。
继承中 先调用父类构造函数,再调用子类构造函数,析构顺序与构造相反。
当子类与父类拥有同名的成员函数,子类会隐藏父类中所有版本的同名成员函数
如果想访问父类中被隐藏的同名成员函数,需要加父类的作用域
补充1: 子类中调用父类构造
class Sub : public Base {

  private:
    int z;

  public://子类调用父类的构造函数我们直接将: Base(x, y)加在子类构造函数参数后面即可
    Sub(int x, int y, int z): Base( x, y)  {
        //调用基类 Base 的构造函数 Base(x, y)
        // :后面的部分将 x 和 y 传递给父类的构造函数进行初始化。
        this->z = z;//通过子类构造函数的形参直接给z赋值,来初始化z的值。
        //this->x=x;this->y=y;//父类Base的变量都是private类型,不允许外界访问
    }

    int getZ() {
        return z;
    }

    int calculate() {
        return Base::getX() * Base::getY() * this->getZ();
    }

};
补充2: 重写子类计算逻辑
class Sub : public Base {
public://不要忘记公共权限
        Sub(int x,int y):Base(x,y){}//调用基类的构造函数初始化x,y

        void calculate() {
        if(Base::getY()){//分母为0时输出error
            cout<<Base::getX()/Base::getY()<<endl;
        }
        else {
            cout<<"Error"<<endl;
        }
    }
};
11、类和对象——多态
多态分为两类 * 静态多态: 函数重载 和 运算符重载属于静态多态,复用函数名 * 动态多态: 派生类和虚函数实现运行时多态
静态多态和动态多态区别: * 静态多态的函数地址早绑定 - 编译阶段确定函数地址 * 动态多态的函数地址晚绑定 - 运行阶段确定函数地址
我们希望传入什么对象,那么就调用什么对象的函数 //如果函数地址在编译阶段就能确定,那么静态联编
如果函数地址在运行阶段才能确定,就是动态联编
多态满足条件:
1、有继承关系
2、子类重写父类中的虚函数
多态使用:
父类指针或引用指向子类对象:BaseCalculator* cal = new AddCalculator;//创建子类对象
class BaseCalculator {
    public:
        int m_A;
        int m_B;
        //函数前面加上 virtual 关键字,变成虚函数,那么编译器在编译的时候就不能确定函数调用了
        virtual int getResult()=0;//纯虚函数
};

// 加法计算器类
class AddCalculator : public BaseCalculator {
    // write your code here......
    int getResult()//子类里的virtual可要可不要
    {
        return m_A+m_B;
    }
};
int main() {
    //父类指针或引用指向子类对象
    BaseCalculator* cal = new AddCalculator;//创建子类对象
    cal->m_A = 10;
    cal->m_B = 20;
    cout << cal->getResult() << endl;
    delete cal;//用完后记得销毁
    return 0;
}
12、STL初识
STL(Standard Template Library,标准模板库)
STL 从广义上分为: 容器(container) 算法(algorithm) 迭代器(iterator)
容器和算法之间通过迭代器进行无缝连接。
STL 几乎所有的代码都采用了模板类或者模板函数
STL六大组件:
1. 容器:各种数据结构,如vector、list、deque、set、map等,用来存放数据。
2. 算法:各种常用的算法,如sort、find、copy、for_each等
3. 迭代器:扮演了容器与算法之间的胶合剂。
4. 仿函数:行为类似函数,可作为算法的某种策略。
5. 适配器:一种用来修饰容器或者仿函数或迭代器接口的东西。
6. 空间配置器:负责空间的配置与管理。
| 函数/容器 | string | vector | deque | stack | Queue | list | set/multiset | map/multimap |
| 赋值=和.assign() | 1 | 1 | 1 | = | = | 1 | = | = |
| 拼接重载+= .append(); | 1 | 先进后出一个出口 | 先进先出两个出口 | 数据域与指针域 | ||||
| find查找 | 返回-1 | 返回set.end() | 返回map.end() | |||||
| replace替换 | 1 | |||||||
| compare()比较 | 1 | |||||||
| 存取str[i]、str.at(i) | 1 | 1 | 1 | |||||
| insert()插入、erase()删除 | 1 | 1 | 1 | 1 | 1 | 1 | ||
| empty() 是否为空 | 1 | 1 | 1 | 1 | 1 | 1 | 1 | |
| capacity()容器容量 | 1 | |||||||
| size()元素个数 | 1 | 1 | 1 | 1 | 1 | 1 | 1 | |
| resize()重新指定大小 | 1 | 1 | 1 | |||||
| push_back()尾部插入元素 | 1 | 1 | push()栈顶加元素 | push()队尾加元素 | 1 | |||
| pop_back()删除最后元素 | 1 | 1 | pop()栈顶移首元素 | pop()队头移首元素 | 1 | |||
| clear();删除所有元素 | 1 | 1 | 1 | 1 | 1 | |||
| front()第一个back()最后一个 | 1 | 1 | 1 | 1 | ||||
| swap()互换 | L1.swap(L2); | 1 | 1 | |||||
| reserve()容器预留 | ||||||||
| push_front()头部插入 | 1 | top()返回栈顶元素 | 1 | |||||
| pop_front()删除第一个 | 1 | 1 | ||||||
| sort(beg, end) 排序 | 1 | 1 | L.sort()默认升序 | 自动排序 | 自动排序 | |||
| remove(e)删除e值匹配 | 1 | |||||||
| reverse()反转链表 | 1 | 1 | ||||||
| count(k)统计k元素个数 | 1 | 1 |
容器的类型:
1、序列容器(支持随机访问迭代器)提供了最自由的操作,以及输入输出操作。 提供++、--、+、-、+=、-=、[]等操作。
vector——动态数组,长度可以动态自动增长的顺序序列。优势:支持快速访问元素、序列尾部的快速插入删除元素。
deque——双端序列,在头尾都可以进行快速操作的序列。优势:支持头尾两端的快速插入删除元素,访问元素比vector稍慢一些,在大数据量的容量动态增减方面比vector有优势。
array——定长数组,提供一种STL方式来创建固定长度数组。可以看成对之前版本中使用[]创建的数组的一种替代方式。
2、容器适配器(不支持迭代器)
stack——栈,先进后出(LIFO,Last In First Out)。
queue——队列,先进先出(FIFO,First In First Out)。
priority_queue——优先序列,内部维护了一个堆数据结构,堆顶为极值
3、有序关联容器(支持双向迭代器)提供了单步向前或向后操作,以及输入输出操作。提供++、--、=、*等操作。
set——有序集合,只包含不重复元素的有序集合。
multiset——有序多重集合,可以包含重复元素的有序集合。
map——有序映射,“键-值”对的有序集合,只包含不重复的键。
multimap——有序多重映射,”键-值“对的有序集合,可以包含重复的键。
优势:内部有序、支持快速查找。
4、链表容器(支持前向或双向迭代器)前向迭代器:提供单向递增操作,以及输入输出操作。提供++、=、*等操作。
forward_list——单向链表,链表中的节点只能向后搜索,支持前向迭代器。
list——双向链表,链表中的节点可以向前和向后搜索,支持双向迭代器。
优势:链表支持在任意位置快速插入删除元素。
常用算法:algorithm头文件是C++的标准算法库
1、max()、min()、abs()--求一个数的绝对值函数
2、交换函数:swap()
3、翻转函数:reverse() 翻转x-y区间的数组、容器的值;若想对容器中所有的数进行翻转,则需要用到begin()、end()函数
4、排序函数:sort()对x-y区间的数组、容器进行排序。默认升序排列。
bool cmp(int a, int b) {
	return a > b;
}

int main() {
	int a[5] = {55,44,33,22,11};

	sort(a,a+5,cmp);			//这里需要加上自己自定义的函数

	return 0;
 }
5、查找函数:find()
6、for_each()遍历函数
void MyPrint(int val)
{
cout << val << endl;
}
for_each(v.begin(), v.end(), MyPrint);
迭代器:
每一个容器都有自己的迭代器,迭代器是用来遍历容器中的元素
v.begin()返回迭代器,这个迭代器指向容器中第一个数据
v.end()返回迭代器,这个迭代器指向容器元素的最后一个元素的下一个位置
用auto定义一个有初始值的变量时,不需要明确指定类型,因为编译器能自动从变量的初始值推断出该变量的数据类型
auto类型:局部变量,关键字“auto”可以被省略。这些变量被表用时分配存储方式,函数调用结束后这些存储空间就被释放
可以用auto 定义的变量来接收迭代器
补充1:string容器
string是一个类,类内部封装了char*,管理这个字符串,是一个char*型的容器。查找find,拷贝copy,删除delete 替换replace,插入insert
1、赋值操作——使用重载后的=和.assign() vector、deque容器也适用
string& assign(const char *s, int n); //把字符串s的前n个字符赋给当前的字符串

string str5;
str5.assign("hello c++",5);

string& assign(int n, char c); //用n个字符c赋给当前字符串

string str7;
str7.assign(5, 'x');
2、string字符串拼接——重载+=操作符;.append();
string str1 = "我";
str1 += "爱玩游戏";

string& append(const string &s, int pos, int n); //字符串s中从pos开始的n个字符连接到字符串结尾
str3.append(str2, 4, 3); // 从下标4位置开始 ,截取3个字符,拼接到字符串末尾
3、string查找和替换
find查找是从左往后,rfind从右往左
find找到字符串后返回查找的第一个字符位置,找不到返回-1
replace在替换时,要指定从哪个位置起,多少个字符,替换成什么样的字符串
string str1 = "abcdefgde";
int pos = str1.find("de");
if (pos == -1)
{
cout << "未找到" << endl;
}
else
{
cout << "pos = " << pos << endl;
}
pos = str1.rfind("de");
string& replace(int pos, int n, const string& str); //从pos开始n个字符替换为字符串str
str1.replace(1, 3, "1111");
4、字符串比较是按字符的ASCII码进行对比 = 返回 0 > 返回 1 < 返回 -1 compare()
字符串对比主要是用于比较两个字符串是否相等,判断谁大谁小的意义并不是很大
5、string字符存取
char& operator[](int n); //通过[]方式取字符 str[i]
char& at(int n); //通过at方法获取字符 str.at(i)
6、string插入和删除 插入和删除的起始下标都是从0开始
string& insert(int pos, int n, char c); //在指定位置插入n个字符c str.insert(1, "111");
string& erase(int pos, int n = npos); //删除从Pos开始的n个字符 str.erase(1, 3); //从1号位置开始3个字符
7、string子串
string substr(int pos = 0, int n = npos) const; //返回由pos开始的n个字符组成的字符串 string subStr = str.substr(1, 3);
补充2:vector容器
vector可以动态扩展:并不是在原空间之后续接新空间,而是找更大的内存空间,然后将原数据拷贝新空间,释放原空间。数据结构和数组非常相似,也称为单端数组

1、vector容量和大小
empty(); //判断容器是否为空 v1.empty()为空则为1 deque容器也适用
capacity(); //容器的容量 v1.capacity() deque没有容量的概念
size(); //返回容器中元素的个数 v1.size() deque容器也适用
resize(int num); //重新指定容器的长度为num,若容器变长,则以默认值填充新位置。 deque容器也适用
//如果容器变短,则末尾超出容器长度的元素被删除。
resize(int num, elem); //重新指定容器的长度为num,若容器变长,则以elem值填充新位置。 deque容器也适用
//如果容器变短,则末尾超出容器长度的元素被删除
//resize 重新指定大小 ,若指定的更大,默认用0填充新位置,可以利用重载版本替换默认填充 v1.resize(15,10);
2、vector插入和删除
push_back(ele); //尾部插入元素ele
pop_back(); //删除最后一个元素
insert(const_iterator pos, ele); //迭代器指向位置pos插入元素ele
erase(const_iterator start, const_iterator end); //删除迭代器从start到end之间的元素
clear(); //删除容器中所有元素
3、vector数据存取
at(int idx); //返回索引idx所指的数据
operator[]; //返回索引idx所指的数据
front(); //返回容器中第一个数据元素
back(); //返回容器中最后一个数据元素
4、vector互换容器
swap(vec); // 将vec与本身的元素互换 v1.swap(v2);
5、vector预留空间——减少vector在动态扩展容量时的扩展次数
reserve(int len); //容器预留len个元素长度,预留位置不初始化,元素不可访问。如果数据量较大,可以一开始利用reserve预留空间
补充3:deque容器
双端数组,可以对头端进行插入删除操作

1、deque 插入
两端插入操作:
push_back(elem); //在容器尾部添加一个数据
push_front(elem); //在容器头部插入一个数据
pop_back(); //删除容器最后一个数据
pop_front(); //删除容器第一个数据
insert(pos,beg,end); //在pos位置插入[beg,end)区间的数据,无返回值。
clear(); //清空容器的所有数据
erase(pos); //删除pos位置的数据,返回下一个数据的位置。
at(int idx); //返回索引idx所指的数据
2、deque 数据存取
operator[]; //返回索引idx所指的数据
front(); //返回容器中第一个数据元素
back(); //返回容器中最后一个数据元素
3、deque 排序
sort(iterator beg, iterator end) //对beg和end区间内元素进行排序
补充3:stack容器
stack是一种先进后出(First In Last Out,FILO)的数据结构,它只有一个出口

栈中只有顶端的元素才可以被外界使用,因此栈不允许有遍历行为
栈中进入数据称为 --- 入栈 push 栈中弹出数据称为 --- 出栈 pop
1、stack 常用接口
赋值操作: stack& operator=(const stack &stk); //重载等号操作符
数据存取:
push(elem); //向栈顶添加元素 //向栈中添加元素,叫做 压栈 入栈 s.push(10);
pop(); //从栈顶移除第一个元素 //弹出栈顶元素 s.pop();
top(); //返回栈顶元素 s.top()
大小操作:
empty(); //判断堆栈是否为空 s.empty()
size(); //返回栈的大小 s.size()
补充4:queue容器
Queue是一种先进先出(First In First Out,FIFO)的数据结构,它有两个出口

队列容器允许从一端新增元素,从另一端移除元素 队列中只有队头和队尾才可以被外界使用,因此队列不允许有遍历行为
队列中进数据称为 --- 入队 push
队列中出数据称为 --- 出队 pop
1、 queue 常用接口
赋值操作: queue& operator=(const queue &que); //重载等号操作符
数据存取:
push(elem); //往队尾添加元素 q.push(p1);
pop(); //从队头移除第一个元素 q.pop()
back(); //返回最后一个元素 q.back()
front(); //返回第一个元素 q.front()
大小操作:
empty(); //判断堆栈是否为空 q.empty()
size(); //返回栈的大小 q.size()
补充5:list容器
功能:将数据进行链式存储
链表(list)是一种物理存储单元上非连续的存储结构,数据元素的逻辑顺序是通过链表中的指针链接实现的
链表的组成:链表由一系列结点组成 结点的组成:一个是存储数据元素的数据域,另一个是存储下一个结点地址的指针域
STL中的链表是一个双向循环链表

由于链表的存储方式并不是连续的内存空间,因此链表list中的迭代器只支持前移和后移,属于双向迭代器
List有一个重要的性质,插入操作和删除操作都不会造成原有list迭代器的失效,这在vector是不成立的。
1、list 赋值和交换
assign(beg, end); //将[beg, end)区间中的数据拷贝赋值给本身。 L3.assign(L2.begin(), L2.end());
assign(n, elem); //将n个elem拷贝赋值给本身。L4.assign(10, 100);
list& operator=(const list &lst); //重载等号操作符 L2 = L1;
swap(lst); //将lst与本身的元素互换。 L1.swap(L2);
2、list 大小操作
size(); //返回容器中元素的个数 L1.size()
empty(); //判断容器是否为空 L1.empty()
resize(num); //重新指定容器的长度为num,若容器变长,则以默认值填充新位置。 如果容器变短,则末尾超出容器长度的元素被删除。L1.resize(10);
resize(num, elem); //重新指定容器的长度为num,若容器变长,则以elem值填充新位置。 如果容器变短,则末尾超出容器长度的元素被删除。
3、 list 插入和删除
push_back(elem);//在容器尾部加入一个元素 L.push_back(10);尾插
pop_back();//删除容器中最后一个元素 尾删 L.pop_back();
push_front(elem);//在容器开头插入一个元素 头插 L.push_front(100);
pop_front();//从容器开头移除第一个元素 头删 L.pop_front();
insert(pos,elem);//在pos位置插elem元素的拷贝,返回新数据的位置。 L.insert(++it, 1000);
insert(pos,n,elem);//在pos位置插入n个elem数据,无返回值。
insert(pos,beg,end);//在pos位置插入[beg,end)区间的数据,无返回值。
clear();//移除容器的所有数据 清空 L.clear();
erase(beg,end);//删除[beg,end)区间的数据,返回下一个数据的位置。
erase(pos);//删除pos位置的数据,返回下一个数据的位置。 L.erase(++it);
remove(elem);//删除容器中所有与elem值匹配的元素。 L.remove(10000);
4、list 数据存取
ist容器中不可以通过[]或者at方式访问数据
front(); //返回第一个元素。 L1.front()
back(); //返回最后一个元素。 L1.back()
5、list 反转和排序
reverse(); //反转链表 L.reverse();
sort(); //链表排序 L.sort(); //默认 从小到大 printList(L); L.sort(myCompare); //指定规则,从大到小
补充6:set/ multiset 容器
所有元素都会在插入时自动被排序
本质: set/multiset属于关联式容器,底层结构是用二叉树实现。
set和multiset区别: set不允许容器中有重复的元素 multiset允许容器中有重复的元素
1、set大小和交换
size(); //返回容器中元素的数目 s1.size()
empty(); //判断容器是否为空 s1.empty()
swap(st); //交换两个集合容器 s1.swap(s2);
2、set插入和删除
insert(elem); //在容器中插入元素。 s1.insert(10);
clear(); //清除所有元素
erase(pos); //删除pos迭代器所指的元素,返回下一个元素的迭代器。 s1.erase(s1.begin());
erase(beg, end); //删除区间[beg,end)的所有元素 ,返回下一个元素的迭代器。
erase(elem); //删除容器中值为elem的元素。
#include<bits/stdc++.h>//万能头文件
using namespace std;
int main(){
	set<int>s;

	int n=5,num=0;
	while(n)//使用while循环将输入的数字插入set容器中
	{
		cin>>num;
		s.insert(num);
		n--;
	}
	for(auto it=s.begin();it!=s.end();it++)
	//用auto定义一个有初始值的变量时,不需要明确指定类型,因为编译器能自动从变量的初始值推断出该变量的数据类型
	//auto类型:局部变量,关键字“auto”可以被省略。这些变量被表用时分配存储方式,函数调用结束后这些存储空间就被释放
	{
		cout<<*it<<" ";
	}
	return 0;
}
3、set查找和统计
find(key); //查找key是否存在,若存在,返回该键的元素的迭代器;
若不存在,返回set.end(); s1.find(30);
count(key); //统计key的元素个数 int num = s1.count(30);
查找 --- find (返回的是迭代器) 统计 --- count (对于set,结果为0或者1)
4、set容器排序
set容器默认排序规则为从小到大,掌握如何改变排序规则
利用仿函数,可以改变排序规则
class MyCompare
{
public:
bool operator()(int v1, int v2) {
return v1 > v2;
}
};
set<int,MyCompare> s2;

class comparePerson
{
public:
bool operator()(const Person& p1, const Person &p2)
{
//按照年龄进行排序 降序
return p1.m_Age > p2.m_Age;
}
};

set<Person, comparePerson> s;
补充7:map/ multimap容器
map中所有元素都是pair
pair中第一个元素为key(键值),起到索引作用,第二个元素为value(实值)
所有元素都会根据元素的键值自动排序
本质: map/multimap属于关联式容器,底层结构是用二叉树实现。
优点: 可以根据key值快速找到value值
map和multimap区别:
map不允许容器中有重复key值元素
multimap允许容器中有重复key值元素
1、pair对组创建
成对出现的数据,利用对组可以返回两个数据
两种创建方式:
pair <type,type> p ( value1, value2 ); pair<string,int> p(string("Tom"), 20);
pair <type,type> p = make_pair( value1, value2 ); pair<string,int> p2 = make_pair("Jerry", 10);
map中所有元素都是成对出现,插入数据时候要使用对组
2、map大小和交换
size(); //返回容器中元素的数目 m.size()
empty(); //判断容器是否为空 m.empty()
swap(st); //交换两个集合容器 m.swap(m2);
3、map插入和删除
insert(elem); //在容器中插入元素。 m.insert(pair<int,int>(1, 10)); m.insert(make_pair(2, 20));
m[4] = 40; m.insert(map::value_type(3, 30));
clear(); //清除所有元素
erase(pos); //删除pos迭代器所指的元素,返回下一个元素的迭代器。
erase(beg, end); //删除区间[beg,end)的所有元素 ,返回下一个元素的迭代器。
erase(key); //删除容器中值为key的元素。 m.erase(3);
4、map查找和统计
find(key); //查找key是否存在,若存在,返回该键的元素的迭代器;
若不存在,返回set.end(); m.find(3);
count(key); //统计key的元素个数 int num = m.count(3);
查找 --- find (返回的是迭代器) 统计 --- count (对于map,结果为0或者1)
5、map容器排序
map容器默认排序规则为 按照key值进行 从小到大排序,利用仿函数,可以改变排序规则
class MyCompare {
public:
bool operator()(int v1, int v2) {
return v1 > v2;
}
};

//默认从小到大排序
//利用仿函数实现从大到小排序
map<int, int, MyCompare> m; 566


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


