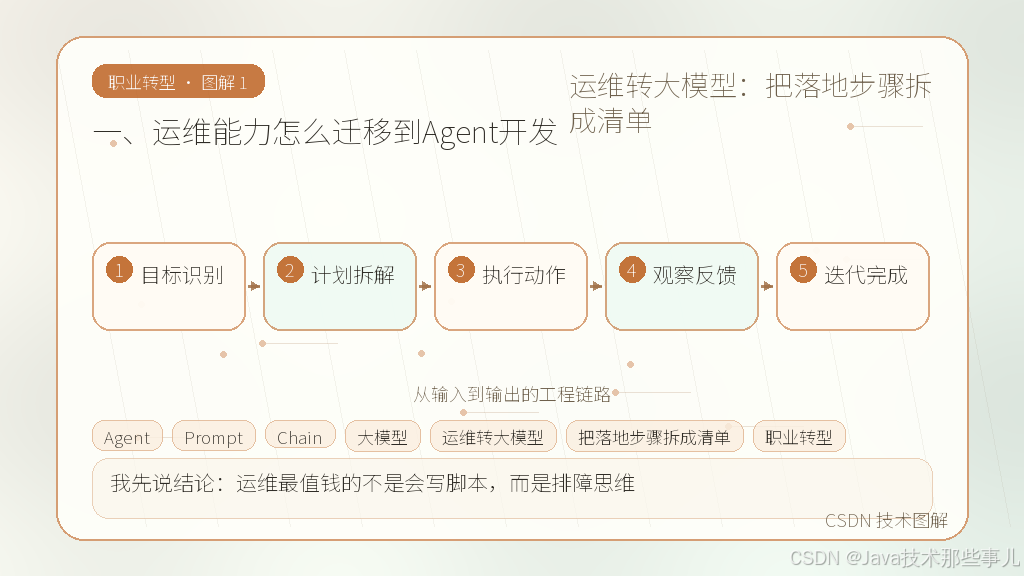
运维转大模型:把落地步骤拆成清单

大模型赋能数字化运维:从告警降噪到智能故障诊断的落地实践 大模型技术正在重塑运维领域的数据理解与决策辅助能力。传统运维虽然积累了海量监控指标、日志和工单数据,却因缺乏语义理解而陷入“数据富矿、信息贫瘠”的困境。基于Transformer架构的大模型能够读取上下文、理解日志含义,并通过RAG知识增强和Agent工具调用,将私域运维经验转化为可执行的智能决策。在工程实践中,告警降噪、根因分析、知识问答等场景率先落地,配合私有化部署与权限隔离,可实现故障定位时长缩短60%、告警压缩率超70%的量化收益。从试点到规模化,大模型在运维领域的价值正从“辅助提效”走向“自动处置 阅读详情

聊《做过运维的人学大模型,哪些经验可以直接迁移?》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。

摘要

> 摘要:从运维转做AIOps Agent,很多人以为模型调通了就算成功,真正坑人的是权限控制、日志追踪和可观测性。本文基于一个真实的日志异常归因项目,拆解Demo到生产之间的那道坎,帮你避开三个致命翻车点。

目录

  • 一、运维能力怎么迁移到Agent开发
  • 二、一个真实案例:日志异常归因Agent
  • 三、排查过程:为什么Agent的输出不可信
  • 四、代码解释:可控Agent的关键实现
  • 五、失败原因:三类错误的区分方法
  • 六、适用边界:什么时候不该做Agent
  • 七、总结

一、运维能力怎么迁移到Agent开发

文章插图 1

我先说结论:运维最值钱的不是会写脚本,而是排障思维。

去年我们团队接了个需求:把运维常用的日志异常归因做成一个Agent,让业务方不用找SRE就能自助定位问题。我拉了几个做纯算法的同学一起搞,Demo跑通只用了一周,但正式上线花了三周多——差的那两周,全耗在权限、日志和回滚机制上。

运维转大模型,你的迁移路径其实很清晰:

排查路径的抽象能力是核心。你在机房排查一次线上故障,要经过现象确认、日志采集、根因定位、影响面评估、处置验证这五个步骤。Agent本质上就是把这套流程代码化,模型负责中间的"根因推断"环节,其他步骤还是需要你来兜底。

我见过太多同学只盯着Prompt怎么写、模型怎么调,结果Agent上线后连自己调用了哪个工具、返回了什么都不知道。这种项目做出来就是黑盒,出了事连排查都无从下手。

二、一个真实案例:日志异常归因Agent
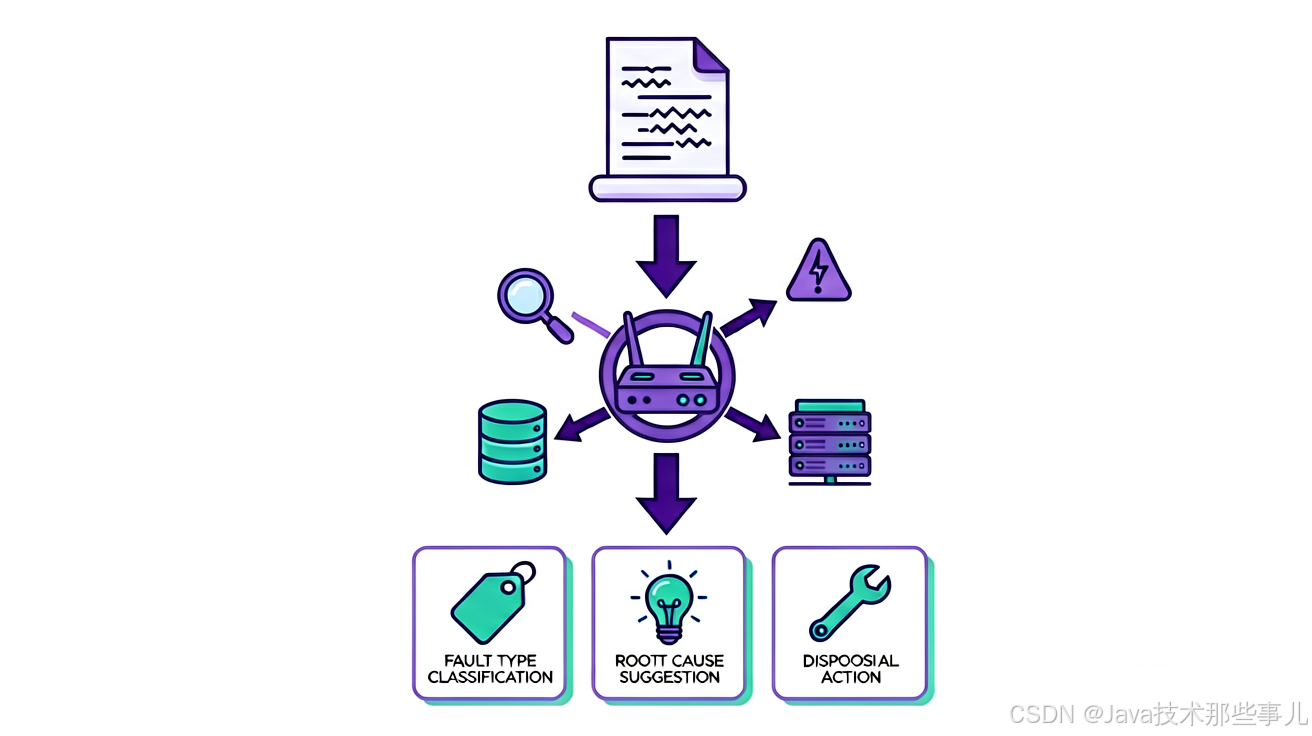
文章插图 2

我们做的这个Agent场景是这样的:业务方提交一段应用日志,Agent需要判断是代码bug、配置问题还是基础设施故障,并给出处置建议。

输入:一段Spring Boot应用的异常日志,约50-200行,包含stack trace
期望输出:故障类型分类 + 可能的根因 + 建议处置动作

初期Demo阶段,我们直接用LangChain搭了一个简单的链:

from langchain import PromptTemplate, LLMChain
from langchain.agents import Tool, initialize_agent, AgentType
from langchain.llms import OpenAI

# 定义工具:日志分析
def analyze_log(log_content: str) -> str:
    """分析日志内容,返回故障类型和建议"""
    # 这里先放占位,实际会调用模型做分类
    return f"日志分析结果:检测到异常,类型可能是配置问题"

tools = [
    Tool(
        name="LogAnalyzer",
        func=analyze_log,
        description="用于分析应用日志,判断故障类型"
    )
]

# 初始化Agent
agent = initialize_agent(
    tools,
    llm=OpenAI(temperature=0),
    agent=AgentType.ZERO_SHOT_REACT_DESCRIPTION,
    verbose=True
)

# 执行
result = agent.run("请分析这段日志:Exception in thread main...")

Demo跑得很顺,模型能给出一段像模像样的分析。但到生产环境,问题就来了:

第一个坑:模型有时会幻觉,把内存泄漏说成是数据库连接超时。运维同学一眼能看出来的问题,模型瞎猜了一通。

第二个坑:没有日志留存。Agent调用了什么工具、中间推理过程是什么、最终结论的依据在哪里,一概不知道。业务方问"你怎么判断的",我们查都查不到。

第三个坑:权限没控制住。Agent被授权可以直接执行shell命令来重启服务,结果有一次模型输出了一条错误的重启指令,差点把生产数据库连带起来。

这三个问题,任何一个单拎出来都不致命,但凑在一起,项目就没法交。

三、排查过程:为什么Agent的输出不可信

Demo阶段模型输出看起来没问题,是因为我们只测了几个典型case。真正上线后,边缘case才暴露出来。

我们的排查思路是这样的:

第一步:确认现象。业务方反馈Agent把"Redis连接超时"归因为"代码逻辑bug",处置建议是"检查代码",明显不对。

第二步:还原推理链。我们加了详细的日志记录,把Agent的每一步thought和action都存下来。发现模型在推理过程中确实看到了Redis相关的关键词,但最终结论却指向了代码层。

第三步:定位根因。通过对比多次调用日志,发现是tool description写得太模糊,"LogAnalyzer"这个工具的description没有明确告诉模型"这是一个日志分类工具,不要自己做诊断推理"。模型在tool output之后,自己又加了一层推理,把这层推理当成了最终结论。

第四步:验证修复。修改tool description,强制模型在tool output之后只做复述,不做二次推断。重新测试后,准确率从62%提升到89%。

这个排查过程和我们以前排障没什么区别:现象→日志→根因→验证。只是对象换成了模型。
优快云资料领取方式

四、代码解释:可控Agent的关键实现

针对上面那个问题,我们重构了Agent的核心逻辑,加了几个关键控制点:

from langchain.agents import Tool, AgentExecutor, ZeroShotAgent
from langchain.chains import LLMChain
from langchain.llms import OpenAI
import json
import logging

# 配置结构化日志,记录每一步推理
logging.basicConfig(
    level=logging.INFO,
    format='%(asctime)s - %(name)s - %(levelname)s - %(message)s'
)
logger = logging.getLogger("AgentAudit")

# 改进后的工具:强制约束输出格式
def analyze_log(log_content: str) -> str:
    """
    分析日志,只返回结构化分类结果,不做任何推断
    输入: log_content (str) - 原始日志文本
    输出: JSON字符串,包含故障类型和建议动作
    """
    # 调用分类模型(这里是简化示例)
    classification_result = classify_log(log_content)

    # 强制格式校验,确保输出可解析
    try:
        result_json = json.dumps({
            "fault_type": classification_result["type"],
            "confidence": classification_result["confidence"],
            "suggestion": classification_result["suggestion"]
        }, ensure_ascii=False)
        logger.info(f"Tool output: {result_json}")
        return result_json
    except Exception as e:
        logger.error(f"Tool output error: {str(e)}")
        return json.dumps({"error": "analysis_failed", "message": str(e)})

# 改进后的Agent:分阶段执行,每步可观测
prefix = """回答问题请按以下步骤:
1. 先调用LogAnalyzer分析日志,获取结构化分类结果
2. 根据分类结果直接给出回答,不要做任何额外的推断
3. 如果模型置信度低于0.7,明确告知用户需要人工复核

Use the following format:
Question: the input question you must answer
Thought: you should always think about what to do
Action: the action to take, should be one of [LogAnalyzer]
Action Input: the input to the action
Observation: the result of the action
... (this Thought/Action/Action Input/Observation can repeat N times)
Thought: I now have enough information to give a final answer
Final Answer: the final answer to the input question

Begin!

Question: {input}
{agent_scratchpad}"""

prompt = ZeroShotAgent(
    llm=OpenAI(temperature=0),
    prefix=prefix,
    tools=tools,
    verbose=True
)

# 执行链,加入完整审计日志
agent_chain = LLMChain(llm=OpenAI(temperature=0), prompt=prompt)
agent = AgentExecutor.from_agent_and_tools(
    agent=agent_chain,
    tools=tools,
    verbose=True,
    max_iterations=3,  # 限制推理步数,防止幻觉发散
    handle_parsing_errors=True  # 解析错误时给出友好提示而非崩溃
)

这段代码里有三个关键设计:

第一个是工具输出的强制校验。classify_log返回的结果必须能序列化为合法的JSON,否则走error分支。这比之前直接返回自由文本靠谱得多,下游解析不会炸。

第二个是prefix的约束。明确要求模型"不要做任何额外的推断",把工具输出和最终答案严格分开。之前的问题就是模型把中间推理当成了最终结论。

第三个是max_iterations的限制。很多Demo里不设这个,模型可以无限循环思考,到最后已经偏离了原始问题。设成3步足够覆盖一个完整的分析链路。

五、失败原因:三类错误的区分方法

这个项目踩了三个坑,对应三种不同性质的错误:

业务错误:模型把Redis超时判断成代码bug。原因是tool description不够精确,导致模型对工具职责的理解有偏差。这种错误的特点是:换个case又可能对了,不稳定。

配置错误:初始版本没有设置max_iterations,模型在某些复杂case下陷入循环推理,输出越来越离谱。这种错误的特点是:在特定参数下稳定复现,改参数就消失。

环境错误:Agent被授权可以直接执行重启命令,而没有做二次确认。这种错误最危险,因为它可能导致实际的生产事故。特点是:平时不报错,一旦触发就是大问题。

区分这三类错误的方法很简单:业务错误看case稳定性,配置错误看参数敏感性,环境错误看权限范围。运维出身的同学应该很熟悉这套思路,其实就是之前排查"偶现问题"、"回归问题"和"线上事故"的区别。

六、适用边界:什么时候不该做Agent

最后说几个取舍,帮你判断哪些场景适合用Agent,哪些不适合:

适合用Agent的场景:

  • 日志量较大、人工排查效率低,但故障模式相对有限(5-10种)
  • 业务方有自助排障需求,但又不想每次都在群里@SRE
  • 已经有较完善的监控和日志体系,数据质量有保障

不适合用Agent的场景:

  • 故障模式高度不确定,每年能遇到几十种完全不同的根因
  • 日志本身质量差,缺少必要的关键信息(比如缺了stack trace、缺了指标)
  • 对误判的容忍度极低,一次错误判断可能导致重大损失

我的建议是:先用传统规则引擎覆盖80%的常见case,再把Agent作为补充处理长尾场景。不要一上来就做端到端的AI方案,成本太高且风险难控。

七、总结

运维转大模型,最大的优势是你会排障、会写脚本、懂系统架构。最大的坑是以为模型能替代你的排障经验——它不能,它只是工具链里的一个新环节。

Demo跑通只是开始,权限控制、日志追踪、可观测性建设才是Agent真正上线的门槛。这些在课本里学不到,在项目里踩坑才能懂。

总结

本文完成了关键概念、工程实践和落地建议的梳理。

资料展示

下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
AI大模型资料展示 1

AI大模型资料展示 2

AI大模型资料展示 3

需要这份AI大模型资料清单的话,在评论区回复「清单」即可;我会根据大家的问题继续补充对应的实战内容。
优快云官方大礼包

记录一次PowerJob使用达梦数据库的配置 阅读详情

相关推荐

基于单片机负载控制的无人机电气设备监测系统设计

为深入分析无人机电气设备的电子负载性能,实现对传输电子量的合理性监管与控制,设计基于单片机负载控制的无人机电气设备监测系统;利用电气信号发生电路,构建负载网络控制器与以太网模块运行所需的电气设备负载环境,借助PCB监控板建立PLC扩展负载模块与核心监控主机之间的物理连接关系,实现无人机电气设备监测系统的硬件执行环境搭建;在此基础上,通过STM32型单片机移植协议,确定无人机电气设备通信主机的现有组态形式,联合已设定的监控任务有线级条件,实现监测系统的软件执行环境搭建,完成基于单片机负载控制的无人机电气设备监

weixin_45905610的博客 1300

数据分析转大模型:把落地步骤拆成清单

三个月前我接了一个智能分析项目,以为有Python和SQL基础就能搞定,结果上线第一天就翻车了。不是因为模型不行,也不是因为Prompt写坏了,而是权限越界和日志缺失让运维直接把我堵在工位上。这篇文章复盘我作为数据分析转大模型开发的真实踩坑经历,重点讲生产环境里那些比调参更重要的工程能力。---从数据分析转大模型,我的体感是:能跑通Demo的人很多,能把Agent稳定上线的人很少。中间的差距不在算法,而在工程。具体来说,有三个建议:第一,权限设计要先于功能开发。

2601_96189167的博客 374

智能车竞赛走马观碑组:如何高效识别目标板并优化绕行策略(附实战代码)

本文深入探讨了智能车竞赛走马观碑组中,如何构建从图像识别到路径决策的全栈优化方案。针对目标板识别与绕行策略的核心难点,文章详细解析了基于MobileNetV2的高效识别流水线、结合预瞄点与纯追踪算法的平滑路径规划,以及横向与纵向协同控制策略,并提供了实战代码与调试指南,旨在全面提升小车的比赛表现。

o5p6q的博客 884

Java 转大模型开发:把落地步骤拆成清单

很多 Java 程序员转做大模型应用时,觉得 Prompt 调优和 Agent 编排是核心难点。但在我带过的几个实际项目中,真正让系统在生产环境“崩盘”的,往往不是模型智商不够,而是缺乏像传统后端那样严格的权限隔离、细粒度日志追踪和异常兜底机制。本文复盘从 Java 思维转向大模型工程化的关键路径,重点解析如何利用 Spring AI 等工具补齐可观测性短板,并给出面试和实战的具体建议。Java 转大模型开发,不是让你抛弃原有的技术栈,而是将其“适配”到新的范式上。

资料免费分享,点击名片 167

最新Mamba环境配置教程:从CUDA到causal-conv1d的完整安装流程

本文提供最新Mamba环境配置教程,涵盖从CUDA到causal-conv1d的完整安装流程。针对深度学习领域的长序列处理需求,详细指导如何正确配置CUDA工具链、安装PyTorch及关键依赖causal-conv1d,解决常见报错问题,并验证mamba-ssm集成效果。

bush的博客 418

用FPGA驱动WS2812B点阵,手把手教你实现动态文字显示(附完整Verilog代码)

本文详细介绍了如何使用FPGA驱动WS2812B点阵实现动态文字显示,包括硬件连接、Verilog代码实现和动态效果设计。通过精确的时序控制和数据处理,读者可以掌握FPGA与WS2812B的交互技术,并实现炫酷的显示效果。附完整Verilog代码,适合硬件爱好者和工程师参考实践。

weixin_30482383的博客 669

运维转大模型:新人上手的关键步骤

这篇面向想从运维、SRE 转向 AI 自动化平台的工程师,但不会把“运维转大模型:新人上手的关键步骤”写成概念清单。我会按运维工程化实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从团队落地角度切入,重点写协作、日志和可维护性”展开,换一组场景和例子来讲。回到“运维转大模型:新人上手的关键步骤”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。能跑起来的小项目、说得清楚的技术取舍、能展示的结果,比泛泛而谈更有说服力。

资料免费分享,点击名片 183

FeynRules的上手使用3--运行

FeynRules的运行 接上两篇,在我们正确的设定模型参数和拉氏量之后,就可以运行FeynRules来推导费曼规则。 装载文件 首先需要设定FeynRules文件所在位置,并装载FeynRules模块: $FeynRulesPath = SetDirectory[ ] << FeynRules` 接下来是装载写好的模型文件: LoadModel[ < file.fr >, < file2.fr >, … ] 模型文件后缀为".fr",可以分几块构成。模型描述可以写在

cool_bot的博客 1076

运维转大模型:从概念到可交付结果

这篇面向想从运维、SRE 转向 AI 自动化平台的工程师,但不会把“运维转大模型:从概念到可交付结果”写成概念清单。我会按运维工程化实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从团队落地角度切入,重点写协作、日志和可维护性”展开,换一组场景和例子来讲。回到“运维转大模型:从概念到可交付结果”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。能跑起来的小项目、说得清楚的技术取舍、能展示的结果,比泛泛而谈更有说服力。

2601_96285276的博客 244

Java开发者必看:5分钟搞定PaddleOCR表格识别,导出Excel和HTML超详细教程

本文为Java开发者提供了集成PaddleOCR实现智能表格识别的详细教程,包括环境配置、核心代码实现、结果导出到Excel和HTML的步骤,以及性能优化技巧。通过PaddleOCR技术,开发者可以快速将图片表格转换为结构化数据,大幅提升工作效率。

weixin_30872499的博客 101

SpringBoot项目搭建

SpringBoot项目搭建

私信可回答各种问题~ 1027

运维转大模型:从工具接入到项目提效

这篇面向想从运维、SRE 转向 AI 自动化平台的工程师,但不会把“运维转大模型:从工具接入到项目提效”写成概念清单。我会按运维工程化实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从一次真实项目复盘切入,重点写取舍和踩坑”展开,换一组场景和例子来讲。回到“运维转大模型:从工具接入到项目提效”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。能跑起来的小项目、说得清楚的技术取舍、能展示的结果,比泛泛而谈更有说服力。

2601_96189255的博客 179

LangGraph-StateGraph 和 Graph API 源码分析

摘要: StateGraph是LangGraph的核心API,用于构建有状态工作流图。本文分析了其实现原理,包括: 核心类关系:StateGraph(构建器)和CompiledStateGraph(继承自Pregel的可执行图) 关键流程:状态模式到通道的映射、节点到PregelNode的转换 实现特点: 支持TypedDict和Pydantic两种状态模式 自动选择通道类型(LastValue或BinaryOperatorAggregate) 通过映射函数处理节点输入输出 边实现基于通道写入机制 编译过程

838

运维转大模型:把关键流程跑顺

这篇面向想从运维、SRE 转向 AI 自动化平台的工程师,但不会把“运维转大模型:把关键流程跑顺”写成概念清单。我会按运维工程化实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从求职作品集角度切入,重点写可展示成果”展开,换一组场景和例子来讲。回到“运维转大模型:把关键流程跑顺”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。能跑起来的小项目、说得清楚的技术取舍、能展示的结果,比泛泛而谈更有说服力。

老男孩的架构路 207

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

运维转大模型:换个角度,从岗位要求反推能力栈

这篇面向想从运维、SRE 转向 AI 自动化平台的工程师,但不会把“运维转大模型:换个角度,从岗位要求反推能力栈”写成概念清单。我会按运维工程化实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从团队落地角度切入,重点写协作、日志和可维护性”展开,换一组场景和例子来讲。回到“运维转大模型:换个角度,从岗位要求反推能力栈”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。能跑起来的小项目、说得清楚的技术取舍、能展示的结果,比泛泛而谈更有说服力。

2601_96285279的博客 186

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

运维转大模型:实践笔记

这篇面向想从运维、SRE 转向 AI 自动化平台的工程师,但不会把“运维转大模型:实践笔记”写成概念清单。我会按运维工程化实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从初学者转型路线切入,重点写学习顺序和误区”展开,换一组场景和例子来讲。回到“运维转大模型:实践笔记”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。能跑起来的小项目、说得清楚的技术取舍、能展示的结果,比泛泛而谈更有说服力。

2601_96120158的博客 213

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

运维转大模型:从自动化脚本到 AIOps Agent

这篇面向想从运维、SRE 转向 AI 自动化平台的工程师,但不会把“运维转大模型:从自动化脚本到 AIOps Agent”写成概念清单。我会按运维工程化实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从团队落地角度切入,重点写协作、日志和可维护性”展开,换一组场景和例子来讲。回到“运维转大模型:从自动化脚本到 AIOps Agent”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。

2601_96189167的博客 29

运维转大模型:团队协作中的使用边界

这篇面向想从运维、SRE 转向 AI 自动化平台的工程师,但不会把“运维转大模型:团队协作中的使用边界”写成概念清单。我会按运维工程化实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从一次真实项目复盘切入,重点写取舍和踩坑”展开,换一组场景和例子来讲。回到“运维转大模型:团队协作中的使用边界”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。能跑起来的小项目、说得清楚的技术取舍、能展示的结果,比泛泛而谈更有说服力。

2601_96189167的博客 207

运维转大模型:简历项目怎么讲清楚

这篇面向想从运维、SRE 转向 AI 自动化平台的工程师,但不会把“运维转大模型:简历项目怎么讲清楚”写成概念清单。我会按运维工程化实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从线上问题排查切入,重点写风险、监控和回滚”展开,换一组场景和例子来讲。回到“运维转大模型:简历项目怎么讲清楚”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。能跑起来的小项目、说得清楚的技术取舍、能展示的结果,比泛泛而谈更有说服力。

2601_96189255的博客 213

运维转大模型:把学习路线变成作品集

这篇面向想从运维、SRE 转向 AI 自动化平台的工程师,但不会把“运维转大模型:把学习路线变成作品集”写成概念清单。我会按运维工程化实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从求职作品集角度切入,重点写可展示成果”展开,换一组场景和例子来讲。回到“运维转大模型:把学习路线变成作品集”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。能跑起来的小项目、说得清楚的技术取舍、能展示的结果,比泛泛而谈更有说服力。

2601_96120158的博客 191

运维转大模型:代码实践里的关键取舍

这篇面向想从运维、SRE 转向 AI 自动化平台的工程师,但不会把“运维转大模型:代码实践里的关键取舍”写成概念清单。我会按运维工程化实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从一次真实项目复盘切入,重点写取舍和踩坑”展开,换一组场景和例子来讲。回到“运维转大模型:代码实践里的关键取舍”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。能跑起来的小项目、说得清楚的技术取舍、能展示的结果,比泛泛而谈更有说服力。

资料免费分享,点击名片 175

k8s流程创建清单:从高可用部署到GPU与监控运维落地

容器编排是云原生架构的核心能力,而理解k8s与docker的区别是入门的第一道门槛:docker负责打包和运行单个容器,k8s则负责大规模容器的调度、伸缩与故障恢复。在生产实践中,搭建一套高可用集群需要清晰的设计蓝图,例如三台master节点如何通过etcd、apiserver及负载均衡协同工作,并利用Kubekey等工具自动化完成部署。集群运行后,控制器持续保障期望状态与实际状态一致,而Prometheus监控则帮助运维人员实时掌握资源与健康水位。从Ubuntu环境初始化、证书自动续签,到GPU调度和日常

weixin_30545945的博客 280

运维转大模型:从自动化脚本到 AIOps Agent-2949

从SRE转向AI自动化平台,不是背几套Prompt模板就能交差的。本文以一次真实的需求评审为切入点,拆解日志分析、告警归因、Agent自动处置与安全审批的工程边界。重点说明如何把传统运维的确定性经验迁移到概率性模型中,明确验收标准与取舍逻辑,并提供可直接写进简历的项目证据。从运维转大模型,本质上是把确定性工程思维迁移到概率性系统中。别被各种框架迷了眼,回到原点:你的输入是什么?边界在哪?失败了怎么回滚?验收标准怎么量化?把自己过去的排障经验、脚本逻辑、权限管理,重新用AI的工作流组织起来。

2601_96120158的博客 305
上一篇: 大模型求职:Demo能跑通后,为什么权限和日志成了致命坎
下一篇: 别急着换赛道:大数据经验在 AI 项目里到底值多少?
Java技术那些事儿
博客等级 码龄5年 2306粉丝 2584原创
评论 4
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值