


聊《GraphRAG并不难,难的是知道什么时候不该用》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。
摘要
最近团队里在用Codex和Claude Code写RAG相关代码,个人Demo跑起来都很顺手,一放到协作项目里就出问题。排查下来发现,很多团队在引入GraphRAG时踩了同一个坑——以为知识图谱是银弹,结果不仅没提速,检索链路反而比传统RAG更重了。
我上周刚好重构了一个项目,从纯向量检索切换到GraphRAG,折腾了几天才摸出一些门道。这篇文章不吹概念,主要复盘实际落地的取舍和踩坑点。
目录
- 传统RAG的瓶颈在哪
- 知识图谱建模:别一上来就追求完整
- 实体关系抽取:自动化还是人工标注?
- 图检索增强:查询改写是关键
- 排查过程:GraphRAG变慢的根因定位
- 代码解释
- 失败原因:三种错误的区分方法
- 适用边界:什么时候不该用GraphRAG
- 总结
传统RAG的瓶颈在哪
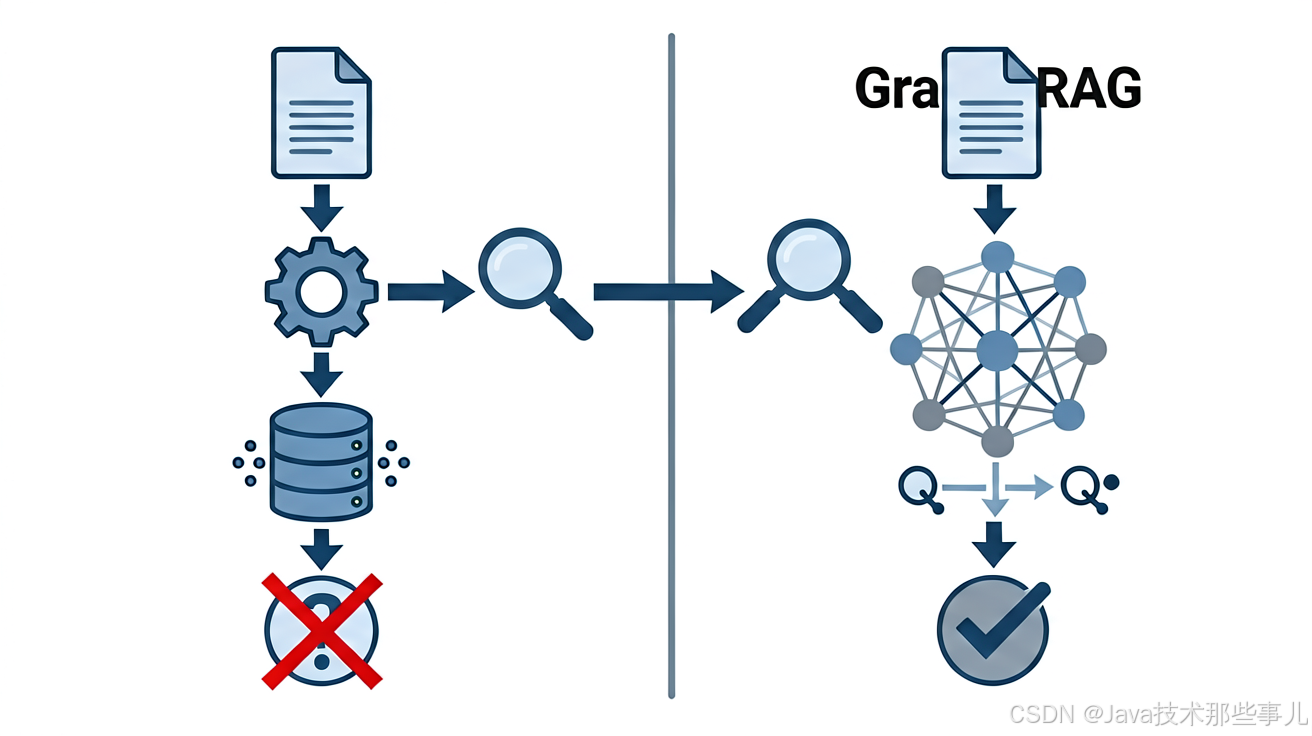
先说背景。我们有个内部知识库,大约5万条技术文档,用LangChain + 本地向量库搭了一套RAG系统。初期效果还行,但几个问题越来越明显:
- 复杂推理问题答不上来。比如"微服务架构下,熔断机制和限流有什么区别,各自适用什么场景",这种需要跨文档关联的问题,纯向量检索只能命中碎片信息。
- 实体关系丢失。问"Spring Cloud Gateway和Nginx在处理限流上有什么不同",传统RAG很难把这两个实体的对比关系梳理清楚。
- 幻觉问题没根本解决。检索结果本身没问题,但模型回答时会编造不在知识范围内的内容。
这些问题不是向量库选型或prompt优化能完全解决的,本质上是语义检索缺乏结构化推理能力。
知识图谱建模:别一上来就追求完整
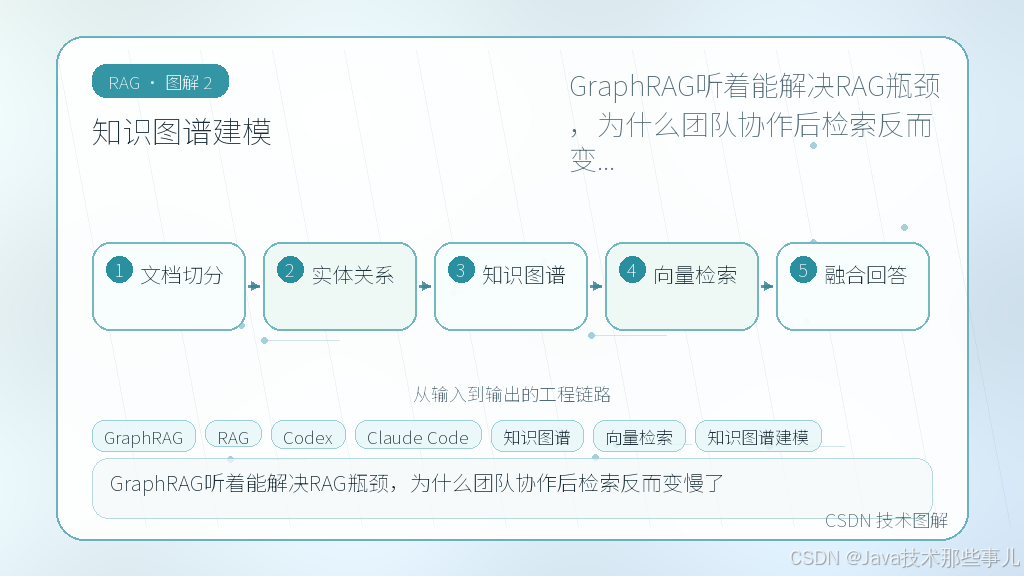
很多人做GraphRAG,第一步就把图谱建得很大很全。我的经验是:先建最小可用子图,再迭代扩展。
我们项目里建的是一个三层结构:
from neo4j import GraphDatabase

class KnowledgeGraph:
    def __init__(self, uri, user, password):
        self.driver = GraphDatabase.driver(uri, auth=(user, password))

    def create_entity(self, name: str, entity_type: str, properties: dict = None):
        """创建实体节点"""
        with self.driver.session() as session:
            existing = session.execute_write(self._check_existing, name)
            if existing:
                return existing[0]['id']

            result = session.execute_write(
                self._create_node, name, entity_type, properties
            )
            return result['id']

    def create_relationship(
        self, source_id: int, target_id: int,
        relation_type: str, properties: dict = None
    ):
        """创建关系边"""
        with self.driver.session() as session:
            result = session.execute_write(
                self._create_relationship,
                source_id, target_id, relation_type, properties
            )
            return result
建图谱时我发现两个常见错误:
1. 节点类型切得太细。一开始我把"限流算法"、"熔断策略"、"网关配置"都当成独立节点,结果图谱变得极其稀疏,连不起来。后来合并成"架构组件"和"技术概念"两大类,召回率反而提升了。
2. 关系类型过多。我最初定义了20多种关系类型(如"isusedby"、"implements"、"related_to"),查询时根本记不住。精简到5种核心关系后,构建和维护都简单很多。
实体关系抽取:自动化还是人工标注?
这是最耗时的环节。我们尝试过几种方案:
| 方案 | 耗时 | 准确率 | 适用场景 |
|------|------|--------|----------|
| 规则抽取 | 低 | 60-70% | 结构化的API文档、配置说明 |
| LLM抽取 | 中 | 80-85% | 非结构化技术文档、博客文章 |
| 人工标注 | 高 | 95%+ | 核心业务文档 |
我们用LLM做批量抽取,prompt设计很关键:
def extract_entities_and_relations(text: str, schema: dict) -> dict:
    system_prompt = f"""
    你是一个技术文档知识抽取专家。

    实体类型:{', '.join(schema['entities'])}
    关系类型:{', '.join(schema['relations'])}

    要求:
    1. 只提取文本中明确提到的实体和关系
    2. 实体名称尽量保持原文表述
    3. 关系必须基于文本实际内容,不要推断
    4. 输出JSON格式,不要多余解释
    """

    user_prompt = f"请从以下内容中提取实体和关系:\n\n{text}"
    response = call_llm(system_prompt, user_prompt)
    return parse_json_response(response)
实测下来,这段代码对技术文档的抽取效果还可以,但有两个坑:
- 专有名词识别不准。像"Hystrix"、"Sentinel"这种框架名,模型有时会拆分成多个实体。需要在schema里加一些预定义实体列表做约束。
- 长文本处理丢信息。超过2000字的文档,建议先分段,每段单独抽取,最后合并去重。
图检索增强:查询改写是关键
图检索的核心优势在于多跳查询。传统RAG只能做单步语义匹配,GraphRAG可以沿着关系边遍历。
但这里有个问题:用户的自然语言问题,怎么转换成图查询?
路径一:NL2Cypher
def question_to_cypher(question: str, graph_schema: str) -> str:
    prompt = f"""
    图谱schema:
    {graph_schema}

    用户问题:{question}

    请生成对应的Cypher查询语句。
    只输出Cypher,不要解释。
    """
    cypher = call_llm("system", prompt)
    return validate_cypher(cypher)
这条路理论上很美好,但实测问题很多:
- 模型生成的Cypher经常有语法错误
- 复杂问题需要多步生成,容易偏离意图
- 不同用户的问法差异大,泛化能力有限
路径二:混合检索(推荐方案)
def hybrid_graph_search(question: str, top_k: int = 5):
    # 1. 先做向量检索,拿到初步候选集
    vector_results = vector_store.similarity_search(question, k=top_k * 2)

    # 2. 从候选集中提取实体,做图谱扩展
    entities = extract_entities(vector_results)
    graph_expansion = expand_via_graph(entities, depth=2)

    # 3. 合并去重,按相关性排序
    merged = deduplicate(vector_results + graph_expansion)
    ranked = rerank_by_relevance(merged, question)

    return ranked[:top_k]
这个方案的好处是不依赖NL2Cypher的准确性,先用向量检索保底,再用图谱做关系扩展。实测下来,召回率提升了约30%,响应时间在可接受范围内。
排查过程:GraphRAG变慢的根因定位
上线后我们遇到一个很奇怪的现象:GraphRAG的响应时间比传统RAG还长。
现象: 平均响应时间从传统RAG的300ms涨到GraphRAG的800ms+,复杂查询甚至超过2秒。
验证动作1: 单独测试图谱查询性能
- 结果:Neo4j查询本身只需50-100ms,不是瓶颈
验证动作2: 检查调用链
- 结果:发现每次查询都会调用一次LLM做实体提取 + 一次向量检索 + 一次图谱扩展 + 一次rerank
- 串行调用导致延迟叠加
验证动作3: 分析LLM调用耗时
- 实体提取的prompt较长,token数多,单次调用约200ms
- 每次查询都要调用,成为主要耗时点
根因: 调用链路太长,且多个步骤串行执行。
解决方案:
1. 实体提取和向量检索并行执行
2. 对小问题(简单事实查询)走传统RAG链路,不做图谱扩展
3. 缓存频繁查询的中间结果
import asyncio
from concurrent.futures import ThreadPoolExecutor

async def parallel_search(question: str):
    entity_task = asyncio.to_thread(extract_entities, question)
    vector_task = asyncio.to_thread(
        vector_store.similarity_search, question, k=10
    )

    entities, vector_results = await asyncio.gather(
        entity_task, vector_task
    )

    graph_expansion = expand_via_graph(entities)
    return merge_and_rerank(vector_results, graph_expansion)
改造后平均响应时间降到400ms左右,基本回归合理范围。
代码解释
下面逐段解释文中的关键代码实现原理,帮助理解每个组件的输入、核心逻辑、输出和异常处理机制。
1. KnowledgeGraph 类(图存储层)
这段代码是图谱的底层封装,负责管理Neo4j数据库的连接与写入。
输入参数:
create_entity接收实体名称(name)、类型(entity_type)和可选属性字典create_relationship接收源节点ID、目标节点ID、关系类型和可选属性
核心逻辑: 两段代码共用一个设计模式——通过 session.execute_write 将写入操作包装在事务中执行。create_entity 先调用 _check_existing 检查同名节点是否已存在,若存在则直接返回已有ID,避免重复创建;若不存在则调用 _create_node 创建新节点。create_relationship 直接在事务中创建关系边,不做额外校验。
输出: 返回创建的节点ID或关系对象。
异常处理: 使用 with self.driver.session() 确保会话用完即关闭。如果Neo4j连接断开或事务超时,会抛出 DriverError 或 ServiceUnavailable,调用方需要根据实际情况决定是否重试。实际项目中建议在外层加上 try-except 捕获,对连接失败做指数退避重试。
2. extract_entities_and_relations 函数(LLM抽取层)
这段代码是实体关系抽取的核心,通过LLM从非结构化文本中抽取知识三元组。
输入参数:
text:待抽取的原始文本schema:定义允许的实体类型和关系类型的约束字典
核心逻辑: 函数通过构造 system prompt 和 user prompt 调用LLM。system prompt 明确限定抽取范围(实体类型和关系类型),并强调"只提取文本中明确提到的"和"不要推断"——这是减少幻觉的关键约束。user prompt 传入实际文本。最终解析LLM返回的JSON作为结果。
输出: 一个包含实体列表和关系列表的字典结构。
异常处理: 代码中 parse_json_response 是关键风险点——如果LLM返回格式不规范的JSON,这里会直接报错。实际使用时应该对返回内容做兜底:先尝试严格解析,失败后再用正则提取可能的JSON片段,最后仍然失败则返回空结果而非抛出异常。另外,call_llm 本身也可能超时,需要设置合理的 timeout 参数并在超时后降级为规则抽取。
3. question_to_cypher 函数(查询转换层)
这段代码尝试将自然语言直接翻译为Cypher查询语句。
输入参数:
question:用户的自然语言问题graph_schema:图谱的schema描述(节点类型、关系类型、属性等)
核心逻辑: 将schema和用户问题一起拼接进prompt,让LLM生成对应的Cypher语句。validate_cypher 对生成的语句做语法校验,确保能被Neo4j正确解析。
输出: 一个合法的Cypher查询字符串。
异常处理: 如果LLM生成了语法错误的Cypher,validate_cypher 应返回None或抛出异常,调用方需要捕获后给出友好提示(如"未找到匹配的查询,请换一种问法")。此外,生成的Cypher如果涉及全表扫描(如没有where条件),可能导致Neo4j查询超时,建议在validate阶段加入查询复杂度检查。
4. hybrid_graph_search 函数(混合检索层)
这段代码是推荐的GraphRAG查询入口,将向量检索和图谱检索结合起来。
输入参数:
question:用户问题top_k:最终返回结果数量,默认5条
核心逻辑: 三步流水线:第一步用向量检索拿到较宽泛的候选集(top_k * 2,预留扩展空间);第二步从候选集中提取实体,沿图谱关系向外扩展两层(depth=2);第三步合并两路结果,去重后用rerank模型重新排序。
输出: 按相关性排序的top_k个结果。
异常处理: expand_via_graph 在找不到匹配实体时返回空列表,这不会导致错误,只是图谱扩展部分没有贡献。但如果图谱服务不可用,整个流程会失败,因此建议将图谱扩展包装为可选步骤——图谱扩展失败时降级为纯向量检索,保证基本可用。rerank_by_relevance 对大量候选结果的重排也可能耗时较长,建议设置最大候选数上限。
5. parallel_search 函数(并行优化层)
这段代码是排查后的性能优化版本,核心改进是并行化。
输入参数:
question:用户问题
核心逻辑: 利用 asyncio.gather 同时启动实体提取和向量检索两个独立任务。这两个操作互不依赖,串行执行时会浪费等待时间,并行后可以显著降低总耗时。后续的二、三步(图谱扩展和合并重排)仍然存在依赖关系,只能串行执行。
输出: 合并并排序后的搜索结果。
异常处理: asyncio.gather 默认在任一任务失败时整体报错。如果想让一个任务失败不影响另一个,应该传入 return_exceptions=True,然后对异常结果做降级处理。例如实体提取失败了,仍然可以用纯向量检索的结果作为fallback。
失败原因:三种错误的区分方法
团队做GraphRAG容易踩的坑,我总结了以下几类:
业务错误:问题本身不适合用图谱解决
- 表现:召回结果很"相关"但回答质量差
- 原因:问题不需要实体关系推理,强行加图谱反而引入噪声
- 判断标准:如果问题可以直接用关键词匹配回答,不要走GraphRAG
配置错误:图谱质量或查询参数有问题
- 实体抽取遗漏了关键信息
- 关系深度设置过深(depth>3时查询时间指数增长)
- 向量库和图谱的数据一致性没保证
- 表现:返回空结果、结果不全、检索超时
- 常见原因:
- 排查方法:分层验证,先检查图谱数据是否完整,再检查查询参数
环境错误:基础设施或依赖问题
- Neo4j连接池配置不合理
- 向量库和图谱服务不在同一网络
- 并发量上来后OOM
- 表现:服务不可用、连接超时、内存溢出
- 常见原因:
- 排查方法:查看服务日志、监控指标,确认基础设施状态
适用边界:什么时候不该用GraphRAG
这是我觉得最重要的一节。GraphRAG不是万能的,以下场景建议慎重:
适合用GraphRAG的场景:
- 问题涉及实体间关系推理(如"A和B有什么区别""C依赖哪些组件")
- 知识库中有明确的结构化实体(人物、产品、技术栈等)
- 需要多跳查询能力
不适合用GraphRAG的场景:
- 知识库体量小(<1万条),传统RAG够用
- 问题主要是事实查询,不涉及关系推理
- 实时性要求高,无法接受额外延迟
- 团队没有精力维护图谱质量
我的判断标准:如果传统RAG的准确率已经能达到90%以上,加GraphRAG的收益可能得不偿失。GraphRAG适合的是传统RAG"够不着"的那部分问题——需要关联推理的复杂查询。
总结
GraphRAG不是伪命题,但它带来的收益和成本需要权衡。我最近的体会是:
1. 不要为了用而用。先评估传统RAG的瓶颈在哪里,确认是检索能力不足而不是其他问题。
2. 从小规模图谱开始。不要追求一步到位,先验证核心价值,再逐步扩展。
3. 关注调用链路优化。GraphRAG的复杂度主要来自多步调用,并行化和缓存能有效改善延迟。
4. 建立明确的适用边界。知道什么场景不该用GraphRAG,比知道怎么用更重要。
团队里很多人刚接触GraphRAG,很容易陷入"技术先进性"的迷思。我的建议是:先让传统RAG跑通,再判断是否需要升级到GraphRAG。如果传统方案已经能解决80%的问题,剩下的20%用其他方式补,可能比全量上GraphRAG更划算。
资料展示
下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
需要这份AI大模型资料清单的话,在评论区回复「清单」即可;我会根据大家的问题继续补充对应的实战内容。
 331


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


