前端转大模型:页面开发到 AI 产品工程师,从简历表达讲到项目复盘

前端转AI前端一周突击指南:从流式输出到面试实战 随着大模型应用普及,前端开发的岗位要求正在悄然变化,不少企业开始在招聘中强调AI应用开发经验。所谓AI前端,并非单纯指用AI辅助写代码,而是面向对话式界面、Agent工作台等新型产品形态,掌握流式数据传输、高频状态更新、复杂异步交互等工程能力。其中,SSE与WebSocket是实现大模型流式输出的关键协议,而虚拟列表、Web Worker等性能优化手段则直接关系到AI应用的用户体验。本文从这些通用技术概念出发,结合2026年企业实际招聘需求,梳理前端开发者转型AI前端所需的核心能力、高频面试题及简历包装方法 阅读详情

聊《前端转大模型:页面开发到 AI 产品工程师,从简历表达讲到项目复盘》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。

摘要

这篇面向想进入 AI 应用方向的前端开发者,但不会把“前端转大模型:页面开发到 AI 产品工程师,从简历表达讲到项目复盘”写成概念清单。我会按产品化视角的实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从初学者转型路线切入,重点写学习顺序和误区”展开,换一组场景和例子来讲。

目录

  • 前端的转型优势
  • AI 应用交互模式
  • 流式输出
  • 多模态体验
  • 作品集方向
  • 总结

前端的转型优势

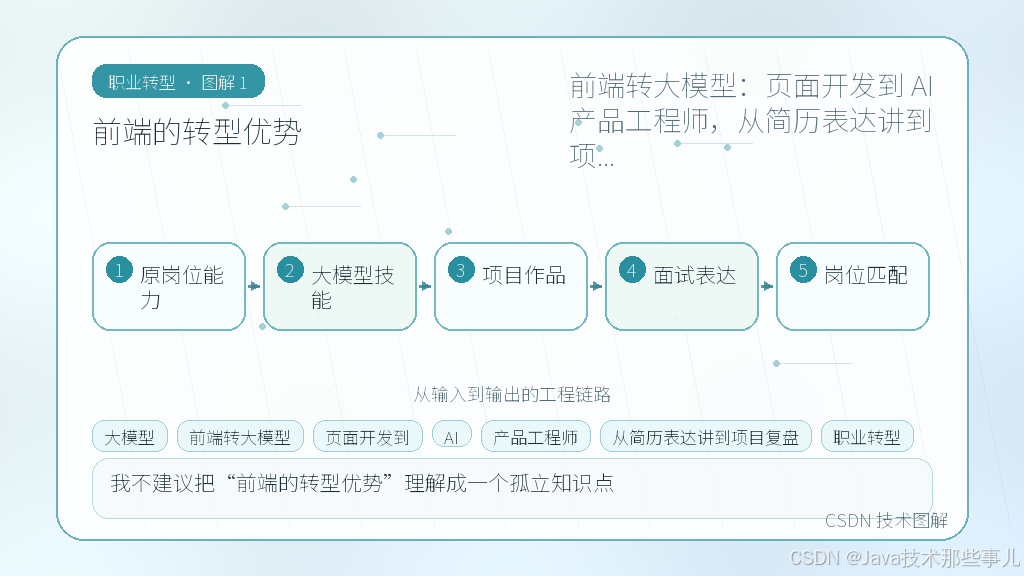
文章插图 1

我不建议把“前端的转型优势”理解成一个孤立知识点。它更像是“前端转大模型:页面开发到 AI 产品工程师,从简历表达讲到项目复盘”里的一段连接层:前面接需求,后面接实现,中间全是取舍。

实际开发时,我会先保留最朴素的版本,哪怕代码看起来没那么漂亮。等需求稳定、调用频率上来,再去做抽象。过早设计通常不是专业,很多时候只是给自己增加维护成本。

检查这部分有没有做好,可以看三个信号:别人能不能接手,线上出错能不能定位,需求变化时要不要大面积重写。

这一版我会把视角放在“从初学者转型路线切入,重点写学习顺序和误区”,所以这里更关注具体场景,而不是把同一套定义再复述一遍。

AI 应用交互模式
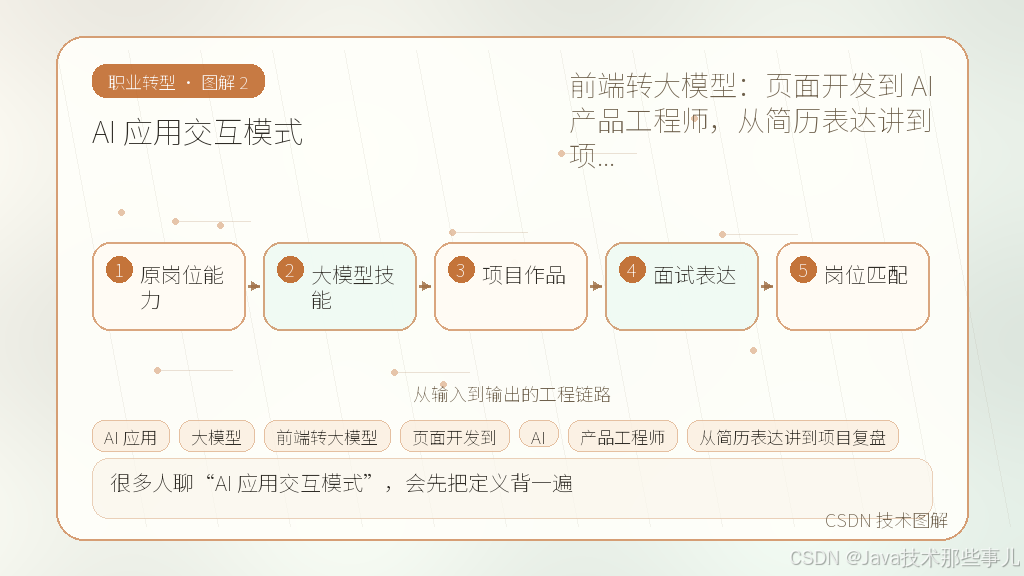
文章插图 2

很多人聊“AI 应用交互模式”,会先把定义背一遍。我的看法稍微不一样:从项目经验看,它必须能解释“前端转大模型:页面开发到 AI 产品工程师,从简历表达讲到项目复盘”里一个具体问题,否则就只是好听的词。

拿一个小项目来说,先别急着把框架、平台和插件全接上。我更愿意先画清楚输入是什么、输出给谁看、失败了怎么回滚。这三件事弄明白,后面的代码通常不会散。

这里最容易踩的坑,是把临时方案包装成通用架构。如果只是一次性脚本,就保持直白;如果要长期复用,再抽接口、加日志、补测试。

这一版我会把视角放在“从初学者转型路线切入,重点写学习顺序和误区”,所以这里更关注具体场景,而不是把同一套定义再复述一遍。

from collections.abc import Callable

def trace_call(name: str) -> Callable:
    def decorator(func: Callable) -> Callable:
        def wrapper(*args, **kwargs):
            print(f"start {name}")
            result = func(*args, **kwargs)
            print(f"finish {name}")
            return result
        return wrapper
    return decorator

@trace_call("calculate")
def calculate_score(values: list[int]) -> int:
    return sum(value * 2 for value in values)
优快云资料领取方式

流式输出

“流式输出”这块不适合只看教程截图。真正有用的学习方式,是把“前端转大模型:页面开发到 AI 产品工程师,从简历表达讲到项目复盘”拆成一个可以演示的小流程。

比如先做一个最小版本:一份输入数据,一个处理函数,一个可见结果。跑通以后再考虑缓存、权限、监控和异常处理。这样推进慢一点,但每一步都能留下证据。

如果你准备把它写进简历,也别只写“熟悉”。最好能说清楚你解决了什么问题、用了什么取舍、最后效果怎么验证。

这一版我会把视角放在“从初学者转型路线切入,重点写学习顺序和误区”,所以这里更关注具体场景,而不是把同一套定义再复述一遍。

在复杂度估算中,可以把一次批处理抽象为:

$$T(n)=O(n)+O(k)$$

其中 n 表示输入规模,k 表示固定的框架调度成本。这个表达式提醒我们,优化时既要关注算法,也要关注运行时环境。

多模态体验

我不建议把“多模态体验”理解成一个孤立知识点。它更像是“前端转大模型:页面开发到 AI 产品工程师,从简历表达讲到项目复盘”里的一段连接层:前面接需求,后面接实现,中间全是取舍。

实际开发时,我会先保留最朴素的版本,哪怕代码看起来没那么漂亮。等需求稳定、调用频率上来,再去做抽象。过早设计通常不是专业,很多时候只是给自己增加维护成本。

检查这部分有没有做好,可以看三个信号:别人能不能接手,线上出错能不能定位,需求变化时要不要大面积重写。

这一版我会把视角放在“从初学者转型路线切入,重点写学习顺序和误区”,所以这里更关注具体场景,而不是把同一套定义再复述一遍。

作品集方向

很多人聊“作品集方向”,会先把定义背一遍。我的看法稍微不一样:从项目经验看,它必须能解释“前端转大模型:页面开发到 AI 产品工程师,从简历表达讲到项目复盘”里一个具体问题,否则就只是好听的词。

拿一个小项目来说,先别急着把框架、平台和插件全接上。我更愿意先画清楚输入是什么、输出给谁看、失败了怎么回滚。这三件事弄明白,后面的代码通常不会散。

这里最容易踩的坑,是把临时方案包装成通用架构。如果只是一次性脚本,就保持直白;如果要长期复用,再抽接口、加日志、补测试。

这一版我会把视角放在“从初学者转型路线切入,重点写学习顺序和误区”,所以这里更关注具体场景,而不是把同一套定义再复述一遍。

总结

回到“前端转大模型:页面开发到 AI 产品工程师,从简历表达讲到项目复盘”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。能跑起来的小项目、说得清楚的技术取舍、能展示的结果,比泛泛而谈更有说服力。后面真做的时候,可以先挑一个小场景验证,再把代码、笔记和复盘整理成自己的作品集。

资料展示

下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
AI大模型资料展示 1

AI大模型资料展示 2

AI大模型资料展示 3

AI大模型资料展示 4

AI大模型资料展示 5

如果你想看完整资料目录,可以在评论区留言「资料」;也欢迎告诉我你更关注AI大模型里的哪类内容。
优快云官方大礼包

AI前端面试冲刺:从大模型接入到流式输出的实战指南 大模型技术正在重塑前端开发范式,AI前端工程师成为企业争抢的稀缺岗位。传统八股背诵已无法应对面试,如今考察的是开发者能否将大模型能力转化为产品价值。核心在于理解REST到SSE的工程化封装、流式输出的性能与状态管理、AI工具链的合理运用。概念上,前端与大模型交互依赖HTTP流式传输;原理上,SSE提供低延迟单向推送,适合对话场景;技术价值在于提升用户体验与开发效率;应用场景包括AI对话助手、内容生成工具等。本文将围绕AI前端面试高频考点,拆解API接入、交互设计、项目实战与冲刺计划,帮助开发者系统掌握新时代 阅读详情

相关推荐

前端开发者转型AI前端:7天突击路线与实战指南

大模型应用开发浪潮下,前端工程师需要掌握新的交互范式。流式渲染配合SSE协议,实现对话式AI的逐字输出体验,成为AI前端的技术基石。动态表单生成与Prompt工程将生成能力转换为可用的业务界面,而向量数据库检索支撑起知识库问答等典型场景。以一名业务前端转型AI前端的完整路径为例,梳理了7天突击路线、工程化补丁、面试要点与简历包装,为希望把握AI应用机遇的开发者提供可操作的实战参考。

weixin_34327223的博客 380

前端转大模型:页面开发到 AI 产品工程师,把学习路线落到项目证据

这篇面向想进入 AI 应用方向的前端开发者,但不会把“前端转大模型:页面开发到 AI 产品工程师,把学习路线落到项目证据”写成概念清单。我会按产品化视角的实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从初学者转型路线切入,重点写学习顺序和误区”展开,换一组场景和例子来讲。回到“前端转大模型:页面开发到 AI 产品工程师,把学习路线落到项目证据”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。

2601_96189255的博客 175

SPAD 单光子雪崩二极管

SPAD,全称为,是一种高灵敏度的光电探测器件,能够在非常低的光照水平下检测单个光子。SPAD在工作时,当一个光子被探测器吸收后,能够触发一个雪崩效应,产生一个可以被检测到的电信号。

qq_42786033的博客 1万+

前端转大模型:页面开发到 AI 产品工程师,把工具链跑成稳定流程

这篇面向想进入 AI 应用方向的前端开发者,但不会把“前端转大模型:页面开发到 AI 产品工程师,把工具链跑成稳定流程”写成概念清单。我会按产品化视角的实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从一次真实项目复盘切入,重点写取舍和踩坑”展开,换一组场景和例子来讲。回到“前端转大模型:页面开发到 AI 产品工程师,把工具链跑成稳定流程”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。

资料免费分享,点击名片 244

NFT图片批量合成及稀有度计算工具

一、制作背景 -当前NFT作品制作的大多方式都是使用部件拼接的形式,然后从大量的可能性结果取优; 二、解决问题 拼接合成的组合数量十分巨大,手工合成费时费力; 合成中对各个部件的使用次数不容易控制,部位出现的概率对作品的稀有度及评分影响较大; 对于生成的作品各个部位的信息(包括来源和使用率)统计繁琐,不利于对作品的介绍中体现; 三、程序功能介绍 1、功能自定义部位稀有度批量合成NFT作品 步骤一:创建各个合成部件文件夹,将图片放到文件夹内 步骤二:软件上设置各个部件对于的图片文件夹及出现的概率 步骤二

Keeping111的博客 4638

联想拯救者r7000p在ubuntu20.04未找到wifi适配器,安装rtl8852ae网卡驱动问题解决方案

新买的拯救者r7000p 2021款,装完ubuntu20.04之后显示未找到wifi适配器, 更换N次源之后还是只有一个显卡驱动,在网上找了很多方法,再自己折腾了一段时间后,总算是解决了这个问题。 1.设置bios 打开主板系统,将security boot设置为disenable,因为设计到修改内核配置,必须得关掉安全启动。 2.查询网卡状态 使用命令查询网卡(hardware of Internet)状态 lshw -C network 因为是双系统,在Windows下控制面板-设备管理器中可以

MCZ777的博客 1万+

前端转大模型:页面开发到 AI 产品工程师,用排错清单压住复杂度

这篇面向想进入 AI 应用方向的前端开发者,但不会把“前端转大模型:页面开发到 AI 产品工程师,用排错清单压住复杂度”写成概念清单。我会按产品化视角的实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从一次真实项目复盘切入,重点写取舍和踩坑”展开,换一组场景和例子来讲。回到“前端转大模型:页面开发到 AI 产品工程师,用排错清单压住复杂度”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。

2601_96285276的博客 224

VASP计算层错能(SFE)全攻略2

本文介绍了使用VASP计算纯镍(Ni)层错能(SFE)的具体步骤。首先构建Ni的FCC单胞并扩展为超胞,通过修改原子位置引入堆垛层错;随后分别计算完美晶体和含层错结构的能量;最后通过能量差与层错面积之比求得SFE值。计算需注意k点网格、截断能和超胞尺寸的收敛性测试,并推荐使用PAW赝势和ASE等工具辅助结构构建。

weixin_50519490的博客 1990

前端转大模型:页面开发到 AI 产品工程师,从岗位要求反推能力栈

这篇面向想进入 AI 应用方向的前端开发者,但不会把“前端转大模型:页面开发到 AI 产品工程师,从岗位要求反推能力栈”写成概念清单。我会按产品化视角的实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从线上问题排查切入,重点写风险、监控和回滚”展开,换一组场景和例子来讲。回到“前端转大模型:页面开发到 AI 产品工程师,从岗位要求反推能力栈”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。

m0_62051288的博客 203

PCA9698嵌入式C++驱动库:高性能I²C GPIO扩展方案

GPIO扩展是嵌入式系统中解决MCU引脚资源不足的关键技术,其核心原理在于通过串行总线(如I²C)桥接主控与外设寄存器,实现逻辑引脚到物理IO的映射与状态同步。技术价值体现在低开销、高确定性与多设备可扩展性,广泛应用于工业控制、传感器节点和LED矩阵驱动等实时场景。本文聚焦PCA9698——一款支持24通道双向IO、中断输出与可编程驱动模式的I²C GPIO扩展芯片,结合其C++驱动库的影子寄存器机制、端口级原子操作及非阻塞同步设计,提供面向资源受限平台(如ATmega2560)的工程就绪方案。

weixin_35756637的博客 628

win11禁止更新,草履虫教程

本文介绍了彻底禁止Windows 11系统更新的组合方法,包括禁用核心服务、修改注册表、关闭计划任务和使用组策略(专业版适用)。作者特别提醒,禁止更新会影响系统安全性,建议实体机保持更新,仅虚拟机等特殊情况下使用这些方法。同时强调即使禁用更新,也应定期手动检查重要安全补丁。文章最后附上了作者的个人网站信息。

testwzc1的博客 562

7天转战AI前端:从普通前端到AI应用工程师的实战路径

大模型能力的爆发正在重塑前端开发者的职业边界,企业不再满足于“写页面”的传统技能,而是更青睐能用AI重构业务交互的复合型人才。理解大模型的基本原理(如流式输出、Token限制、幻觉现象)是AI前端的技术基石,而Prompt工程则成为控制模型行为的关键手段,通过角色设定、输出约束等技巧,开发者可以将模型输出稳定地嵌入产品逻辑。在此基础上,AI Agent的落地(如工具调用、决策规划)进一步拓展了前端的能力半径,让页面具备感知、判断与执行的能力。这些技术最终服务于AI搜索、智能PPT生成、文档助手等真实场景,其

weixin_34127717的博客 326

DeepSeek赋能公文写作指南(一)

DeepSeek 的出现,为公文写作领域带来了新的曙光。作为先进的人工智能技术,DeepSeek 以其强大的语言理解与生成能力,能为公文写作提供全方位的支持。它可以快速梳理思路,提供丰富的素材参考,辅助优化语言表达,甚至能根据不同的公文类型和场景,生成极具价值的内容框架。《DeepSeek 赋能公文写作指南》正是基于此背景应运而生。本书旨在帮助公文写作者深入了解并充分利用 DeepSeek 这一强大工具,将其融入到公文写作的各个流程中。

通俗易懂学IT 5486

前端转大模型:代码实践里的关键取舍

这篇面向想进入 AI 应用方向的前端开发者,但不会把“前端转大模型:代码实践里的关键取舍”写成概念清单。我会按产品化视角的实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从一次真实项目复盘切入,重点写取舍和踩坑”展开,换一组场景和例子来讲。回到“前端转大模型:代码实践里的关键取舍”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。能跑起来的小项目、说得清楚的技术取舍、能展示的结果,比泛泛而谈更有说服力。

资料免费分享,点击名片 256

解密Whisper模型与Speaker Diarization的结合

本文介绍了如何将Whisper语音识别模型与Speaker Diarization(说话人分割)技术相结合,实现多人对话场景下的语音转录和说话人识别。文章详细讲解了技术背景、环境配置和代码实现方法,通过Pyannote进行说话人分割,结合Whisper进行语音转文本,最终输出包含说话人信息的完整转录结果。该解决方案适用于会议记录、访谈分析等场景,显著提升了语音处理的应用价值。

2501_90323865的博客 152

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

前端转大模型:团队协作中的使用边界

这篇面向想进入 AI 应用方向的前端开发者,但不会把“前端转大模型:团队协作中的使用边界”写成概念清单。我会按产品化视角的实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从一次真实项目复盘切入,重点写取舍和踩坑”展开,换一组场景和例子来讲。回到“前端转大模型:团队协作中的使用边界”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。能跑起来的小项目、说得清楚的技术取舍、能展示的结果,比泛泛而谈更有说服力。

2601_96189255的博客 189

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

全栈工程师转型大模型AI:6个月实战路线与关键技能

在人工智能技术加速落地的今天,大模型应用开发已成为企业数字化转型的核心赛道。全栈工程师凭借扎实的工程能力,正好契合这一领域对“模型落地”而非“算法研究”的迫切需求。理解RAG、LoRA、模型量化与本地部署等关键技术原理,能够帮助开发者快速构建知识库问答、智能客服等AI原生应用。本地部署大模型的过程涉及环境配置、性能优化、服务封装等多个工程环节,这些正是全栈工程师的既有优势。通过项目驱动式学习,从调用API到微调模型,再到推理优化与产品化包装,一套系统化的转型路径能够最大化复用原有技能。本文梳理了全栈工程师转

weixin_29057163的博客 216

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

AI应用开发前端一面:从八股到流式与RAG的深度拆解

随着人工智能应用深入业务,前端不再只是页面渲染,更需要承接大模型能力落地。在大模型接口调用中,SSE流式返回与中断控制(如AbortController)是保证对话体验的关键;而RAG架构则让前端在知识库管理、引用溯源中承担重要角色。理解这些原理,能帮助前端工程师在AI应用开发中做出更合理的工程决策,例如用Web Worker处理大文件解析、用Vue3响应式设计交互状态。本文结合得物AI应用开发前端一面真题,拆解JavaScript闭包、异步机制、框架原理、性能优化等高频考点,梳理从基础八股到AI工程化场景

weixin_26945061的博客 341

从通用AI工程转前端开发:避免知识错配,补足FDE核心技能

当通用AI工程课程教的是大模型原理、RAG、Agent和提示词工程,而前端开发工程师(FDE)岗位要求的是盒模型、事件冒泡、布局调试等确定性技能时,两者之间形成了一道认知鸿沟。AI工程面对的是概率空间,追求模型输出的可用性;FDE面对的是浏览器这个确定性环境,必须交付可预期、可维护的界面体验。通用AI知识并非无用,在AI产品的前端实现中,流式输出、工具调用编排、幻觉兜底都需要前端感知模型行为来设计状态与交互。但若投递FDE岗,HTML/CSS/JavaScript手写能力、工程化流程和调试经验才是基本盘。从

weixin_29009501的博客 229

2024前端社招复盘:从面试流程到高频考点全解析

前端面试的本质,是对工程师综合能力的系统性检验。从浏览器渲染原理、事件循环到框架设计思想,每一个基础知识点背后都对应着真实业务场景中的技术决策。随着微前端、低代码、AI辅助开发等工程实践普及,面试官越来越关注候选人在复杂环境下解决问题的能力,而不仅是API调用熟练度。理解这些原理,能帮助开发者构建更深层的技术判断力,在性能优化、架构设计、跨端协作等场景中做出更优选择。这份基于作者亲身经历的复盘,完整梳理了2024年社招行情、面试流程、高频考点与避坑策略,为准备跳槽或蓄力2026求职季的前端工程师提供清晰的方

weixin_34072637的博客 415

DeepSeek+豆包组合拳:AI辅助简历优化的完整实操指南

大语言模型正在改变传统文档创作的流程,尤其在求职场景中,如何利用AI将零散的工作经历转化为结构化、有说服力的表达,成为许多人的刚需。其核心原理在于:通过长文本推理与逻辑拆解,将模糊素材重构为符合STAR法则的描述,再借助自然语言生成技术完成可视化排版与润色,实现内容与形式的双重优化。这类技术组合不仅减少了重复劳动,更让简历从“岗位职责罗列”升级为“JD关键词精准回应”,显著提升面试邀约率。在跳槽、校招、转行等高频场景中,使用DeepSeek拆解JD关键词、量化项目成果,再用豆包生成适合A4打印的HTML简历

weixin_34197488的博客 387

AI Layer如何重构求职申请流程:从简历生成到数据闭环

大模型技术的普及让AI生成文本变得极为容易,但真实的求职场景远不止“写一份简历”那么简单。从岗位发现、JD解析、匹配诊断、材料定制、投递管理到复盘反馈,每一环都分散在不同平台和工具中。由此催生的“AI Layer”思路,是在现有招聘生态之上构建一层智能中间件:先用信息抽取与自然语言处理将非结构化简历和职位描述结构化,再通过差异诊断指导内容生成,最终用版本管理与流程追踪形成可复用的求职工作流。其技术价值不仅在于提升书写效率,更在于把一次性申请行为转变成可沉淀、可回流的数据闭环,帮助求职者基于历史反馈持续优化简

weixin_33908217的博客 454

为了找工作,码士集团 AI 大模型面试突击班效果实测

本文实测码士 AI 大模型面试突击班,聚焦大厂高频面试题与 RAG 项目实战。通过场景解题、算法精讲及独家 Offer 通关攻略,帮助开发者系统掌握大模型应用开发技能,快速补齐技术短板,提升求职竞争力。

LLM_9528的博客 278

2026年前端AI面试工具深度横评:6款产品实测 + 4维选型指南

本文专为前端开发者(校招应届生、社招 1-5 年工程师)撰写,解决"AI面试工具太多不知道怎么选"的痛点。基于自建的四维测评标尺,实测 2026 年主流 AI 面试工具(鹅来面 OfferGoose、牛客、Interviewing.io、豆包等),覆盖*实时辅助提词*、*模拟面试与复盘*、*多场景适配*、*性价比*四大维度,提供可落地的选型方案和组合策略。

SJ_HP的博客 143

Web 版翻译者资料库

本项目是桌面版《翻译者资料库》的 Web 移植版,基于 Spring Boot 3.3、Thymeleaf、Bootstrap 5.3 与 MySQL 8.0 构建。它面向翻译写作提供资料、词汇、句库、文本工具、对照制作、查找、备份恢复及旧库迁移等功能,完整继承桌面版核心业务规则,支持一键启动与离线访问。

howard2005的专栏 150
上一篇: 程序员就业:把核心能力写进作品集
下一篇: Codex 实战:AI 编程助手接入真实项目,从问题拆解到交付验证
Java技术那些事儿
博客等级 码龄5年 2306粉丝 2584原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值