编译原理:RL/0文法的词法分析器

编译原理——基于LR(1)的语法检查器(一) 前言  该项目是我在学习编译原理的时候所完成的一个项目,不同于成熟的yacc语法分析器,我的语法检查器通过和一个词法分析器相互配合,启动之前读入由BNF范式和正则表达式所描述的文法与词法,之后根据给定的文法对给出的代码文件进行检查,并指出文件中的错误。整个文法的解析以LR(1)为基础,总共的代码量为800左右(不包括词法分析器),完整的代码请移步Configurable-syntactic-anal 阅读详情

词法分析的核心在于,将文法转换为NFA再转换为DFA,根据DFA识别出单词的种别码。

下面给出RL/0文法的词汇表:
1.基本字:
begin, call, const, do, end,if, odd, procedure, read,then, var, while, write
对应的种别码:
beginsym, callsym, constsym, dosym, endsym,ifsym, oddsym, proceduresym, readsym,thensym, varsym, whilesym, writesym

2.标识符对应的种别码:ident

3.常数对应的种别码:number

4.运算符:
+, -, *, /, odd,=, <>, <, <=, >, >=, :=
对应的种别码:
plus, minus, times, slash,oddsym,eql, neq, lss, leq, gtr, geq,becomes

5.界符
( ) , ;.
对应的种别码:
Lapren,raplen,comma,semicolon,period

下面是简易的定义,注重过程,不在具体问题上纠结。
标识符对应的正规式为:(a|…|z)星(0|…|9)星 (暂时不考虑下划线)
而常数对应的正规式为:(1|…|9)(0|…|9)* (只考虑无符号的整数)

可以画出NFA
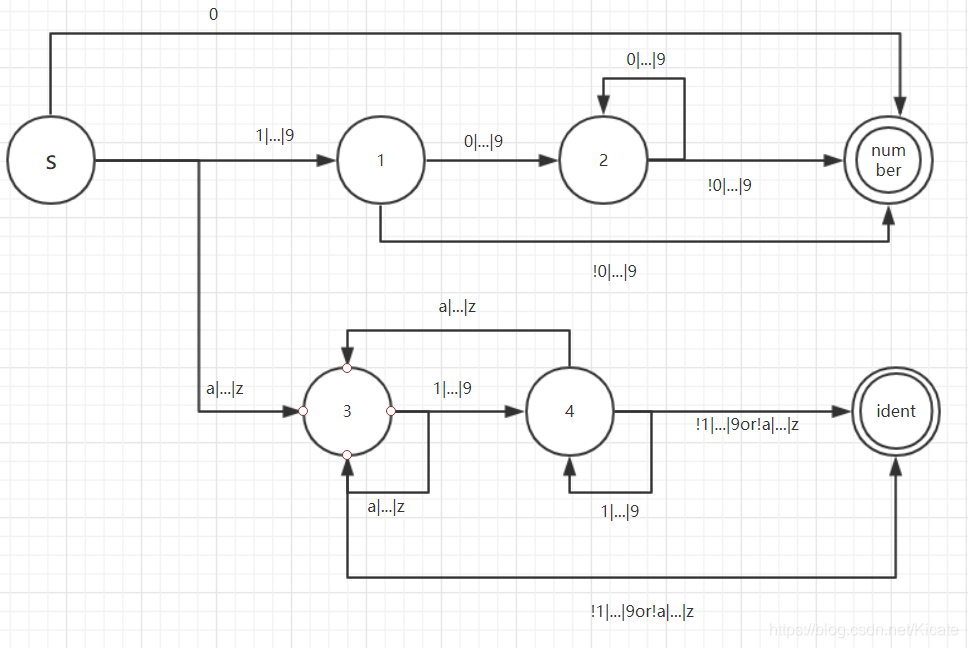
在这里插入图片描述
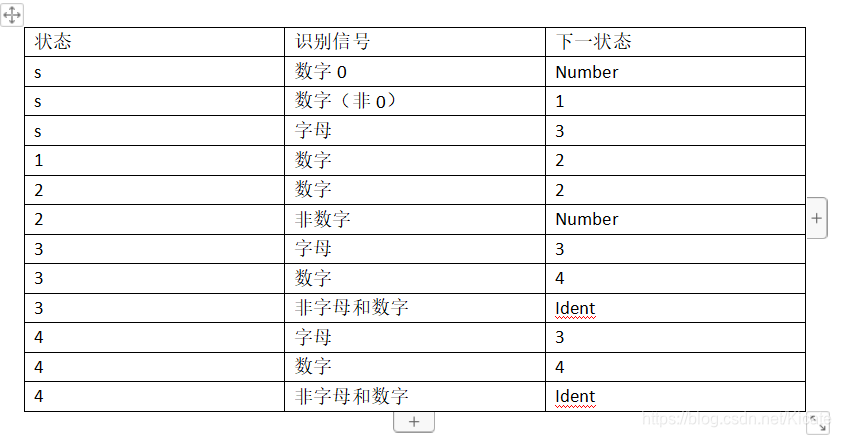
由于很接近dfa,直接给出状态转换表:

在这里插入图片描述
据此可以完成编码。

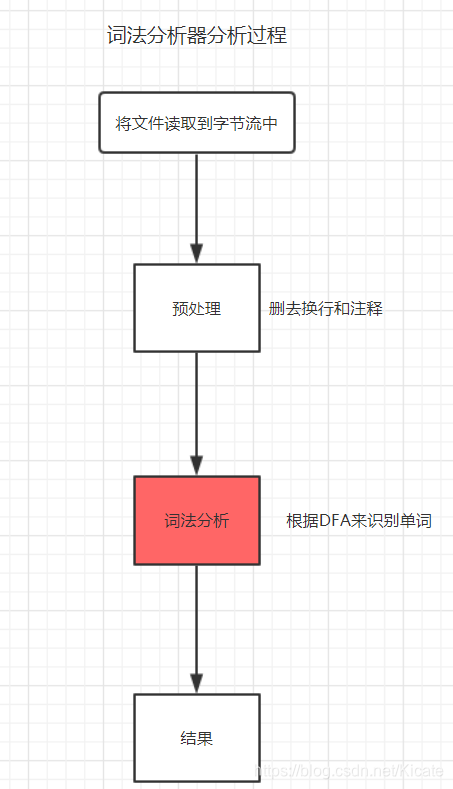
词法分析流程图:
在这里插入图片描述
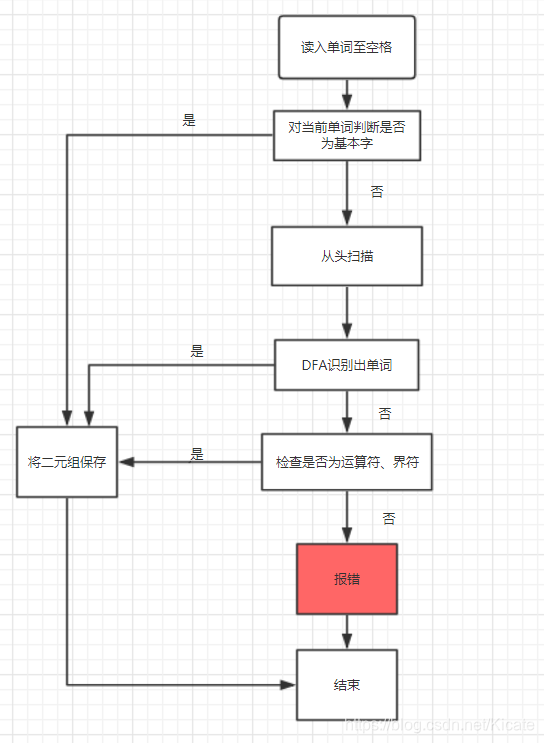
词法分析程序:
在这里插入图片描述
据此就可以编写程序:

public class Main {
    //主程序
	public static void main(String[] args) {
		Scanner sc=new Scanner(System.in); 
		StringBuffer sb=new StringBuffer(sc.nextLine());
		while(sc.hasNextLine()) {
			String s=sc.nextLine();
			if(s.isEmpty()) break;
			else  sb.append(s+" ");
		}	
		//词法分析返回二元组
		sb=new la().g(sb);
		System.out.println(sb);
	}

}
public class la {
	Map<String,String> map=new HashMap<String, String>();
	StringBuffer tF=new StringBuffer();
	private void sw() {
		map.put("begin","beginsym");
		map.put("call","callsym");
		map.put("const","constsym");
		map.put("do","dosym");
		map.put("end","endsym");
		map.put("if","ifsym");
		map.put("odd","oddsym");
		map.put("procedure","proceduresym");
		map.put("read","readsym");
		map.put("then","thensym");
		map.put("var","varsym");
		map.put("while","whilesym");
		map.put("write","writesym");
		map.put("read","readsym");
		map.put("+","plus");
		map.put("-","minus");
		map.put("*","times");
		map.put("/","slash");
		map.put("=","eql");
		map.put("<>","neq");
		map.put("<","lss");
		map.put("<=","leq");
		map.put(">","neq");
		map.put("<=","gtr");
		map.put("<=","geq");
		map.put(":=","becomes");
		map.put("(","lparen");
		map.put(")","rparen");
		map.put(",","comma");
		map.put(";","semicolon");
		map.put(".","period");
		
	}
	public la() {
		// TODO Auto-generated constructor stub
		sw();
	}
	public int getBlank(String a)
	{
		for(int i=0;i<a.length();i++)
		{
			if(a.charAt(i)==' ') return i;
		}
		return a.length();
	}
	public int dfa(int p,String a)
	{
		int l=p;
		//l扫描指针
		int flag=0; //状态
		while(true)
		{
			if(l>=a.length())
			{
				if(flag==5||flag==1||flag==2)
				{
					tF.append("(");
					tF.append("number");
					tF.append(",");
					tF.append(a.substring(p,l));
					tF.append(")");
					tF.append("\r\n");
				}
				else if(flag==6||flag==3||flag==4)
				{
					if(map.containsKey(a.substring(p,l))) //识别为标准字
					{
						tF.append("(");
						tF.append(map.get(a.substring(p,l)));
						tF.append(",");
						tF.append(a.substring(p,l));
						tF.append(")");
						tF.append("\r\n");
						break;
					}
					else {
					tF.append("(");
					tF.append("ident");
					tF.append(",");
					tF.append(a.substring(p,l));
					tF.append(")");
					tF.append("\r\n");
					break;
					}
				}
				else
				{
					
				}
				break;
			}
			if(flag==5)
			{
				tF.append("(");
				tF.append("number");
				tF.append(",");
				tF.append(a.substring(p,l));
				tF.append(")");
				tF.append("\r\n");
				break;
			}
			else if(flag==6)
			{
				if(map.containsKey(a.substring(p,l))) //识别为标准字
				{
					tF.append("(");
					tF.append(map.get(a.substring(p,l)));
					tF.append(",");
					tF.append(a.substring(p,l));
					tF.append(")");
					tF.append("\r\n");
					break;
				}
				else {
				tF.append("(");
				tF.append("ident");
				tF.append(",");
				tF.append(a.substring(p,l));
				tF.append(")");
				tF.append("\r\n");
				break;
				}
			}
			else if(flag==0)
			{
				char x=a.charAt(l);
				if(x=='0') flag=5;
				else if(x<='9'&&x>='1')
				{
					flag=1;
					l++;
				}
				else if(x<='z'&&x>='a')
				{
					flag=3;
					l++;
				}
				else
				{
					break;
				}
			}
			else if(flag==1||flag==2)
			{
				char x=a.charAt(l);
				if(x<='9'&&x>='0')
				{
					flag=2;
					l++;
				}
				else
				{
					flag=5;
				}	
			}
			else if(flag==3||flag==4)
			{
				char x=a.charAt(l);
				if(x<='z'&&x>='a')
				{
					flag=3;
					l++;
				}
				else if(x<='9'&&x>='0')
				{
					flag=4;
					l++;
				}
				else
				{
					flag=6;
				}
			}
			
		}
		return l;
	}
	public int jy(int l,String a)
	{
		//System.out.println("66666:"+l);
		String s=Character.toString(a.charAt(l));
		//System.out.println(s);
		if(s.equals("<")&&l<a.length()-1)
		{
			if(a.charAt(l+1)=='>'||a.charAt(l+1)=='=')
				s=s+Character.toString(a.charAt(l+1));
			l++;
		}
		else if(s.equals(">")&&l<a.length()-1)
		{
			if(a.charAt(l+1)=='=')
				s=s+Character.toString(a.charAt(l+1));
			l++;
		}
		else if(s.equals(":")&&l<a.length()-1)
		{
			//System.out.println("7777777");
			if(a.charAt(l+1)=='=')
			{
				s=s+Character.toString(a.charAt(l+1));
				//System.out.println(s);
			l++;
			}
		}
		if(map.containsKey(s))
		{
			tF.append("(");
			tF.append(map.get(s));
			tF.append(",");
			tF.append(s);
			tF.append(")");
			tF.append("\r\n");
			l++;
		}
		return l;
	}
	public void LL(String a)
	{
		if(map.containsKey(a)) //识别为标准字
		{
			tF.append("(");
			tF.append(map.get(a));
			tF.append(",");
			tF.append(a);
			tF.append(")");
			tF.append("\r\n");
		}
		else {
			int l=0; //扫描指针
			int o=l;
			int r=a.length();
			while(true)
			{
				//dfa识别
				l=dfa(l,a);
				//System.out.println("l="+l+"r="+r);
				if(l>=r) break;
				l=jy(l,a);
				//System.out.println("l="+l);
				if(l>=r) break;
				if(o==l) {
					System.out.println("Error!");
					break;
				}
				o=l;
			}
		}
	}
	public StringBuffer g(StringBuffer a)
	{
		String s=new String(a);
		while(true)
		{
			//获得空格前的字符串
			int k=getBlank(s); 
			//System.out.println(k);
			//System.out.println(s.length()-1);
			String ps=s.substring(0, k);
			//如果读取到最后,则退出循环
			//进入词法判断
			//System.out.println(ps);
			LL(ps);
			if(k>=s.length()-1) break;
			s=s.substring(k+1);
		}
		return tF;
	}

}
1、世界级模拟电路设计指南 本文详细探讨了模拟电路设计的各个方面,从基础概念到实际应用,涵盖了元件选择、滤波器设计、反馈系统、噪声问题以及SPICE仿真的优缺点。文中还提供了设计实例和无计算机设计方法,旨在帮助工程师提升模拟电路设计的效率与可靠性。 阅读详情

相关推荐

Veeam Backup Replication Console 13 备份 PVE

本文介绍了如何通过Veeam Backup & Replication控制台配置与Proxmox VE(PVE)服务器的连接,包括主机地址、用户名密码和SSH信任设置。随后详细说明了部署备份Worker虚拟机的步骤,涵盖网络配置和VM创建。接着指导用户创建PVE虚拟机备份任务,包括命名、选择备份对象、存储位置、备份类型设置,以及配置备份计划任务。最后描述了备份测试执行过程,从启动备份到完成状态通知的完整流程。整个操作涉及服务器连接、Worker部署、备份配置和任务执行四个主要环节。

极致,细节 1604

词法分析程序

printf("错误: %s\n", msg);symbol sym;// 当前读到的单词的类别。// 存放最新读到的字符。// 判断是否为保留字。// 其他保留字判断略。// 运算符和界符的识别代码略。// 识别标识符或保留字。// 定义枚举类型表示单词种别。// 识别运算符和界符。// 从标准输入读取。// 读取下一个字符。// 词法分析主程序。// 读取下一个字符。

m0_73975228的博客 379

Anchor graph 对齐文献解读

Align then Fusion: Generalized Large-scale Multi-view Clustering with Anchor Matching Correspondences文献解读

atease0001的博客 1165

编译原理 实验1 PL/0语言词法分析

PL/0语言词法分析 一、 实验目的 通过完成词法分析程序,了解词法分析的过程。编制一个读单词程序,对PL/0语言进行词法分析,把输入的字符串形式的源程序分割成一个个单词符号,即基本保留字、标识符、常数、运算符、界符五大类。 二、 实验环境 操作系统:window xp 编写环境:visual c++ 、c-free、turbo c 编写语言:c语言 分析语言:PL/0 三、 实验

嗯。 1万+

Zabbix安装与部署 系统环境:centos7.0

Zabbix安装与部署 系统环境:centos7.0

weixin_42485027的博客 2600

【32】OpenCV——图像含义关系?RGGB , BGGR , GRBG , GBRG呢?raw8,raw10,raw12,raw14呢? YUV422; RAW16呢?YCbYCr/RG_GB;

‌如前所述,定义原始数据的位深精度。‌* ‌一种压缩色彩编码方式,通过色度抽样(亮度Y全分辨率,色度U/V半分辨率)减少数据量,常用于视频传输。‌* ‌可能指每个像素分量占16位存储(如高位填充的RAW10/12/14),或未明确量化的高精度原始数据。‌ ‌分类‌核心定义‌关联性及典型应用传感器原始色彩排列(RGGB/BGGR等)决定RAW数据的色彩分布规则RAW位深每个分量的数据精度(8/10/12/14位)影响动态范围和存储空间‌YUV422。

程序员,他们想的是什么?他们想的永远都是技术,他们崇尚的也永远都是技术。 794

编译原理--编译过程中的词法分析--简述

在预编译之后 生成的纯粹源代码文件 从左向右读取源程序的每一个字符 形成一个字符流 作为编译阶段的输入文件 编译阶段: 词法分析:–&gt;从输入流中识别各个单词 、确定单词类型、将识别出的单词类型转换为统一的机内表示 这个表示被称为词法单元(token) 词法单元token是一个 二元组: token&lt;种别码,属性值&gt; 在机器编译的过程中 有一张表 记录了 字符组成的种种可能 为...

qq_41325777的博客 2307

PCB板Gerber文件的理解和制作

Gerber文件是PCB生产的关键文件,主要包括:1)走线层(GTL/GBL);2)阻焊层(GTS/GBS);3)丝印层(GTO/GBO);4)板框层(GMx/GKO);5)钢网层(Gtp/GBp);6)钻孔文件(NCdrillFiles)。其中1-10项和15项钻孔文件必须提供,建议包含11-14项辅助钻孔层。Gerber文件不含过孔属性,需提前在AD中设置过孔盖油。导出步骤包括:导出非机械层、机械层和钻孔层,新版AD可通过"文件->制造输出->GerberFiles"操作

qq_37999850的博客 853

编译原理笔记17:自下而上语法分析(4)LR(0)、SLR(1) 分析表的构造

编译原理

VengaZ的学习博客 7377

视觉提示学习(Prompt Learning):CV领域的GPT时刻?

视觉提示学习(Prompt Learning):CV领域的GPT时刻? ,人工智能,计算机视觉,大模型,AI,在人工智能技术不断演进的今天,计算机视觉(Computer Vision,CV)作为人工智能领域的重要分支,始终致力于让机器 “看懂” 世界。从早期基于传统特征工程的图像识别方法,到深度学习时代卷积神经网络(Convolutional Neural Networks,CNN)的崛起,CV 领域经历了多次重大变革。

不踩坑,不知道坑有多深;不总结,踩过的坑白踩。 4万+

【四足机器人项目实战】四足机器人腿部机械结构设计

系列文章目录 提示:这里可以添加系列文章的所有文章的目录,目录需要自己手动添加 TODO:写完再整理 文章目录系列文章目录前言 前言 认知有限,望大家多多包涵,有什么问题也希望能够与大家多交流,共同成长! 本文先对四足机器人–腿部机械结构设计做个简单的介绍,具体内容后续再更,其他模块可以参考去我其他文章 提示:以下是本篇文章正文内容 为了减轻腿部惯量,使用有限元分析着重进行轻量化设计,小腿采用工字梁方案,大腿采用内部镂方案,并使用1.5 mm的AL 6061硬质材料,轻量化的腿部设了腿部运动时摆动

qq_35635374的博客 7539

RL分析器

import java.util.ArrayList;//lshimport java.util.Scanner;/** *题目:LR1分析过程模拟 *说明: * 首先要说句,这程序没有花大量的时间写,稍微写了下吧,能运行,兼容中间插入空格 * 无特殊功能,就只能判断一个语句是否符合给定文法和显示LR(1)分析过程 *要求: * 本程序按照如下文法设计: *

xihaxinku123的专栏 602

【C++】开源:cpp-httplib HTTP协议库配置与使用

cpp-httplib HTTP协议库配置与使用

DevFrank的博客 5542

笔记 | 编译原理L2:词法分析(lexical analysis)

词法分析(lexical analysis),也称scanning, 编译程序的第一阶段,其作用是识别单词(程序意义上)并找出词法错误. 读入源程序的输入字符、将它们拆分成词素,生成并输出一个词法单元序列,每个词法单元对应于一个词素回顾词法分析在整个编译过程的位置![[【笔记】编译原理L1#^53d248| 回顾编译原理的各个模块顺序]]作用:沟通,交流,传递信息自然语言:英语,中文,日语无限的集合字符组成了单词;单词组成了句子;句子携带了信息语言是形式化的内容提取——

Tancilon的博客 8042

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

【编译原理】LR1程序文法的java实现【有firstfollow集,action和goto表,LR1分析过程】

一个能用的LR1文法: S' -> <程序> <程序> -> <声明列表>|<程序> <函数> <声明列表> -> <声明>|<声明列表> <声明> <声明> -> include < <标识符> > ; <函数> -&...

清凌的博客 6008

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

编译原理-语法分析(基础)

文章目录概念概览表推导和规约Chomsky 0型文法: 短语文法或无限制文法Chomsky 1型文法: 长度增加文法/上下文有关文法)Chomsky 2型文法: content-free grammer(CFG )下推自动机(PDA)Chomsky 3型文法:正则文法 (FSG)语法分析器解析树(Parsing Tree),即语法分析树(syntax analysis tree)子问题从起始符通过...

qq_41956860的博客 1940

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

基于LL1文法的语法分析

一、目标本次实验的目的是对编译器进行词法分析的过程进行模拟,我选择了在实际中更为通用的自底向上的词法分析器的分析过程,最终产生规约序列。对于LR(0)和LR(1)问题,我的程序对于LR(0)和LR(1)是通用的,因为只要给出合法的parsing table和上下文无关文法, 程序就能进行相应的词法分析,而parsing table和文法都是用户输入文件给出...

854

保研面试/考研复试编译原理问题整理

1. 编译器/编译程序 把计算机高级语言 (源语言)编写的程序(源程序)翻译成该计算机的汇编语言或机器语言(目标语言)书写的程序(目标程序)的计算机程序称为编译器(或编译程序)。 2. 图灵机 1) 什么是图灵机 图灵机(英语:Turing machine),又称确定型图灵机,是一种将人的计算行为抽象化的数学逻辑机,其更抽象的意义为一种计算模型,可以看作等价于任何有限逻辑数学过程的终极强大逻辑机器。 所谓的图灵机就是指一个抽象的机器,它有一条无限长的纸带,纸带分成了一个一个的小方格,每个方格有不

weixin_43595277的博客 4747

计算机保研专业课必备之编译原理

吐血整理全网最全保研专业课必备之编译原理

ylx的博客 599

有穷自动机的最小化c语言代码,程序语言基础

1编译原理1.1Lex Yacclex:提取语言中各种保留字、操作符等语言的元素。yacc:语法分析器lex和yacc能帮助我们做事情是:用c语言来实现另外一种语言。1.2编译器工作原理 对于编译器的各个阶段,在逻辑上可以把它们划分为前端和后端两部分.前端包括从词法分析到中间代码生成各阶段的工作,后端包括中间代码优化和目标代码的生成、优化等。这样以中间代码为分水岭,把编译器分成了与机器有关的部分和...

weixin_39984578的博客 824

LR(0)文法分析(通过例题穿插讲解)

LR(0)文法分析,加上一个简单的例子来进行分析,每一步过程都有的,非常详细。

weixin_57165154的博客 2万+

二叉平衡树平衡方法(RR、LL、RL、LR)

二叉平衡树的平衡方法 (RR、LL、RL、LR) 1、RR型 右单旋 右右型:插入节点在不平衡因子节点右子树的右边 右单旋:向左旋转 2、LL型 左单旋 左左型:插入节点在不平衡因子节点的左子树的左边 左单旋:向右旋转 3、RL型 右左双旋 右左型:插入节点在不平衡因子节点的右子树的左边 右左双旋:先以不平衡因子的右子树为支点进行右旋,再以不平衡因子节点为支点进行左旋 4、LR型 左右双旋 左右型:插入节点在不平衡因子节点的左子树的右边 左右双旋:先以不平衡因子的左子树为支点进行左旋,

榴莲男孩的博客 4553

pl/0词法分析器实验代码

pl0实验

m0_61973596的博客 1033

PL0扩展一维数组array

PL0语言数组变量类型文法可定义为: Var <数组变量名> ’(‘<下界>,<上界>’)’ 其中<下界>,<上界>是常量名或无符号数 引用格式可为:C(1),c(a),C(a+b),C(b+C(1)) 头文件修改: 1、增加冒号符号(增加colon,symnum+1) /* 符号 */ enum symbol { ...

ItaLink 5879

【编译原理】自上而下分析与LL文法

语法分析是编译原理的核心部分,这一点从语法分析在编译原理教科书中所占的篇幅可见一斑,不论是陈火旺老师的《编译原理》还是Ullman等人的“龙书”。语法分析的任务是在词法分析识别出单词符号串的基础上分析并判定程序的语法结构是否符合语法规则。例如词法分析识别出a是一个合法的变量名,那么语法分析目的就是判定a=a+5这样的句子是否合法。

Esperanto.的博客 2472

学习使用的PL/0编译器增强版PL/0plusplusCompiler(一)源码及使用

一个计算机科学家做的C语言实现的一个比较简单的学习研究用的编译器,PL/0 Compiler。正在学习编译原理,所以自己修改一下。 这个编译器只有两个文件。PL0.c、PL0.h/*PL/0 编译系统C版本头文件 pl0.h*/typedef enum{ false,true }bool; # define norw 13 /*关键字个数*/ # defin

珍惜时间 3684
上一篇: acm刷题记录 (2020.4.2)
下一篇: acm刷题记录(2020.4.4)
不见冬
博客等级 码龄7年 3粉丝 12原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值