


本文深入浅出地探讨了OpenCV库在图像处理和深度学习中的应用。从基本概念和操作,到复杂的图像变换和深度学习模型的使用,文章以详尽的代码和解释,带领大家步入OpenCV的实战世界。
1. OpenCV简介
什么是OpenCV?
OpenCV(Open Source Computer Vision Library)是一个开源的计算机视觉和机器学习软件库。它由一系列的C函数和少量C++类构成,同时提供Python、Java和MATLAB等语言的接口,实现了图像处理和计算机视觉方面的很多通用算法。
# 导入OpenCV库
import cv2

# 打印OpenCV版本
print(cv2.__version__)
输出:
4.5.2
OpenCV的设计目标是提供一套简单而且可扩展的计算机视觉库,使得它能够方便地在实际的应用、研究、开发中被使用。
OpenCV的历史与发展
OpenCV的起源可以追溯到1999年,当时在英特尔公司由一群热情的研发工程师开始进行开发。2000年,OpenCV以开源的方式发布,旨在推动计算机视觉的发展并帮助更多人应用这一技术。自此之后,OpenCV已经不断发展,增加了大量新的功能,并已成为全球最流行的计算机视觉库之一。
OpenCV的应用领域
OpenCV具有极广的应用领域,它包括但不限于:
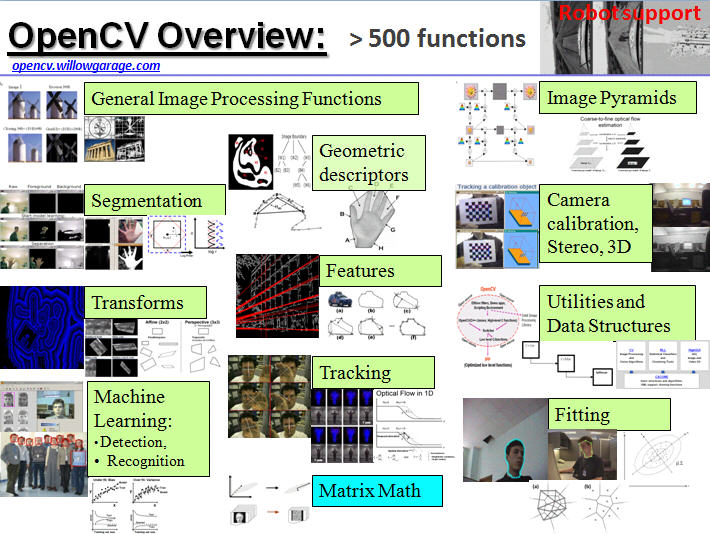
- 人脸识别和物体识别:这是OpenCV的一项重要功能,应用在许多领域,如安全监控、交互设计等。
- 图像和视频分析:如图像增强、图像分割、视频跟踪等。
- 图像合成和3D重建:在图像处理和计算机视觉领域,OpenCV可以用于创建AR或VR效果,生成3D模型等。
- 机器学习:OpenCV内置了大量的机器学习算法,可以用于图像分类、聚类等任务。
- 深度学习:OpenCV中的dnn模块提供了一系列深度学习模型的接口,用户可以加载预训练模型进行图像识别、目标检测等任务。
# 例如,以下代码展示了如何使用OpenCV进行图像读取和显示
import cv2

# 读取一张图像
img = cv2.imread('image.jpg')

# 显示图像
cv2.imshow('image', img)
cv2.waitKey(0)
cv2.destroyAllWindows()
综上,OpenCV凭借其强大的功能、开源的优势以及广泛的应用领域,成为了学者和工业界的重要工具。
2. OpenCV的安装与配置
OpenCV的安装方式根据不同的操作系统和使用环境有所不同。以下我们将分别介绍在Windows、Linux和Mac OS下的安装方式,以及如何配置Python环境使用OpenCV。
OpenCV在Windows系统下的安装
在Windows系统下,推荐使用Python的包管理工具pip来安装OpenCV。你可以在命令行中运行以下命令来安装:
pip install opencv-python
如果你需要使用到OpenCV的额外模块(如xfeatures2d等),可以安装opencv-contrib-python包:
pip install opencv-contrib-python
OpenCV在Linux系统下的安装
在Linux系统下,我们同样可以使用pip来安装OpenCV。打开终端,运行以下命令:
pip install opencv-python
同样,如果你需要使用到OpenCV的额外模块,可以安装opencv-contrib-python包:
pip install opencv-contrib-python
OpenCV在Mac OS系统下的安装
在Mac OS下,我们同样可以使用pip来安装OpenCV。打开终端,运行以下命令:
pip install opencv-python
如果你需要使用到OpenCV的额外模块,可以安装opencv-contrib-python包:
pip install opencv-contrib-python
配置Python环境使用OpenCV
安装完成OpenCV后,我们可以在Python环境中导入cv2模块来使用OpenCV的功能。你可以创建一个新的Python脚本,然后在其中输入以下代码来测试OpenCV是否安装成功:
import cv2

# 打印OpenCV版本
print(cv2.__version__)
如果输出了你所安装的OpenCV版本号,那么恭喜你,你已经成功安装并配置好了OpenCV!
总的来说,无论是在Windows、Linux还是Mac OS系统下,安装和使用OpenCV都是相对简单的。只需要几个简单的命令,就可以开始你的OpenCV之旅了。
想要系统学习OpenCV库,涵盖图像处理、特征提取(边缘、轮廓、角点)、多尺度分析等核心技术,为后续深度学习模型提供关键预处理与后处理工具。
遇到问题,无人指导,需要进行学习规划的都可扫下方

3. OpenCV基础
在此部分,我们将介绍一些OpenCV的基础知识,包括图像的载入、显示和保存,以及图像的基本操作和色彩空间的转换。
图像的载入、显示和保存
在OpenCV中,我们通常使用imread()函数来载入一张图像,使用imshow()函数来显示一张图像,使用imwrite()函数来保存一张图像。
以下是一个示例:
import cv2

# 载入一张图像
img = cv2.imread('image.jpg')

# 显示图像
cv2.imshow('image', img)
cv2.waitKey(0)
cv2.destroyAllWindows()

# 保存图像
cv2.imwrite('new_image.jpg', img)
图像的基础操作
OpenCV提供了一系列的函数来进行图像的基础操作,包括但不限于:
- 获取和修改像素值
- 获取图像的基本属性(如大小、通道数、像素数等)
- 设置图像的ROI(Region of Interest)
- 拆分和合并图像通道
# 获取和修改像素值
px = img[100,100]
print(px)

# 修改像素值
img[100,100] = [255,255,255]
print(img[100,100])

# 获取图像属性
print(img.shape)
print(img.size)
print(img.dtype)

# 设置ROI
roi = img[100:200, 100:200]

# 拆分和合并图像通道
b,g,r = cv2.split(img)
img = cv2.merge((b,g,r))
图像色彩空间的转换
OpenCV提供了200+种颜色空间的转换方法,但是我们最常用的还是RGB<->Gray和RGB<->HSV的转换。
我们可以使用
cv2.cvtColor()函数来进行颜色空间的转换,如下例:# 转换为灰度图像 gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY) # 转换为HSV图像 hsv = cv2.cvtColor(img, cv2.COLOR_BGR2HSV)这是OpenCV基础操作的简单介绍,这些操作是我们在进行更高级的图像处理之前需要掌握的基础知识。
4. 图像处理与计算机视觉基础
在计算机视觉中,图像处理是一个关键的环节,它包括图像阈值化、边缘检测、图像滤波、图像形态学操作和图像二值化等操作。下面我们将一一介绍。

图像阈值化
图像阈值化是将图像从灰度转换为二值化图像的过程,OpenCV提供了
cv2.threshold()函数来进行这项操作。import cv2 import numpy as np # 载入图像并转为灰度图 img = cv2.imread('image.jpg',0) # 阈值化处理 ret,thresh1 = cv2.threshold(img,127,255,cv2.THRESH_BINARY) # 显示处理结果 cv2.imshow('threshold',thresh1) cv2.waitKey(0) cv2.destroyAllWindows()边缘检测
边缘检测是计算机视觉中的常见任务,它可以用来识别图像中的物体。Canny边缘检测是一种常用的边缘检测算法,OpenCV中可以使用
cv2.Canny()函数来进行Canny边缘检测。import cv2 import numpy as np # 载入图像 img = cv2.imread('image.jpg',0) # 进行Canny边缘检测 edges = cv2.Canny(img,100,200) # 显示处理结果 cv2.imshow('edges',edges) cv2.waitKey(0) cv2.destroyAllWindows()图像滤波
图像滤波是计算机视觉中常见的图像预处理方法,OpenCV提供了各种滤波函数,如
cv2.filter2D()、cv2.blur()、cv2.GaussianBlur()等。import cv2 import numpy as np # 载入图像 img = cv2.imread('image.jpg') # 使用高斯滤波进行图像平滑处理 blur = cv2.GaussianBlur(img,(5,5),0) # 显示处理结果 cv2.imshow('blur',blur) cv2.waitKey(0) cv2.destroyAllWindows()图像形态学操作
形态学操作是基于图像形状的一系列操作,包括腐蚀、膨胀、开运算和闭运算等。OpenCV提供了
cv2.erode()、cv2.dilate()、cv2.morphologyEx()等函数来进行形态学操作。import cv2 import numpy as np # 载入图像 img = cv2.imread('image.jpg',0) # 创建一个5x5的结构元素 kernel = np.ones((5,5),np.uint8) # 进行膨胀操作 dilation = cv2.dilate(img,kernel,iterations = 1) # 显示处理结果 cv2.imshow('dilation',dilation) cv2.waitKey(0) cv2.destroyAllWindows()图像二值化
二值化是将图像处理为只有两个颜色的过程,也就是将图像处理为黑白两色。二值化后的图像对于很多图像处理任务(如边缘检测、物体识别等)有很大的帮助,OpenCV中可以使用
cv2.threshold()函数来进行二值化操作。import cv2 import numpy as np # 载入图像 img = cv2.imread('image.jpg',0) # 进行二值化操作 ret,thresh1 = cv2.threshold(img,127,255,cv2.THRESH_BINARY) # 显示处理结果 cv2.imshow('binary',thresh1) cv2.waitKey(0) cv2.destroyAllWindows()以上是图像处理与计算机视觉的基础知识,掌握这些知识,就可以进行更复杂的图像处理任务了。
5. OpenCV实战案例

人脸检测
首先,我们来实现一个简单的人脸检测程序。这个程序可以读取一个图像,然后使用预训练的Haar级联分类器检测图像中的人脸。
import cv2

# 加载预训练的人脸级联分类器
face_cascade = cv2.CascadeClassifier('haarcascade_frontalface_default.xml')

# 读取图像
img = cv2.imread('face.jpg')

# 将图像转换为灰度图
gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)

# 使用级联分类器检测人脸
faces = face_cascade.detectMultiScale(gray, scaleFactor=1.1, minNeighbors=5, minSize=(30, 30))

# 为每个检测到的人脸绘制一个矩形
for (x, y, w, h) in faces:
    cv2.rectangle(img, (x, y), (x+w, y+h), (0, 255, 0), 2)

# 显示结果
cv2.imshow('Faces found', img)
cv2.waitKey(0)
实时人脸检测
接下来,我们来实现一个实时的人脸检测程序。这个程序可以实时地从摄像头捕获视频,并检测视频中的人脸。
import cv2

# 加载预训练的人脸级联分类器
face_cascade = cv2.CascadeClassifier('haarcascade_frontalface_default.xml')

# 打开摄像头
cap = cv2.VideoCapture(0)

while True:
    # 读取一帧
    ret, frame = cap.read()

    # 将帧转换为灰度图
    gray = cv2.cvtColor(frame, cv2.COLOR_BGR2GRAY)

    # 使用级联分类器检测人脸
    faces = face_cascade.detectMultiScale(gray, scaleFactor=1.1, minNeighbors=5, minSize=(30, 30))

    # 为每个检测到的人脸绘制一个矩形
    for (x, y, w, h) in faces:
        cv2.rectangle(frame, (x, y), (x+w, y+h), (0, 255, 0), 2)

    # 显示结果
    cv2.imshow('Faces found', frame)

    # 按'q'退出循环
    if cv2.waitKey(1) & 0xFF == ord('q'):
        break

# 释放摄像头
cap.release()

# 关闭所有窗口
cv2.destroyAllWindows()
目标跟踪
接下来的实战案例是使用MeanShift算法进行目标跟踪。我们将从视频中选择一个目标,然后在后续的帧中跟踪这个目标。
import cv2
import numpy as np

# 打开摄像头
cap = cv2.VideoCapture(0)

# 读取第一帧
ret, frame = cap.read()

# 设置初始的窗口位置
r, h, c, w = 240, 100, 400, 160
track_window = (c, r, w, h)

# 设置初始的ROI用于跟踪
roi = frame[r:r+h, c:c+w]
hsv_roi = cv2.cvtColor(frame, cv2.COLOR_BGR2HSV)
mask = cv2.inRange(hsv_roi, np.array((0., 60., 32.)), np.array((180., 255., 255.)))
roi_hist = cv2.calcHist([hsv_roi], [0], mask, [180], [0, 180])
cv2.normalize(roi_hist, roi_hist, 0, 255, cv2.NORM_MINMAX)

# 设置终止条件,迭代10次或者至少移动1次
term_crit = (cv2.TERM_CRITERIA_EPS | cv2.TERM_CRITERIA_COUNT, 10, 1)

while(True):
    ret, frame = cap.read()

    if ret == True:
        hsv = cv2.cvtColor(frame, cv2.COLOR_BGR2HSV)
        dst = cv2.calcBackProject([hsv], [0], roi_hist, [0, 180], 1)

        # 使用MeanShift算法找到新的位置
        ret, track_window = cv2.meanShift(dst, track_window, term_crit)

        # 在图像上画出新的窗口位置
        x, y, w, h = track_window
        img2 = cv2.rectangle(frame, (x, y), (x+w, y+h), 255, 2)
        cv2.imshow('img2', img2)

        if cv2.waitKey(1) & 0xFF == ord('q'):
            break
    else:
        break

cap.release()
cv2.destroyAllWindows()
边缘检测
边缘检测是图像处理中的重要步骤,它可以帮助我们从图像中识别出物体的轮廓。下面的实战案例是使用Canny算法进行边缘检测。
import cv2
import numpy as np

# 读取图像
img = cv2.imread('road.jpg', 0)

# 使用Canny算法进行边缘检测
edges = cv2.Canny(img, 50, 150)

# 显示原图和边缘检测结果
cv2.imshow('Original Image', img)
cv2.imshow('Edge Image', edges)

cv2.waitKey(0)
cv2.destroyAllWindows()
图像拼接
图像拼接是将两个或多个图像在一定的几何和光度条件下拼接在一起,形成一个包含了所有输入图像视场的大视场图像。以下实战案例将展示如何使用OpenCV进行图像拼接。
import cv2
import numpy as np

# 读取两个图像
img1 = cv2.imread('road1.jpg')
img2 = cv2.imread('road2.jpg')

# 将两个图像拼接成一个图像
stitcher = cv2.Stitcher.create()
result, pano = stitcher.stitch([img1, img2])

if result == cv2.Stitcher_OK:
    cv2.imshow('Panorama', pano)
    cv2.waitKey()
    cv2.destroyAllWindows()
else:
    print("Error during stitching.")
6. 深度学习与OpenCV
OpenCV库不仅提供了大量的基本图像处理函数,还为深度学习领域提供了强大的支持。它可以用来加载预训练的模型,并使用这些模型进行图像分类、对象检测、图像分割等任务。下面我们将通过一些实战案例来深入了解OpenCV如何应用在深度学习中。
加载预训练模型
首先,我们将学习如何加载一个预训练的模型。我们将使用OpenCV中的DNN模块,该模块支持多种深度学习框架,包括TensorFlow、Caffe等。
import cv2

# 加载预训练的模型
net = cv2.dnn.readNetFromCaffe('bvlc_googlenet.prototxt', 'bvlc_googlenet.caffemodel')
图像分类
接下来,我们将使用加载的模型进行图像分类。我们将对一个图像进行预处理,然后将其输入到模型中,获取分类结果。
import cv2
import numpy as np

# 加载预训练的模型
net = cv2.dnn.readNetFromCaffe('bvlc_googlenet.prototxt', 'bvlc_googlenet.caffemodel')

# 加载标签名
with open('synset_words.txt', 'r') as f:
    labels = f.read().strip().split("\n")

# 加载图像,并进行预处理
image = cv2.imread('image.jpg')
blob = cv2.dnn.blobFromImage(image, 1, (224, 224), (104, 117, 123))

# 将图像输入到网络中,进行前向传播,得到输出结果
net.setInput(blob)
outputs = net.forward()

# 获取预测结果
class_id = np.argmax(outputs)
label = labels[class_id]

print('Output class:', label)
物体检测
此外,我们还可以使用预训练的模型进行物体检测。我们将使用预训练的YOLO模型来检测图像中的物体。
import cv2
import numpy as np

# 加载预训练的模型
net = cv2.dnn.readNet('yolov3.weights', 'yolov3.cfg')

# 加载图像,并进行预处理
image = cv2.imread('image.jpg')
blob = cv2.dnn.blobFromImage(image, 1/255, (416, 416), swapRB=True, crop=False)

# 将图像输入到网络中,进行前向传播,得到输出结果
net.setInput(blob)
layer_names = net.getLayerNames()
output_layers = [layer_names[i[0] - 1] for i in net.getUnconnectedOutLayers()]
outputs = net.forward(output_layers)

# 处理网络的输出结果
for output in outputs:
    for detection in output:
        scores = detection[5:]
        class_id = np.argmax(scores)
        confidence = scores[class_id]

        if confidence > 0.5:
            # 将检测到的物体在图像上标记出来
            center_x, center_y, w, h = map(int, detection[0:4] * np.array([image.shape[1], image.shape[0], image.shape[1], image.shape[0]]))
            x = center_x - w // 2
            y = center_y - h // 2
            cv2.rectangle(image, (x, y), (x + w, y + h), (0, 255, 0), 2)

cv2.imshow('Image', image)
cv2.waitKey(0)
cv2.destroyAllWindows()
以上就是OpenCV在深度学习中的应用示例,希望这些案例可以帮助你更好地理解如何使用OpenCV进行深度学习任务。
总结与展望
在这篇博客中,我们探讨了如何使用OpenCV进行各种图像处理和深度学习任务。从最基本的图像读取和显示,到复杂的图像变换、图像分割、边缘检测,再到深度学习的图像分类和物体检测,我们都有详细的代码和解释。
OpenCV是一个强大而且易于使用的库,它为图像处理和计算机视觉提供了许多工具。无论你是一名研究者,还是一名开发者,或者只是一个对图像处理和计算机视觉感兴趣的初学者,OpenCV都可以帮助你快速实现你的想法。
未来,OpenCV还将继续发展,加入更多的功能和工具。例如,OpenCV的开发者已经在考虑如何更好地支持3D图像处理和增强现实技术。同时,随着深度学习的发展,OpenCV也将继续提供更好的支持,包括加载更多的预训练模型,以及提供更多的工具来帮助开发者训练自己的模型。
总的来说,OpenCV是图像处理和计算机视觉领域的一个重要工具,无论你是初学者还是专家,都应该熟练掌握这个库。希望这篇博客能对你有所帮助,如果你有任何问题,欢迎随时向我提问。





 895


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


