彻底搞懂深度学习-正则化和归一化

[深度学习] 网络正则化 机器学习的核心问题是如何使学习算法不仅在训练样本上表现良好,而且在新数据上或测试集上同时奏效,学习算法在新数据上的这样一种表现我们称之为模型的泛化能力。如果一个学习算法在训练集表现优异,同时在测试集依然工作良好,可以说该学习算法有较强的泛化能力。若某算法在训练集表现优异,但是测试集却非常糟糕,我们说这样的学习并没有泛化能力,这种现象也叫做过拟合(overfitting)。 如何避免过拟合?我们可... 阅读详情

|架构师带你玩转AI

在深度学习模型训练中,你是否也遇到过这样的困扰:“为什么我的模型在训练集上表现完美,但在测试集上却一塌糊涂?”又或者"为什么我的神经网络训练了几百个epoch还是不收敛?"

深度学习资料+AI学习路线可以上图扫码获取

资料包:一、 人工智能学习路线及大纲

二、计算机视觉OpenCV【视频+书籍】

三、AI基础+ 深度学习 + 机器学习 +NLP+ 机器视觉 教程

四、李飞飞+吴恩达+李宏毅合集

五、自动驾驶+知识图谱等资料

六、人工智能电子书合集【西瓜书、花书等】

七、各阶段AI论文攻略合集【论文带读/代码指导/本硕博/SCI/EI/中文核心】
 

 这背后的原因在于,模型的成功不仅取决于网络架构的设计,更在于训练过程的精细调控。在这个调控过程中,有两个技术占据着举足轻重的地位:正则化与归一化。前者如同智慧的导师,防止模型过度拟合训练数据;后者如同稳定的基石,确保训练过程平稳高效。

 一、正则化(Regularization)

正则化(Regularization)是什么?正则化是一种减少模型过拟合风险的技术。

一个训练过度的模型就像一个只会死记硬背的学生。它不仅掌握了知识的核心要点,还把教材中的每个标点符号、甚至是印刷错误都一并记住了。虽然这样的学生在期末考试(训练集)中能拿满分,但面对新的题目(测试集)时却往往束手无策,因为它缺乏真正的理解和泛化能力。

正则化的目的是通过引入额外的约束或惩罚项来限制模型的复杂度,从而提高模型在未知数据上的泛化能力。

如何实现正则化?正则化是通过重新定义损失函数来实现的。新的损失函数由两部分组成:原始的预测损失和一个正则化项。

正则化通过给损失函数"加料",在原有的预测误差基础上,再添加一个基于模型参数计算得出的惩罚项。这样一来,模型在优化过程中不仅要考虑预测准确性,还要兼顾参数的简洁性。

L1正则化和L2正则化是最主流的两种正则化技术,前者通过引入权重绝对值的约束来产生稀疏权重(许多权重为零),后者则通过权重平方和的惩罚来控制参数规模(保持权重值较小)。无论选择哪种方法,训练过程都遵循同样的原理——通过优化算法不断调整参数以最小化新的损失函数L_new,从而达到正则化的效果。 

1. L1正则化(Lasso)

L1正则化在损失函数L中添加L1正则项,得到新的损失函数L_new = L + λ∑|w_i|,其中λ是正则化系数,w_i是模型参数。

  • 方法:在损失函数中添加模型参数绝对值之和作为惩罚项。

  • 特点:倾向于产生稀疏权重矩阵,即部分特征权重为零,有助于特征选择。

def l1_regularization(model, lambda_l1):
    l1_loss = 0
    for param in model.parameters():
        l1_loss += torch.norm(param, p=1)  # 绝对值之和
    return lambda_l1 * l1_loss

# 训练时修改loss计算
loss = criterion(outputs, labels) + l1_regularization(model, 0.001)

2. L2正则化(Ridge)

L2正则化则在损失函数L中添加L2正则项,得到新的损失函数L_new = L + λ∑w_i^2,其中λ是正则化系数,w_i是模型参数。

  • 方法:在损失函数中添加模型参数平方和作为惩罚项。

  • 特点:倾向于使权重值均匀分布且较小,有助于防止模型过于复杂,减少过拟合。

def l2_regularization(model, lambda_l2):
    l2_reg = torch.tensor(0.0)
    for param in model.parameters():
        l2_reg += torch.norm(param, p=2)  # 平方和
    return lambda_l2 * l2_reg

# 在训练循环中手动添加
loss = criterion(outputs, labels) + l2_regularization(model, 0.001)

二、归一化(Normalization)

归一化(Normalization)是什么?归一化是一种数据预处理技术,目的是将数据分布调整为特定尺度(如均值为0,标准差为1),旨在解决数据分布不一致的问题。

当面对来自不同量纲的特征数据时,归一化能够将它们统一转换到相同的数值范围内,比如标准正态分布(均值0,标准差1)。通过这种统一化处理,可以消除原始数据中不同特征维度间的尺度差异,让神经网络能够更均衡地学习各个特征的重要性。
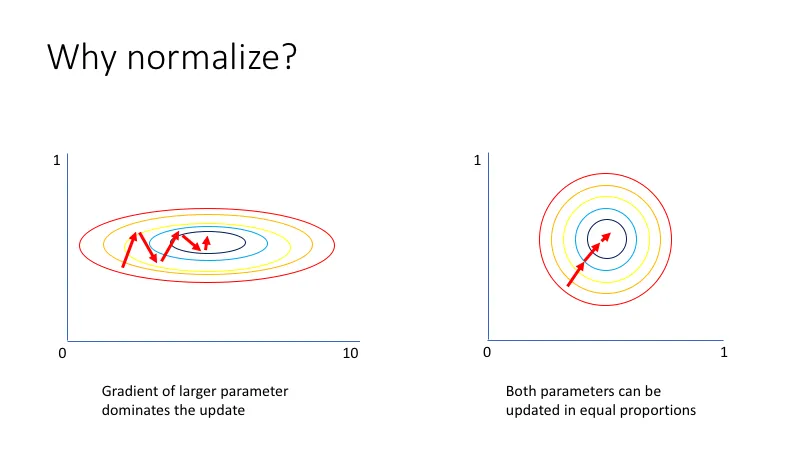
归一化的过程是什么?归一化是通过确定数据的取值范围,应用相应的归一化公式将数据转换到新的稳定尺度,从而得到更加适合后续分析和处理的数据集。

  1. 确定归一化范围:找出数据的最大值和最小值,或根据需要选择均值和标准差等统计量。

  2. 应用归一化公式:使用相应公式将数据转换到新尺度,如线性归一化(映射到[0,1]或[-1,1])或Z-score标准化(转换为标准正态分布)。

  3. 获得归一化数据:经过公式处理后,得到数值更稳定、便于后续分析的标准化数据集。


常用的归一化有哪些?常用的归一化主要包括批量归一化(BN)、层归一化(LN)、实例归一化(IN)和组归一化(GN)等,它们各有其独特的应用场景和优势,选择哪种归一化方法通常取决于具体任务和数据的特点。 

1. 批量归一化(Batch Normalization, BN)--  图像处理首选

  • 方法:在神经网络的每一层中,对每个mini-batch的输入进行归一化处理。通过减去均值,再除以标准差,将输入数据转化为均值为0,标准差为1的分布。

  • 优点:加速网络训练、防止梯度问题、优化正则化效果、降低学习率要求,并有助于缓解过拟合,从而显著提升神经网络的性能和稳定性。

  • 应用场景:适用于大多数神经网络场景,特别是在训练深层网络时。

# 卷积网络标准配置
nn.Sequential(
    nn.Conv2d(3, 64, 3),
    nn.BatchNorm2d(64),  # 批量归一化
    nn.ReLU()
)

2. 层归一化(Layer Normalization, LN)-- Transformer标配

  • 方法:在神经网络的每一层中,对每个样本的所有特征维度进行归一化处理。通过减去均值,再除以标准差,将每个样本的特征维度转化为均值为0,标准差为1的分布。

  • 优点:在训练样本较小、样本间相互影响较大的情况下更稳定。

  • 应用场景:如循环神经网络(RNN)、Transformer等场景。

# Transformer Block结构
class TransformerLayer(nn.Module):
    def __init__(self):
        super().__init__()
        self.ln1 = nn.LayerNorm(512)
        self.ln2 = nn.LayerNorm(512)

3. 实例归一化(Instance Normalization, IN)-- 风格迁移神器

  • 方法:对每个样本的特征维度进行归一化。通过减去均值,再除以标准差,将每个样本的特征维度转化为均值为0,标准差为1的分布。

  • 优点:更适用于图像生成等任务中,每个样本的特征维度独立于其他样本的情况。

  • 应用场景:图像生成任务等。

# 风格迁移网络片段
style_transfer = nn.Sequential(
    nn.Conv2d(3, 128, 3),
    nn.InstanceNorm2d(128),  # 单样本单通道归一化
    nn.AdaptiveAvgPool2d(1)
)

4. 组归一化(Group Normalization, GN)-- 小批量救星

  • 方法:在神经网络的每一层中,将特征分成若干组,对每个组的特征进行归一化处理。通过减去均值,再除以标准差,将每个组的特征维度转化为均值为0,标准差为1的分布。

  • 优点:适用于样本较小、样本间相互影响较大,但又不需要对整个mini-batch进行归一化的情况。

  • 应用场景:图像分割任务等。

# 医学图像分割网络
nn.Sequential(
    nn.Conv2d(64, 128, 3),
    nn.GroupNorm(4, 128),  # 128通道分为4组
    nn.LeakyReLU()
)


 

基于深度学习的量化多因子的归一化问题 基于深度学习的量化策略如何实现归一化?本文首先辨析了归一化、标准化与正则化三个术语,然后分析了min-max, sin, sigmoid等归一化函数在量化中使用时常犯的错误,讲解了如何制作一个好的归一化函数。最后,以一些量化因子归一化示例作为结束。 阅读详情

相关推荐

正则化(Regularization)、归一化(Normalization)、权重初始化等

正则化(Regularization) 解决深度学习中的over-fitting(high variance)问题,有两个solutions,其中之一就是regularization,另外就是more data。 正则化就是在原cost function 中加入正则项 Why regularization can reduces overfitting? 直观上理解就是如果正则化系数λ\lamb...

econe_wei的博客 4311

正则化、归一化含义解析

原文地址 http://sobuhu.com/ml/2012/12/29/normalization-regularization.html 正则化、归一化含义解析 2012-12-29 正则化(Regularization)、归一化(也有称为正规化/标准化,Normalization)是对数据尽心预处理的方式,他们的目的都是为了让数据更便于我们的计算或获得更

bhj5787的专栏 1629

常用归一化/正则化层:InstanceNorm1d、InstanceNorm2d、

批量归一化与实例归一化的最大区别在于计算均值及方差的依据不同,实例归一化是对每个样本沿着通道方向独立对各个通道进行计算,而批量归一化则是对所有样本沿着batch的方向对各个通道分别进行计算。比如:输入特征图形状为:(2,3,256,512),表示有两个256×512的特征图,特征图通道数为3,假设为RGB三个通道依次对样本1,样本2分别计算R、G、B三个通道的均值、方差,每次计算其实是对256×512个元素值记性计算;依据计算出的均值和方差,对各通道的元素实现图中的公式;...

NorthSmile的博客 1万+

正则化和归一化

正则化   正则化其实就是在原来的目标函数的基础上又加了一项非负项, 并且这个非负项是 w 的函数。 这样的话target不变的基础上得让这个loss变得小一点, 相当于对其产生了一种约束。也可以认为正则化是减小权值方差的一种策略,减小权值的取值范围,从而使得模型求解空间变小,不会拟合出复杂的曲线(函数) 文章目录正则化正则化为什么可以抑制过拟合L1和L2正则Dropout1.引入库2.读入数据参考资料 正则化为什么可以抑制过拟合    减小模型参数(权重)大小或者参数的数量, 缓解过拟合。其实是说正则化在

a699669的博客 2717

深度学习笔记——归一化、正则化

本笔记介绍深度学习中常见的归一化、正则化。

haopinglianlian的博客 3486

如何实现chrome谷歌浏览器多开(独立环境 独立cookie)

由于各种各样的原因,你可能需要在一个电脑登录某个平台,比如一个电脑登录3个公众号,或者3个知乎等等。最简单的方案是,直接安装3个不同的浏览器,比如一个谷歌浏览器,一个火狐浏览器,一个 Edge 浏览器。这个方案也能解决,但如果想多开10个呢?安装10个不同的浏览器也能解决,但感觉这样比较复杂,另外一方面安装太多的应用,会导致电脑卡顿。这里给大家介绍,我在 Win 和 Mac 系统下的躲开解决方案。Win 系统下的解决方案最为简单,原理就是给不同的谷歌浏览器,指向不同的用户存储路径即可。

lzqial1987的专栏 1万+

【机器学习】一文搞懂标准化,归一化,正则化

归一化(Normalization): 将一列数据变化到某个固定区间(范围)中, 通常, 这个区间是[0,1],广义的讲, 可以是各种区间, 比如映射到[0,1] 也可以映射到其他范围,在图像中可能会映射到[0, 255], 其他情况也有可能映射到[-1,1];最大值最小值的归一化,范围[0,1]均值归一化(Mean normalization), 范围[-1,1]标准化(Standardization): 将数据变换为均值为0,标准差为1的分布。标准化=Xi−μσ。

一个程序员 9723

mpu6050原理图_STM32控制 MPU6050 六轴陀螺仪资料汇总

一般使用MPU6050的步骤是先驱动I2C总线,然后初始化MPU6050,从MPU6050读取数据,最后是数据的处理。本文档详细介绍有关MPU6050 三维角度传感器电子陀螺仪使用说明。附件内容提供该 MPU6050模块原理图,配套STM32代码,相关数据手册及参考文档。实物连接图:MPU6050 六轴陀螺仪特点:使用芯片:MPU-6050供电电源:3-5v(内部低压差稳压)通信方式:标...

weixin_39911056的博客 4759

一文彻底搞懂深度学习:归一化(Normalization)

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

老皮的博客 1万+

STM32Cubemx+CanFestival:从零到一的CANopen移植实战

本文详细介绍了如何使用STM32CubeMX和CanFestival实现CANopen协议栈的移植,从开发环境搭建到核心配置步骤,再到调试与问题排查。通过实战经验分享,帮助开发者快速掌握STM32与CANopen的结合应用,提升嵌入式系统开发效率。

weixin_42558093的博客 421

OpenBCI脑电数据处理实战:用MNE库从Raw对象到可视化分析全流程

本文提供了使用MNE-Python库处理OpenBCI脑电数据的完整实战指南。从通过BrainFlow库获取原始数据流、创建核心的Raw对象,到进行工频滤波、带通滤波等关键预处理步骤,最后实现时域信号、功率谱密度及地形图等多种专业可视化分析,手把手教你完成脑机接口数据处理的全流程。

gin88的博客 371

一文彻底搞懂深度学习:正则化(Regularization)、归一化(Normalization)

你是否也有这样的困扰?“我的模型在训练集上100分,测试集上却只有60分?”“我的神经网络训练了500轮还是不收敛?别慌!这些问题的根源往往在于两个关键技术:正则化和归一化。正则化就像严格的老师,防止学生死记硬背;归一化则是标准化的教材,让学习更高效。

star_nwe的博客 1938

行车记录仪 - 碰撞检测

功能需求 行车记录仪的核心功能是记录,大部分时候,行车记录仪都是在循环录制视频和音频,而设备的存储空间是有限的,因此录制机制一般是循环覆盖录制,如此一些重要的记录(例如:发生碰撞时的记录)就可能会被覆盖,为了避免这种情况的发生,行车记录仪设备就需要感知这些情况并做特殊处理(例如:备份相应时刻的录像数据)。 实现原理 碰撞检测是通过物理芯片G-sensor来实现的,加速度发生变化时G-sensor驱动会将加速度上报给应用层,应用层做相应处理。 G-sensor G-sensor(Gravity se

qazw9600的专栏 5219

正则化和归一化基础

这种巨大的数值尺度差异,会让学生(模型)感到困惑,难以判断不同知识点的重要性,从而导致学习效率低下、状态不稳。在现代深度学习实践中,正则化和归一化并非二选一,它们分别从模型和数据两个维度出发,相辅相成,共同致力于训练出更快速、更稳定、更强大的深度学习模型。:正则化通过在损失函数中引入一个代表模型复杂度的惩罚项,在“拟合训练数据”和“保持模型简洁”之间寻找一个最佳平衡点,从而有效避免了过拟合。归一化则像一位教学环境设计师,它的核心任务是**解决因数据本身“规格不一”而导致的学习效率低下(训练困难)**问题。

frostmelody 全网同名,大家多多关注呀~ 持续分享优质内容! 1155

LT码与Raptor码的性能仿真

从数据分析看来,在数据块大小较小时(100 - 200 左右 ),LT 码和 Raptor 码的平均冗余符号数量差距相对较小,但 LT 码的冗余符号数量始终高于 Raptor 码。现在采用MATLAB进行仿真,直观展示不同数据块大小下,两种解码方式的解码时间差异.如图4.1所示,LT解码(绿色圆点折线)LT 解码方式的解码时间随数据块大小的变化情况。从实际应用的角度来看,LT码由于其简单的编码机制,适用于资源受限或对编码效率要求较高的场景,但其较高的解码复杂度限制了其在一些实时性要求较高的应用中的使用。

道亦无名 1138

MAX30102心率血氧传感器原理图设计,已量产(e-Health传感器)

在最近的便携健康监测设备项目中,我们采用了集成算法的 MAX30102 心率血氧模块 —— 这类带内置 MCU 算法的传感器能直接输出心率 / 血氧数值,大幅降低了主控资源占用。但硬件电路的稳定性直接决定了 PPG 信号的采集精度,下面结合实际项目里的原理图,拆解下这个模块的设计细节。

不脱发的程序猿 1283

深度学习-正则化和归一化(图文讲解)

模型训练中常见过拟合和收敛问题,可通过正则化和归一化解决。正则化通过添加惩罚项控制模型复杂度,L1正则化产生稀疏权重,L2正则化保持权重均衡。归一化将数据统一到相同尺度,包括批量归一化(图像处理)、层归一化(文本处理)、实例归一化(风格迁移)和组归一化(医学图像)。两者结合能有效提升模型泛化能力和训练效率。

Jigsaw的博客 1037

DICOM图像知识:深入详解DICOM的层级关系

解析DICOM的四个主要层级:Patient(患者)、Study(检查)、Series(序列)和SOP(服务-对象对),探讨它们之间的关系、各自的唯一标识符以及在实际应用中的用途

编程技术探索者,分享C/C++、C#、Java、数据库等开发经验,聚焦实战技巧与AI兴趣,助力编程爱好者成长。 3305

详解归一化、标准化、正则化以及batch normalization

一文详解归一化、标准化、正则化以及batch normalization

PiggyRuns的博客 3015

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

深度学习归一化与正则化

归一化(Normalization) 定义:归一化是指通过某种算法将输入数据或神经网络层的激活值处理后限制在我们需要的特定范围内。它的目的是为了方便后续的数据处理,并加快程序的收敛速度。归一化的主要作用是统一样本的统计分布。在0到1之间的归一化代表的是概率分布,而在其他区间内的归一化则表示的是坐标分布。正则化(Regularization)定义:正则化是指为解决适定性问题或过拟合而加入额外信息的过程。在机器学习和逆问题的优化过程中,正则项往往被加在目标函数当中。

自己在学习过程中的总结 880

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

归一化与正则化

深度学习中的归一化和正则化1. 权重归一化   机器学习的学习过程基于概率和统计学,学习到的知识能用于其它数据的一个基本假设是独立同分布(IID),因此把数据变成同分布是很有必要的。 1. 权重归一化   权重归一化不归一化特征,而是归一化权重。假设卷积核的向量形式是w⃗\vec ww,感受野的向量形式是x⃗\vec xx,偏置为bbb。一个神经元的输出可以表示为: y=ϕ(w⃗⋅x⃗+b).y ...

sinoai 2038

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

深度学习笔记:正则化和批量归一化

特性维度L1正则化 (Lasso)L2正则化 (Ridge)Dropout核心思想"废弃无用特征""平均抑制特征""随机团队协作""稳定内部环境"数学机制在损失函数中增加λ·‖W‖₁在损失函数中增加(λ/2)·‖W‖₂²前向传播时以概率p随机置零神经元对小批量数据标准化:γ·x̂ + β实现方式效果稀疏解:将不重要的权重精确置零,实现特征选择。稠密解:使所有权重均匀地缩小,但不为零。破坏协同适应:防止神经元过度依赖,增强模型鲁棒性。稳定分布:加速收敛;同时引入噪声,起到隐式正则化作用。

GHOSThohoho的博客 872

【深度学习第六期深度学习中的归一化与正则化技术:原理、实践与应用】

本文深入探讨深度学习中批量归一化(BN)、层归一化(LN)、标准化以及正则化等关键技术。详细阐述它们的基本原理,包括如何调整数据分布、控制模型复杂度等;通过丰富的实例和对应代码,展示在不同网络架构中这些技术的具体实现方式,以及对模型训练和性能的影响;同时,对比分析各项技术的特点和适用场景,帮助读者理解在不同任务和数据条件下如何合理选择与应用。本文旨在帮助读者全面掌握这些技术,从而在深度学习项目中优化模型性能、提升泛化能力。

qq_45832651的博客 1178

深度学习:批归一化和层归一化Batch Normalization、Layer Normalization

深度神经网络模型训练难,其中一个重要的现象就是 Internal Covariate Shift. Batch Norm 自 2015 年由Google 提出之后, Layer Norm / Weight Norm / Cosine Norm 等也横空出世。 Normalized的作用 1.1 独立同分布与白化 1.2 深度学习中的 Internal Covariate Sh...

皮皮blog 1万+

深度学习正则化归一化,动图版来了,复杂概念秒变简单!

摘要:本文解析了机器学习的两个关键技术——正则化和归一化。正则化通过L1/L2正则项防止模型过拟合,L1产生稀疏权重,L2保持参数均衡;归一化统一数据尺度,介绍批量、层、实例和组归一化四种方法及其适用场景。文章还提供了大模型学习资源,包含学习路线、视频教程、技术文档和面试题等,助力AI开发者掌握核心技能。

2401_84204413的博客 1224
上一篇: 知识图谱入门:从概念架构到实践应用
下一篇: 我如何用一份模型地图,避开了90%的深度学习坑
大模型星球
博客等级 码龄5年 1132粉丝 239原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

