推荐系统常用的推荐系统算法学习宝典

【主要推荐算法概览,包括召回与排序】 阅读详情

这是小编的其他文章,点击即可阅读 

 人工智能常用的十大算法        知识图谱     人工智能数学基础(四)   人工智能学习路线

人工智能—Python数据科学必备工具包实战入门学习笔记 

一、推荐系统概述和常用评价指标

1.1 推荐系统的特点

在知乎搜了一下推荐系统,果真结果比较少,显得小众一些,然后大家对推荐系统普遍的观点是:

(1)重要性UI>数据>算法,就是推荐系统中一味追求先进的算法算是个误区,通常论文研究类的推荐方法有的带有很多的假设限制,有的考虑工程实现问题较少,推荐系统需要大量的数据整理和转化,同时更需要考虑公司业务特性以及与现有系统的集成,方能形成推荐系统和业务之间的良性循环;

(2)推荐系统离线测试很好,上线后要么没有严格的测试结果而只能凭感觉,要么实际效果差强人意,我想主要缘于离线测试比较理想,而在线AB冠军测试无论对于前端还是后台要求都很高,没有雄厚的研发实力难以实现;

(3)推荐系统受到的外部干扰因素特别多(季节、流行因素等),整个系统需要不断的迭代更新,没有一劳永逸的事情。
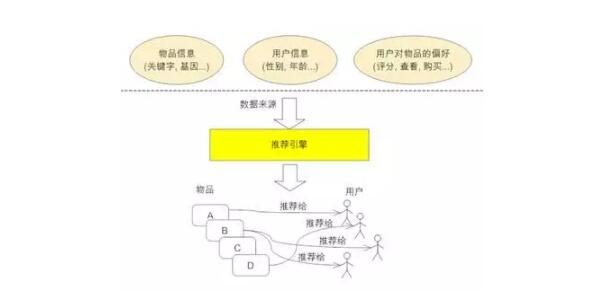
1.2 推荐系统的评价指标

由于推荐系统比较复杂,所以涉及到的评价指标也很多。当然,用户满意度最为的有效,因为这本来就是推荐系统的最终目标,但是奈何资源有限成本太高,推荐系统还依赖于其它客观评价指标。

(1)推荐准确度:这个参数可以离线计算所得,而且较为的客观,所以是各大研究论文算法最重要的参考指标。

总体来说,推荐系统有两大任务:“预测”和“推荐”,所以推荐系统准确度的评分包括:

评分预测:学习用户的评价模型,用于预测用户对于未接触事物的评分,其实可以看作是一个回归模型,一般用均方根误差或者绝对误差来衡量;

TopN推荐:给用户一个个性化的推荐列表,其一般通过准确度、召回率等指标评估。其中N也是一个可变参数,可以根据不同的N描绘出对应算法的ROC曲线来进一步评价推荐效果;

(2)覆盖率:体现了挖掘算法对发掘长尾商品的能力。最简单的定义是,对所有用户推荐出的产品做并集,然后看这个出现的并集产品与总产品数中所占的比例,这种方式比较的粗线条,因为推荐系统中马太效应频繁,所以好的推荐算法应当是所有商品被推荐的几率差不多,都可以找到各自合适的用户,所以实际中会考虑信息熵、基尼系数等指标。

(3)多样性:其原理可以表述为不在一棵树上吊死。因整个推荐系统涉及到的因素太多,如果只推荐用户一个类别的相似物品,失败风险比较的大,而且也难以实现整个推荐效益的最大化。

(4)新颖性:原理就是那些用户没有接触过、没有操作过的商品,或者是流行度比较低的商品,对用户来说是比较新鲜的物品,往往会有意外的效果。个人觉得这个指标有点扯~~

(5)信任度:这个指标比较的主观,就是让用户信任推荐系统做出的推荐是有根据有理由的,以及推荐系统内部是如何运作的。例如亚马逊的商品推荐会给出推荐理由,作为用户的我会觉得很贴心,否则用户会觉得商家的利益驱动而带有抵触心理。

(6)健壮性:比如针对关联推荐算法,商户恶意下单提高产品的推荐频率,水军恶意评论等。

二、静态数据推荐

基本上绝大多数算法都会利用用户-产品的交互数据动态生成个性化的推荐。而静态数据指还没生成用户交互数据的时候,这种情况在系统冷启动的时候尤为的常见,常常使用的静态数据包括:

(1)用户注册时候的性别、年龄、地域、学历、兴趣等人口统计学信息;

(2)授权的社交网络账号的好友信息;

这类基于推荐方法简单,可以根据每类用户预先设置好推送内容,也可以根据同类用户相互之间进行推送,但是这种方法面临着推荐颗粒度较大,对于涉及个人品味爱好的个性化强的商品,参考价值有限,同时在大家隐私意识加强的情况下,这类数据不见得能够轻易得到;第二类社交网络好友信息效果会比较好,但也需要相应的平台授权接入才可以。

然后这里引申出对于新加入的用户和新加入的商品的冷启动问题:

新加入用户:推送热门商品;选择用上面人口统计信息进行粗粒度的推送;如果可以得到合作商数据,获取其好友信息,选择接近的好友进行UserCF推荐;向用户展示一些商品(热们常见、具有代表性和区分性、物品要多样性),得到用户的反馈,然后进行学习(Nadav Golbandi算法);

新加入商品:UserCF对新加入的物品冷启动不是很敏感,因为只要有用户发现这个新商品,这个新商品就会慢慢扩散开来。对于ItemCF就比较严重,比如可以考虑开始使用基于内容的推荐,等积累数据一定程度后切换成协同过滤推荐。

三、基于内容的推荐

其主要根据用户之前的喜好,推荐相似的物品。该系统包括用户属性和产品属性两方面构成,前者包括用户的固有属性(比如人口统计信息)以及用户的历史商品交互信息(比如对看过电影的评分,然后得到该用户对于喜欢电影的属性描述),后者是对商品的本身属性描述,这样通过简单的余弦相似度就可以实现推荐了。同时也能感觉到,对于同类型的物品描述维度相似,这种算法会工作的比较好,对于电商千奇百怪的商品,可能工作效果一般。

这个方法核心要解决的问题是推荐是否具有扩张性,如果根据用户之前的爱好只不断推荐同类的产品,显然整个推荐系统的价值就十分有限,但是如果能准确推荐其他不同类别的商品就会很好了。

Pandora的音乐推荐就是个典型的基于内容的推荐系统,他们把音乐使用各种维度的属性进行描述,然后根据用户之前的兴趣爱好推荐相似属性风格的音乐。

四、协同过滤算法

协同过滤算法算是推荐系统中最经典的算法了,也称为基于领域的算法。协同过滤牵涉到用户和商品的交互信息,也就是用户行为,而一般用户对于商品的行为反馈有:

显性反馈行为——用户明确表现出对某项产品和的喜好,比如用户对商品的打分、评论等信息。

隐性反馈行为——不能明确代表用户对产品喜好的行为,比如页面浏览行为等,这类数据量的比较多,常常伴有大量的噪音,需要经过处理和转化才可能有实际的用途。

4.1 基于用户的协同过滤算法(UserCF)

其基于的假设是——喜欢类似物品的用户可能有相同或者相似的口味和偏好。UserCF实现的步骤包括:

(1)找到与目标用户兴趣相似的用户群;

假设用户u和v的正反馈的商品集合为N(u),N(v),那么两者兴趣相似度可以记为
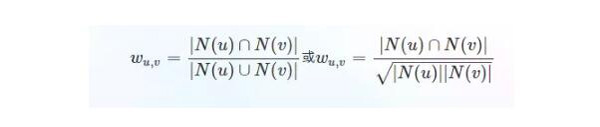
(2)找到这个集合中用户喜欢的,而目标用户没有听说过得商品推荐之;

UserCF提供的一个参数K表示要考虑目标用户兴趣最相似的人的个数,在保证精度的同时,K不宜过大,否则推荐结果会趋向于热门商品,流行度指标和覆盖度指标都会降低。

4.2 基于内容的协同过滤算法(ItemCF)

目前用的最广泛的推荐算法,不是通过商品本身,而是通过用户对商品的行为来计算商品之间的相似度,其假设能够引起用户兴趣的商品,必定与其之前评分高的商品相似。ItemCF的操作步骤包括:

(1)计算商品之间的相似度。

物品相似度可以表示为(其实跟前面的支持度比较像)
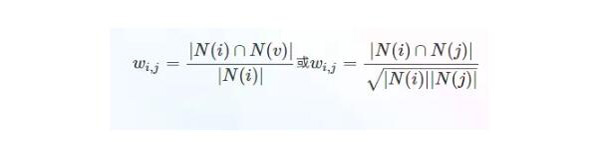
第二个式子比第一个式子好在可以惩罚过热产品j。

(2)根据商品的相似度和用户的历史行为,给用户生成推荐列表。

4.3 基于模型的协同过滤算法

User-CF和Item-CF合称为memory-based CF,而model-based CF使用一般机器学习的方式,其基于样本的用户喜好信息,训练出一个推荐模型,然后根据实时的用户喜好的信息进行预测和计算推荐。

常用的模型包括LSI、贝叶斯网络等。

4.4 UserCF和ItemCF之间的比较

在现实的情况中,往往物品的个数是远远小于用户的数量的,而且物品的个数和相似度相对比较稳定,可以离线完成工作量最大的相似性计算步骤,从而大大降低了在线计算量,基于用户的实时性更好一些。但是具体使用的场景,还需要根据具体的业务类型来区分,User-CF偏重于反应用户小群体热点,更具社会化,而Item-CF在于维持用户的历史兴趣,比如:

对于新闻、阅读类的推荐,新闻阅读类的信息是实时更新的,所以ItemCF在这种情况下需要不断更新,而用户对新闻的个性化推荐不是特别的强烈情况,用户有新行为不会导致相似用户的剧烈运动。

对于电子商务类别的,由于用户消费代价比较高,所以对个性化的精确程度要求也比较高,而一段用户有新的行为,也会导致推荐内容的实时变化

协同过滤的算法缺点也很明显,除了上面的冷启动之外,往往商家的用户数量和产品数量都很多,所以矩阵的计算量会非常的大,但某个具体的用户往往买的东西又有限,所以数据同时也是高度稀疏的。

五、基于标签的推荐方法

基于标签的推荐算法也是十分常见的,比如豆瓣网、京东的商品评论等。标签信息一般分为专家、学者类打的标签;一类为普通用户给商品打的标签(UGC, User Generated Content)。而标签的内容一般要么描述商品本身的,比如名字、类别、产地等,也或者用户对商品的观点评价,比如便宜、好用、性能强等,三元组(用户、物品、标签)通过标签将用户和物品进行联系。

基于标签推荐最简单的例子比如:统计一个用户最常用的标签,统计每个物品最常被打的标签,然后两者通过一定的关系推荐起来;当然也可以展现标签云,让用户点击自己感兴趣的标签,然后依此个性化推荐。

国内的京东、淘宝、豆瓣都大量使用标签信息。

由于标签的评价用户主观性比较强,所以一方面同样意思用户的用语差异性比较大,规范化可以考虑:用户评价的时候提供常用标签,让用户点击可以减少输入差异,而推荐的标签包括该物品描述性较好的标签,以及用户自己常用的标签(用户一致性);人为或者通过自然语言处理技术对标签进行整理,对于用户积极和消极的评价进行区分;标签也有长尾分布效应,所以除了热门标签外怎么提取那些差异化的有用标签进行更精确的推荐也是应当研究的课题(卡方分布/SVD)。


免费领取以下资料可以加我们助教小姐姐的威信 

①10G教学视频包(附课件+代码)推荐系统教学视频也有的哈
②AI人工智能:54份行业重磅报告汇总
③能写进简历的企业级项目实战。
④100篇+深度学习论文合集
⑤人工智能必读书籍
⑥专属人工智能学习路径规划
⑦不定期大神直播,学习和困惑解答
⑧拿来就能跑通的论文复现代码讲解及数据集




分享几个自认为不错的学习Spark的视频资源(百度云) 有段时间没写大数据相关的博客了,主要是最近一边学着Spark,一边手上做着基于Hadoop的实现一个web端推荐系统的项目。 想写点东西,整理了一会儿发现写的不咋地就没发出来,这次就放几个Spark的学习视频资源吧,是百度云链接啊 学习 Scala 进击大数据 Spark 生态圈:https://pan.baidu.com/s/1Ld35QE4xfsOQ9o6qFwxL0A 密码:detm Sp... 阅读详情

相关推荐

推荐系统知识:是什么?能干什么?核心算法是?

在当今数字化时代,推荐系统已经成为许多互联网平台的核心功能之一。无论是在线购物、音乐和视频流媒体、社交媒体,还是新闻和内容聚合,推荐系统都扮演着至关重要的角色。它们通过分析用户的历史行为和偏好,以及其他相关信息,为用户提供个性化的推荐内容,从而提高用户体验,增加平台的粘性,以及促进销售和内容传播。那么,推荐系统究竟是如何运作的呢?让我们深入探索一下。

全沾软贱开发攻城狮 1万+

【人工智能】推荐系统算法

推荐系统算法详解 一、常用推荐算法分类 1. 基于人口统计学的推荐算法 基于人口统计学的推荐机制(Demographic-based Recommendation)是一种最易于实现的推荐方法,它只是简单的根据系统用户的基本信息发现用户的相关程度,然后将相似用户喜爱的其他物品推荐给当前用户 对于没有明确含义的用户信息(比如登录时间、地域等上下文信息),可以通过聚类等手段,给用户打上分类标签 对于特定标签的用户,又可以根据预设的规则(知识)或者模型,推荐出对应的物品 用户信息标签化的过程一般又称为用户画像(

柠檬小帽的博客 - 计算机全栈体系 2万+

机器学习代码实践宝典:ml_code存储库

在机器学习中,没有单一的评估指标适用于所有问题。通常会根据问题的性质和需求选择适当的指标。例如,在不平衡分类问题中,混淆矩阵、召回率、精确度和F1分数更为重要。一个成功的机器学习项目从定义清晰的问题开始。问题定义应包括预期的结果以及解决这个问题将如何提供价值。一旦问题定义完成,数据集的选择就成为项目成功的关键。合适的数据集不仅反映了现实世界的多样性和复杂性,而且为模型提供了足够的信息以学习和泛化。选择数据集时,你应该考虑以下因素:- 数据质量:确保数据准确、干净、且没有错误。

weixin_42465332的博客 1045

推荐系统算法详解

推荐系统、基于内容、基于用户、协同过滤、矩阵分解、LFM

weixin_46351593的博客 4170

库卡kuka仿真软件sim Pro 3.1简单实用教程

实验目的 建立机器人,自定义抓手,导入外部模型,掌握工具坐标、基坐标的使用,自动生成轨迹。 实验步骤 打开KUKA.Sim Pro 3.1.2仿真软件,依次点击KUKA Sim Library 3.1 → KUKA_ROBOTS→Small Robots(3kg-10kg)→Archiv→AGILUS-1 Series→sixx,双击KR 6 R700 sixx,加载机器臂到工作空间; 加载自定义抓手。双击Miscellaneous,再双击圆锥Cone设置上半径为0,下半径为40,高为100; 点击“捕

weixin_45168199的博客 4万+

Appstore开发者必读:3.2(f)违规预警与高效申诉指南

本文为AppStore开发者提供了应对3.2(f)违规通知的完整指南。文章深度解析了3.2(f)条款下的隐瞒性、关联性与真实性违规类型,并提供了黄金48小时内的自查、申诉信撰写与提交全流程策略。同时,文章强调遵循App Review Guidelines,建立内部合规清单与保持账号独立,是预防违规、维护开发者账号安全的关键。

weixin_29214559的博客 272

推荐系统常用推荐系统算法(协同过滤算法等)-人工智能AI

导读:悟已往之不谏,知来者之可追。 这是小编的其他文章,希望对大家有所帮助,点击即可阅读 人工智能常用的十大算法 人工智能数学基础(一) 人工智能数学基础(二) 人工智能数学基础(三)人工智能数学基础(四) 一、推荐系统概述和常用评价指标 1.1 推荐系统的特点 在知乎搜了一下推荐系统,果真结果比较少,显得小众一些,然后大家对推荐系统普遍的观点是: (1)重要性UI>数据>算法,就是推荐系统中一味追求先进的算法算是个误区,通常论文研究类的推荐方法有的带有很...

Java_rich的博客 5287

《联邦学习实战》杨强 读书笔记十四——构建公平的大数据交易市场

当数据具有资产属性之后,数据便可以直接或者间接地为公司、为社会创造价值和收益,并且可以作为一种特殊的商品在市场中进行交易。 与传统的商品交易相比,数据资产交易的市场前景更广阔,但同时也面临着很多的挑战,主要包括: 数据的质量、价格如何定义 在合法合规的前提下,数据的交易如何确保不会泄露用户的隐私 如何构建合理的激励机制来鼓励更多的参与方加入数据交易市场中 大数据交易 数据交易的定义 数据交易是指一种对数据进行买卖的行为,大数据交易由三方共同参与,分别为数据提供方、大数据交易平台和数据需求方:

IEEE802_11的博客 3433

机器学习入门宝典:掌握核心算法与应用

在数字化时代,机器学习作为人工智能的重要分支,广泛应用于智能语音助手、自动驾驶、精准医疗和个性化推荐等领域。本文为初学者提供了机器学习的入门指南,涵盖了其定义、应用场景、类型(监督学习、无监督学习、强化学习)、核心算法(如线性回归、逻辑回归、决策树、支持向量机、K近邻算法、神经网络)以及实践步骤(数据收集与预处理、选择算法与模型、训练模型、评估模型、应用模型)。此外,还介绍了常用的机器学习工具与框架(如Python、Scikit-learn、TensorFlow、PyTorch),并通过鸢尾花分类的实战案例

2501_91624122的博客 823

plotly包安装_Plotly(一)安装指南

plotly,是一个快速完善并崛起的交互式的、开源的绘图库库,Python库则是它的一个重要分支。现已支持超过40种独特的图表类型,涵盖了广泛的统计、金融、地理、科学和三维用例。Plotly 通过JavaScript构建,能基于Web显示实现交互式的可视化效果(Plotly最强大之处之一)。所以它的图形呈现可以方便的显示于Jupyter notebook(基于html)、独立的html中(直接显示...

weixin_35907189的博客 3472

知识库构建革命:基于Agent的智能检索系统设计

本文聚焦“基于Agent的智能检索系统”这一前沿技术,系统讲解其设计逻辑、核心技术与落地方法。我们将覆盖从基础概念(如Agent如何“理解”知识)到实战代码(如何用Python搭建原型系统)的全链路内容,帮助技术开发者、企业知识管理负责人理解这一技术为何能颠覆传统知识库。本文将按“问题引入→核心概念→技术原理→实战落地→未来趋势”的逻辑展开:先用“老图书馆的困境”故事引出传统知识库的问题;再用“智能图书管理员”类比解释Agent如何革新检索;接着拆解NLP、对话管理、知识推理等核心技术;

AI智能探索者的博客 725

机器学习算法整理面试宝典

机器学习算法 传统机器学习算法 本篇整理了传统的机器学习算法在面试中的考点,主要涉及算法的基本原理和具体细节。包含的算法有:分类算法:逻辑回归、决策树、随机森林、朴素贝叶斯、KNN、GBDT、XgBoost和LightGBM、stacking集成模型、最大熵模型;聚类算法:K-Means和混合高斯模型;降维算法:PCA、LDA;推荐系统算法:协同过滤;关联规则算法:Apriori算法;图模型:HM...

weixin_40259742的博客 1451

YOLO26训练自己的数据集,从代码下载到实例测试 (含YOLO26网络结构图)

在Windows10上配置CUDA环境教程2026年1月14日,YOLO26是最新发布的计算机视觉模型。支持多种任务,包括目标检测、实例分割、图像分类、姿态估计、有向目标检测以及物体跟踪等。以上就是YOLO26训练自己数据集的全部过程啦,欢迎大家在评论区交流~

Limiiiing的博客 6485

【机器学习入门宝典:核心概念 + 应用全图谱】

告别“不明觉厉”:一次搞懂机器学习是啥

dally2的博客 718

Qt实现窗口自适应分辨率大小

如果希望窗口大小始终保持与屏幕分辨率一致,可以将上述代码放在窗口的resizeEvent()函数中。这样,每当窗口大小发生变化时,都会自动调用resizeEvent()函数,从而实现窗口大小的自适应调整。在Qt中,可以通过一些简单的方法实现窗口大小随分辨率变化而自适应调整。获取到当前屏幕的分辨率后,可以根据需要调整窗口的大小。无论在何种分辨率下运行应用程序,窗口都能够正确地自动调整大小,提供更好的用户体验。除了调整窗口大小,还可以考虑将窗口设置为最大化,以充分利用屏幕空间。步骤2:调整窗口大小。

FuJavascript的博客 3655

ubuntu下编译qtwebengine

ubuntu qtwebengine

tianyu的专栏 - Linux site:blog.youkuaiyun.com/wishfly 1463

【特别开放】 4.10热门项目推荐:fun-rec - 从算法基础到实战闭环的推荐系统学习指南

在信息爆炸的时代,我们每天面对海量的内容选择:淘宝上有数亿商品,抖音上有千万视频,网易云音乐有百万歌曲。如何让用户快速找到自己感兴趣的内容?这就是推荐系统要解决的核心问题。 推荐系统已经成为现代互联网产品的标配,从电商、视频、音乐到新闻资讯,无处不在的个性化推荐正在重塑我们的数字生活体验。据统计,Netflix 75%的观看内容来自推荐,YouTube 60%的视频点击来自推荐,Amazon 3...

gitblog_01401的博客 714

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

百度机器学习算法春招一二三面面经

节前,我们星球组织了一场算法岗技术&面试讨论会,邀请了一些互联网大厂朋友、参加社招和校招面试的同学,针对算法岗技术趋势、大模型落地项目经验分享、新手如何入门算法岗、该如何准备、面试常考点分享等热门话题进行了深入的讨论。

机器学习社区 1354

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

推荐系统方向毕业设计选题宝典(2026 届):创新课题推荐

推荐系统方向本科毕业设计的七大研究方向,包括基于协同过滤的推荐、内容推荐系统、深度学习推荐、混合推荐系统、社交网络推荐、时间序列推荐以及位置感知推荐。这些方向涵盖了推荐系统的核心算法和技术方法,从传统的协同过滤到前沿的深度学习技术,为学生提供了全面的研究选择。本文适合数据科学与大数据专业、计算机科学与技术专业、软件工程专业、智能科学与技术以及人工智能与大数据专业的本科生参考,旨在为对推荐系统领域感兴趣的同学提供毕业设计选题灵感

2301_79555157的博客 1085

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

推荐系统是如何在 Elasticsearch 中实现的

关注我,持续分享逻辑思维&管理思维&面试题;可提供大厂面试辅导、及定制化求职/在职/管理/架构辅导;推荐专栏,目前已完成所有内容。一顿烧烤不到的费用,让人能紧跟时代的浪潮。从普通网站,到公众号、小程序,再到AI大模型网站。干货满满。学成后可接项目赚外快,绝对划算。不仅学会如何编程,还将学会如何将AI技术应用到实际问题中,为您的职业生涯增添一笔宝贵的财富。

借雨醉东风的博客 1466

机器学习常见算法思想的面试宝典

本文转载自机器学习&数据挖掘笔记_16(常见面试之机器学习算法思想简单梳理) 前言:   找工作时(IT行业),除了常见的软件开发以外,机器学习岗位也可以当作是一个选择,不少计算机方向的研究生都会接触这个,如果你的研究方向是机器学习/数据挖掘之类,且又对其非常感兴趣的话,可以考虑考虑该岗位,毕竟在机器智能没达到人类水平之前,机器学习可以作为一种重要手段,而随着科技的不断发展,相信这方面...

qq_32572085的博客 442

解决mechabar常见问题:从依赖安装到主题适配的完整解决方案

mechabar是一款模块化的Waybar配置工具,专为提升桌面体验设计。本文将帮助新手用户轻松解决从依赖安装到主题适配的各类常见问题,让你快速上手这款强大的桌面美化工具。 ## 依赖安装失败的终极解决方法 mechabar的正常运行需要特定依赖包的支持,很多用户在安装过程中会遇到依赖缺失的问题。其实解决方法非常简单,项目提供了一键安装脚本,只需运行以下命令: ```bash ~/.conf

gitblog_00001的博客 971

《大模型面试宝典》(2024版) 正式发布!

2022 年11月底,OpenAI 正式推出 ChatGPT ,不到两个月的时间,月活用户就突破1亿,成为史上增长最快的消费者应用。目前国内已发布的大模型超过200个,大模型的出现彻底改变了我们的生活和学习方式。只要你想从事 AI 相关的岗位,无论是计算机视觉(CV)、自然语言处理(NLP)、搜广推、风控、机器学习算法等,大模型相关话题都是绕不开的。可能唯一的区别就是场景和问题难度上。最近我们星球群组织了一场AI技术&面试讨论会,邀请了一些互联网大厂朋友、最近参加社招和校招面试的同学。

Python学习与数据挖掘 779

探秘算法之旅:《常用算法程序集》第四版精华版解读

探秘算法之旅:《常用算法程序集》第四版精华版解读 【下载地址】常用算法程序集第四版高清完整版PDF全部代码第二部分 本仓库提供了《常用算法程序集(C++语言描述)第四版》的第二部分资源下载。该资源包括高清完整版的PDF文件以及全部的代码实现。由于文件大小超过60M,因此分为两部分进行分享,这是第二部分 ...

gitblog_09743的博客 575

【面试宝典】机器学习:深度解析高频面试题与解答策略

其主要思想是:将⼦集的选择看作是⼀个搜索寻优问题,⽣成不同的组合,对组合进⾏评价,再与 其他的组合进⾏⽐较。这样就将⼦集的选择看作是⼀个是⼀个优化问题,这⾥有很多的优化算法可 以解决,尤其是⼀些启发式的优化算法,如GA,PSO,DE,ABC等,详⻅“优化算法——⼈⼯蜂群 算法(ABC)”,“优化算法——粒⼦群算法(PSO)”。

2301_76820214的博客 2426

【算法岗校招面试】有用链接

AI算法工程师手册 http://www.huaxiaozhuan.com/ 算法题讲解 https://github.com/labuladong/fucking-algorithm 牛客网 算法面试宝典 https://www.nowcoder.com/tutorial/95/3cefbe4d0e914256b1271fe3417dded8 《剑指Offer》面试题: Python实现 GitHub - JushuangQiao/Python-Offer: 《剑指Offer》面试题Python实现

qq_36037953的博客 221
上一篇: 秀的一批,一文带你认识推荐系统算法
下一篇: 研究生学人工智能有未来吗?点击快速了解就业前景
普通网友
博客等级 码龄5年 1265粉丝 108原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
